Grundlæggende AI
Hvad er overfitting?

 Føj Unite.AI til dine foretrukne kilder på Google
Overfitting opstår, når en model fanger mønstre eller støj, som fungerer usædvanligt godt på træningsdataene, men som ikke kan generalisere til nye eksempler. En overtilpasset model kan have meget lav træningsfejl, mens validerings‑ eller virkelighedspræstationen er væsentligt dårligere.
Det modsatte problem er underfitting: modellen eller træningsprocessen kan ikke indfange nok af signalet selv på træningssættet. God modellering balancerer tilpasning med generalisering i stedet for at jagte perfekt træningspræstation.
Vigtige pointer
- Træningspræstation alene kan ikke diagnosticere generalisering.
- Tidlig stopning bør baseres på valideringsadfærd og aldrig gentagne beslutninger på det endelige test‑sæt.
- Mere data kan hjælpe, men flere funktioner eller større kapacitet kan også forværre overfitting.
- Regularisering, augmentation, krydsvalidering, forebyggelse af lækage og passende evaluering adresserer forskellige årsager.
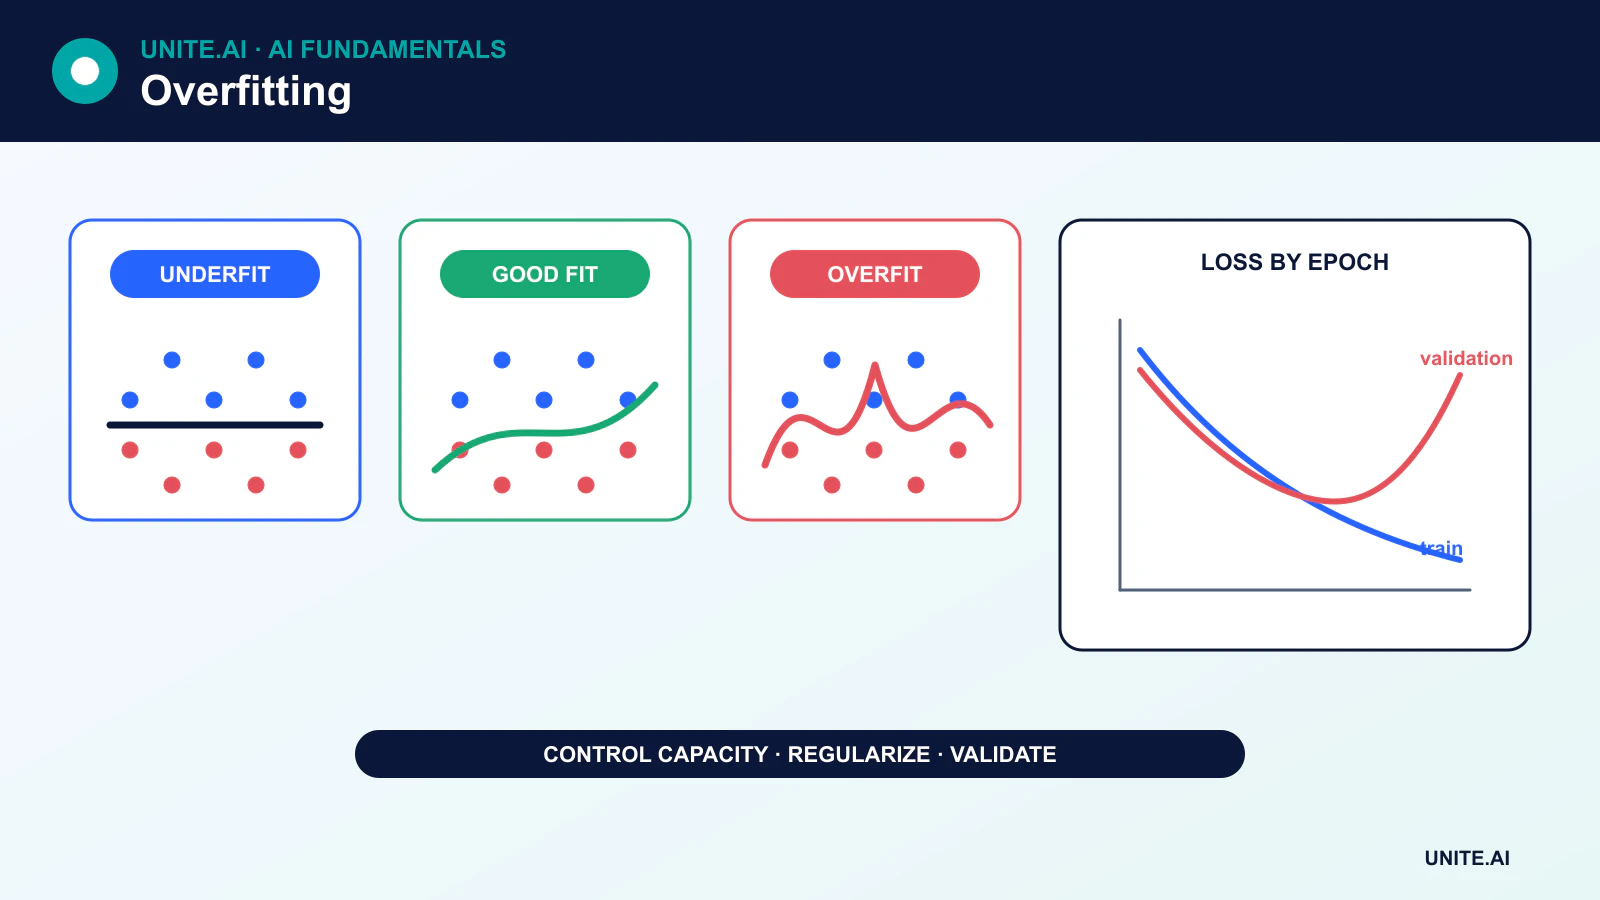
Tilpasning, underfitting og overfitting
En model underfitter, når dens antagelser er for restriktive, dens funktioner udelader vigtigt signal, optimeringen er utilstrækkelig, eller træningen er utilstrækkelig. Tilføjelse af relevante funktioner eller kapacitet kan hjælpe, men blot at tilføje vilkårlige funktioner kan øge støj og overfitting.
En model overfitter, når dens effektive kapacitet er for høj i forhold til informationen i træningsdataene. Eksempler inkluderer et dybt decision tree, der laver meget små blade, et polynomium, der følger tilfældige udsving, eller et neuralt netværk, der memoriserer eksempler.
Rollen for trænings‑, validerings‑ og testdata
- Training data tilpasser modelparametre.
- Validation data vælger arkitektur, hyperparametre, tærskler og stoppetidspunkt.
- Test data giver et endeligt estimat, når disse valg er færdige.
Hvis test‑sættet gentagne gange styrer beslutninger, bliver det en del af udviklingsprocessen og giver ikke længere et upartisk endeligt estimat. Krydsvalidering kan gøre mere effektiv brug af begrænsede data, men al forbehandling og funktionselektion skal foregå inden for hver træningsfold.
Tidlig stopning
Under træning falder træningstabet typisk fortsat. Valideringstabet kan falde i starten og senere stige, når modellen specialiserer sig på træningsstøj. Tidlig stopning gemmer det checkpoint med den bedste validerings‑objective eller stopper, efter at valideringen ikke har forbedret sig i en defineret tålmodighedsperiode.
Det korrekte checkpoint er ikke det med den laveste træningstab. Et separat endeligt test‑sæt evalueres efter tidlig stopning og efter at tuning‑beslutninger er afsluttet.
Regulariseringsmetoder
Vægtsstraffe
L2‑regularisering eller vægtforfald afskrækker store parameter‑værdier. L1‑regularisering kan fremme sparsomme koefficienter. Deres effekt afhænger af modellen og optimeringsalgoritmen; AdamW, for eksempel, adskiller vægtforfald fra den adaptive opdatering.
Dropout og stokastisk regularisering
Dropout maskerer tilfældigt aktiveringer under træning. Andre metoder dropper stier, forstyrrer funktioner eller udglatter etiketter. Disse teknikker ændrer trænings‑objective og skal deaktiveres eller håndteres korrekt ved inferens.
Data‑augmentation
Augmentation skaber realistiske variationer — såsom beskæringer, rotationer, støj eller parafraser — som bør bevare målet. Ugyldige transformationer kan ændre etiketten og skade modellen. Til vision hjælper værktøjer som Albumentations med at implementere kontrollerede pipelines.
Kapacitetskontrol
Fladere træer, færre parametre, funktionselektion, beskæring og enklere hypotese‑klasser kan reducere varians. Træbeskæring er kriteriedrevet, ikke tilfældig fjernelse af indlært detaljer.
Datalækage kan fremstå som exceptionel præstation
Lækage opstår, når information, der ikke er tilgængelig på forudsigelsestidspunktet, kommer ind i træning eller evaluering. Almindelige eksempler inkluderer at tilpasse normalisering på hele datasættet, splitte gentagne poster på tværs af fold‑ene, bruge fremtidige data til at forudsige fortiden, eller inkludere en funktion afledt af målet.
Lækage er ikke almindelig overfitting, men den skaber den samme vildledende kløft mellem offline‑resultater og implementering. Split‑strategien bør respektere tid, identitet, placering og data‑genereringsprocesser.
Distributionsskift er et separat problem
En model kan generalisere til sin testdistribution og stadig fejle, når produktionsdata ændrer sig. Nye enheder, politikker, populationer, årstider eller ondsindet adfærd kan forskyde input‑ eller mål‑relationen. Overvågning og periodisk revurdering er nødvendige, selv når den oprindelige model ikke var overfittet.
Diagnostisering af overfitting
Brug læringskurver, krydsvaliderings‑varians, undergruppe‑metrikker, kalibrering og fejlinspicering. Hvis både trænings‑ og valideringspræstation er dårlig, fokuser på underfitting, funktioner, etiketter eller optimering. Hvis træningen er stærk og valideringen svag, undersøg kapacitet, lækage, regularisering og repræsentativitet, før du blot indsamler flere data.
Hvorfor overfitting sker, og hvordan man opdager det
Overfitting opstår, når en model lærer mønstre, der reducerer træningsfejlen, men som ikke kan generalisere til målpopulationen. Årsager inkluderer overdreven kapacitet i forhold til effektiv data, støj i etiketter, gentagne enheder, fleksibel funktionselektion, lækage og tuning mod det samme validerings‑sæt. En voksende kløft mellem trænings‑ og valideringspræstation er et almindeligt bevis, men en lille kløft udelukker ikke overfitting, hvis begge sæt deler forurening eller afviger fra implementeringen. Læringskurver over datavolumen og kapacitet hjælper med at skelne varians fra bias.
Lækage er især vildledende: fremtidig information, dubletter, overlappende emner, forbehandlings‑fit på al data, eller etiketter kodet i metadata kan give fremragende hold‑out‑score. Split efter den enhed, der vil være ny ved implementering — patient, kunde, maskine, lokation eller tid — før du tilpasser transformationer eller augmentationer. Hold et endeligt test‑sæt lukket, mens du vælger funktioner, arkitektur og tærskler. Hvis teams gentagne gange inspicerer testresultater, bliver test‑sættet et andet valideringssæt og kræver udskiftning eller formel korrektion.
Regularisering, modeludvælgelse og produktions‑drift
Reducer overfitting med mere repræsentativ data, lavere kapacitet, vægtforfald, dropout, tidlig stopning, augmentation, ensemble‑metoder eller begrænsninger, der afspejler domænestrukturen. Hver metode har afvejninger: augmentation kan forvride etiketter, dropout ændrer optimering, og ensembles tilføjer betjeningomkostninger. Krydsvalidering estimerer udvælgelses‑variabilitet, men grupperede eller tids‑bevidste fold‑e skal bevare implementeringsgrænsen. Sammenlign med en simpel model og rapportér usikkerhed over fold‑e eller frø i stedet for at vælge den mest gunstige kørsel.
Produktionen kan afsløre en anden form for generaliseringsfejl, når input, brugere, incitamenter eller målinger ændrer sig. Overvåg funktion‑ og forudsigelsesfordelinger, kalibrering, undergruppe‑resultater og forsinket sandhed. Retræn ikke automatisk på uanmeldt feedback; modellens egne beslutninger kan forme de etiketter, den senere ser. Diagnosticér om fejlen skyldes drift, datapipelines, politikændringer eller et ugyldigt mål. Overfitting styres af eksperimentelt design og livscyklus‑disciplin, ikke en enkelt regulariseringsindstilling.
Arbejdseksempel: eliminering af lækage i en svindelmodel
En indledende svindelklassifikator scorer ekstremt højt, fordi gentagne kort‑ og forhandler‑begivenheder forekommer i tilfældige trænings‑ og test‑rækker, og chargeback‑information registreret uger senere er inkluderet som en funktion. Teamet rekonstruerer hver funktions tilgængelighedstid, fjerner felter efter beslutning, grupperer efter konto og bruger et fremadrettet tids‑split. Præstationen falder kraftigt, men estimerer nu den faktiske beslutning. En simpel regel‑baseline og læringskurver guider den nødvendige modelkompleksitet.
Regularisering og tidlig stopning tunes kun inden for historiske fold‑e. Den endelige evaluering rapporterer præcision ved gennemgangskapacitet, recall, kalibrering og omkostning efter svindeltype og kundesegment. I produktion ankommer bekræftede etiketter sent og er partiske efter hvilke transaktioner der blev gennemgået, så overvågning adskiller score‑drift fra resultat‑estimat. Retræning bruger domstols‑sager og afspilning mod den aktuelle politik. Projektet foretrækker en lavere ærlig score frem for en høj lækket, som ikke kan overleve implementeringen.
Implementeringsbeviser og operationel parathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tilsigtede brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evaluerings‑sæt før tuning. Test almindelige tilfælde, grænsetilstande, fejl‑ eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostning, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operationel telemetri bør afsløre inputkvalitet, outputadfærd, model‑ eller regel‑version, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, gennemgå derefter virkelige beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Kan en simpel model overfitte?
Ja. Gentagen funktionselektion, tærskel‑tuning eller evaluering på den samme hold‑out kan overfitte udviklingsprocessen, selv når den endelige model er simpel.
Giver mere træningsdata altid en løsning på overfitting?
Nej. Mere repræsentativ, korrekt mærket data kan hjælpe, men duplikeret, partisk, lækket eller uden for domænet data gør måske ikke. Lærings‑objective og evalueringsdesign er stadig vigtige.
Primære referencer