
Grundlæggende AI
Hvad er en KNN (K-nærmeste naboer)?

 Føj Unite.AI til dine foretrukne kilder på Google
K-nearest neighbors (KNN) forudsiger et udfald ud fra de mærkede træningseksempler, der er tættest på et forespørgselspunkt. For klassifikation stemmer naboerne om klassen. For regression gennemsnittes deres målværdier eller kombineres på anden måde.
KNN er en instansbaseret, ikke‑generalisering metode: tilpasning gemmer primært træningseksemplerne og et valgfrit søgeindeks. Det fjerner ikke behovet for trænings‑, validerings‑ og test‑splits. Evaluering på hold‑out data er afgørende for valg af k, afstandsmål, funktionbehandling og stemmeregel.
Vigtige pointer
- KNN forudsiger lokalt; den deler ikke datasættet i klynger først.
- Feature‑skalering er kritisk, fordi afstanden bestemmer, hvilke eksempler der tæller som naboer.
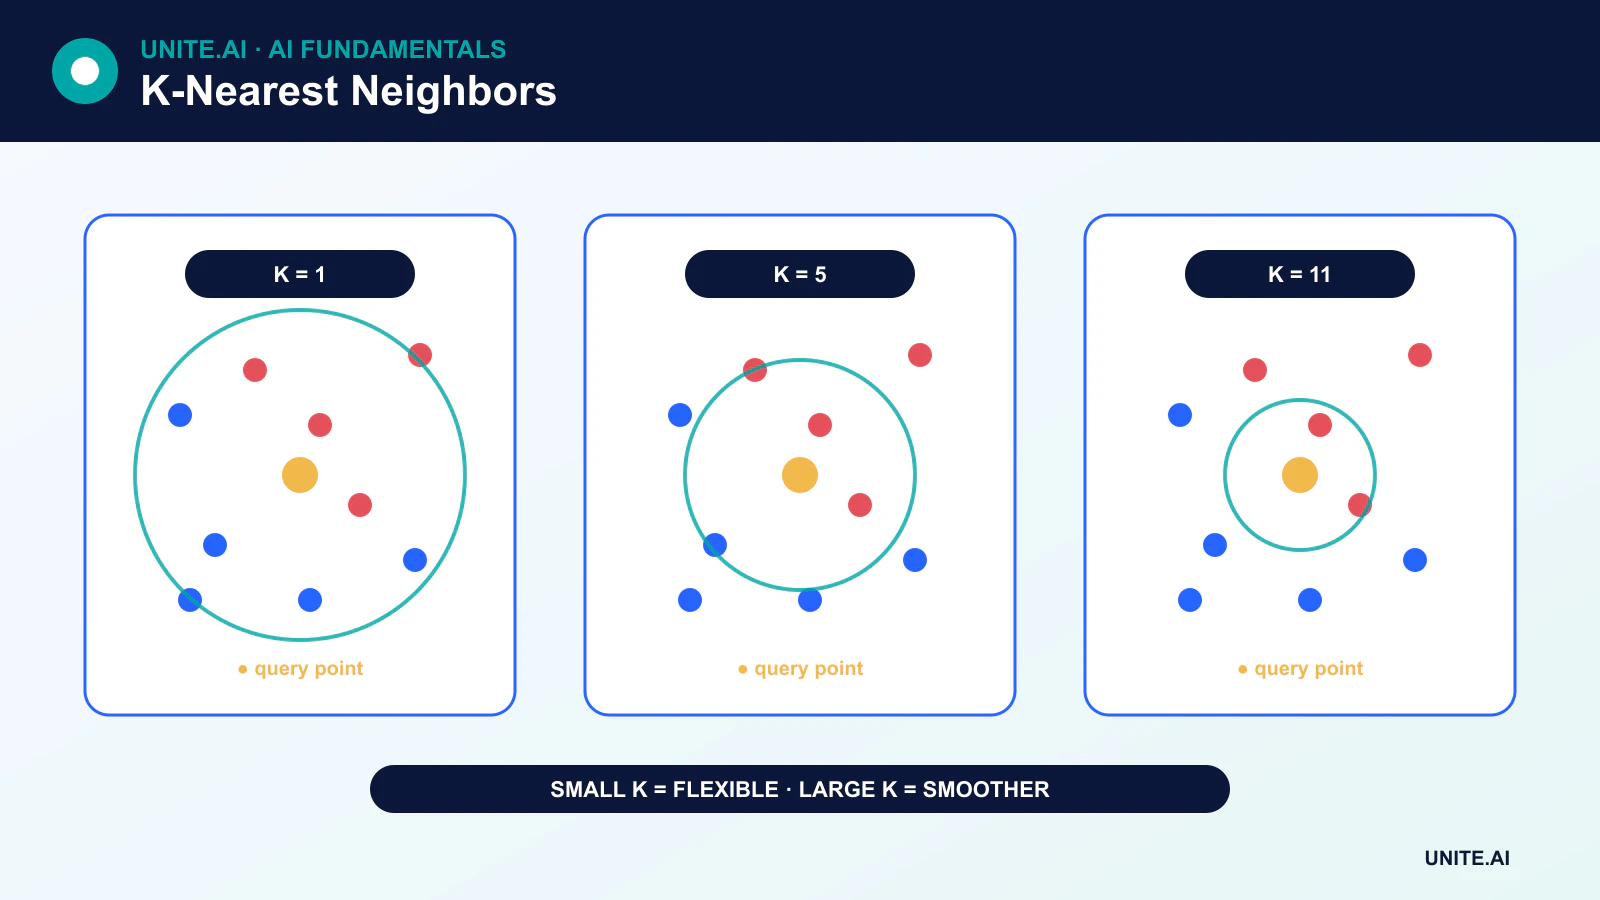
- Lille k kan være støjende, mens stort k kan udglatte den lokale struktur.
- Høje dimensioner, irrelevante funktioner, klasseubalancering og langsom søgning kan begrænse ydeevnen.
Hvordan KNN‑klassifikation fungerer
- Repræsenter forespørgslen og træningseksemplerne i det samme funktionsrum.
- Beregn afstanden fra forespørgslen til træningseksemplerne.
- Vælg de k nærmeste eksempler.
- Forudsig majoritetsklassen eller brug afstandsvægtet afstemning.
Afstandsvægtet afstemning giver de nærmeste naboer mere indflydelse. Uafgjorte stemmer kræver en dokumenteret regel, og naboer med samme afstand men forskellige mærkater kan få resultater til at afhænge af rækkefølge eller implementeringsdetaljer.
KNN‑regression
Ved regression er forudsigelsen typisk gennemsnittet af de nabomål. Afstandsvægtning kan reducere indflydelsen fra fjernere observationer. Median eller robust aggregation kan være nyttigt, når lokale mål indeholder outliers.
Afstandsmål
Euklidisk afstand er almindelig for kontinuerlige funktioner, Manhattan‑afstand summerer absolutte forskelle, og cosine‑afstand fokuserer på retning snarere end størrelse. Andre mål anvendes på binære, kategoriske, geografiske, sekvens‑ eller indlærte indlejringsdata.
At kalde KNN “ikke‑parametrisk” betyder, at den ikke antager en fast, endelig‑dimensional funktionel form for beslutningsgrænsen. Den antager dog stadig, at den valgte repræsentation og metrik gør nærliggende punkter relevante for hinanden.
Hvorfor skalering er vigtigt
Hvis én funktion spænder fra 0 til 1 og en anden fra 0 til 100.000, vil almindelig euklidisk afstand dominere den anden funktion. Standardisering, normalisering eller domænespecifikke transformationer bør tilpasses på træningspartitionen og anvendes på validerings‑, test‑ og produktionsdata.
Irrelevante funktioner forvrænger også nabolagene. Feature‑udvælgelse, dimensionsreduktion eller indlærte repræsentationer kan hjælpe, men hvert valg skal valideres uden datalækage.
Valg af k
Med k = 1 kan modellen følge støj og fejlagtigt mærkede eksempler. Efterhånden som k vokser, bliver forudsigelserne glattere og mindre følsomme over for et enkelt punkt. Hvis k bliver for stort, dominerer fjerne klasser eller regioner, og modellen under‑fit’er.
Vælg k gennem krydsvalidering på træningsdataene. For binær klassifikation reducerer et ulige k antallet af uafgjorte stemmer, men eliminerer dem ikke helt. Klassevægte, stratificerede splits, valg af tærskel og passende målinger er vigtige, når klasser er ubalancerede.
Forbandelsen ved høj dimension
I høj‑dimensionelle rum kan afstande blive mindre informative, fordi eksempler er sparsomme, og de nærmeste og fjerneste afstande bliver relativt ens. KNN kan kræve enorme mængder data for at opretholde meningsfulde lokale nabolag. Dette er forbandelsen ved høj dimension.
Dimensionalitetsreduktion eller opgavespecifikke indlejringer kan hjælpe, men en indlejrings geometri bør valideres for den tilsigtede opfattelse af lighed.
Søgeydelse
En brute‑force‑forespørgsel sammenligner det nye punkt med hvert gemt eksempel. KD‑træer og ball‑træer accelererer nogle eksakte søgninger, selvom deres fordele mindskes i høj dimension. Approximate nearest‑neighbor‑indekser bytter en lille mængde recall for stor hastigheds‑ og hukommelsesgevinst. Denne idé ligger også til grund for vektorsimilaritetssøgning.
Styrker og begrænsninger
KNN er enkel, understøtter uregelmæssige beslutningsgrænser og giver en intuitiv eksempelbaseret forklaring. Den kan også kræve betydelig hukommelse, afsløre følsomme træningseksempler, forudsige langsomt og opføre sig dårligt, når afstand ikke er meningsfuld. Den er en nyttig baseline – men ikke en metode, der som standard er meget præcis på de fleste problemer.
Afstand, nabolag og hyperparameter‑adfærd
K‑nearest neighbors gemmer træningseksempler og forudsiger ud fra de k nærmeste under en valgt afstand. Klassifikation bruger en majoritets‑ eller afstandsvægtet afstemning; regression gennemsnitter nabomål. Skalering er essentiel, fordi en funktion med stort interval kan dominere euklidisk afstand. Kategoriske, sparsomme, sekvens‑ eller geografiske data kan kræve Hamming, cosine, edit, great‑circle eller indlærte afstande. Metrikken er en modelantagelse om lighed, og den bør valideres mod den faktiske betydning af nærliggende tilfælde.
Lille k skaber fleksible, høj‑varians grænser og følsomhed over for støj; stort k udglatter forudsigelser og kan slette mindretalsstruktur. Ulige k undgår kun nogle binære uafgjorte stemmer og er ikke en generel regel. Vælg k, afstand, vægtning, funktionssæt og forbehandling inden for krydsvalidering. Klasseubalancering kan få lokal majoritetsafstemning til at overse sjældne udfald, så inspicer per‑klasse recall og nabolags‑sammensætning. Høj‑dimensionelle afstande har en tendens til at koncentrere, og irrelevante funktioner forringer nabolag; udvælgelse, dimensionsreduktion eller indlærte indlejringer kan hjælpe.
Indeksering, usikkerhed og produktionsdrift
Naiv inferens sammenligner en forespørgsel med hvert træningspunkt. KD‑træer og ball‑træer hjælper i passende lave dimensioner; approximate nearest‑neighbor‑indekser bytter præcision for hastighed og skala. Mål recall for nabosøgningen separat fra den forudsigende kvalitet. Hukommelse omfatter gemte funktioner, mærkater og indeksstrukturer. Opdateringer er konceptuelt simple, men kan kræve genopbygning af indeks, versions‑konsistens og sletnings‑propagation. Beskyt følsomme træningseksempler, da returnering af naboer eller afstande kan afsløre poster.
KNN kan fremvise eksempler, der gør en forudsigelse forståelig, men nærhed er ikke årsagssammenhæng eller retfærdighed. Angiv afstand, stemmemargin og en afholdelsesregel, når nabolag er sparsomme eller modstridende. Overvåg forespørgselsafstand, nabomærkater, funktions‑drift, latency og bekræftede udfald. Hold forbehandling og indeks‑versioner synkroniseret, og test eksakte versus approximerede resultater efter ændringer. KNN er en effektiv lokal baseline og genfindelsesmetode, når afstanden er meningsfuld; den har problemer, når lighed ikke kan repræsenteres af de tilgængelige funktioner.
Praktisk eksempel: KNN til produktudskiftning
En forhandler repræsenterer produkter med standardiserede numeriske attributter, kategorisk kompatibilitet og en indlært tekst‑embedding, og definerer derefter en vægtet afstand, som merchandisers gennemgår. K og vægte vælges ud fra senere produktlanceringer, ikke tilfældige varelinjer. Evalueringen tjekker relevant erstatnings‑recall, inkompatible anbefalinger, afstand, kategoridækning og resultater for sjældne varer. En popularitets‑baseline viser, om lokal lighed tilføjer værdi.
Et approximativt indeks benchmarkes mod eksakte naboer for recall og latency. Forespørgsler uden en tæt kompatibel vare returnerer ingen forslag i stedet for en tvungen nabo. Produkt‑sletninger og attribut‑korrektioner propagere til indekset gennem versionerede opdateringer. Overvågning sporer afstandsfordelinger, tomme resultater, overstyringer og kommercielle udfald uden at forveksle salg med reel kompatibilitet. Følsomme leverandør‑betingelser udelades fra forklaringer, og returnerede eksempler forbliver bevis på lighed – ikke en påstand om, at produkter er ækvivalente.
Implementeringsbeviser og driftsberedskab
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsetilstande, fejlformet eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latency, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operativ telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede udfald uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genopretning, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Har KNN en træningsfase?
Den har kun lidt parameter‑tilpasning, men den har stadig en udviklingsproces: forbehandling læres fra træningsdata, et indeks kan bygges, og k, metrik, vægte og funktioner vælges med validering.
Er KNN det samme som K‑means?
Nej. KNN er primært en superviseret lokal‑forudsigelsesmetode. K‑means er en usuperviseret klyngedannelses‑algoritme, hvor K er antallet af klyngesentre.
Primære referencer












