
Grundlæggende AI
Hvad er Support Vector Machines?

 Føj Unite.AI til dine foretrukne kilder på Google
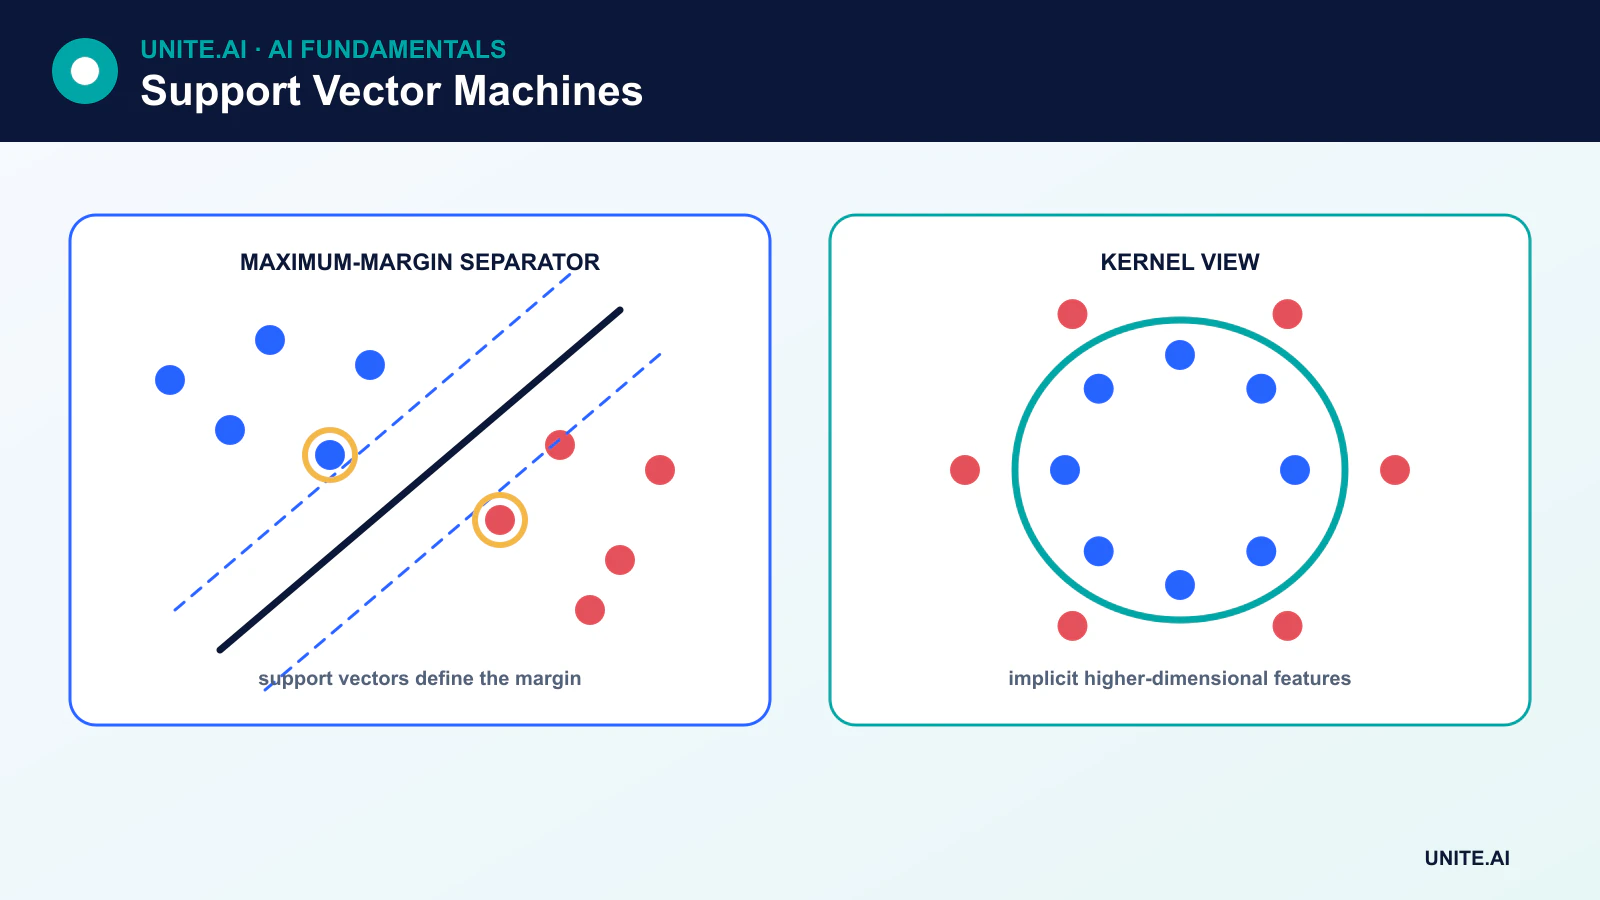
En supportvektormaskine (SVM) er en superviseret læringsmetode, der finder en beslutningsgrænse med den bredest mulige margin mellem klasser. De træningseksempler, der bestemmer den grænse, er supportvektorer.
SVM’er kan udføre lineær eller ikke-lineær klassificering, regression og nyhedsdetektion. De er især nyttige for små til mellemstore datasæt med informative funktioner, herunder høj-dimensionelle sparsomme data, men deres træningsomkostninger kan blive urimelige på meget store datasæt.
Vigtige pointer
- En SVM maksimerer den minimale margin mellem grænsen og de nærmeste træningspunkter.
- Supportvektorer er datapunkter, ikke ekstra hyperplaner.
- Parameteren C afbalancerer marginbredden mod straf for overtrædelser.
- Kernefunktioner beregner lighed i et implicit funktionelt rum uden eksplicit at materialisere hver transformeret funktion.
Ideen om maksimal margin
For en lineær binær klassifikator er beslutningsgrænsen et hyperplan:
w · x + b = 0
Vektoren w bestemmer orienteringen og b forskydningen. Mange hyperplaner kan adskille træningsklasserne. SVM’en vælger den, som maksimerer afstanden til de nærmeste eksempler på begge sider. Disse nærmeste eksempler er supportvektorerne og har den største indflydelse på den tilpassede grænse.
Målet er ikke at maksimere afstanden fra grænsen til hvert punkt individuelt. Den maksimerer den minimale margin, mens den overholder eller straffer klassebegrænsninger.
Hårde og bløde marginer
En hard-margin SVM kræver perfekt lineær adskillelse og er følsom over for outliers. Reelle datasæt har typisk brug for en blød margin, som introducerer slack-variabler for observationer inden for marginen eller på den forkerte side af grænsen.
Hyperparameteren C styrer straffen for disse overtrædelser:
- En større C straffer overtrædelser kraftigere og giver ofte en smallere margin, der følger træningseksemplerne tættere.
- En mindre C tillader flere overtrædelser til gengæld for en bredere, mere regulariseret margin.
Antallet af supportvektorer er et resultat af dataene og løsningen; en forøgelse af C garanterer ikke et bestemt antal supportvektorer.
Kerne‑tricket
Nogle klasser kan ikke adskilles med et lige hyperplan i det oprindelige funktionelle rum. En kerne evaluerer et indre produkt svarende til et andet funktionelt rum. Dette gør det muligt for SVM’en at tilpasse en ikke-lineær grænse uden eksplicit at beregne hver transformeret koordinat.
Almindelige kerner omfatter:
- Lineær: effektiv for høj-dimensionelle sparsomme funktioner såsom tekst.
- Polynomisk: modellerer interaktioner op til en valgt grad.
- Radial basis function (RBF): skaber fleksible lokale grænser baseret på afstand.
- Sigmoid: ligner en neuralt aktiveringsfunktion, men er sjældent standardvalget.
For en RBF SVM styrer gamma, hvor lokalt hvert træningseksempel påvirker grænsen. Stor gamma kan skabe meget detaljerede regioner og overpasse; lille gamma giver en glattere påvirkning.
Multiklasseklassificering
Det klassiske SVM-mål er binært. Biblioteker udvider det ved hjælp af strategier som one-vs-rest, som træner én klassifikator pr. klasse, eller one-vs-one, som træner klassifikatorer for klassepar og kombinerer deres beslutninger. Multiklasse‑SVM’er trækker ikke blot én linje færre end antallet af klasser.
Supportvektorregression og one-class SVM
Supportvektorregression (SVR) tilpasser en funktion, mens den ignorerer fejl inden for et epsilon-bredt rør og straffer større afvigelser. En one-class SVM estimerer en grænse omkring typiske data og kan understøtte nyhedsdetektion. Et usædvanligt punkt er ikke automatisk svig eller fejl; det er usædvanligt i forhold til den tilpassede repræsentation.
Praktiske krav
SVM’er afhænger af afstande og indre produkter, så numeriske funktioner skal generelt skaleres. C, kerne, gamma og klassevægte bør vælges gennem validering. Sandsynlighedsvurderinger er ikke iboende i marginen og kræver ofte kalibrering, hvilket tilføjer omkostninger og bør evalueres separat.
Træning af kernel‑SVM kan skaleres mellem kvadratisk og kubisk tid i forhold til antallet af prøver, afhængigt af data og implementering. Lineære SVM‑varianter eller stokastiske lineære modeller er bedre egnet til meget store datasæt. For rå billeder, lyd eller sprog kan lærte repræsentationer fra deep learning være mere effektive, mens en SVM stadig kan klassificere en fast indlejring.
SVM’s styrker og begrænsninger
SVM’er kan fungere godt med mange funktioner, tilbyder et klart regulariseret mål og afhænger primært af supportvektorer ved forudsigelse. Begrænsninger omfatter følsomhed over for skalering og hyperparametre, potentielt dyr træning, reduceret fortolkelighed under ikke-lineære kerner og krav om sandsynlighedskalibrering.
Marginer, kerner og optimeringsmålet
En supportvektormaskine søger et separerende hyperplan med en stor margin mellem klasser. Kun supportvektorer på eller inden for marginen bestemmer grænsen. Soft‑margin SVM’er introducerer slack for overlap og fejlagtigt mærkede punkter; parameteren C bytter en bredere margin mod træningsovertrædelser. Input bør som regel skaleres, fordi afstand og prikprodukt driver løsningen. Klassevægte eller genprøvning hjælper, når fejlomkostninger og forekomst er ulige, men tærskler og sandsynligheder kræver stadig uafhængig validering.
Kerne‑tricket evaluerer lighed, som om input blev kortlagt til et højere‑dimensionelt funktionelt rum. Lineære, polynomiske, radial‑basis og specialiserede kerner indkoder forskellige antagelser. For en RBF‑kerne styrer gamma, hvor lokalt hvert punkt påvirker grænsen: høj gamma kan skabe indviklede regioner og overpasse, mens lav gamma kan underpasse. Kerne‑matricer vokser kvadratisk med antallet af prøver, hvilket gør ikke‑lineære SVM’er dyre på store datasæt. Lineære løsningsmetoder eller approksimative funktionelle kort er ofte foretrukne i stor skala.
Multiklassebrug, kalibrering og operationelle begrænsninger
Binære SVM’er udvides til multiklasse gennem one‑vs‑rest, one‑vs‑one eller strukturerede formuleringer. Hyperparametre skal justeres inden for krydsvalidering, med grupperede eller tidsmæssige opdelinger hvor nødvendigt. Evaluer klasse‑specifik præcision og recall, marginfordelinger, kalibrering og ydeevne under skift. Rå beslutningsscore er ikke sandsynligheder; Platt‑skalering eller isotonskalering bruger separate data og kan forringes, hvis forekomsten ændres. Sammenlign med logistisk regression, træer og moderne repræsentationsbaserede metoder ved tilsvarende forbehandling og tuning.
Implementering kræver den præcise scaler, funktionernes rækkefølge, kerneparametre, supportvektorer og klassemapping. Forudsigelsesomkostningen for en kernel‑SVM vokser med antallet af supportvektorer, så mål latenstid og hukommelse på realistiske batches. Input langt fra træningssupport kan stadig modtage sikre etiketter; tilføj out‑of‑distribution‑tjek eller en afholds politik hvor det er passende. Undersøg fejl for følsomme proxyer og datasætartefakter. SVM’er forbliver stærke for mellemstore, høj‑dimensionelle problemer, men en maksimal geometrisk margin er ikke bevis på kausal struktur eller sikkerhed.
Eksempel: en SVM til sjælden dokumentrouting
Et juridisk operationsteam klassificerer korte indleveringer i routeringskategorier ved hjælp af TF–IDF-funktioner og en lineær SVM. Det opdeler efter sag og tid for at forhindre lækage af skabeloner, skalerer klassevægte baseret på gennemgået fejlomkostning og tuner C inden for indlejret validering. Den lineære model sammenlignes med logistisk regression og en transformer. Præcision, recall, kalibrering og reviewerarbejdsbyrde pr. klasse er vigtigere end samlet nøjagtighed.
Beslutningsscore kalibreres på separate data, og dokumenter med lav margin eller uden understøttet sprog sendes til manuel indtagelse. Implementeringsartefakten indeholder tokenizeren, ordforrådet, vægtning, modellen, kalibreringen og label‑kortet. Overvågning sporer nye termer, kategori‑forekomst, marginer og korrigerede ruter. Dokumenter og supportvektorer beskyttes, da tekstfunktioner kan afsløre fortrolige oplysninger. En ikke‑lineær kerne afvises, når dens lille kvalitetsforbedring ikke kan retfærdiggøre latenstid, hukommelse og fortolkningsomkostninger.
Implementeringsbeviser og operationel beredskab
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før tuning. Test almindelige tilfælde, randbetingelser, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles autoritet for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operationel telemetri bør afsløre inputkvalitet, outputadfærd, model‑ eller regelversion, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarmtærskler og en ansvarlig for respons, og gennemgå realverdensbeviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelseslæring, slette‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Udfører SVM’er kun klassificering?
Nej. Supportvektorregression forudsiger kontinuerlige mål, mens en one‑class SVM kan estimere en nyhedsgrænse. Hver variant har et andet mål og et sæt hyperparametre.
Hvornår er en lineær SVM et stærkt valg?
Lineære SVM’er er ofte effektive for høj‑dimensionelle sparsomme funktioner, herunder traditionelle tekstrepræsentationer, hvor en fleksibel kerne ville tilføje omkostninger uden klar fordel.
Primære referencer












