
Grundlæggende AI
Hvad er Ensemble‑læring?

 Føj Unite.AI til dine foretrukne kilder på Google
Ensemble‑læring kombinerer forudsigelser fra flere modeller. Den centrale idé er, at modeller med forskellige fejl kan levere et mere præcist eller stabilt resultat, når deres output gennemsnitliggøres, stemmes eller sendes til en meta‑lærer.
Det er ikke nok blot at tilføje modeller. Hvis alle medlemmer lærer den samme genvej, vil deres fejl korreleres, og ensemblet kan blot blive mere sikker på den samme fejl.
Vigtige pointer
- Ensembler fungerer bedst, når de enkelte medlemsmodeller er nyttige og begår væsentligt forskellige fejl.
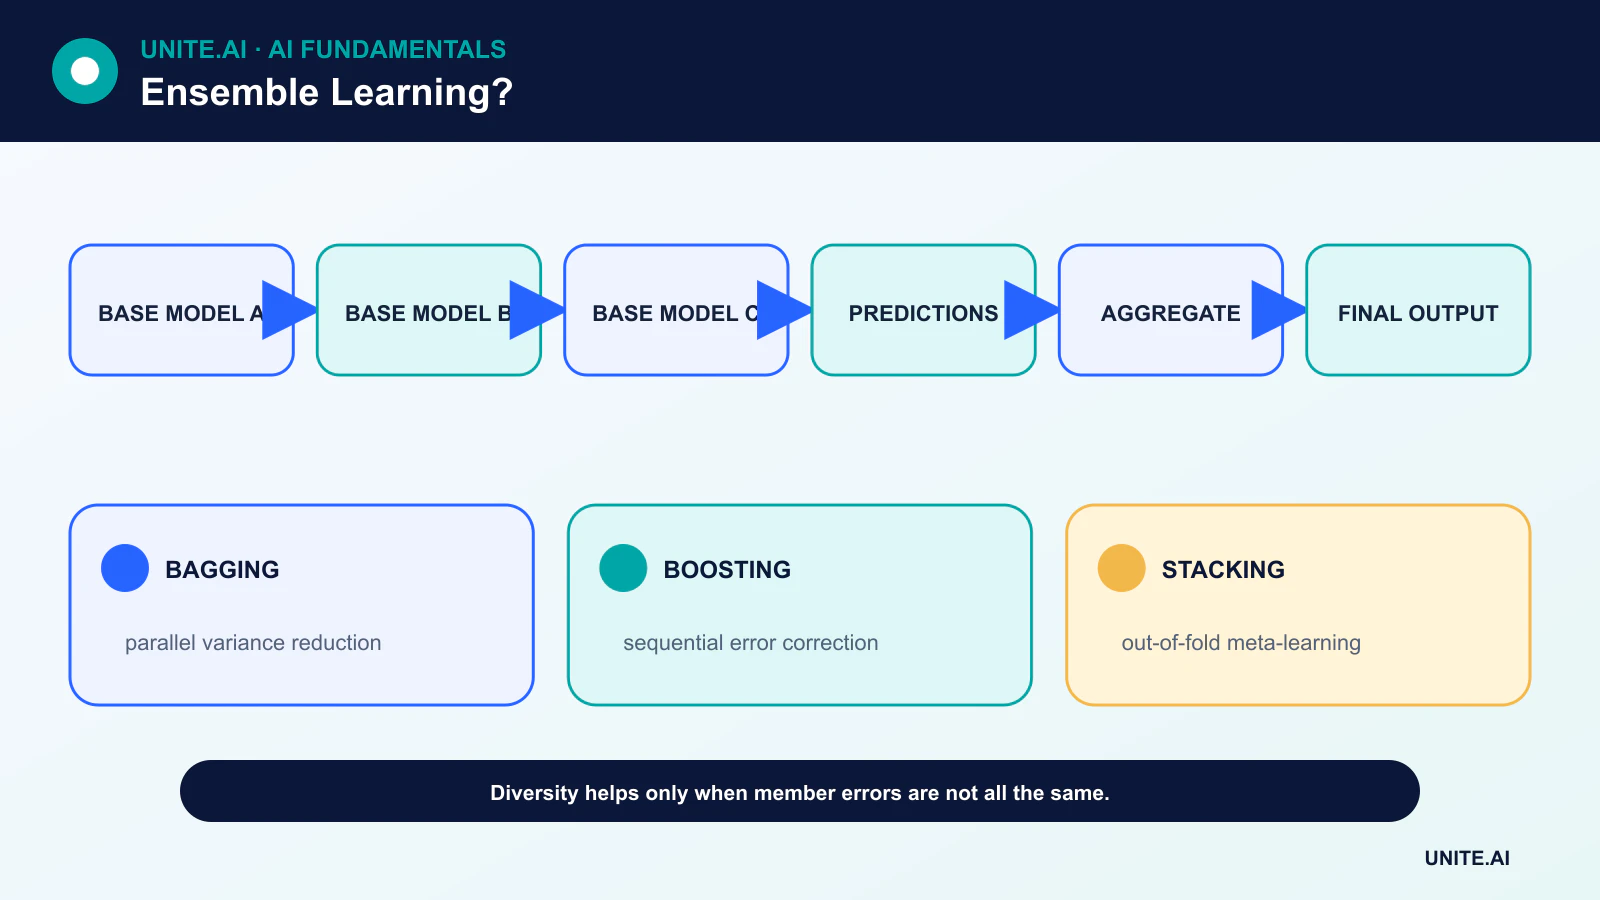
- Bagging træner medlemmer parallelt på genprøvet data; boosting træner lærere sekventielt for at rette fejl.
- Stacking træner en meta‑model på out‑of‑fold‑forudsigelser, ikke på in‑sample‑forudsigelser.
- Nøjagtighedsgevinster skal afvejes mod latenstid, kalibrering, fortolkelighed og vedligeholdelsesomkostninger.
Afstemning og gennemsnit
Hard voting vælger den klasse med flest stemmer. Soft voting gennemsnitliggør klassesandsynligheder, typisk efter kalibrering. Regression‑ensembler gennemsnitliggør ofte numeriske forudsigelser. Vægtede versioner giver stærkere medlemmer mere indflydelse.
Et gennemsnit kan reducere varians, når fejl ikke er perfekt korrelerede. Det kan ikke reparere et fælles dataproblem, label‑fejl eller manglende undergruppe. Mangfoldighed bør måles gennem uenighed og fejl‑overlap, ikke antages ud fra forskellige modellnavne.
Bagging og random forests
Bootstrap‑aggregating træner modeller på genprøvede datasæt og gennemsnitliggør dem. Et decision tree har høj varians, hvilket gør det til en naturlig kandidat til bagging.
Random forests tilføjer tilfældig funktion‑udvælgelse ved split, hvilket reducerer korrelation mellem træerne. Out‑of‑bag‑eksempler kan estimere ydeevne, men et endeligt ubrudt test‑sæt forbliver værdifuldt for model‑udvælgelse og deployments‑påstande.
Boosting
Boosting bygger en additiv model i faser. Senere lærere fokuserer på eksempler eller residual‑mønstre, som det aktuelle ensemble håndterer dårligt. AdaBoost ændrer vægtene på eksempler; gradient boosting tilpasser lærere til negative gradienter af et valgt tab.
Boostede træer kan modellere komplekse tabel‑relationer, men dybe træer, for mange runder og lækage kan stadig overfitte. Læringsrate, trædybde, delprøveudtagning og tidlig stopning er centrale kontrolparametre.
Stacking og blending
Stacking skaber en anden‑niveau‑model, der lærer at kombinere basis‑forudsigelser. For at undgå lækage skal hver trænings‑række for meta‑modellen komme fra et basis‑model, der ikke er trænet på den pågældende række. Kryds‑validering genererer disse out‑of‑fold‑forudsigelser.
Blending bruger et separat hold‑out‑sæt til meta‑modellen, hvilket er enklere men reducerer den tilgængelige træningsdata. Begge tilgange kræver identisk forbehandling og versionsstyring ved inferens.
Operationelle afvejninger
Et ensemble kan multiplicere hukommelse, beregning og fejltolerance. Det kan være sværere at forklare, kalibrere og opdatere konsistent. Destillation kan komprimere et ensemble til en mindre model, men eleven skal evalueres uafhængigt.
En praktisk udvælgelse sammenligner ydeevne, tail‑latens, kalibrering, ressourceforbrug og fejl‑omkostninger. Nogle gange er én vel‑regulariseret model at foretrække frem for en lille nøjagtighedsforbedring fra en skrøbelig stak.
Hvorfor ensembler virker
Ensemble‑læring kombinerer flere modeller, så deres fejl delvist ophæver hinanden, eller deres styrker dækker forskellige områder. Bagging træner modeller på genprøvet data og gennemsnitliggør forudsigelser, hvilket reducerer varians; random forests tilføjer tilfældig funktion‑udvælgelse for at dekorellere træerne. Boosting træner lærere sekventielt for at fokusere på residual‑fejl, hvilket ofte reducerer bias men øger følsomhed over for støj og tuning. Stacking træner en meta‑model på basis‑model‑forudsigelser. Mangfoldighed skal være nyttig: at gennemsnitliggøre identiske modeller tilføjer omkostning uden væsentlig fejlreduktion.
Korrelation mellem fejl bestemmer gevinsten. Mangfoldighed kan komme fra datasamples, funktioner, algoritmer, hyperparametre, tilfældig initialisering eller tidsvinduer. Hard voting kasserer selvtillid; soft voting gennemsnitliggør sandsynligheder men kræver kompatibel kalibrering. Regression kan gennemsnitliggøres eller anvende robust aggregation. I stacking er out‑of‑fold‑forudsigelser essentielle — træning af meta‑modellen på basis‑forudsigelser fra de samme tilpassede data forårsager lækage. Behold en simpel gennemsnits‑baseline, før du adopterer en kompleks kombinerer.
Evaluering, kalibrering og usikkerhed
Sammenlign hvert medlem og ensemblet på et hold‑out‑sæt med identisk forbehandling. Rapportér opgave‑metrikker, kalibrering, undergruppe‑fejl, varians på tværs af fold eller frø, samt ressourceomkostninger. Et ensemble kan forbedre gennemsnitlig kvalitet, mens det skjuler et fælles blind‑spot forårsaget af fælles data eller labels. Undersøg uenighed: den kan afsløre usikkerhed, men korrelerede, selvsikre forkerte modeller kan stadig være enige. Kalibrer det endelige ensemble, ikke kun medlemmerne, og valider afvisnings‑thresholds mod gennemgangskapacitet og konsekvenser.
Out‑of‑bag‑estimater er nyttige for baggede modeller, men erstatter ikke en endelig, deployments‑repræsentativ test. For tidsseriedata skal man undgå genprøvning, der bryder rækkefølgen. For sikkerheds‑kritiske anvendelser skal man teste medlems‑fejl, forældede modeller og adversarial input. Vægtede ensembler kan overfitte valideringsdata, når mange kandidater afprøves. Registrér kandidat‑udvælgelse og brug indlejret validering, hvor tuning er omfattende.
Serving og vedligeholdelse
Ensembler multiplicerer hukommelse, latenstid, energi og operationelle afhængigheder. Destillation kan komprimere den samlede adfærd til én model, men kræver ny validering. Versionsstyr både medlemmer, forbehandling, vægte og routing som én artefakt; definér adfærd når et medlem tidsudløber eller producerer et ugyldigt resultat. Overvåg medlems‑forudsigelser og uenighed, så tavs fejl bliver synlig. Afsked med overflødige medlemmer og gen‑træn bevidst. Ensembler forbedrer forudsigelser, når fejl‑mangfoldighed er reel, men de kan ikke gøre biased træningsdata eller et ugyldigt mål til pålidelig evidens.
Arbejdseksempel: et ensemble til varsling om alvorligt vejr
Et prognose‑team kombinerer et fysisk‑model‑feature‑sæt, gradient‑boosted‑tree, neuralt sekvens‑model og kalibreret statistisk baseline. Out‑of‑fold‑forudsigelser træner en simpel meta‑model, og evalueringen bruger fremtidige storme, som er fuldstændigt udelukket fra medlems‑træning. Metrikker omfatter hændelses‑recall, falske alarmer, lead‑time, kalibrering, geografisk ydeevne og pålidelighed under sjældne ekstreme forhold. Medlems‑fejlkorrelation undersøges, fordi delt input‑data kan skabe fælles blind‑spots.
Serving gemmer hver forudsigelse og det samlede resultat. Hvis et medlem er utilgængeligt, bruger systemet en forvalideret degraderet konfiguration i stedet for tavst at renormalisere. Uenighed udløser ekstra gennemgang, men behandles ikke som usikkerhed i alle tilfælde. Overvågning sporer medlems‑drift, latenstid og storm‑resultater, med vægte kun opdateret gennem kontrolleret validering. Offentlige advarsler forbliver under autoriserede meteorologiske beslutningsprocesser; ensemblet forbedrer evidensen, men redefinerer ikke autonomt alarm‑politikken.
Implementerings‑beviser og operationel beredskab
En produktions‑beslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver væsentlig fejl. Etabler en reproducerbar baseline og et versioneret evaluerings‑sæt før tuning. Test almindelige tilfælde, grænsetilstande, malformed eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, som mest sandsynligt er underforsynet. Mål opgave‑kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal autoritet for udgivelse, undtagelser, ændringer, rollback og pensionering tildeles. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operationel telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑helbred, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑thresholds og en respons‑ejer, gennemgå derefter real‑world‑evidens efter deployment i stedet for at antage, at offline‑ydeevne vedvarer. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system skal også have dokumenterede genoprettelses‑, hændelses‑lærings‑, slette‑ og opbevaringsprocedurer samt et klart punkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er en random forest et ensemble?
Ja. Den kombinerer mange randomiserede decision‑træer, typisk ved afstemning eller gennemsnit.
Kan identiske modeller danne et nyttigt ensemble?
Det kan de, hvis træningsdata, initialisering eller sampling skaber tilstrækkeligt forskellige fejl, men ren duplikation tilfører ingen fordel.
Primære referencer












