
Grundlæggende AI
Hvad er lineær regression?

 Føj Unite.AI til dine foretrukne kilder på Google
Lineær regression modellerer en kontinuert målvariabel som en lineær kombination af én eller flere input‑funktioner. Den bruges til forudsigelse, estimering og som en gennemsigtig basislinje for at forstå, om en mere kompleks model tilføjer væsentlig værdi.
Ordene uafhængig variabel og afhængig variabel beskriver roller i modellen, ikke påvist årsag‑virkning. En regression kan identificere en sammenhæng, mens forveksling, udvælgelsesbias, omvendt årsagssammenhæng eller målefejl forklarer relationen.
Vigtige pointer
- Målvariablen y modelleres ud fra input‑funktionerne X; den ældre version af artiklen vendte disse etiketter om i en formelforklaring.
- Den almindelige mindst‑kvadraters metode minimerer summen af kvadrerede residualer.
- Residual‑diagnostik og antagelser er vigtige for inferens og usikkerhed.
- Ridge‑ og lasso‑regularisering hjælper, når forudsigere er mange eller korrelerede.
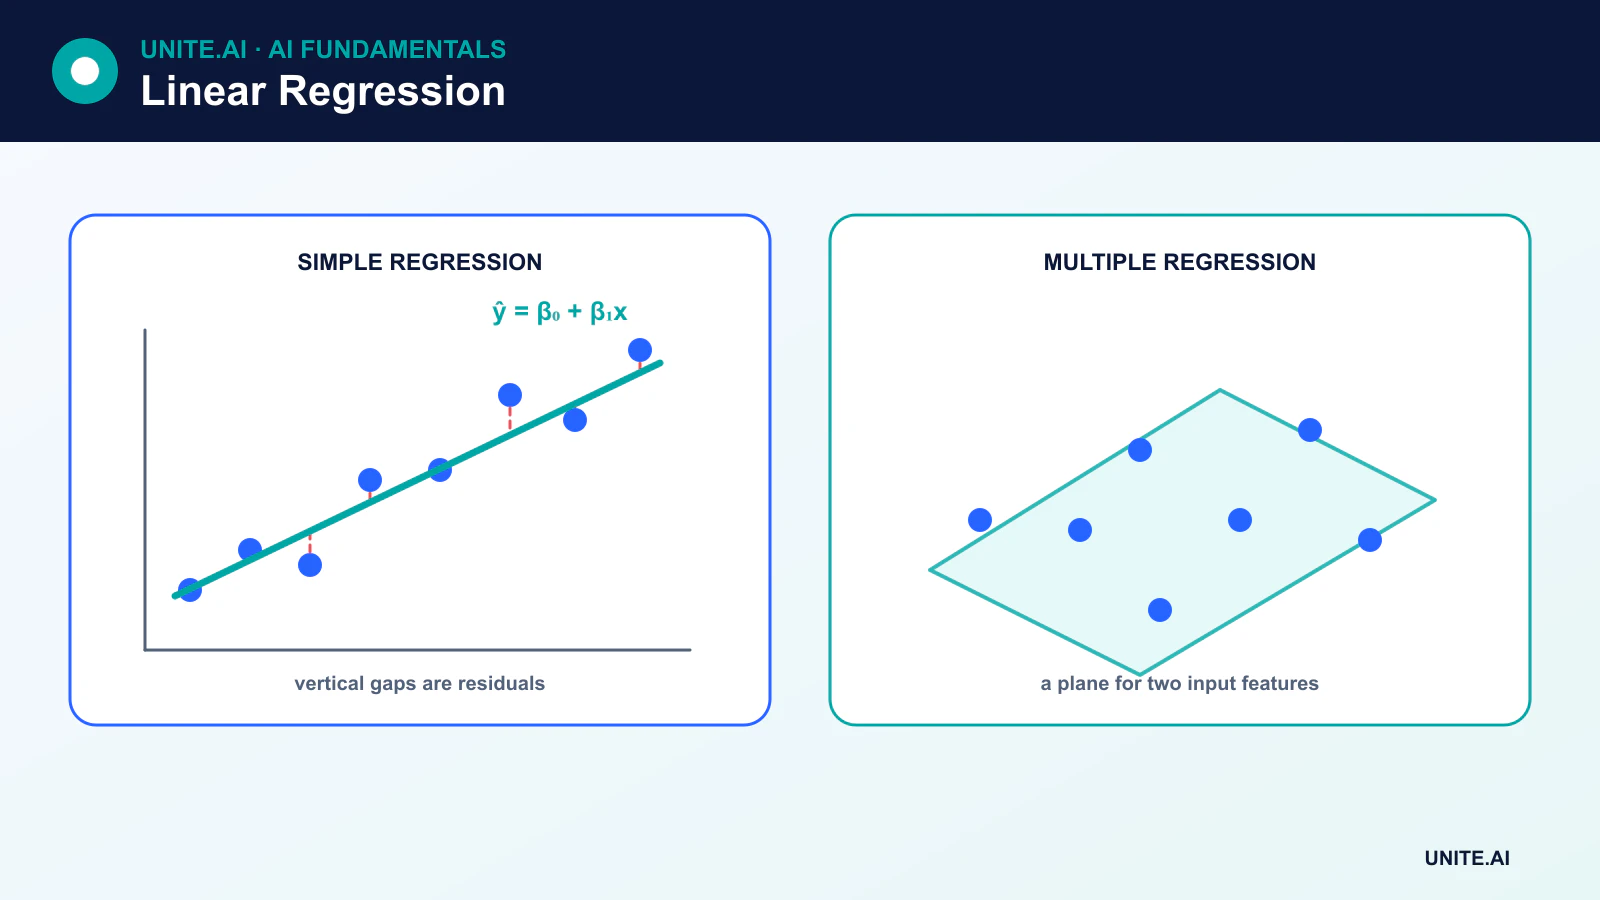
Simpel lineær regression
Med én funktion er modellen:
ŷ = β₀ + β₁x
β₀ er skæringspunktet (intercept) og β₁ er hældningen. Residualet for observation i er yᵢ - ŷᵢ. Den almindelige mindst‑kvadraters metode (OLS) vælger koefficienter, der minimerer summen af kvadrerede residualer.
Hældningen estimerer den forventede ændring i målvariablen, der er forbundet med en enhedsændring i funktionen under den tilpassede model. Den bør ikke beskrives som en kausal effekt, medmindre studiedesignet og antagelserne understøtter kausal identifikation.
Multipel lineær regression
Med p funktioner:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Hver koefficient fortolkes betinget af de øvrige medtagne funktioner. Multipel regression kan inkorporere kategoriske variable via kodning, polynomielle termer og interaktioner. Den forbliver “lineær”, fordi den er lineær i koefficienterne, selvom transformerede funktioner som x² indgår.
Antagelser og diagnostik
For forudsigelse er hovedspørgsmålet, hvor godt modellen generaliserer. For klassiske koefficient‑tests og -intervaller bliver yderligere antagelser vigtige:
- Linearitet: den betingede middelværdi repræsenteres af den valgte lineære form.
- Uafhængige eller korrekt modellerede fejl: gentagne, grupperede, rumlige eller tidsseriedata kan kræve en anden fejlstruktur.
- Konstant fejlvaryans: heteroskedasticitet påvirker standardfejl og usikkerhedsvurderinger.
- Begrænset multikollinearitet: stærkt korrelerede forudsigere gør individuelle koefficienter ustabile.
- Residualfordeling: normalitet er relevant for visse små‑sample inferenser, men det er ikke et krav, at hver funktion er normalfordelt.
Residual‑plot, leverage‑ og påvirkningsmål samt domænegennemgang kan identificere outliers, ikke‑linearitet, skiftende varians eller observationer, der dominerer tilpasningen.
Evaluering af forudsigelser
- Mean absolute error (MAE) gennemsnitlig absolut residualstørrelse.
- Mean squared error (MSE) giver større fejl mere vægt.
- Root mean squared error (RMSE) bringer den kvadrerede fejl tilbage til målvariablens enheder.
- R² sammenligner residualvariation med en konstant basislinje på de evaluerede data.
R² er ikke nøjagtighed, fastslår ikke kausalitet, og kan være negativ på hold‑out data. Validering bør matche den reelle forudsigelsesindstilling, herunder tids‑ eller gruppe‑bevidste opdelinger, når det er nødvendigt.
Ridge, lasso og elastic net
Ridge‑regression tilføjer en L2‑straf, der krymper koefficienterne og stabiliserer korrelerede forudsigere. Lasso tilføjer en L1‑straf og kan sætte koefficienter til nul. Elastic net kombinerer begge. Funktioner kræver typisk kompatibel skalering, før disse straffe sammenlignes.
Regularisering introducerer bias til gengæld for lavere varians og kan reducere overfitting. Strafstyrken vælges ved validering, ikke på det endelige test‑sæt.
Når lineær regression er det forkerte værktøj
En lineær model kan fejle, når relationerne er stærkt ikke‑lineære, fejl afhænger af tidligere værdier, målfordelinger kræver specialiseret modellering, eller få outliers dominerer den kvadrerede tab. Decision trees, generaliserede lineære modeller, tidsserie‑modeller, robust regression eller ikke‑lineære metoder kan passe bedre.
Selv når en kompleks model vinder, forbliver lineær regression en værdifuld basislinje. Hvis et stort system ikke kan overgå den pålideligt, kan den ekstra kompleksitet være ubegrundet.
Modelantagelser, estimering og diagnostik
Lineær regression modellerer den betingede middelværdi af et numerisk udfald som et intercept plus vægtede forudsigere. Den almindelige mindst‑kvadraters metode vælger koefficienter, der minimerer kvadrerede residualer. Koefficienterne beskriver den forventede ændring i udfaldet for en enhedsændring i forudsigeren, mens andre medtagne variable holdes konstante, under den specificerede model. Dette er en sammenhæng, medmindre antagelser om kausal identifikation og studiedesign retfærdiggør mere. Enheder, kodning, transformationer, interaktioner og referencekategorier bestemmer fortolkning, så koefficienter uden et datadictionary er ufuldstændige.
Klassisk inferens er afhængig af antagelser om funktionel form, uafhængige fejl, konstant varians og fejldistribution for specifikke tests og intervaller. Residual‑vs‑tilpasset‑plot afslører ikke‑linearitet eller heteroskedasticitet; Q–Q‑plot vurderer hale‑adfærd; leverage‑ og påvirknings‑diagnostik identificerer observationer, der stærkt påvirker estimaterne. Korrelerede forudsigere forøger usikkerheden og gør individuelle koefficienter ustabile, selvom forudsigelserne er tilstrækkelige. Robuste standardfejl, transformationer, splines, hierarkisk struktur eller en anden model kan være nødvendig i stedet for at slette upraktiske datapunkter.
Regularisering, evaluering og ansvarlig brug
Ridge‑regression krymper koefficienter med en L2‑straf, mens lasso kan sætte nogle til nul med en L1‑straf; elastic net kombinerer dem. Standardiser forudsigere, når strafskalaen skal være sammenlignelig, og vælg styrken ved hjælp af validering eller kryds‑validering. Evaluer mean absolute error, root mean squared error, residualfordeling, kalibrering på tværs af intervaller og usikkerhed, med tids‑ eller gruppe‑opdelinger, der afspejler brugen. Sammenlign med en gennemsnits‑basislinje og ikke‑lineære alternativer, men behold lineære modeller, når gennemsigtighed og stabilitet er værdifulde.
Ekstrapolation ud over det observerede forudsigelsesinterval følger den tilpassede linje uden evidens og kan være farlig. Overvåg funktions‑intervaller, manglende data, residualer og undergruppe‑fejl i produktion. Prediktionsintervaller beskriver individuel udfalds‑usikkerhed og er bredere end konfidensintervaller for gennemsnittet; begge kræver antagelser. Undgå at kontrollere for variable, der introducerer kausal bias, når målet er effekt‑estimering. Lineær regression er et præcist værktøj for en defineret relation, ikke en universel garanti for, at verden er lineær eller at en koefficient repræsenterer en intervention.
Praktisk eksempel: estimering af leveringstid
Et logistikteam modellerer leveringsvarighed ud fra afstand, serviceniveau, region, ugedag og kendt vejr. De inspicerer ikke‑lineære residualmønstre og tilføjer berettigede splines og interaktioner i stedet for at behandle en lineær ligning som bogstavelig fysik. Transportør‑ og rute‑grupper definerer validerings‑folds. Mean absolute error, tail error, interval coverage og systematisk bias rapporteres. Annullerede leveringer og data registreret efter ankomst udelades eller modelleres eksplicit.
Koefficienterne dokumenteres i enheder og kontrolleres for ustabilitet under korrelerede forudsigere. Modellen afviser ekstrapolation ud over validerede afstands‑ og region‑intervaller. Prediktionsintervaller ledsager estimater, og efterfølgende planlægning bruger deres usikkerhed. Overvågning sporer funktionsintervaller, residualer, intervaldækning og bias efter netværksændringer. Et kausalt påstand om transportør eller vejr fremsættes ikke ud fra de forudsigende koefficienter; operationelle eksperimenter eller stærkere identifikation ville være påkrævet for at understøtte en intervention.
Implementeringsbeviser og operationel beredskab
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar basislinje og et versionsstyret evalueringssæt før tuning. Test almindelige tilfælde, grænsebetingelser, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latency, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operationel telemetri bør afsløre inputkvalitet, outputadfærd, model‑ eller regel‑version, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, gennemgå derefter real‑world beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system har også brug for dokumenteret genopretning, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Kræver lineær regression kun én input‑variabel?
Nej. Simpel regression har én forudsigelse, mens multipel lineær regression kan bruge mange numeriske, kodede kategoriske, transformerede og interaktionsfunktioner.
Kan lineær regression bevise kausalitet?
Nej. Kausal fortolkning kræver et holdbart forskningsdesign og antagelser om forveksling, udvælgelse, måling og intervention. En forudsigende koefficient alene beskriver en sammenhæng i den tilpassede model.
Primære referencer












