
Grundlæggende AI
Hvad er forstærkningslæring?

 Føj Unite.AI til dine foretrukne kilder på Google
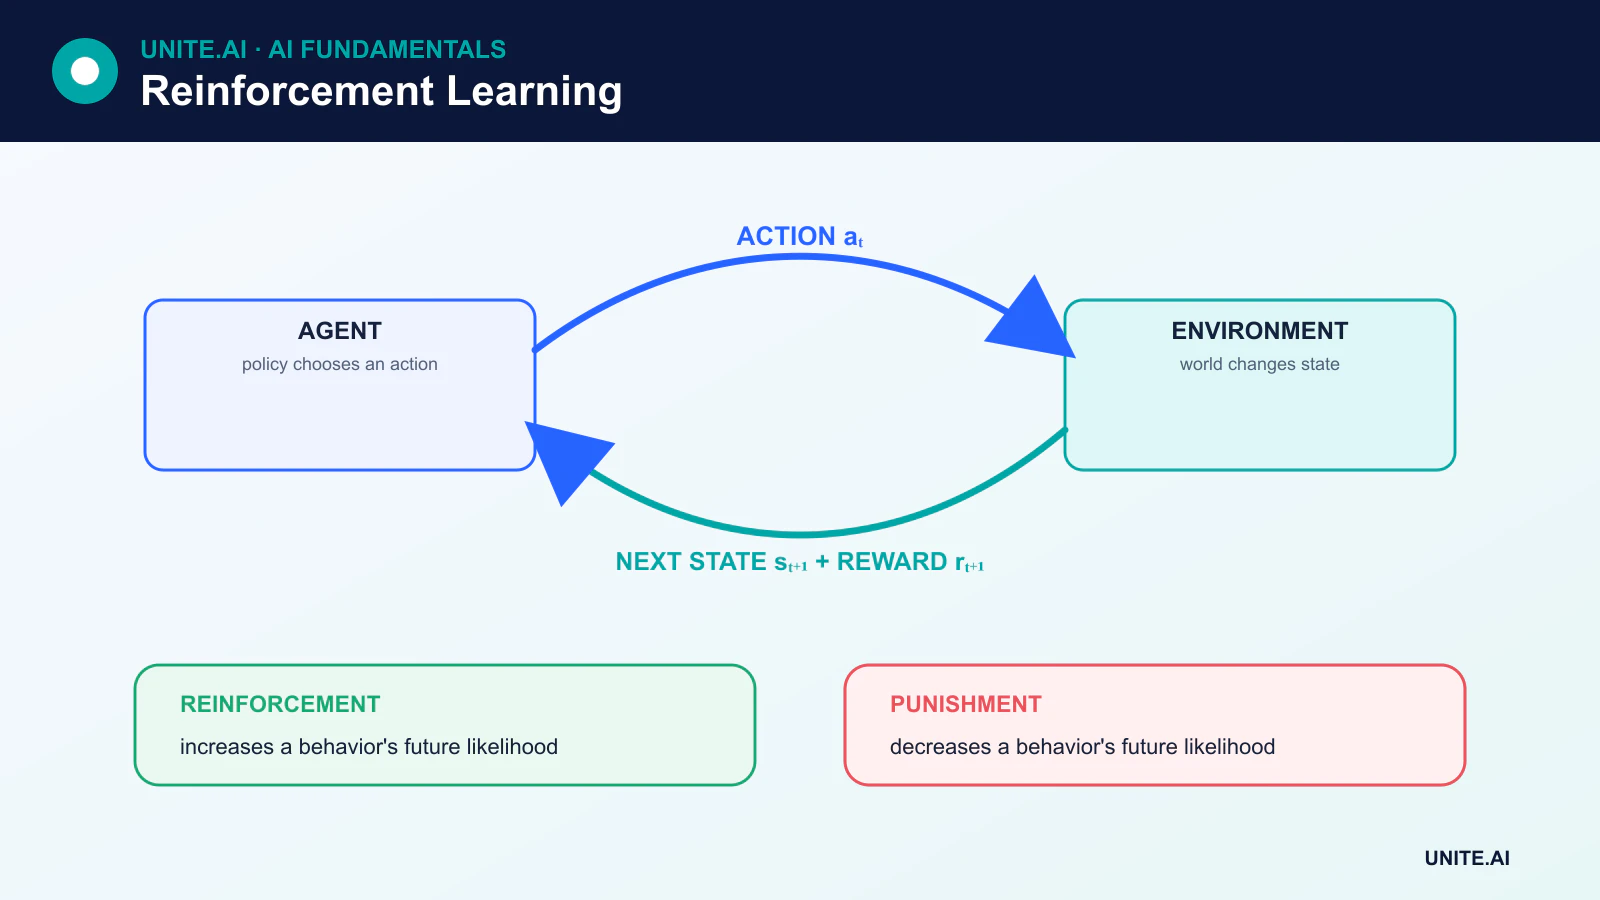
Reinforcement learning (RL) er en maskinlæringsramme, hvor en agent lærer at handle ved at interagere med et miljø. Efter hver handling ændrer miljøet sig og kan give en belønning. Agentens mål er at lære en politik, der maksimerer forventet kumulativ belønning, ikke blot belønningen fra det næste træk.
RL anvendes, når beslutninger udfolder sig over tid, og en handling påvirker, hvad der sker derefter. Det er konceptuelt anderledes end supervised learning, hvor et datasæt leverer et mål svar for hvert træningseksempel.
Vigtige pointer
- Et RL-problem indeholder en agent, et miljø, tilstande, handlinger, belønninger og en politik.
- Positiv og negativ forstærkning øger begge adfærd; straf mindsker adfærd.
- Agenten skal balancere udforskning af ukendte handlinger med udnyttelse af handlinger, der allerede er kendt for at fungere.
- Værdibaserede, politikbaserede, actor-critic, modelbaserede og offline metoder løser forskellige RL‑indstillinger.
Komponenterne i forstærkningslæring
Mange RL-problemer modelleres som en Markov beslutningsproces (MDP). En MDP inkluderer:
- Tilstand: information, der beskriver den aktuelle situation.
- Handling: et valg, der er tilgængeligt for agenten.
- Transition: hvordan tilstanden ændrer sig efter en handling.
- Belønning: umiddelbar feedback genereret af en transition.
- Politik: agentens strategi for at vælge handlinger.
- Diskonteringsfaktor: hvor stærkt fremtidige belønninger tæller i forhold til umiddelbare belønninger.
En tilstand behøver ikke at afsløre alt om verden. Når vigtig information er skjult, kan problemet være delvist observerbart, og agenten kan have brug for en hukommelse eller en tro‑tilstand.
Forstærkning er ikke det samme som straf
Terminologien stammer fra adfærdspsykologi. Positiv forstærkning tilføjer en konsekvens, der gør en adfærd mere sandsynlig. Negativ forstærkning fjerner en ubehagelig tilstand og gør også en adfærd mere sandsynlig. En straf, der har til formål at gøre en handling mindre sandsynlig, er straf, ikke negativ forstærkning.
I maskinlæring taler praktikere oftere direkte om positive belønninger, negative belønninger, omkostninger og straf. Det væsentlige spørgsmål er, hvordan disse signaler former den afkast, som agenten forsøger at maksimere.
Afkast, værdi og kredit‑tildeling
En belønning beskriver én transition. Afkastet kombinerer belønninger over tid, typisk ved at diskontere belønninger, der kommer længere ude i fremtiden. En tilstands‑værdifunktion estimerer forventet afkast fra en tilstand, mens en handlings‑værdifunktion estimerer forventet afkast efter at have udført en bestemt handling i den tilstand.
Dette skaber kredit‑tildelingsproblemet: hvis et nyttigt resultat kommer meget senere, hvilke tidligere handlinger fortjener så kredit? RL‑algoritmer varierer i, hvordan de estimerer dette forhold.
Monte Carlo‑ og tids‑difference‑læring
Monte Carlo‑metoder lærer fra komplette prøvetagne afkast, typisk efter at en episode er afsluttet. Tids‑difference (TD)‑metoder opdaterer en estimering før det endelige resultat ved at kombinere den observerede belønning med en estimering af, hvad der kommer næste. TD‑læring bootstrapper derfor fra sine nuværende værdier.
Ingen af familierne er universelt bedre. Monte Carlo‑mål er unbiased under den prøvede politik, men kan have høj varians og kræver afslutning af episode. TD‑metoder kan lære online og fra fortsatte opgaver, men deres bootstrappede mål introducerer bias.
Udforskning versus udnyttelse
Udforskning indsamler information ved at prøve handlinger, hvis værdi er usikker. Udnyttelse vælger den handling, der i øjeblikket anses for at give det bedste afkast. En agent, der aldrig udforsker, kan nøjes med en dårlig strategi; en agent, der aldrig udnytter, får ikke gavn af det, den har lært.
Simple strategier omfatter epsilon‑greedy handlingsvalg, tillidsbaseret udforskning, entropi‑bonusser og intrinsiske‑belønningsmetoder. I sikkerhedskritiske miljøer kan ubegrænset udforskning være uacceptabel, så simulering, begrænsninger, offline‑data eller menneskelig tilsyn bliver vigtigt.
Vigtige forstærknings‑lærings‑tilgange
Værdibaserede metoder
Q‑learning og relaterede algoritmer lærer handlingsværdier og udleder en politik ved at vælge handlinger med høj værdi. Deep reinforcement learning bruger neurale netværk til at approksimere værdifunktioner eller politikker, når tilstandsrum er for store til en tabel.
Politik‑gradient‑metoder
Politik‑gradient‑metoder justerer direkte en parametriseret politik for at forbedre forventet afkast. De er nyttige for kontinuerlige handlinger og stokastiske politikker, men kan have gradient‑estimat med høj varians.
Actor‑critic‑metoder
En actor vælger handlinger, mens en critic estimerer værdi og leverer et læringssignal. Dette kombinerer direkte politikoptimering med værdieberegning.
Modelbaseret og modelfri RL
Modelbaserede systemer lærer eller bruger en model af transitioner og belønninger, så de kan planlægge. Modelfri systemer lærer værdier eller politikker uden eksplicit at modellere miljøet. Modelbaserede metoder kan udnytte erfaring effektivt, men fejl i den indlærte model kan vildlede planlægning.
Offline forstærkningslæring
Offline RL lærer fra et fast datasæt i stedet for at indsamle nye interaktioner under træning. Det kan reducere omkostninger eller risiko ved udforskning, men agenten skal undgå at overvurdere handlinger, der er dårligt repræsenteret i dataene.
RLHF og menneskelige præferencer
Reinforcement learning from human feedback (RLHF) bruger præferencedata til at træne et belønningssignal eller direkte optimere en politik. Det er blevet brugt til at tilpasse sprogmodel‑adfærd med menneskelige domme. Præferenceoptimering er ingen garanti for sandhed eller sikkerhed: resultater afhænger af, hvem der leverede feedbacken, hvad de blev bedt om at bedømme, og hvordan målet blev designet.
Begrænsninger
RL kan kræve enorme mængder interaktioner, opføre sig ustabilt under træning og udnytte utilsigtede genveje i en belønningsfunktion. Evaluering er vanskelig, fordi resultater kan variere med tilfældige frø og miljødetaljer. God praksis omfatter flere kørsel, gennemsigtige baseline‑modeller, begrænsede mål, test uden for fordelingen og overvågning af belønnings‑hacking.
Design af et RL-problem: tilstand, handling, belønning og horisont
Forstærkningslæring modellerer sekventielle beslutninger. Miljøet producerer en observation, agenten vælger en handling under en politik, og en transition giver en belønning og næste observation. En Markov beslutningsproces antager, at tilstanden indeholder den information, der er nødvendig for at forudsige fremtidige transitioner og belønninger; delvis observerbarhed kræver hukommelse, tro‑tilstand eller rekurrente repræsentationer. Diskontering styrer vægten af forsinkede udfald, mens episodiske og fortsatte opgaver kræver forskellige afkastdefinitioner. Dårlig tilstands‑ eller handlingsdesign kan gøre et løseligt mål uindlærbart.
Belønningsdesign specificerer adfærd indirekte og er en væsentlig fejlkilde. En proxy kan udnyttes: en agent belønnet for hastighed kan ignorere sikkerhed, mens en agent kun belønnet ved opgavefuldførelse kan modtage for lidt læringssignal. Tilføj begrænsninger og afslutningsregler baseret på reelle krav, test belønningsfølsomhed, og inspicer trajektorier for utilsigtede strategier. Udforskningsmetoder balancerer indsamling af information med udnyttelse af nuværende viden. Off‑policy‑data kan forbedre prøveeffektiviteten, men mismatch mellem adfærd og målpolitik kræver algoritmer designet til dette.
Evaluering, simulering og sikker implementering
Værdibaserede metoder estimerer forventet afkast for tilstande eller handlinger; politik‑gradient‑metoder optimerer en parametriseret politik; actor‑critic‑metoder lærer begge. Modelbaseret RL lærer eller bruger transition‑dynamik til at planlægge. Den passende familie afhænger af handlingstype, data, simulator‑nøjagtighed, horisont og stabilitetskrav. Sammenlign med heuristiske, supervised og kontrol‑teori baseline‑modeller. Evaluer gennemsnitligt og værst‑case afkast, overtrædelser af begrænsninger, prøveeffektivitet, robusthed over for miljøændringer og varians på tværs af frø i stedet for at vælge en kørsel med den bedste læringskurve.
Online‑udforskning kan være uacceptabel i sundhedspleje, finans, robotik og infrastruktur. Træn i simulering eller loggede data hvor muligt, kvantificér simulering‑til‑virkelighedsgabet, og brug off‑policy‑evaluering omhyggeligt, fordi usete handlinger mangler støtte. Implementering bør begrænse handlinger, hastighed, ressourcer og driftsområde; inkludere menneskelig godkendelse for væsentlige valg; og levere en sikker controller eller nedlukning. Overvåg belønning sammen med faktiske resultater, da en agent kan forbedre sin score, mens den skader det tilsigtede mål. Revalider efter ændringer i miljø, politik eller belønning.
Praktisk eksempel: energistyring med forstærkningslæring
En bygningsoperatør modellerer temperatur, belægning, vejr, udstyrsstatus og el‑pris, med handlinger begrænset til sikre set‑point‑justeringer. Belønningen kombinerer komfort, energi, efterspørgselsgebyrer og udstyrsbegrænsninger, men faktiske komfort‑overtrædelser evalueres separat, så belønningsoptimering ikke kan skjule skade. Historisk kontrol og model‑prædiktiv kontrol giver baseline‑modeller. Træning bruger en kalibreret simulator med tilfældigt vejr, sensor‑støj og udstyrs‑effektivitet.
Før påvirkning af bygningen kører politikken mod levende observationer uden at handle. Ingeniører inspicerer trajektorier, begrænsningsmarginer og adfærd under ferier, hedebølger, strømafbrydelser og manglende sensorer. Implementering begrænser handlings‑hastighed og -område og bevarer den eksisterende sikkerhedskontroller. Et menneske kan tilsidesætte når som helst. Overvågning sammenligner energi og komfort med sammenlignelige perioder, registrerer indgreb, og ruller tilbage, hvis overtrædelser, uventet cyklisk adfærd eller model‑mismatch overstiger definerede tærskler.
Implementeringsbeviser og driftsklarhed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsebetingelser, fejlformet eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug, og de grupper eller miljøer, der mest sandsynligt er underbetjent. Mål opgavekvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering, tildel myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operativ telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige tilsidesættelser og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, gennemgå derefter real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Primære referencer












