Grundlæggende AI
Hvad er dyb forstærkningslæring?

 Føj Unite.AI til dine foretrukne kilder på Google
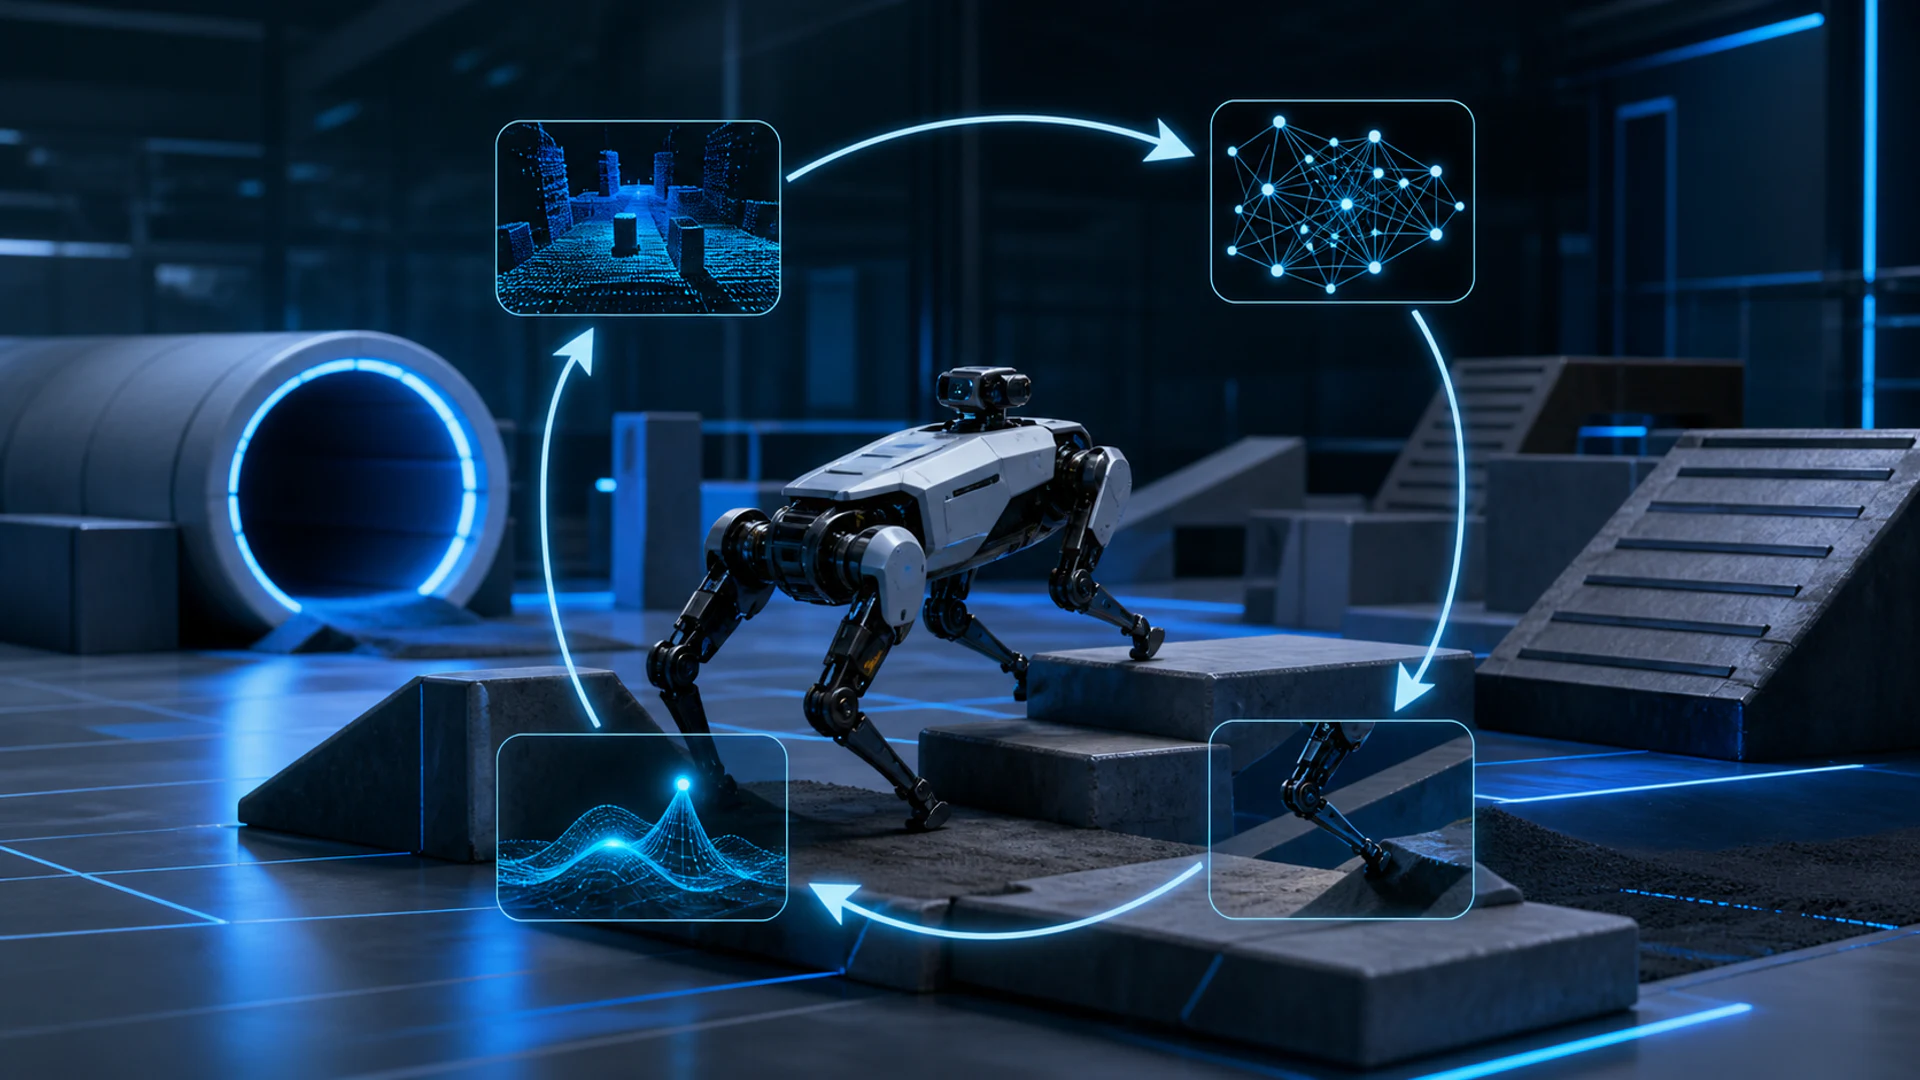
Deep reinforcement learning (deep RL) kombinerer forstærkningslæring med dybe neurale netværk. En agent observerer en tilstand, vælger en handling, modtager en belønning og en ny observation, og justerer derefter en politik eller værdifunktion for at forbedre fremtidige beslutninger.
Det dybe netværk fjerner ikke de svære dele af forstærkningslæring. Det giver en fleksibel måde at repræsentere billeder, sensorstrømme, store handlingsrum eller komplekse værdifunktioner på. Udforskning, forsinket kredit, ustabil træning og sikker evaluering i den virkelige verden forbliver centrale ingeniørmæssige udfordringer.
Vigtige pointer
- Dyb RL lærer sekventielle beslutninger fra interaktion i stedet for en fast tabel med mærkede eksempler.
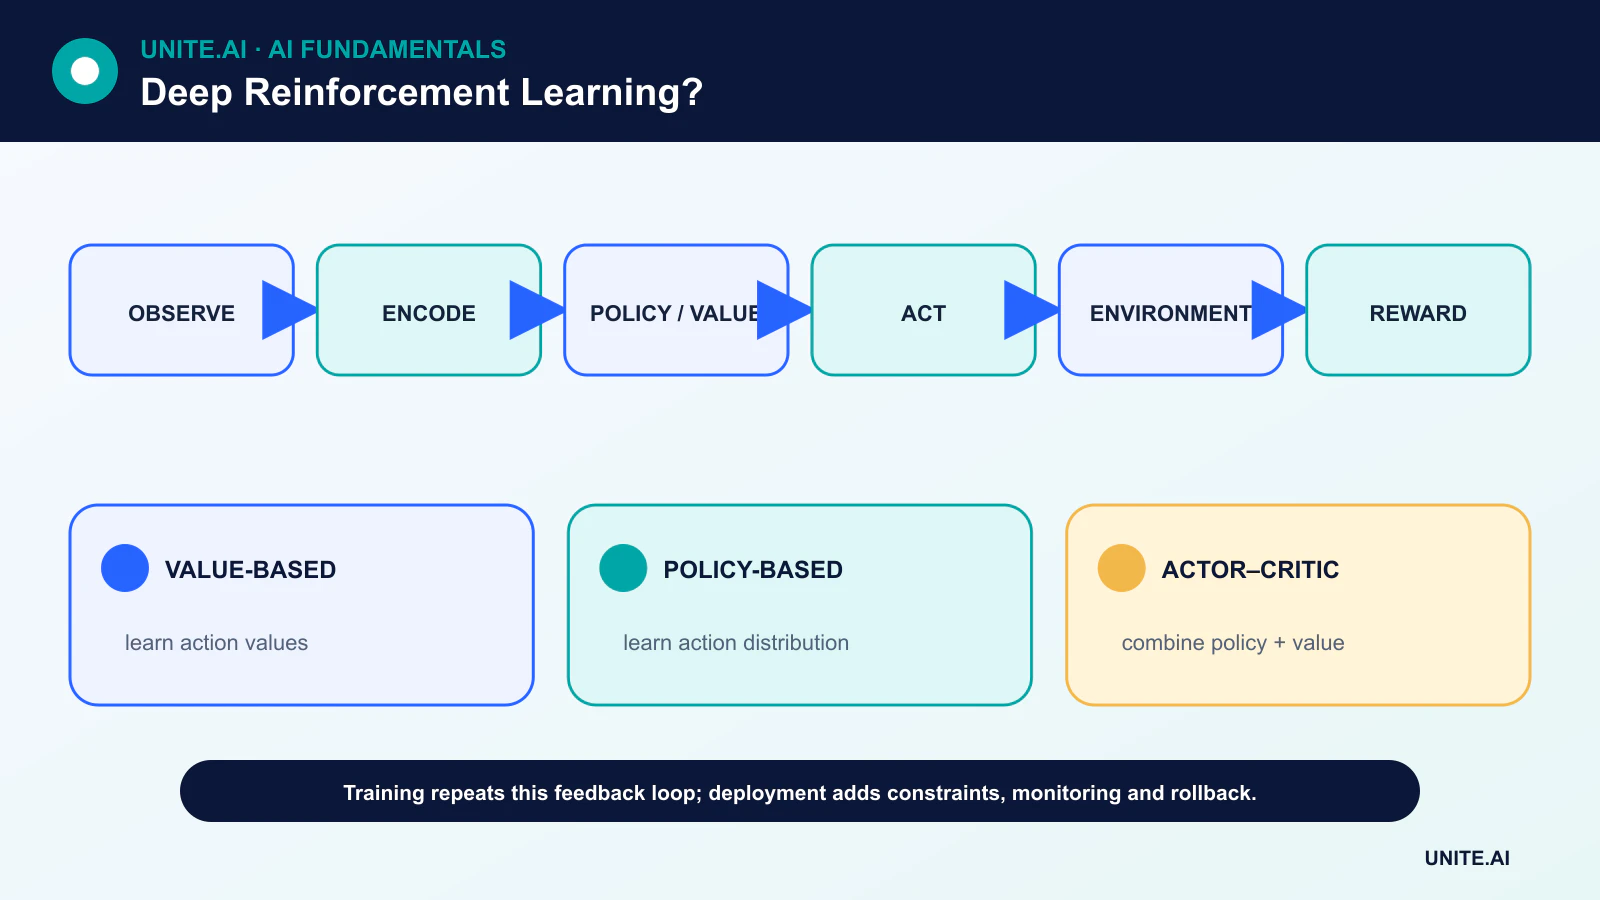
- Værdibaserede metoder estimerer hvor gode handlinger er; politikmetoder lærer handlingsfordelingen direkte; actor‑critic‑metoder kombinerer begge.
- Genafspilningsbuffere, mål‑netværk og omhyggelig belønningsdesign kan forbedre træningen, men ingen af dem garanterer pålidelig adfærd.
- En høj score i en simulator er ikke bevis på robusthed, sikkerhed eller vellykket overførsel til den fysiske verden.
Beslutningsproblemet: tilstande, handlinger og belønninger
Mange dybe RL‑opgaver modelleres som en Markov beslutningsproces. På tidspunkt t modtager agenten en tilstand eller observation s_t, vælger handling a_t og modtager derefter belønning r_{t+1} samt den næste tilstand. Målet er den forventede diskonterede afkast, ikke nødvendigvis kun den næste belønning.
Diskonteringsfaktoren styrer, hvor meget fjerne belønninger vægtes. En belønningsfunktion definerer, hvad optimeringsprocessen vil forfølge, så en ufuldstændig proxy kan producere adfærd, der er teknisk succesfuld, men operationelt uønsket. Dette er en grund til, at belønningsdesign og test af begrænsninger bør have samme opmærksomhed som modelarkitektur.
Værdibaserede, politikbaserede og actor‑critic‑metoder
En værdibaseret algoritme estimerer en tilstands‑ eller handlingsværdi. Deep Q‑netværk bruger et neuralt netværk til at approximere Q‑værdier og vælger typisk handlingen med den højeste estimering, mens der bevares noget udforskning. En policy‑gradient‑algoritme optimerer i stedet en parametriseret politik, der udgiver en handlingsfordeling.
Actor‑critic‑systemer vedligeholder både en actor, som foreslår handlinger, og en critic, som estimerer deres værdi. Dette design understøtter kontinuerlig kontrol, men introducerer interagerende kilder til estimeringsfejl. Dyb RL afhænger derfor af de samme grundlag som deep learning, gradient descent og backpropagation.
Hvorfor genafspilningsbuffere og mål‑netværk hjælper
Efterfølgende erfaringsprøver er korrelerede, mens en netværksopdatering ændrer de mål, der bruges af senere opdateringer. Experience replay bryder noget af den tidsmæssige korrelation ved at udvælge ældre overgange. Et mål‑netværk ændrer sig langsommere end det online‑netværk, hvilket gør bootstrappede mål mindre volatile.
Disse mekanismer forbedrer træningsstabiliteten, men finjustering er stadig vigtigt. Læringsrate, udforskningsplan, belønningsskala, replay‑sammensætning og netværkskapacitet kan alle påvirke resultatet. Flere tilfældige frø bør rapporteres, da en enkelt kørsel kan være misvisende.
Offline RL, modelbaseret RL og sim‑til‑real
Offline RL lærer fra et fast logført datasæt uden at indsamle nye interaktioner. Det kan være nyttigt, når udforskning er dyr eller usikker, men politikken skal undgå handlinger, der er dårligt repræsenteret i loggen. Modelbaseret RL lærer eller bruger en overgangsmodel til at planlægge, hvilket bytter ekstra antagelser for prøveeffektivitet.
Robotik træner ofte i simulation, randomiserer fysiske parametre og finjusterer eller validerer derefter på hardware. Realitetskløften kan stadig afsløre fejl i perception, timing, kontakt‑dynamik og umodellerede kanttilfælde. Et forstærknings‑læringssystem bør evalueres under forstyrrelser, fordelingsskift og eksplicitte sikkerhedsbegrænsninger.
Evaluering og implementering
En nyttig evaluering adskiller trænings‑ og testmiljøer, rapporterer afkast‑fordelinger i stedet for kun en bedste score, og tjekker overtrædelser af begrænsninger, interventions‑frekvens og værste‑case‑adfærd. For reelle systemer har teams også brug for overvågning, rollback‑procedurer, begrænsede handlingsrum og en menneskelig overstyring.
Dyb RL er mest overbevisende, når beslutninger er sekventielle, feedback er tilgængelig, og håndskrevne kontrolregler er utilstrækkelige. Det er et dårligt valg, når der er rigelige overvågede mærkater, en konventionel optimizer løser problemet, eller udforskning ville bringe mennesker eller aktiver i fare.
Deep RL‑arkitekturer og træningssignaler
Dyb forstærkningslæring bruger neurale netværk til at repræsentere en værdifunktion, politik, miljømodel eller en kombination heraf. Et dybt Q‑netværk forudsiger handlingsværdier og lærer fra temporale‑difference‑mål; experience replay reducerer korrelation mellem opdateringer, mens et mål‑netværk stabiliserer den bevægende målsætning. Policy‑gradient‑metoder optimerer den forventede afkast direkte, og actor‑critic‑metoder bruger en lært critic til at reducere gradient‑varians. Kontinuerlige handlinger kræver ofte deterministiske eller stokastiske actor‑critic‑varianter, mens diskrete høj‑dimensionelle handlinger kræver omhyggelig udforskning og output‑design.
Træning er ikke‑stationær, fordi politikken ændrer de data, den indsamler. Replay‑data bliver off‑policy, bootstrappede mål afhænger af aktuelle estimater, og funktions‑approksimation kan forstærke fejl – kombinationen kaldes nogle gange den dødelige triade. Dobbelt‑estimatorer reducerer overestimering af værdier; fordelings‑funktioner forbedrer kredit‑tildeling; entropi‑bonusser fremmer udforskning; klippede mål begrænser destruktive politikopdateringer. Normaliser observationer og belønninger kun med lækage‑sikker tilstand, og registrer miljø, wrapper, gentagelse af handling, terminering og belønnings‑forbehandling, fordi hver af dem ændrer problemet.
Evaluering, simulatorer og implementeringssikkerhed
Rapporter afkast‑fordelinger på tværs af uafhængige frø og miljø‑instanser, ikke kun den bedste kørsel. Evaluer prøve‑effektivitet, overtrædelser af begrænsninger, katastrofale udfald, følsomhed over for belønnings‑skala og robusthed over for observations‑støj, forsinkelse, aktuator‑fejl og ændrede dynamikker. Sammenlign med scriptet kontrol, klassisk kontrol, overvåget imitation og enklere RL. Hold miljø‑variationer tilbage og test belønnings‑fri resultat‑målinger, fordi en agent kan udnytte den programmerede belønning mens den fejler den tilsigtede opgave. Video‑ og trajektori‑inspektion afslører ofte adfærd, der er skjult af samlet afkast.
Simulation muliggør udforskning, men introducerer en realitetskløft. Randomiser relevant fysik og perception, kalibrer mod reelle målinger, og brug konservativ overførsel. Loggede data eller offline RL undgår online‑udforskning, men kan ikke pålideligt evaluere handlinger, der ikke understøttes af adfærdspolitikken. Produktionssystemer bør begrænse handlingssættet, hastigheden, ressourcerne og drifts‑envelopen; kræve godkendelse for handlinger med høj indvirkning; og inkludere en verificeret sikker controller eller stop. Overvåg politik‑input, handlingsfordeling, belønning, reelle udfald og interventioner, med rollback til en testet politik‑version.
Et konkret kontrol‑eksempel
For lagerrobot‑routing defineres tilstanden ud fra placering, belastning, batteri, nærliggende trafik og opgavekø; handlingerne ud fra tilladte bevægelser og opladningsbeslutninger; og belønningen ud fra fuldført arbejde, energi, trængsel og sikkerhedsbegrænsninger. Træn først i en kalibreret simulator med randomiseret efterspørgsel og sensorsvigt, og skyg derefter reelle beslutninger. Lad aldrig den lærte politik omgå kollisionsundgåelse. Evaluer gennemløb sammen med nærved‑ulykker, deadlocks, batteri‑nødsituationer og værste‑case‑forsinkelse. Projektet lykkes kun, hvis det lagdelte system forbedrer driften uden at overføre uacceptabel udforsknings‑risiko til mennesker eller udstyr.
Eksempel: DRL for datacenter‑køling
Et datacenter begrænser en RL‑agent til godkendte kølings‑setpoints og træner den i en simulator, der er kalibreret ud fra historisk vejr, arbejdsbelastning, temperaturer og udstyrsrespons. Belønningen inkluderer energi, men hårde begrænsninger beskytter separat temperatur, fugtighed og udstyrs‑cykluser. Model‑predictive control og eksisterende regler fungerer som baseline. Evalueringen dækker sæsoner, sensorsstøj, aktuator‑forsinkelse, udstyrs‑tab, usædvanlige belastninger og flere frø, og rapporterer energi, overtrædelser, varians og genopretning.
Den lærte politik kører i skygge‑tilstand før en begrænset zone‑test. En ekstern sikkerhedskontroller beskærer handlinger, og operatører kan overstyre. Handlings‑hastighed, tilstands‑dækning, model‑usikkerhed og faktiske anlægsresultater overvåges; simulator‑afvigelse eller gentagne interventioner udløser rollback. Opdateret udstyr eller kontrol‑logik skaber en ny miljø‑version og validering. Energispare‑foranstaltninger accepteres kun, når pålidelighed, termisk margin, vedligeholdelse og reaktion på fejl forbliver mindst lige så stærke som baseline.
Implementeringsbeviser og driftsparathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, randbetingelser, fejlformateret eller manglende input, fordelingsskift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der udpeges ansvar for udgivelse, undtagelser, ændringer, rollback og udfasning. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Drifts‑telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en respons‑ejer, og gennemgå real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system har også brug for dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er dyb forstærkningslæring det samme som dyb læring?
Nej. Dyb læring leverer funktions‑approksimatorerne; forstærkningslæring leverer interaktionen, belønningen og målet om sekventielle beslutninger.
Betyder en høj belønning, at agenten har lært den tilsigtede adfærd?
Ikke nødvendigvis. Det betyder, at politikken har fundet en adfærd, der scorer højt under den implementerede belønning og miljø. Uafhængige sikkerheds‑ og mål‑overensstemmelses‑tests er stadig påkrævet.
Primære referencer