Grundlæggende AI
Hvad er forstærkningslæring fra menneskelig feedback (RLHF)?

 Føj Unite.AI til dine foretrukne kilder på Google
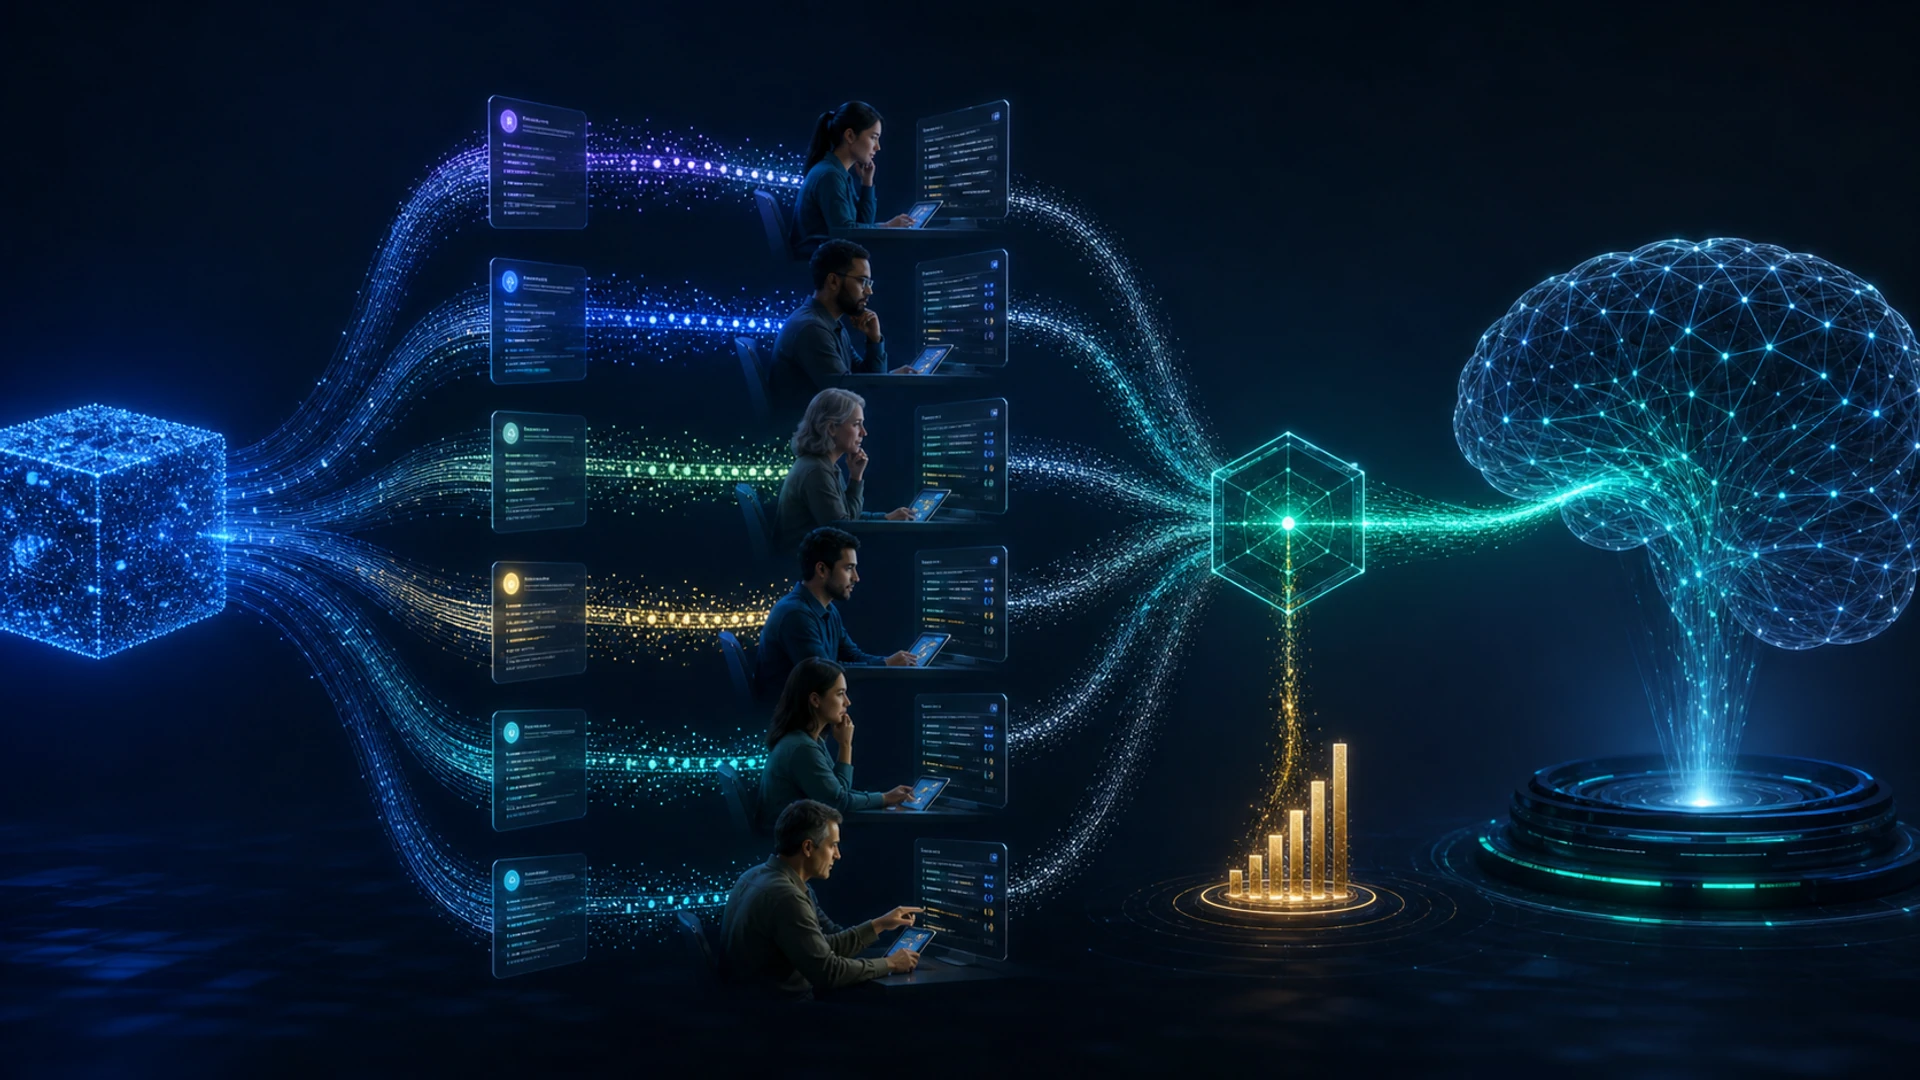
Forstærkningslæring fra menneskelig feedback (RLHF) er en familie af metoder, der bruger menneskelige bedømmelser til at hjælpe med at optimere en model, når den ønskede adfærd er vanskelig at specificere med en simpel automatisk belønning. For sprogmodeller sammenligner folk ofte kandidat‑svar, og en indlært præference‑model omsætter disse sammenligninger til et træningssignal.
RLHF kan gøre en forudtrænet model mere hjælpsom eller bedre tilpasset en skriftlig politik, men det garanterer ikke sandfærdighed eller overensstemmelse med alle brugere. Resultatet afhænger af, hvem der leverer feedback, hvordan prompts udvælges, hvad belønningsmodellen kan repræsentere, og hvordan optimeringen begrænses.
Vigtige pointer
- RLHF følger typisk fortræning og superviseret instruktions‑tuning.
- Parvise præferencer træner en belønnings‑ eller præference‑model; politikoptimering favoriserer derefter output med højere score.
- Belønningshacking, annotatormodstand, distributionsskift og overoptimering forbliver vigtige risici.
- Evaluer den endelige politik direkte for opgavekvalitet, sikkerhed, kalibrering og undergruppe‑effekter.
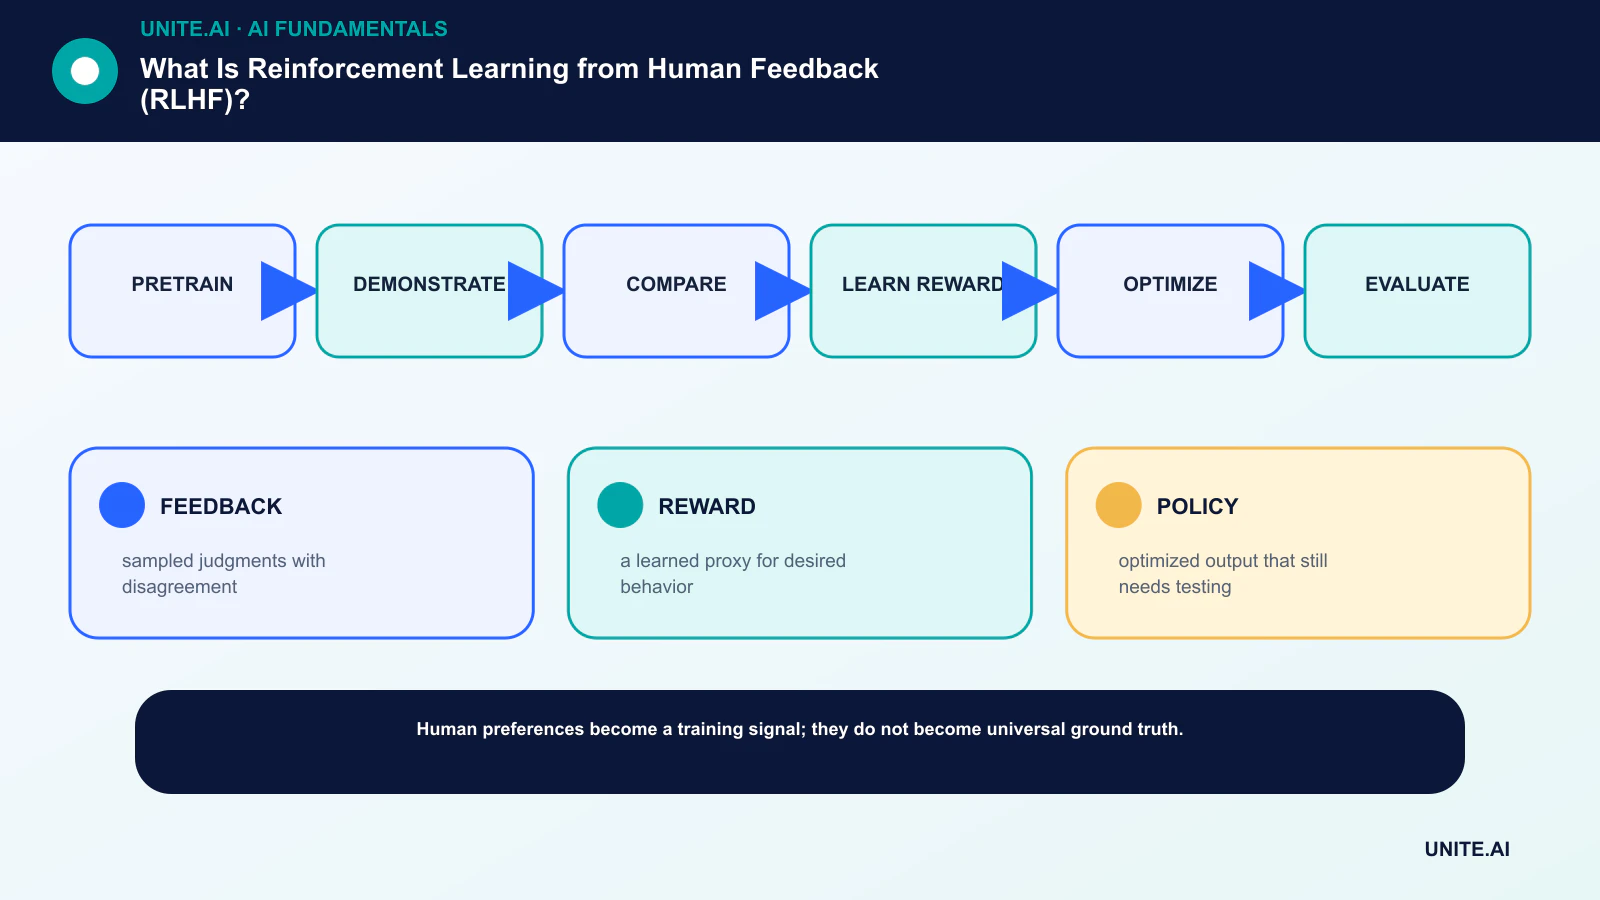
Den almindelige RLHF‑pipeline
En sprogmodel lærer først bred statistisk struktur gennem fortræning. Superviseret finjustering bruger derefter demonstrationer af ønskede svar. Til indsamling af præferencer rangerer eller vælger annotatorer mellem output for den samme prompt.
En belønningsmodel lærer at forudsige disse sammenligninger. En reinforcement-learning algoritme såsom PPO kan optimere sprogmodellen mod den indlærte belønning, mens en straf afskrækker den fra at afvige for meget fra referencepolitikken.
Feedback er måling, ikke grundsandhed
Annotatorer kan være uenige, fordi instruktionerne er tvetydige, ekspertisen varierer, eller værdier reelt er i konflikt. Position, omstændighed, selvsikkerhed og stil kan påvirke præferencer. Et højkvalitetsprogram træner bedømmere, måler enighed, reviderer eksempler og bevarer usikkerhed.
Udvælgelse er også vigtigt. Hvis præference‑sættet udelader vanskelige sprog, domæner eller skadeligt indhold, kan belønningsmodellen ikke pålideligt supervisionere dem. Data‑science‑disciplin er lige så vigtig som optimeringsalgoritmen.
Fejltilstande
Politikken kan udnytte svagheder i den indlærte belønning og producere output, der scorer højt uden at opfylde den underliggende intention. Overdreven optimering kan reducere diversitet, forstærke en foretrukken stil eller få modellen til at være selvsikkert imødekommende.
Selve belønningsmodellen kan fejle uden for sin træningsfordeling. Teams bør teste modstandende prompts, faktuelle opgaver, afvisningsgrænser, kalibrering og adfærd ved forskellige optimeringsstyrker i stedet for kun at stole på én samlet præference‑vinderate.
Alternativer og komplementer
Direct Preference Optimization lærer fra præference‑par uden at tilpasse en separat politik gennem en online forstærknings‑læringssløjfe. Afvisnings‑sampling, superviseret præference‑finjustering, regelbaseret feedback og proces‑supervision giver andre afvejninger.
Ingen metode fjerner behovet for prompt‑, genvindings‑, værktøjs‑ og applikations‑niveau kontrol. Efter‑træning former adfærd; implementerede systemer kræver stadig forankret evidens, tilladelser, overvågning og menneskelig eskalering.
Hvordan præference‑modeller trænes
For en prompt x og to svar y₁ og y₂ tildeler en præference‑model skalære scores og trænes således, at det foretrukne svar får den højere score. Et almindeligt tab er baseret på sandsynligheden for, at én score overstiger den anden. Dette omdanner mange parvise bedømmelser til en funktion, der kan score nygenererede output.
Modellen lærer de signaler, der forudsiger de indsamlede valg. Hvis bedømmere foretrækker selvsikker prosa, længere svar, specifikke kulturelle normer eller kendte synspunkter, kan disse korrelationer blive belønnings‑funktioner. Afbalancerede instruktioner, modeksempler, ekspertgennemgang og revisioner af overfladiske præferencer reducerer, men eliminerer ikke problemet.
Præference‑data kan inkludere uafgjort, rangeringer, kritikker, skalære etiketter eller demonstrationer. Valg af par er vigtigt: sammenligninger mellem åbenbart forskellige svar lærer mindre om subtile kvalitetsgrænser, mens kun vanskelige par kan gøre træningen ustabil. Aktiv udvælgelse kan målrette informative uenigheder, men kan ændre datadistributionen.
Politikoptimering og regularisering
PPO‑baseret RLHF udtrækker svar fra den aktuelle politik, scorer dem med belønningsmodellen og opdaterer politikken for at øge den forventede belønning. En Kullback–Leibler‑straf eller lignende begrænsning holder politikken tæt på den superviserede reference, hvilket begrænser destruktiv afdrift og afskrækker udnyttelse af smalle svagheder i belønningsmodellen.
Optimeringsstyrken er et produktvalg. For lidt efterlader ønsket adfærd uændret; for meget kan skabe belønningshacking, gentagende formuleringer, smiger eller reduceret diversitet. Plot kvalitet‑ og sikkerheds‑målinger mod belønning og afvigelse gennem hele træningen i stedet for kun at vælge et checkpoint ud fra belønning.
Direkte præference‑metoder udleder et mål fra præference‑par og en referencemodel uden en eksplicit online RL‑sløjfe. De kan forenkle træning, men arver stadig præferencekvalitet, dækning og antagelser om reference‑politikken. Konstitutionel eller AI‑genereret feedback ændrer, hvem der leverer etiketter; det fjerner ikke behovet for at validere værdier og fejl med mennesker.
Evaluering og datastyring
Brug blinde sammenligninger, opgavespecifikke tests, modstandende prompts, faktuel kontrol, præcision og recall for afvisning samt undergruppe‑gennemgang. Adskil evaluatorer fra træningsdata, hvor det er muligt. En vinderrate mod en ældre model kan skjule absolutte fejl, når begge kandidater er dårlige.
Dokumentér annotator‑rekruttering, kompensation, ekspertise, geografi, sprog, instruktioner, eksponering for skadeligt indhold, uenighed, afgørelse og kvalitetskontrol. Feedback‑arbejde kan medføre psykologisk risiko, og ansvarlige dataoperationer omfatter medarbejderstøtte og retten til at afslå forstyrrende opgaver.
Efter implementering skal man overvåge præference‑drift og overgeneralisering. En politik, der er finjusteret til uformel assistance, kan opføre sig dårligt i medicinske eller juridiske sammenhænge. Hold domænegrænser, genfinding, tilladelser og eskalering uden for RLHF‑antagelsen, og gentræn kun når nye beviser retfærdiggør ændringen.
En konkret RLHF‑trænings‑ og evalueringspipeline
Et typisk projekt starter med en forudtrænet sprogmodel og et instruktions‑datasæt brugt til superviseret fin‑justering. Annotatorer sammenligner derefter kandidat‑svar under en skriftlig rubrik, der dækker korrekthed, relevans, stil, sikkerhed og usikkerhed. Parvise præferencer træner en belønningsmodel eller optimerer politikken direkte. Udvælgelsen skal omfatte almindelige opgaver, vanskelige kant‑cases, modstandende prompts, flere sprog og områder, hvor annotatorer legitime er uenige.
Belønningsmodellens nøjagtighed på hold‑out‑sammenligninger er nødvendig men ikke tilstrækkelig. Den optimerede politik kan udnytte fejl i den indlærte belønning, blive overdrevent omstændelig, afvise harmløse anmodninger eller miste funktioner. Spor opgave‑benchmark, menneskelig præference, kalibrering, sikkerhed, diversitet og afvigelse fra referencemodellen gennem træningen. Indsaml periodisk friske sammenligninger fra den ændrende politik, så præferencedata dækker output, som modellen faktisk producerer.
Dokumentér hvem der leverede præferencer, deres instruktioner, kompensation, uenighed, kvalitetskontrol og kulturelle eller domæne‑grænser. Brug ekspert‑gennemgang, hvor fejl kan medføre specialiseret skade. Red‑team både belønningsmodellen og den endelige politik, vedligehold regressions‑tests for adfærd og planlæg implementering. RLHF former adfærd i henhold til målte præferencer; det beviser ikke sandfærdighed, eliminerer bias eller løser det bredere problem med at specificere, hvad en model skal gøre i enhver kontekst.
Praktisk implementerings‑tjekliste
Omform konceptet til en afgrænset, testbar arbejdsgang: fortræning → demonstration → sammenligning → lær belønning → optimering → evaluering. Udpeg en ansvarlig ejer, dokumentér data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definer overvågning, rollback og gennemgang før udvidelse af omfanget. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal der gennemføres en dokumenteret beredskabsgennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænsetilstande, afhængighedsfejl og misbrug; bevar beviserne og ubesvarede risici. Definér hvem der kan godkende udgivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når data fra den virkelige verden ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- FEEDBACK: udvalgte domme med uenighed.
- REWARD: en indlært proxy for ønsket adfærd.
- POLICY: optimeret output, som stadig skal testes.
Ofte stillede spørgsmål
Er RLHF det samme som finjustering?
RLHF er en form for efter‑træning, der bruger præference‑afledte belønninger. Superviseret finjustering træner direkte på mål‑output; mange pipelines bruger begge dele.
Gør RLHF en model sandfærdig?
Den kan forbedre adfærd målt via feedback‑processen, men en model kan stadig være forkert, overbevisende eller strategisk udnytte belønningen. Sandfærdighed kræver direkte evaluering og forankring.
Primære referencer