
Grundlæggende AI
Hvad er Federeret Læring?

 Føj Unite.AI til dine foretrukne kilder på Google
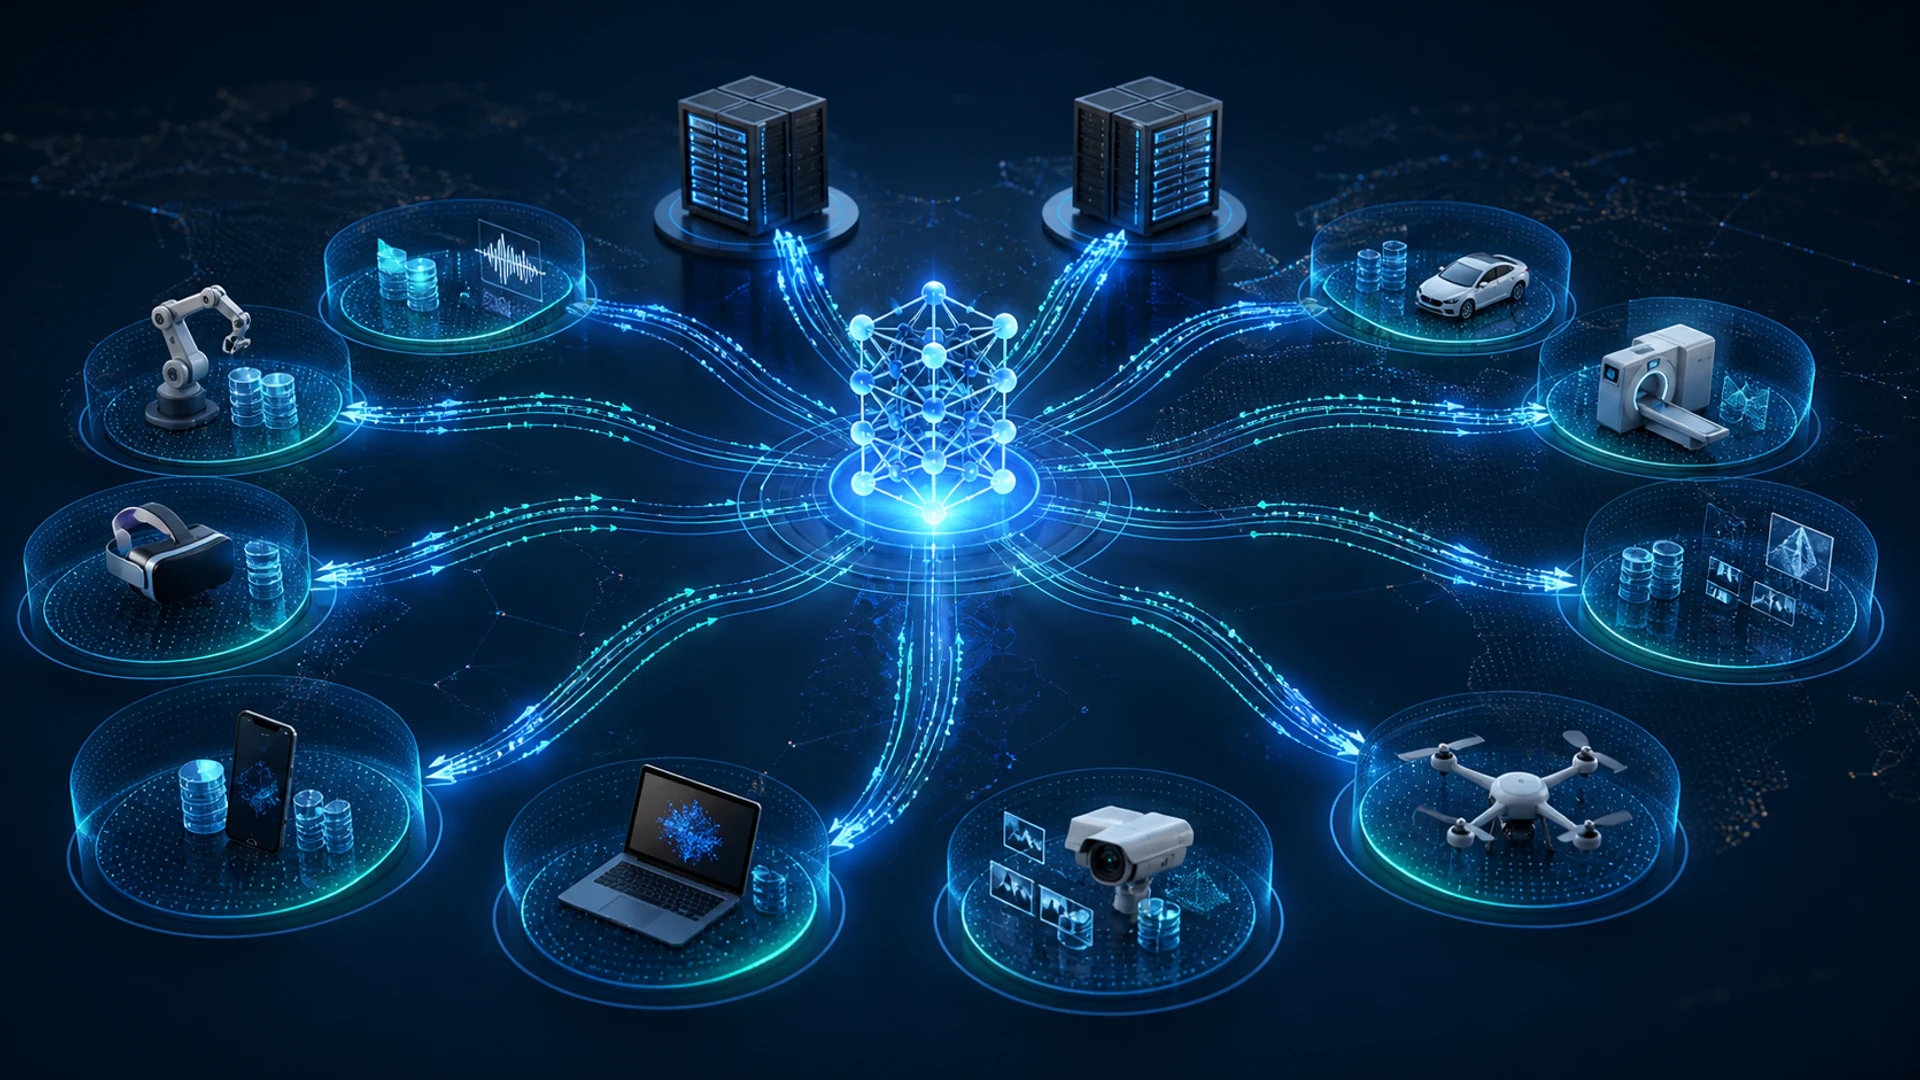
Federated learning træner en delt model på tværs af flere enheder eller organisationer, mens hver deltagers rå træningsdata forbliver lokalt. En koordinator distribuerer modelparametre, klienter beregner opdateringer på deres egne data, og et aggregationsskridt kombinerer disse opdateringer.
Det er nyttigt at holde data lokalt, men det er ikke synonymt med privatliv eller sikkerhed. Modelopdateringer kan lække information, kompromitterede klienter kan forgifte træningen, og koordinatoren har stadig brug for autentificering, transportsikkerhed, adgangskontrol og en defineret tillidsmodel.
Vigtige pointer
- Federeret læring flytter beregning til distribuerede data; den flytter ikke det rå datasæt til én central træner.
- Cross‑device‑systemer involverer mange intermitterende enheder, mens cross‑silo‑systemer involverer færre, mere stabile organisationer.
- Sikker aggregation og differentiel privatliv adresserer forskellige risici og kan kombineres.
- Non‑IID‑data, begrænset båndbredde, upålidelig deltagelse og ondsindede opdateringer er centrale designbegrænsninger.
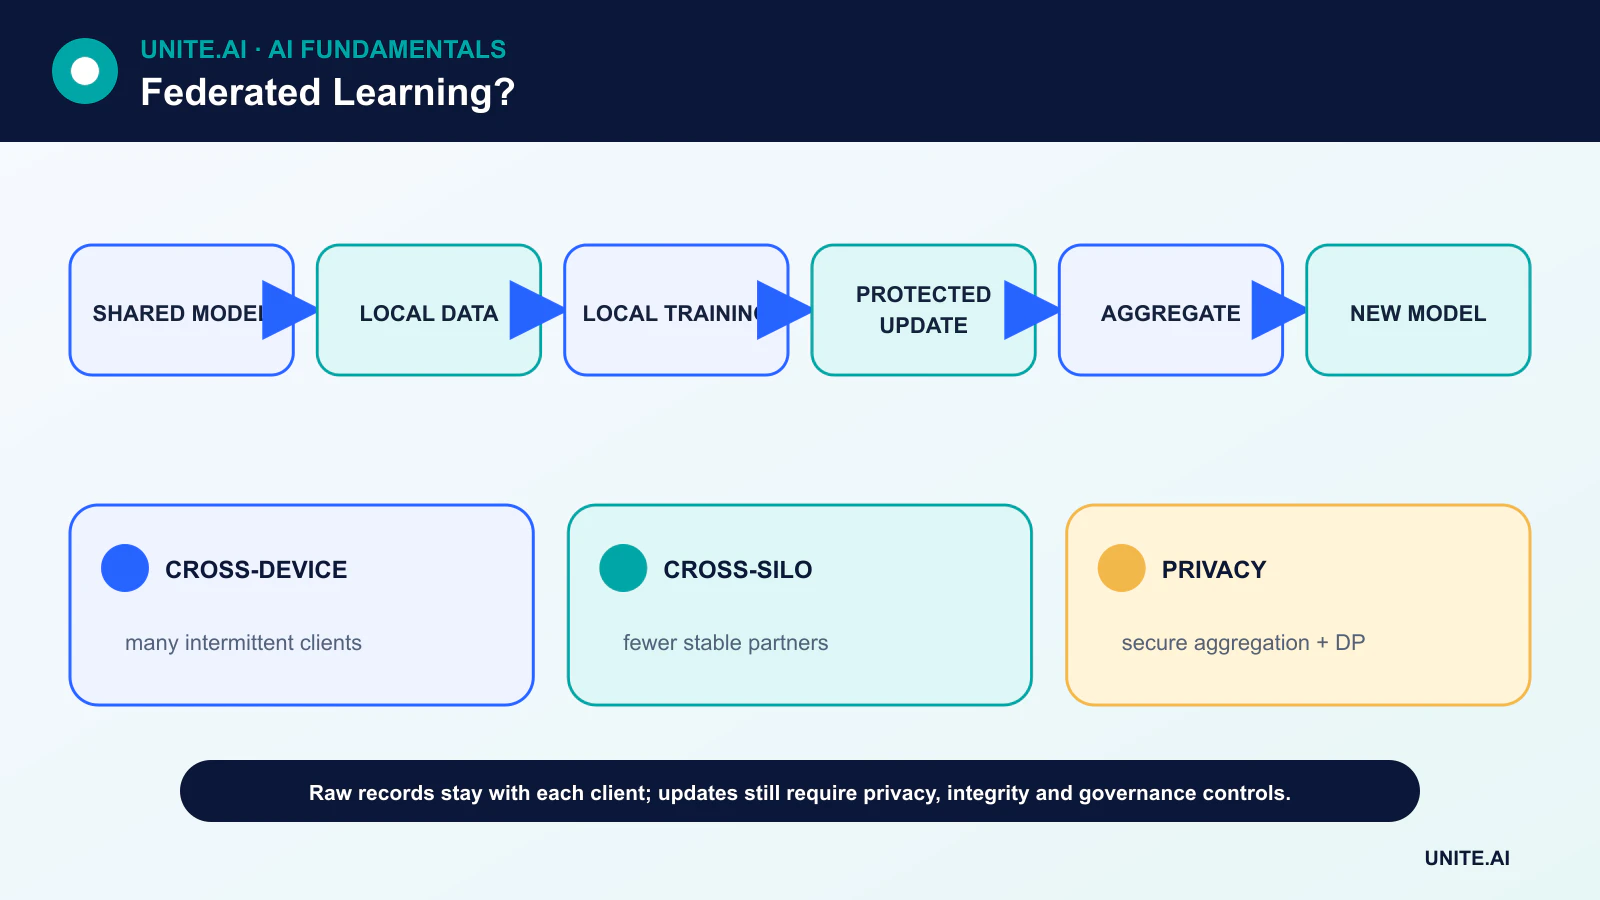
Livscyklussen for federeret gennemsnit
En typisk runde starter, når en koordinator udvælger berettigede klienter og sender den aktuelle model. Hver klient træner lokalt i et begrænset antal trin og producerer en parameter‑ eller gradient‑opdatering. Koordinatoren aggregerer de berettigede opdateringer — ofte med vægte baseret på lokalt antal eksempler — og offentliggør den nye delte model.
Kun en brøkdel af klienterne kan deltage i hver runde. Protokollen skal kunne håndtere tabte forbindelser, versionskonflikter og enheder, der ikke kan træne mens de lader, er optaget eller offline. Kommunikation kan dominere beregning, så komprimering af opdateringer og færre runderejser vejer ofte tungere end rå accelerator‑hastighed.
Cross‑device versus cross‑silo
Cross‑device‑federeret læring kan involvere telefoner, sensorer eller browsere ejet af mange individer. Klienterne er mange, svagt betroede og tilgængelige intermitterende. Cross‑silo‑federeret læring forbinder typisk et mindre sæt af hospitaler, banker eller forretningsenheder med stabil infrastruktur og kontraktuel styring.
De to indstillinger kræver forskellige antagelser om identitet, revision og fejl. Et cross‑silo‑projekt kan forhandle et fælles skema og valideringsproces; en cross‑device‑tjeneste kan skulle håndtere millioner af software‑versioner og meget ujævne lokale datasæt.
Sikker aggregation, differentiel privatliv og kryptering
Sikker aggregation er en kryptografisk protokol, der lader serveren rekonstruere en samlet værdi uden at læse hver klients opdatering. Differentiel privatliv begrænser, hvor meget det frigivne resultat kan afhænge af en enkelt post eller deltager ved at klippe bidrag og tilføje kalibreret støj.
Ingen af mekanismerne løser alle risici. Sikker aggregation gør ikke aggregatet harmløst, og differentiel privatliv pålægger en nøjagtighed‑privatlivs‑afvejning, der skal tages i betragtning med et eksplicit privatlivsbudget. Kryptering beskytter data under overførsel eller lagring; den forhindrer ikke i sig selv inferens fra en model.
Non‑IID‑data og modelkvalitet
Klientdata er sjældent uafhængige og identisk fordelte. En tastaturmodel ser hver persons ordforråd; hospitaler betjener forskellige befolkninger; fabrikker bruger forskelligt udstyr. Disse forskelle kan bremse konvergens og kan skjule dårlig ydeevne for små klientgrupper.
Evaluering bør inkludere globale metrikker, per‑klient‑ eller kohortfordelinger, kalibrering og fejlanalyse. Et centralt test‑sæt kan være praktisk, men er utilstrækkeligt. Dette forbinder federeret læring med maskinlæring-datakvalitet og struktureret og ustruktureret data-styring.
Trusler og operationelle kontrolforanstaltninger
Ondsindede klienter kan indsende forgiftede opdateringer, sybil‑klienter kan forvride aggregation, og en kompromitteret server kan distribuere en målrettet model. Forsvar inkluderer autentificeret tilmelding, anomali‑detektion, robust aggregation, validering af opdateringer, hastighedsbegrænsninger og reproducerbar software‑attestering, hvor det er praktisk.
Federeret læring indgår i et bredere cybersikkerheds-program. Teams bør dokumentere, hvem der kontrollerer koordinatoren, hvilke metadata der indsamles, hvordan deltagere kan forlade, hvordan modeller rulles tilbage, og hvad der sker, når privatlivs‑ eller kvalitetstest fejler.
Federeret optimering og data‑heterogenitet
Federeret læring sender en model eller opgave til deltagende klienter, træner lokalt og aggregerer opdateringer uden at centralisere rå eksempler. I federeret gennemsnit kører udvalgte klienter flere lokale optimerings‑trin, og serveren beregner et vægtet gennemsnit, typisk efter antal eksempler. Kommunikationsrunder, lokale epoker, udvælgelse og læringsrater afvejer båndbredde mod konvergens. Cross‑device‑indstillinger involverer mange upålidelige telefoner eller sensorer; cross‑silo‑indstillinger involverer færre organisationer med stærkere beregning, identitet og styring.
Klientdata er normalt ikke‑uafhængige og ujævne: brugere varierer i adfærd, label‑fordeling, volumen og tilgængelighed. Lokal træning kan drifte i uforenelige retninger, så et simpelt gennemsnit bliver ustabilt eller biased mod aktive høj‑volumen‑klienter. Algoritmer kan anvende proximale termer, adaptiv serveroptimering, klyngedannelse, personalisering eller kontrolvariabler. Evaluering bør rapportere global og klient‑niveau ydeevne, tail‑klienter, deltagelsesfrekvens, konvergens, kommunikation og energi. Et godt gennemsnit kan skjule, at små eller sjældne klientpopulationer får en dårligere model.
Privatliv, sikkerhed og systemteknik
At holde data lokalt garanterer ikke i sig selv privatliv. Gradient‑ og opdaterings‑data kan lække medlemskab eller funktioner, mens den endelige model kan huske eksempler. Sikker aggregation skjuler individuelle opdateringer for serveren, og differentiel privatliv begrænser informationsbidrag ved at klippe og tilføje støj, men begge ændrer nytte og operationel kompleksitet. Angiv trusselsmodellen, privatlivsenheden, budgettet og de betroede komponenter. Kryptering under overførsel er nødvendig, men forhindrer ikke en ondsindet klient, forgiftet opdatering, kompromitteret koordinator eller inferens‑angreb.
Forsvar inkluderer autentificerede klienter, robust aggregation, anomali‑kontroller, opdaterings‑grænser, sikre enclaver i visse design og validering mod rene data. Sybil‑angribere kan oprette mange klienter; bagdøre kan overleve gennemsnit; fjernelse af mistænkelige opdateringer kan også udelukke legitime sjældne adfærd. Versionér klientkoden, understøt afbrudte runder, forebyg genafspilning, og design for efterslægere og enhedsbegrænsninger. Samtykke, opbevaring, regionale regler og sletning gælder stadig for lokale data og afledte opdateringer.
Implementerings‑ og styrings‑eksempel
Et mobilt tastatur kan træne næste‑ord‑forbedringer lokalt, men udrulning bør anvende en befolkning, der er berettiget ud fra enhedens kapacitet og samtykke, indsamle klippede beskyttede opdateringer og sammenligne med en frosset baseline. Valider sprog‑ og dialekt‑ydeevne, batteri, dataforbrug og hukommelsesrisiko inden udgivelse. Klienter har brug for signerede træningsopgaver og modelopdateringer; serveren har brug for auditérbar runde‑konfiguration og rollback. Federeret læring er en arkitektur for distribueret læring under begrænsninger, ikke en erstatning for repræsentative data, privatlivs‑engineering eller ansvarlighed.
Praktisk eksempel: federeret læring på tværs af hospitaler
Hospitaler træner en delt billedkvalitetsmodel uden at samle scanninger. En fælles protokol definerer enheds‑metadata, etiketter, forbehandling, klient‑berettigelse, lokale epoker, klipning og sikker aggregation. Stederne beholder patientdata og indsender beskyttede opdateringer, mens en koordinator evaluerer hver runde på lokale hold‑out‑sæt. Resultaterne rapporterer ydelse på sted‑niveau og for tail‑klienter, ikke kun et volumen‑vægtet gennemsnit, fordi små hospitaler og enhedstyper ellers kan blive overset.
Trusselsmodellen dækker ondsindede opdateringer, medlems‑lækage, kompromitterede klienter og koordinatoradgang. Differentiel privatliv konfigureres med et dokumenteret budget og testet nytte. Model‑ og opgavepakker er signerede; steder kan trække sig tilbage, og opdateringer er auditérbare. En forgiftet eller ustabil runde erstatter ikke automatisk den implementerede model. Projektet bevarer lokale baselines og klinisk gennemgang, og betragter den federerede arkitektur som en privatlivskontrol inden for bredere samtykke‑, sikkerheds‑ og styringsforpligtelser.
Implementeringsbeviser og operationel klarhed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versionsstyret evalueringssæt før finjustering. Test almindelige tilfælde, grænsetilstande, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug, og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operationel telemetry bør afsløre inputkvalitet, outputadfærd, model‑ eller regelversion, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, gennemgå derefter virkelige beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Garanterer federeret læring, at private data ikke kan lække?
Nej. Det reducerer flytning af rådata, men opdateringer og endelige modeller kan stadig afsløre information. Privatliv kræver en trusselsmodel samt yderligere tekniske og organisatoriske kontrolforanstaltninger.
Hvornår er centraliseret træning enklere?
Når data lovligt og sikkert kan centraliseres, er centraliseret træning ofte lettere at fejlfinde, reproducere og overvåge. Federeret læring er berettiget, når distribution er et reelt krav, ikke blot et branding‑mål.
Primære referencer












