Grundlæggende AI
Hvad er en NPU? Neurale behandlingsenheder forklaret

 Føj Unite.AI til dine foretrukne kilder på Google
En neural processing unit (NPU) er en specialiseret accelerator designet til at udføre almindelige neurale netværksoperationer effektivt. I telefoner, pc’er, køretøjer, kameraer og indlejrede systemer kan den køre understøttede AI‑arbejdsbelastninger med lavere energiforbrug eller frigøre CPU’en og GPU’en til andre opgaver.
NPU er et bredt branchebegreb frem for en enkelt universel arkitektur. Ydeevnen afhænger af understøttede operatorer, numeriske formater, hukommelse, kompilator og runtime, termiske grænser samt hvor meget af en applikation der kan forblive på acceleratoren.
Vigtige pointer
- NPUs fokuserer på matrix-, vektor- og tensoroperationer med høj data‑genbrug og lavt strømforbrug.
- Peak‑TOPS er ikke en end‑to‑end‑applikationsbenchmark og kan antage en specifik præcision eller sparsitet.
- En model kan kræve konvertering, kvantisering, graf‑partitionering og fallback for ikke‑understøttede operationer.
- Sammenlign latenstid, gennemløb, energi, hukommelse, kvalitet, privatliv og portabilitet på den reelle arbejdsbelastning.
CPU‑, GPU‑ og NPU‑roller
CPU’er udmærker sig i generel kontrolflow og bred kompatibilitet. GPU’er leverer programmerbar parallel gennemløb og store software‑økosystemer. NPUs er specialiseret i gentagne tensoroperationer og kan indeholde lokal hukommelse, multiplikations‑akkumulerings‑arrays og dataflow optimeret til inferens.
Ulige systemer planlægger forskellige dele, hvor de passer bedst. Dette er vigtigt for edge AI, hvor vedvarende strømforbrug og responstid kan være vigtigere end peak‑datacenter‑gennemløb.
Modelkompilering og eksekvering
Et frameworks graf konverteres til en mellemliggende repræsentation, optimeres, kvantiseres hvor det er passende, og kompileres til understøttede operatorer. Runtime‑miljøet kan partitionere grafen, så ikke‑understøttede lag eksekveres på CPU eller GPU.
Overførsler mellem processorer kan udligne accelerator‑gevinster. Statiske former, layout, præcision, batch‑størrelse og hukommelsesgenbrug påvirker ydeevnen. Test det kompilerede artefakt, fordi deep‑learning-modelkvaliteten kan ændre sig efter konvertering.
Forstå TOPS‑ og effektivitetspåstande
TOPS angiver billioner af operationer pr. sekund under definerede antagelser. Leverandører kan tælle multiplikation og addition separat, bruge lav‑bit‑heltals‑præcision eller antage sparsitet. Et højere tal garanterer ikke lavere latenstid for en given model.
Mål kold‑ og varm‑start, per‑forespørgsels‑latenstid, gennemløb, energi, peak‑hukommelse, termisk throttling, understøttet kontekst‑ eller billedstørrelse samt den andel af grafen, der er acceleratoreret. Brug ækvivalent nøjagtighed og software‑versioner.
AI‑afvejninger på enheden
Lokal eksekvering kan reducere netværksafhængighed og holde rå input på enheden, men downloadede modeller, logfiler, sikkerhedskopier og cloud‑fallbacks skaber stadig datastrømme. Sikker model‑levering og platform‑opdateringer er fortsat nødvendige.
NPUs kan understøtte vision-, lyd-, sprog- og sensor‑applikationer, herunder TinyML-beslægtede arbejdsbelastninger. Udviklere bør designe en elegant fallback og kommunikere, når behandlingen forlader enheden.
NPU‑arkitektur og understøttede operationer
En NPU accelererer tensoroperationer ved at bruge arrays af multiplikations‑akkumulerings‑enheder, lokal hukommelse, dataflow‑planlægning og specialiserede numeriske formater. At holde vægte og aktiveringer tæt på beregningen reducerer dyr data‑flytning. Reelle enheder varierer i operator‑understøttelse, hukommelseshierarki, præcision, sparsitet, programmerbarhed og hvordan arbejdet deles med CPU og GPU.
Peak‑ydeevne annonceres ofte i TOPS, men TOPS angiver ikke præcision, udnyttelse, hukommelsesgrænser, operator‑dækning eller end‑to‑end‑latenstid. To processorer med samme overskrifts‑tal kan præstere forskelligt på den samme model. Benchmark den kompilerede model, realistiske batch‑ og sekvensstørrelser, forbehandling, overførsler og strømtilstand.
NPUs er effektive for understøttede neurale arbejdsbelastninger såsom vision, tale, støjreduktion, baggrundseffekter og kompakte sprogmodeller. Ikke‑understøttede operatorer kan falde tilbage til CPU eller GPU, hvilket skaber overførsler og uforudsigelig latenstid. Undersøg kompilator‑rapporter og runtime‑spor for at bekræfte placering i stedet for at antage, at hele grafen bruger acceleratoren.
Modelkonvertering, kvantisering og implementering
Implementering går typisk fra et trænings‑framework gennem eksport, graf‑optimering, kvantisering, leverandør‑kompilering og runtime‑integration. Statiske former og almindelige operatorer er lettest at accelerere. Dynamisk kontrol‑flow, brugerdefinerede kerner, store mellemliggende tensore og ikke‑understøttede normaliserings‑ eller opmærksomhedsmønstre kan kræve graf‑ændringer eller hybrid‑eksekvering.
Heltal‑ og lav‑præcisions‑formater reducerer modelstørrelse, båndbredde, energi og latenstid, men kalibreringsdata skal repræsentere reelle input. Sammenlign post‑training‑kvantisering med kvantisering‑bevidst træning, når kvaliteten er følsom. Evaluer per‑klasse‑ og værste‑tilfælde‑adfærd, fordi gennemsnitlig nøjagtighed kan skjule forringelse i sjældne eller sikkerhedskritiske tilfælde.
On‑device‑inference forbedrer latenstid, offline‑drift og privatliv ved at begrænse dataoverførsel, men enheden har stadig brug for sikre modeller, tilladelses‑bevidst dataadgang og opdateringsmekanismer. Beskyt model‑filer hvor det er relevant, signer opdateringer, oplys cloud‑fallback, og sikr at telemetri ikke genindfører den privatlivseksponering, som den lokale arkitektur var ment at reducere.
Ydelsesevaluering og system‑niveau afvejninger
Mål kold‑start‑ og steady‑state‑latenstid, gennemløb, energi pr. inferens, hukommelse, termisk adfærd, nøjagtighed og batteri‑påvirkning. Lange tests afslører throttling, som korte benchmarks overser. Inkluder for‑ og efterbehandling, da resizing, tokenisering, dekodning eller datakopiering kan dominere en ellers hurtig accelerator.
Planlægning er et systemproblem. CPU’en håndterer applikationslogik, GPU’en kan renderere eller eksekvere ikke‑understøttede lag, og NPU’en kører kompatible grafer. Samtidige kamera‑, lyd‑, display‑ og AI‑arbejdsbelastninger konkurrerer om hukommelsesbåndbredde og strøm. Test det komplette brugerscenarie i stedet for en isoleret model i et leverandør‑værktøj.
Portabilitet forbliver begrænset på tværs af kompilatorer og runtimes. Foretræk standard‑modelrepræsentationer, hvor de fungerer, isoler leverandør‑specifik kode bag grænseflader, bevar reference‑output og vedligehold enhedstestdækning. Vælg hardware baseret på validerede arbejdsbelastninger, software‑support, opdateringshorisont og total systemomkostning – ikke kun en enkelt accelerator‑specifikation.
Praktisk eksempel: implementering af en vision‑model på en NPU‑laptop
Et team træner en segmenteringsmodel til baggrundseffekter, eksporterer den til et understøttet udvekslingsformat, erstatter ikke‑understøttede operatorer og kalibrerer heltals‑kvantisering med repræsentative kameraer, belysning, hudtoner, tøj og baggrunde. Leverandør‑kompilatoren rapporterer, hvilke noder der kører på NPU’en, og hvilke der falder tilbage. Teamet betragter enhver fallback som en systemomkostning, fordi tensor‑overførsler kan dominere en hurtig individuel kernel.
Benchmarking måler kamera‑forbehandling, model‑eksekvering, compositing, hukommelse, kold‑start, steady‑state‑latenstid, billedstabilitet, strømforbrug og termisk throttling under et reelt video‑opkald. Resultaterne sammenlignes med CPU‑ og GPU‑veje ved lige uddata‑kvalitet. Applikationen bruger kapabilitets‑detektion og en testet fallback i stedet for at antage, at accelerator‑en findes eller understøtter den samme graf efter en driver‑opdatering.
Release‑test dækker enhedsmodeller, operativsystem‑ og driver‑versioner, samtidige arbejdsbelastninger, batteri‑tilstande og fejlformet input. Modelpakker er signerede og versionerede; telemetri registrerer ydeevne og fejl uden at indsamle unødvendig video. Produktet forklarer, hvornår behandlingen forbliver på enheden, og hvornår cloud‑funktioner anvendes. NPU’en får sin plads ved at forbedre den samlede oplevelse under realistiske begrænsninger, ikke ved at opnå en isoleret TOPS‑ eller kernel‑benchmark.
Praktisk implementerings‑tjekliste
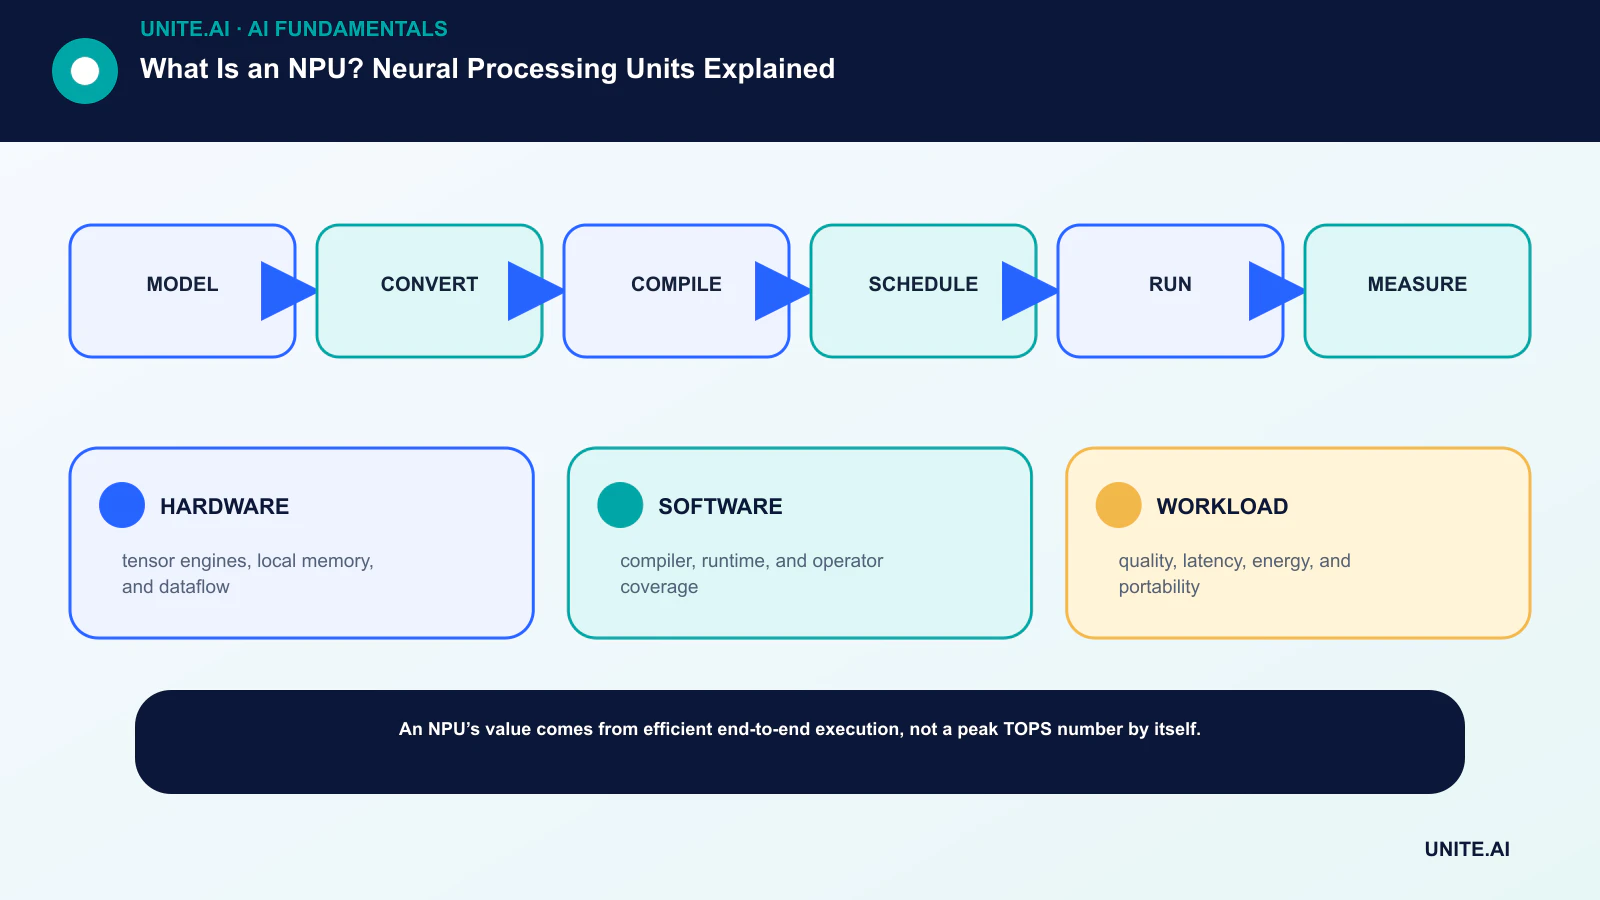
Omform konceptet til en afgrænset, testbar arbejdsproces: model → konverter → kompiler → planlæg → kør → mål. Udpeg en ansvarlig ejer, dokumentér data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definer overvågning, rollback og gennemgang inden udvidelse af omfanget. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal du gennemføre en dokumenteret beredskabs‑gennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænse‑betingelser, afhængigheds‑fejl og misbrug; bevar beviserne og uafklarede risici. Definér, hvem der kan godkende udgivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når real‑world‑data ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- HARDWARE: tensor‑motorer, lokal hukommelse og dataflow.
- SOFTWARE: kompilator, runtime og operator‑dækning.
- WORKLOAD: kvalitet, latenstid, energi og portabilitet.
Ofte stillede spørgsmål
Er en NPU hurtigere end en GPU?
Det afhænger af modellen, præcisionen, operator‑understøttelsen, batch‑størrelsen, strømgrænsen og softwaren. En NPU kan være mere effektiv for en understøttet on‑device‑arbejdsbelastning, mens en GPU er hurtigere eller mere fleksibel andre steder.
Bevarer en NPU al AI‑data privat?
Nej. Den muliggør lokal behandling, men applikationen kan stadig sende data eller output til cloud‑tjenester. Privatliv afhænger af den samlede arkitektur og politik.
Primære referencer