Grundlæggende AI
Hvad er store sprogmodeller (LLM’er)?

 Føj Unite.AI til dine foretrukne kilder på Google
En stor sprogmodel (LLM) er et neuralt netværk, der er trænet på store samlinger af sekvenser for at forudsige tokens eller relaterede sprogmål. De fleste nuværende LLM’er bruger transformer‑arkitekturer og kan generere, klassificere, opsummere, oversætte, hente og transformere sprog via en fælles grænseflade.
En LLM er ikke en database eller en garanteret ræsonneringsmaskine. Dens output er en betinget forudsigelse, formet af træningsdata, eftertræning, kontekst, værktøjer og dekodning. Flydende sprog kan sameksistere med faktuelle fejl, usikkerhed, bias eller usikker adfærd.
Vigtige pointer
- Tokenisering omdanner tekst til diskrete enheder; indlejringer og opmærksomhed bygger kontekstuelle repræsentationer.
- Fortræning lærer brede mønstre, mens finjustering og præference‑metoder former opgaveadfærd.
- Hentning og værktøjer kan tilføje aktuelle beviser eller handlinger, men kræver separate tilladelser og validering.
- Evaluer det implementerede system for kvalitet, forankring, sikkerhed, latenstid, omkostninger og drift.
Tokens, transformere og fortræning
Tekst opdeles i tokens. En transformer kortlægger dem til vektorer, blander information via opmærksomheds‑ og feed‑forward‑lag, og producerer en sandsynlighedsfordeling over den næste eller manglende token.
Selv‑superviserede mål skaber træningssignaler fra rå sekvenser. Skala i parametre, data og beregning kan forudsigeligt forbedre tabet over intervaller, men datasætkvalitet, arkitektur, optimering og evaluering bestemmer, hvilke kapaciteter der fremkommer i praksis.
Eftertræning og inferens
Instruktions‑tuning bruger demonstrationer; præference‑optimering kan få output til bedre at matche menneskelige vurderinger eller en politik. Ved inferens definerer en prompt og samtalehistorik konteksten, mens temperatur‑ og sampling‑indstillinger påvirker variation.
RLHF og lignende metoder former adfærd snarere end at installere en fuldstændig faktatjekker. Modellen kan stadig generere et plausibelt, men uunderbygget svar.
Hentning, værktøjer og agenter
Retrieval‑forstærket generering leverer passager udvalgt fra en ekstern samling. Værktøjs‑kald gør det muligt for applikationskode at forespørge databaser, beregne, søge eller handle. Disse mønstre adskiller noget viden og udførelse fra modellens vægte.
Applikationen skal validere værktøjs‑argumenter, håndhæve tilladelser, bevare kildehenvisninger og behandle hentet indhold som upålidelig input. Vector similarity search hjælper med hentning, men beviser ikke, at en passage understøtter svaret.
Begrænsninger og evaluering
LLM’er kan hallucinerere, afsløre husket indhold, følge ondsindede instruktioner, reproducere bias og fejle på opgaver, der ligner træningseksempler. Lang kontekst garanterer ikke, at hver faktuel information anvendes eller afstemmes korrekt.
Evaluer på repræsentative private opgaver med dokumenterede prompts og versioner. Mål støtte fra kilder, afvisning, kalibrering, sikkerhed, undergruppe‑resultater, menneskelig arbejdsbyrde, latenstid og omkostninger. Overvåg efter frigivelse, da modeller, data og brugeradfærd ændrer sig.
Træningsdata og modeludvikling
Fortrænings‑korporer kombinerer websider, bøger, kode, akademisk materiale, samtaler og licenserede eller kuraterede kilder. Pipelines opdager sprog, fjerner dubletter, filtrerer kvalitet og usikkert indhold, håndterer persondata og vælger blandingsvægte. Disse valg former viden, sprog‑dækning, stil, bias og memorering.
Optimeringsprocesser behandler batches af token‑sekvenser og minimerer forudsigelses‑tab med gradientnedstigning. Distribueret træning opdeler data, model‑tensorer, pipeline‑stadier eller eksperter på tværs af acceleratorer. Checkpoint‑lagring, numerisk stabilitet, netværkskommunikation og fejl‑genopretning bliver store ingeniørmæssige udfordringer i stor skala.
Evaluering under træning sporer tab og kapacitets‑suiter, men benchmark‑forurening kan oppuste resultater. Hold udvalgte tidsperioder og proprietære opgaver, søg efter overlap, og rapporter præcise prompts, dekodning, værktøjer og scoring. En model kan forbedre gennemsnitligt tab, mens regressioner optræder i sikkerhed eller et lav‑ressource‑sprog.
Kontekst‑vinduer, dekodning og inferens
Ved inferens gemmer nøgle‑værdi‑cachen opmærksomheds‑projektioner for tidligere tokens, så de ikke behøver at blive genberegnet ved hvert trin. Cache‑hukommelsen vokser med lag, sekvens, batch og repræsentation. Kvantisering og paging reducerer presset, men kan ændre kvalitet eller latenstid.
Grådig dekodning vælger den token med højeste sandsynlighed; temperatur omregner sandsynligheder; top‑k og top‑p begrænser kandidat‑sættet; beam‑search sporer flere sekvenser. Den bedste strategi afhænger af, om opgaven værdsætter determinisme, diversitet, struktureret output eller sekvens‑sandsynlighed. Valider altid skemaet efter generering.
Lang kontekst øger mængden af tilgængelig information, men garanterer ikke genkaldelse eller ræsonnement. Position, distraherende elementer, modsigelser og prompt‑struktur påvirker brugen. Hentning kan vælge et mindre bevis‑sæt, mens opsummering komprimerer historikken med risiko for tab af detaljer. Mål ydeevne på tværs af kontekstlængde og placering.
Tilpasning, implementering og økonomi
Fuld finjustering opdaterer alle parametre; parameter‑effektive metoder opdaterer adaptere eller lav‑rang‑matricer; fortsat fortræning tilpasser domænedistribution; instruktion‑ og præference‑tuning former svar. Hentning er ofte bedre for hyppigt skiftende fakta, mens tuning er bedre for adfærd og opgaveformat. Metoderne kan kombineres.
Implementeringsvalg omfatter hosted API’er, managed endpoints, selv‑hostede åbne vægte, on‑device modeller og hybrider. Sammenlign databehandling, versionsstyring, latenstid, gennemløb, regioner, tilgængelighed, model‑portabilitet, support og samlede omkostninger. Selv‑hosting overfører ansvaret for sikkerhed, skalering, opdateringer og misbrugs‑overvågning.
Omkostning pr. token er ufuldstændig. En svag model kan kræve gentagelser, længere prompts, mere gennemgang eller dyre fejl. Mål omkostning pr. succesfuldt fuldført opgave ved den krævede kvalitet og risikoniveau. Brug caching, batching, mindre routede modeller og deterministisk kode, hvor de forbedrer den samlede arbejdsgang.
Praktisk eksempel: forankring af en LLM i virksomheds‑dokumenter
En dokumentassistent bør starte med et tilladelses‑bevidst korpus, stabile dokument‑identifikatorer, version‑ og ikrafttrædelsesdatoer, parsérbar struktur og et evalueringssæt af besvarelige, ubesvarelige, tvetydige og modstridende spørgsmål. Hentning indekserer segmenter og metadata, men segmentstørrelse og overlap skal matche dokumentstrukturen. Søgekvalitet måles uafhængigt før generering, så en flydende model ikke kan skjule manglende beviser.
Ved kørselstid skal brugeren autentificeres, hentning filtreres efter adgang, beviser hentes og om‑rangordnes, en begrænset prompt konstrueres, et citeret svar genereres, og påkrævet output valideres. Modellen bør angive, når kilder er i konflikt eller ikke understøtter et svar. Værktøjsbrug og eksterne handlinger kræver separat autorisation. Beskyt mod instruktioner indlejret i hentede dokumenter ved at behandle indholdet som data i stedet for som højere‑prioriteret systempolitik.
Evaluer hentnings‑recall, citations‑præcision, svar‑korrekthed, forankring, afvisning, latenstid og omkostninger på tværs af roller og dokumenttyper. Spor model‑, prompt‑, indeks‑, parser‑ og korpus‑versioner for hver test. I produktion logges bevis‑ID’er og feedback uden at afsløre privat tekst, monitoreres nye ubesvarelige spørgsmål efter indholdsændringer, og der opretholdes en sikker fallback. En LLM‑grænseflade erstatter ikke arkivstyring, adgangskontrol eller ansvarlig faglig gennemgang.
Kapacitetsplanlægning bør modellere prompt‑ og output‑længdefordelinger, samtidige brugere, cache‑adfærd, værktøjs‑latenstid og genforsøgs‑rater. Streaming forbedrer opfattet latenstid men komplicerer moderation og annullering, fordi usikkert eller forkert indhold kan nå brugeren, før hele svaret er kontrolleret. Sæt token‑ og værktøjs‑budgetter, isoler lejere, beskyt leverandør‑legitimationsoplysninger, og øv failover mellem model‑versioner uden lydløst at ændre den adfærd, brugerne er afhængige af.
Praktisk implementerings‑tjekliste
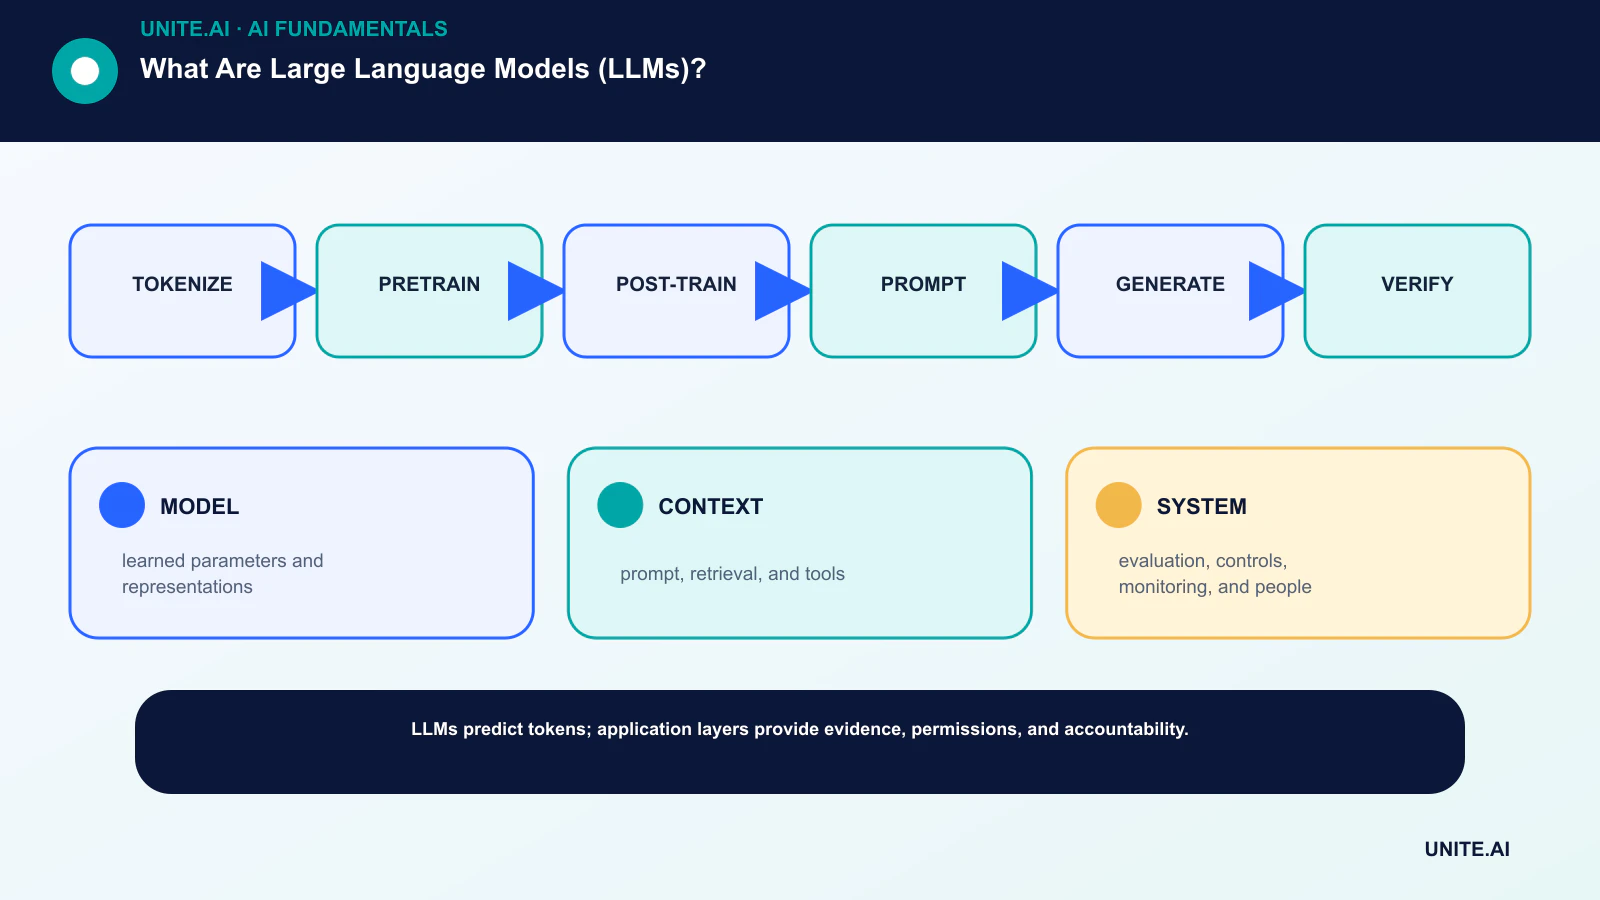
Omform konceptet til en afgrænset, testbar arbejdsgang: tokenisere → fortræne → efter‑træne → prompt → generere → verificere. Navngiv en ansvarlig ejer, dokumentér data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definer overvågning, rollback og gennemgang før udvidelse af omfanget. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal der gennemføres en dokumenteret beredskabs‑gennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænse‑betingelser, afhængigheds‑fejl og misbrug; bevar beviserne og uafklarede risici. Definér hvem der kan godkende udgivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når data fra den virkelige verden ankommer, da en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- MODEL: lærte parametre og repræsentationer.
- CONTEXT: prompt, hentning og værktøjer.
- SYSTEM: evaluering, kontrol, overvågning og personer.
Ofte stillede spørgsmål
Hvorfor kaldes LLM’er store?
Der findes ingen universel parameter‑grænse. ‘Store’ refererer til skala i forhold til tidligere sprogmodeller, inklusiv parametre, træningsdata, beregning og anvendelsesbredde.
Forstår LLM’er sprog?
De bygger nyttige interne repræsentationer og udviser kompleks adfærd, men ordet ‘forstå’ har flere betydninger. Ydeevne bør demonstreres opgave for opgave frem for at blive afledt af flydende sprog.
Primære referencer