Grundlæggende AI
Hvad er en Mixture-of-Experts-model? Sparse AI forklaret

 Føj Unite.AI til dine foretrukne kilder på Google
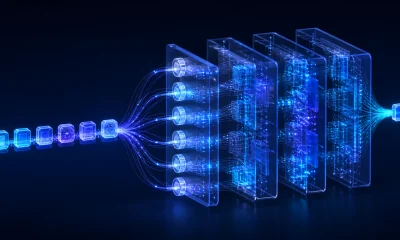
En mixture-of-experts (MoE)-model indeholder flere parametriserede ekspert‑netværk og en router, der vælger et lille udsnit for hver input eller token. Da kun de udvalgte eksperter udføres, kan modellen øge den samlede parameterkapacitet uden at aktivere alle parametre ved hver fremadrettet gennemløb.
Sparsom aktivering gør hverken beregning eller hukommelse gratis. MoE‑systemer skal gemme og flytte mange parametre, balancere tokens på tværs af eksperter, koordinere enheder og forhindre router‑instabilitet. Det samlede antal parametre og antallet af aktive parametre beskriver forskellige omkostninger.
Vigtige pointer
- Routere beregner ekspert‑scores og sender tokens til de top‑k eksperter.
- Kapacitetsgrænser og balanceringsmål forhindrer, at få eksperter modtager alle tokens.
- Sparsom beregning kan forbedre kapaciteten pr. operation, men øger kommunikations‑ og hukommelseskompleksiteten.
- Evaluer kvalitet, aktiv beregning, latenstid, hukommelse, router‑adfærd og betjeningstopologi samlet.
Router‑ og ekspertlag
I transformer‑MoE‑modeller erstattes udvalgte feed‑forward‑lag ofte af ekspert‑feed‑forward‑netværk. En router giver hvert token en score og sender det til én eller flere eksperter; deres output vægtes og returneres til den primære residual‑strøm.
Attention kan forblive tæt. Den omgivende transformer bruger derfor en blanding af delt beregning og betinget ekspertberegning.
Kapacitet og belastningsbalancering
Hver ekspert kan behandle et begrænset antal tokens i en batch. Hvis for mange tokens vælger den samme ekspert, kan nogle implementeringer droppe eller omdirigere overskuddet. Auxiliære tab fremmer balanceret brug, mens router‑støj kan forbedre udforskning under træning.
Lige trafik svarer ikke til meningsfuld specialisering. Undersøg ekspert‑brug efter domæne, position og opgave, men undgå at tildele menneskelæselige roller uden kausal evidens.
Hvorfor betjening er vanskelig
Selvom kun et udsnit er aktivt, kan alle ekspert‑vægte skulle ligge i accelerator‑hukommelsen. Ekspert‑parallelisme sender tokens mellem enheder, hvilket gør netværksbåndbredde og all‑to‑all‑kommunikation kritisk. Små batches kan underudnytte eksperter.
Kvantisering, caching, batching og topologi‑bevidst routing kan hjælpe. Sammenlign MoE og tætte alternativer ved samme output‑kvalitet, kontekst, hardware og service‑niveau‑mål — ikke kun aktive FLOP.
Hvad MoE gør og ikke indebærer
MoE giver betinget beregning og kapacitet. Det garanterer ikke faktualitet, modulær ræsonnement, fortolkelighed eller et panel af uafhængige agenter. Ekspert‑netværk læres samtidigt og kan dele diffuse funktioner.
MoE supplerer generative-AI eftertræning og komprimering. Overvåg router‑drift, tail‑latens, ekspert‑fejl, hukommelse og domænekvalitet efter implementering.
Routing, ekspertkapacitet og sparsom beregning
Et mixture-of-experts‑lag indeholder flere ekspert‑netværk og en router, der tildeler hvert token et lille udsnit, ofte de top‑en eller to eksperter. Modellen kan indeholde mange parametre, mens kun en brøkdel aktiveres pr. token. Sparsom aktivering reducerer beregningen i forhold til en tæt model med tilsvarende samlet parameterantal, men ikke i forhold til hver mindre model.
Routeren producerer ekspert‑scores, anvender en udvælgelsesregel og sender token‑repræsentationer videre. Hver ekspert har begrænset kapacitet. Hvis for mange tokens vælger én ekspert, skal systemet droppe, omdirigere eller padde tokens. Kapacitetsfaktor, auxiliare balancerings‑tab, router‑støj og ekspert‑parallelisme afvejer kvalitet mod udnyttelse og kommunikation.
Det er ikke garanteret, at eksperter kortlægger direkte til menneskelige begreber eller domæner. Specialisering opstår gennem optimering og kan være distribueret, ustabil eller token‑afhængig. Påstande om fortolkelighed bør undersøge routing på tværs af lag og kontekster og anvende interventioner, ikke kun etiketter udledt fra et håndfuld højt‑scorede tokens.
Træning og betjening af distribuerede MoE‑modeller
Træning kombinerer data, tensor, pipeline og ekspert‑parallelisme. Tokens skal ofte rejse mellem acceleratorer for at nå de udvalgte eksperter, så all‑to‑all‑kommunikation kan udligne aritmetiske gevinster. Placering, batch‑sammensætning, netværksbåndbredde, token‑pakning og overlappende kommunikation med beregning er centrale systemdesign‑valg.
Load‑ubalancering skaber inaktive eksperter og overbelastede enheder. Auxiliære mål fremmer balanceret routing, men kan forstyrre hoved‑læringsmålet; nyere metoder kan justere bias eller router‑dynamik. Overvåg token‑tælling pr. ekspert, droppede tokens, entropi, gradienter og enhedstid i stedet for kun at stole på samlet tab.
Betjening er vanskelig, fordi alle ekspert‑vægte kan skulle være tilgængelige, selvom hvert token kun bruger få. Hukommelseskapacitet, interconnect, batching, cache‑adfærd og router‑variabilitet påvirker latenstid. Kvantisering og ekspert‑offloading hjælper i visse indstillinger, men kan tilføje overførsler. Benchmark den præcise model og hardware‑topologi.
Kvalitet, evaluering og implementeringsafvejninger
Evaluer MoE‑modeller mod tætte baselines ved matchet kvalitet, trænings‑compute, inferens‑compute, hukommelse, latenstid og omkostninger. En sammenligning kun på parameterantal er misvisende. Test lange kontekster, sprog, domæner, sjældne tokens og adversarielle prompts, fordi router‑adfærd kan skifte med fordelingen og skabe ujævne evner.
Routing introducerer yderligere fejltænkninger: ekspert‑kollaps, ustabil specialisering, token‑drop, korrelerede nedbrud og følsomhed over for batch‑sammensætning. Deterministisk evaluering bør kontrollere runtime‑ og router‑indstillinger. Operationel overvågning bør inkludere ekspert‑udnyttelse og kommunikations‑sundhed, så et systemproblem ikke forveksles med almindelig modelvarians.
MoE er attraktiv, når skalering af samlet kapacitet er vigtig, og infrastrukturen kan understøtte sparsom distribueret eksekvering. Tætte modeller kan forblive enklere og hurtigere for små batches, edge‑enheder eller begrænsede interconnects. Arkitekturen er en systemafvejning, ikke en universel erstatning for tætte transformers.
Eksempel: evaluering af en MoE‑sprogsmodel
Et forskerteam sammenligner en MoE‑transformer med tætte baselines ved brug af matchede træningstokens og flere ressource‑perspektiver: aktive parametre pr. token, samlede parametre, accelerator‑hukommelse, netværkstrafik, træningstid, inferens‑gennemløb og latenstid. De logger router‑sandsynligheder, tokens pr. ekspert, overflow, droppede tokens og auxiliare tab efter lag, sprog og domæne. En lavere aritmetisk tælling accepteres ikke som effektivitet, hvis kommunikation eller underudnyttelse øger de samlede omkostninger.
Kvalitetsevalueringen dækker viden, ræsonnement, lange kontekster, sjældne domæner, flersprogede opgaver, sikkerhed og kalibrering. Teamet forstyrrer batch‑sammensætning og prompt‑fordeling for at se, om router‑ og output‑resultater ændrer sig uventet. Kausale ekspert‑ablations tester specialiserings‑påstande, mens ekspert‑fejl og netværksnedbrydning afslører robusthed. Resultaterne sammenlignes ved samme service‑niveau‑mål, fordi en model, der kun klarer sig godt i store batches, måske ikke passer til interaktiv brug.
Til implementering placeres eksperter for at minimere all‑to‑all‑trafik, vægte kvantiseres først efter per‑ekspert‑sensitivitets‑kontroller, og runtime‑overvågning opdager ubalance eller utilgængelige enheder. Kapacitets‑ og router‑indstillinger versioneres sammen med modellen. Teamet vælger MoE kun hvis den ekstra parameterkapacitet forbedrer de nødvendige opgaver tilstrækkeligt til at retfærdiggøre hukommelses‑ og distribueret‑system‑kompleksitet; ellers kan en tæt model være billigere, lettere at drive og mere forudsigelig.
Praktisk implementerings‑tjekliste
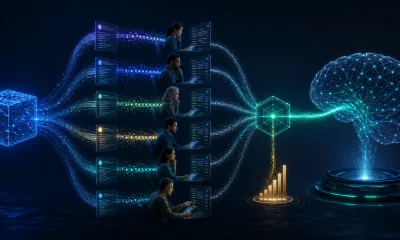
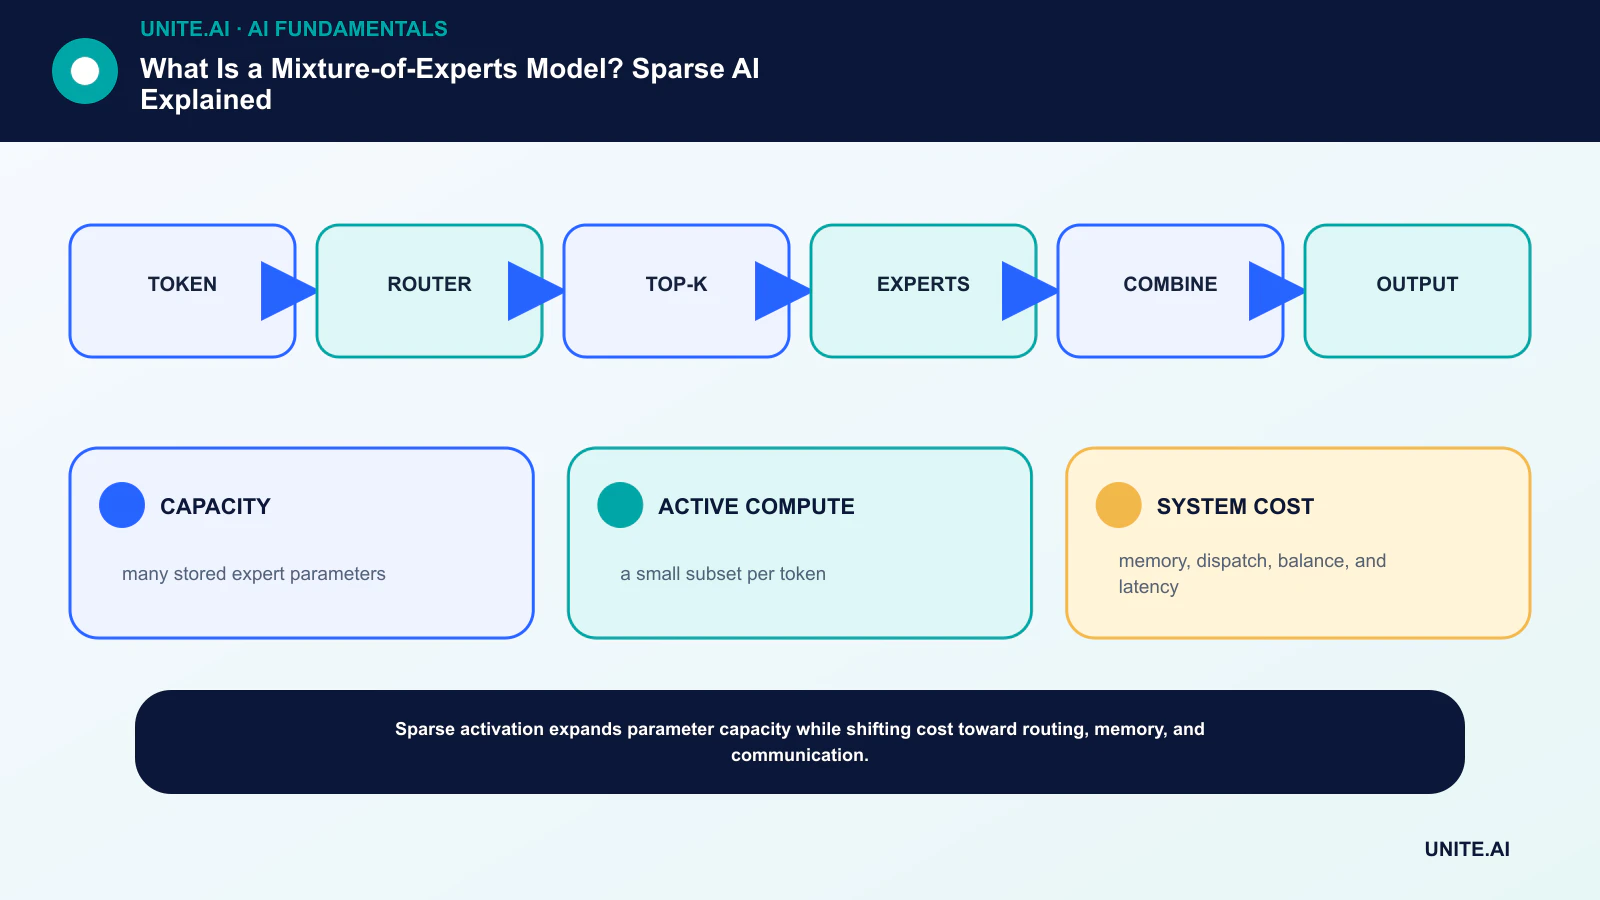
Omform konceptet til en afgrænset, testbar arbejdsgang: token → router → top‑k → eksperter → kombiner → output. Navngiv en ansvarlig ejer, dokumenter data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definér overvågning, rollback og gennemgang inden udvidelse af omfanget. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal der gennemføres en dokumenteret beredskabsgennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænse‑betingelser, afhængigheds‑fejl og misbrug; bevar beviserne og de uafklarede risici. Definér, hvem der kan godkende udgivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når virkelige data ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- KAPACITET: mange lagrede ekspertparametre.
- AKTIV BEREGNING: et lille udsnit pr. token.
- SYSTEMOMKOSTNING: hukommelse, dispatch, balance og latenstid.
Ofte stillede spørgsmål
Er MoE‑eksperter separate modeller?
Normalt nej. De er delnetværk inden i én trænet model, forbundet via en router og delte lag. Deres lærte specialisering behøver ikke stemme overens med intuitive domæner.
Hvorfor kan en MoE have mange parametre men moderat beregning?
Kun et lille top‑k‑sæt af eksperter aktiveres for hvert token. De inaktive ekspert‑parametre forbruger stadig lager og hukommelse og kan medføre kommunikationsomkostninger.
Primære referencer