
Grundlæggende AI
Hvad er mekanistisk fortolkning? Sådan analyserer forskere AI-modeller

 Føj Unite.AI til dine foretrukne kilder på Google
Mekanisisk fortolkning studerer, hvordan indlærte komponenter i et neuralt netværk kausalt producerer adfærd. I stedet for kun at korrelere input med output, danner forskere hypoteser om funktioner, opmærksomhedshoveder, neuroner og kredsløb og griber ind for at teste disse hypoteser.
Feltet har leveret detaljerede forklaringer på udvalgte adfærd i små og mellemstore modeller, men en fuldstændig, troværdig redegørelse for en frontlinjemodel er stadig uden for rækkevidde. Automatiserede forklaringer og attraktive visualiseringer kan være nyttige udgangspunkter, men ikke bevis.
Vigtige pointer
- Funktioner er repræsenterede mønstre; kredsløb er interagerende komponenter, der foreslås at implementere en beregning.
- Aktiveringspatching, ablation og kausal sporing tester, om en komponent ændrer en adfærd.
- Superposition betyder, at en neuron kan deltage i mange funktioner; sparsomme autoencodere forsøger en anden funktionsbasis.
- Fortolkningsmetoder har brug for sand data, falsificerbare tests, dækning og evaluering mod alternative forklaringer.
Fra repræsentation til mekanisme
Probing spørger, om information kan afkodes fra en aktivering. Attribution estimerer, hvilke input eller komponenter der betyder noget. Mekanistisk arbejde går videre ved at foreslå en intern beregning og kontrollere, om interventioner ændrer den forventede mellemliggende og endelige adfærd.
Dette gør det relateret til, men snævrere end forklarlig AI. En efterfølgende forklaring på én beslutning er ikke nødvendigvis en omvendt konstrueret algoritme inde i modellen.
Kredsløb og kausale interventioner
Forskere kan identificere et opmærksomhedshoved eller en funktion, der er forbundet med en opgave, afablere det, patch’e aktiveringer fra en anden kørsel eller spore, hvordan information bevæger sig på tværs af lag. En god hypotese forudsiger adfærd på nye eksempler og overlever kontroller.
Interventioner kan skabe tilstande uden for fordelingen, så en ændring i adfærd ikke automatisk afslører den naturlige beregning. Brug flere metoder, matchede kontroller og kvantitative effekter i stedet for kun én illustrativ prompt.
Superposition og sparsomme funktioner
Neurale netværk kan repræsentere flere funktioner end individuelle dimensioner ved at superponere dem. En neuron kan derfor aktivere for flere urelaterede mønstre, hvilket gør neuron‑niveau etiketter misvisende.
Sparsomme autoencodere lærer et større ordbog af funktioner fra modellens aktiveringer. De kan gøre mønstre mere adskillelige, men den valgte sparsitet, træningsdata, rekonstruktionsfejl og automatiserede etiketter påvirker, hvad der genvindes. Neurale netværk-funktioner kræver stadig kausal validering.
Sikkerhed, fejlfinding og begrænsninger
Mekanismeredskaber kan hjælpe med at finde gemte fakta, bias, vildledende strategier eller fejlkredsløb og kan understøtte redigering eller overvågning. De samme værktøjer kan overse distribuerede, sjældne eller kontekstafhængige beregninger.
Behandl fund som afgrænset evidens: modelversion, opgave, datasæt, lag, intervention, effekt og usikkerhed. Forbind fortolkning med adfærdsevalueringer, red‑teaming og responsible‑AI-styring i stedet for at bruge det som et generelt sikkerhedscertifikat.
Repræsentationer, kredsløb og kausal evidens
Mekanisisk fortolkning studerer, hvordan interne beregninger producerer modellens adfærd. Forskere inspicerer aktiveringer, vægte, opmærksomhed og mellemliggende funktioner og danner derefter hypoteser om repræsentationer og kredsløb. En repræsentation er ikke nødvendigvis gemt i én neuron; den kan være fordelt på retninger, lag, tokens og kontekstafhængige kombinationer.
Sparsomme autoencodere forsøger at dekomponere tætte aktiveringer til et større sæt funktioner, der aktiverer selektivt. Funktionsetiketter er menneskelige fortolkninger af observerede eksempler, ikke sand data. Rekonstruktionsfejl, sparsitet, funktionsopdeling, absorption og døde funktioner påvirker, hvad dekompositionen afslører, og hvad den går glip af.
Korrelation er utilstrækkelig for en mekanistisk påstand. Aktiveringspatching, ablation, kausal sporing, styring og målrettede vægtinterventioner tester, om en komponent ændrer adfærd som forudsagt. Interventioner kan også skabe tilstande uden for fordelingen, så resultaterne kræver kontroller, dosis‑respons‑analyse, alternative forklaringer og replikation på tværs af prompts og modeller.
En stringent fortolknings‑workflow
Start med en præcist målt adfærd og et datasæt, der adskiller konkurrerende hypoteser. Lokalisér relevante lag, positioner, komponenter eller funktioner; inspicer kandidatmekanismer; grib ind; og test, om det foreslåede kredsløb forudsiger nye tilfælde. Hold udforskende eksempler adskilt fra bekræftende evaluering for at reducere udvælgelsesbias.
Automatiserede værktøjer kan rangere neuroner, funktioner, hoveder eller stier, mens sprogmodeller kan foreslå beskrivelser. Automatisering øger dækning, men kan fremstille plausible historier. Vurdér forklaringer på hold‑out aktiverings‑eksempler og kausale forudsigelser, registrér usikkerhed, og gør artefakter reproducerbare med modelversion, tokenizer, prompts og kode.
Mekanismer kan være polysemantiske, redundante, ikke‑lineære og distribuerede. Fjernelse af en komponent kan kompenseres af andre, mens en funktion kan deltage i flere adfærd. Negative fund er informative: et tilsyneladende kredsløb, der fejler uden for kuraterede eksempler, bør indsnævres eller afvises i stedet for at blive reddet med en stadigt vagere forklaring.
Anvendelser, begrænsninger og sikkerhedspåstande
Fortolkning kan hjælpe med at fejlsøge hallucinationer, bias, memorisering, jailbreak‑adfærd eller uventet generalisering; sammenligne modeller; og generere videnskabelige hypoteser. Den kan også identificere funktioner til overvågning eller intervention. Disse anvendelser kræver opgavespecifik validering, fordi en nyttig forskningsvisualisering ikke automatisk er en pålidelig produktionskontrol.
Fraværet af en opdaget funktion beviser ikke fraværet af en evne eller intention, og en læsbar funktion beviser ikke, at modellen bruger den i et givet svar. Værktøjer observerer en projektion af beregning med begrænset dækning. Sikkerhedspåstande skal specificere detektionsfølsomhed, falske positiver, fordeling, modstander og kendte blinde pletter.
Brug fortolkning sammen med adfærdsevalueringer, red‑teaming, datastyring, adgangskontrol, overvågning og hændelsesrespons. Publicér metoder og modeksempler, når det er muligt. Feltet udvikler sig hurtigt, men nuværende teknikker giver ikke en fuldstændig, troværdig forklaring på frontlinjemodellers ræsonnement eller en generel garanti for alignment.
Praktisk eksempel: test af et foreslået modelkredsløb
Antag, at en model ser ud til at bruge et sæt opmærksomhedshoveder og funktioner til at løse et indirekte objekt i en sætning. Forskere definerer et kontrolleret datasæt med varierende navne, positioner, distraktorer og modeksempler og måler derefter adfærden. Aktiveringsinspektion identificerer kandidatkomponenter, men hypotesen skrives før intervention: hvilken information hver komponent bærer, hvor den bevæger sig, og hvordan ændring af den skal ændre outputtet.
Aktiveringspatching og ablation tester nødvendighed og tilstrækkelighed på tværs af hold‑out eksempler. En målrettet redigering, der ændrer den forudsagte token i den forventede retning, understøtter mekanismen; bred præstationsnedgang gør det ikke. Kontroller patcher irrelevante positioner og komponenter, varierer interventionsmagnitude og sammenligner alternative kredsløb. Teamet publicerer negative tilfælde, hvor forklaringen fejler, og undgår at tildele et menneskelæsbart formål udelukkende baseret på korrelation.
For at påstå en sikkerheds‑applikation skal metoden kunne opdage den relevante adfærd med kendt følsomhed under realistiske prompts og modstander‑tilpasning. Funktionsmonitorer evalueres for falske positiver, undvigelse, modelopdateringer og kausal relevans. Fortolknings‑evidens kan vejlede fejlsøgning og yderligere tests, men håndhævelse forbliver i eksterne kontroller og adfærdsovervågning. Et overbevisende kredsløbsdiagram er en videnskabelig hypotese med evidens – ikke en fuldstændig forklaring på en model eller en garanti for uset adfærd.
Praktisk implementerings‑tjekliste
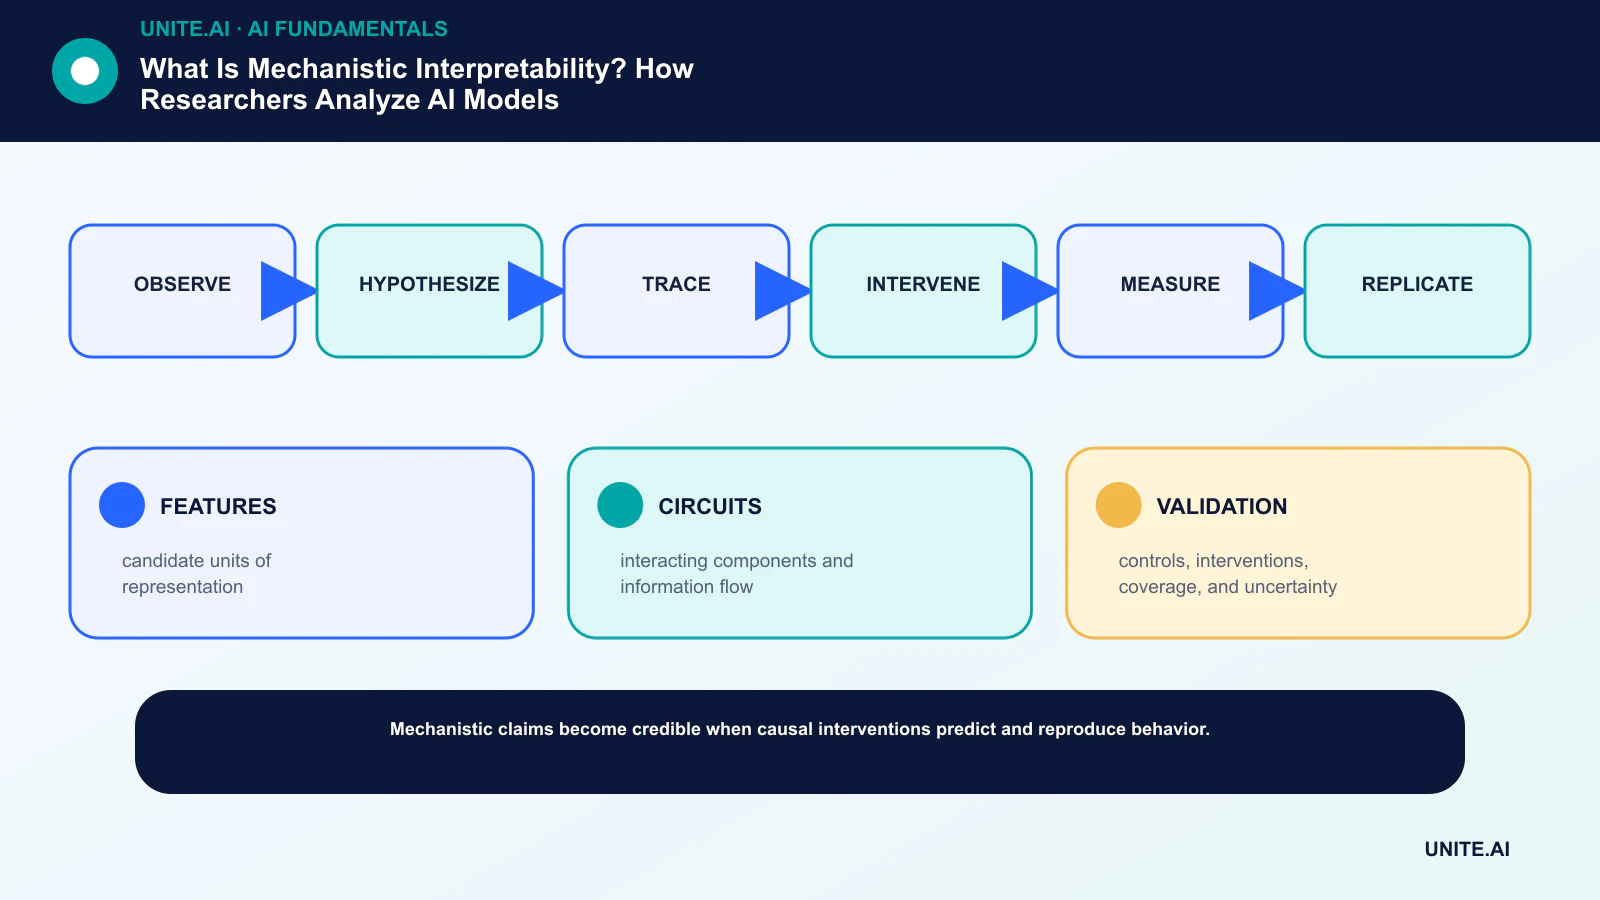
Omform konceptet til en afgrænset, testbar workflow: observer → hypothesér → spor → grib ind → mål → replikér. Navngiv en ansvarlig ejer, dokumentér data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definer overvågning, rollback og gennemgang før udvidelse af omfanget. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal du gennemføre en dokumenteret beredskabsgennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænsebetingelser, afhængighedsfejl og misbrug; bevar evidensen og uafklarede risici. Definér, hvem der kan godkende udgivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Revurder beslutningen, når real‑world data ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- FUNKTIONER: kandidat‑enheder af repræsentation.
- KREDSLØB: interagerende komponenter og informationsflow.
- VALIDERING: kontroller, interventioner, dækning og usikkerhed.
Ofte stillede spørgsmål
Er mekanistisk fortolkning det samme som at læse modellens vægte?
Nej. Rå vægte er ikke selvforklarende. Forskere analyserer aktiveringer, funktioner, komponenter og interventioner for at opbygge og teste kausale hypoteser.
Kan sparsomme autoencodere fuldstændigt forklare en LLM?
Nej. De tilbyder en kandidat‑funktionsbasis og kan understøtte kredsløbsanalyse, men dækning, troværdighed, rekonstruktion, mærkning og skalerbarhed forbliver åbne problemstillinger.
Primære referencer












