
Grundlæggende AI
Hvad er et generativt adversarialt netværk (GAN)?

 Føj Unite.AI til dine foretrukne kilder på Google
Et generativt adversarialt netværk (GAN) træner to neurale netværk i konkurrence. En generator omdanner tilfældig eller betinget input til syntetiske prøver. En diskriminator forsøger at skelne genererede prøver fra ægte træningseksempler. Hver netværks feedback ændrer den anden netværks læringsproblem.
GAN’er kan skabe skarpe billeder og kontrollerbare syntetiske data, men adversarial træning er svær at stabilisere. Visuel realisme er ikke bevis på diversitet, faktuel gyldighed eller tilladelse til at bruge træningsdataene.
Vigtige pointer
- Generatoren producerer prøver; diskriminatoren lærer et beslutningssignal om ægte versus genereret.
- Træning søger en ligevægt, men skiftende modstandere kan forårsage ustabilitet, oscillation eller modekollaps.
- Betingede GAN’er styrer genereringen med etiketter, tekst eller anden kontekst.
- Evaluering bør teste nøjagtighed, dækning, memorisering og efterfølgende risiko – ikke kun billedkvalitet.
Det adversarielle spil
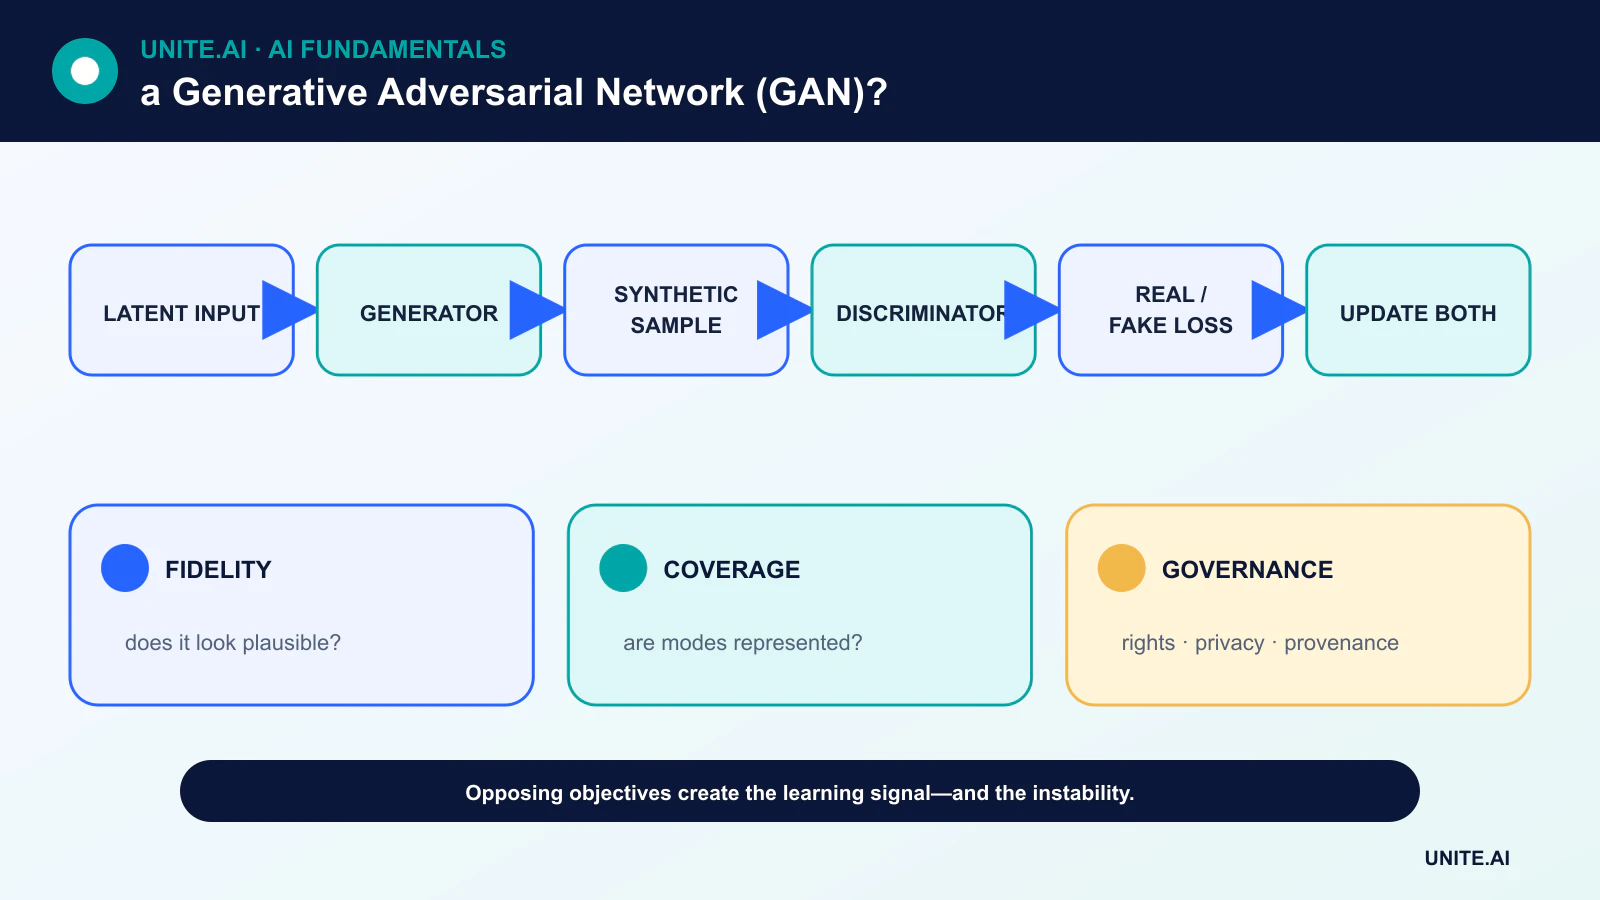
Den oprindelige formulering er et to‑spiller minimax-spil. Diskriminatoren bliver bedre til at adskille ægte data fra genererede data, mens generatoren bliver bedre til at lave prøver, som diskriminatoren klassificerer som ægte. Begge trænes med tilbagepropagation.
Hvis diskriminatoren bliver for præcis, kan dens feedback til generatoren være ubrugelig. Hvis den er for svag, kan generatoren udnytte nemme genveje. Træning skifter derfor mellem opdateringer og balancerer omhyggeligt kapacitet, tab og optimeringsindstillinger.
Modekollaps og træningsstabilitet
Modekollaps opstår, når mange latente input giver lignende output, så prøverne virker plausible, men dækker kun en del af datafordelingen. Andre fejl omfatter oscillation, eksplosion af gradienter og følsomhed over for tilfældig initialisering.
Wasserstein‑mål, gradientstraffe, spektral normalisering, arkitekturændringer og justerede opdateringsforhold kan forbedre stabiliteten. De fjerner ikke behovet for at inspicere diversitet og gentage eksperimenter med flere frø.
Betinget generering og latent kontrol
En betinget GAN giver generatoren og diskriminatoren en etiket eller anden kontekst, hvilket muliggør målrettede klasser eller attributter. Stilbaserede arkitekturer adskiller aspekter af latent kontrol på forskellige opløsninger og har produceret meget realistiske billeder.
Latente retninger kan korrelere med menneskelige begreber, men redigering af én attribut kan ændre andre, fordi træningsdata indeholder korrelerede funktioner. Påstande om kontrol bør testes på tværs af forskellige identiteter og kontekster.
Evaluering, privatliv og oprindelse
Målinger som Fréchet Inception Distance sammenligner funktionfordelinger, men de arver antagelser fra funktionmodellen og kan overse memorisering eller fejl i undergrupper. Nærmeste‑nabo‑analyse, præcision/recall‑lignende dækningstests og menneskelig gennemgang giver supplerende beviser.
En GAN kan memorere sjældne eksempler, reproducere bias eller generere vildledende medier. Teams bør dokumentere datasæt, rettigheder, filtrering, vandmærke‑ eller oprindelsesmekanismer og misbrugskontrol. Syntetiske data er ikke automatisk anonyme.
GAN’er, VAE’er og diffusionsmodeller
Variationale autoenkodere optimerer et sandsynlighedsbaseret latent mål og bytter ofte skarpheden i prøver ud med et struktureret latent rum. Diffusionsmodeller lærer at vende en støjproces om og er blevet et almindeligt grundlag for billedgenerering.
GAN’er forbliver nyttige, når hurtig én‑pass sampling, specifikke billede‑til‑billede‑mappinger eller kompakt implementering er vigtige. Den rette metode afhænger af kvalitet, diversitet, latenstid, træningsstabilitet og styring – ikke af, hvilken arkitektur der er nyeste.
Adversarial mål og træningsdynamik
Et generativt adversarialt netværk træner en generator til at producere prøver og en diskriminator til at skelne genererede fra ægte data. I det oprindelige minimax-spil estimerer diskriminatoren et signal relateret til tæthedsforhold, og generatoren forsøger at narre den. Træning skifter mellem opdateringer, så hvert netværk lærer mod en bevægelig modstander i stedet for et fast tab. Hvis diskriminatoren bliver for stærk, kan generatorgradienterne blive ubrugelige; hvis den er for svag, stagnerer den genererede kvalitet. Tab‑værdien alene svarer ikke direkte til prøvekvaliteten.
Modekollaps opstår, når generatoren producerer begrænsede varianter, der narres diskriminatoren. Oscillation, følsomhed over for hyperparametre og ustabil normalisering er også almindelige. Wasserstein‑mål, gradientstraffe, spektral normalisering, funktionsmatchning, minibatch‑statistik og omhyggeligt balancerede opdateringsplaner adresserer forskellige fejlsøgningsmekanismer. Betingede GAN’er bruger etiketter, tekst eller billeder til at styre output; stilbaserede arkitekturer adskiller latente påvirkninger. Datasættets kvalitet og dækning forbliver grundlæggende, fordi generatoren gengiver og kombinerer den fordeling, den ser.
Evaluering og ansvarlig brug
Evaluer nøjagtighed og diversitet separat. Fréchet Inception Distance sammenligner funktionsfordelinger, men afhænger af prøvestørrelse, funktionsmodel, forbehandling og domæne; Inception Score udelader sammenligning med ægte data. Præcision og recall for generative modeller, nærmeste‑nabo‑analyse, memoriseringskontroller og menneskelig opgave‑evaluering tilføjer beviser. For videnskabelig eller medicinsk syntese, brug domænespecifikke målinger og efterfølgende validering. Behold et hold‑out ægte sæt og sammenlign med diffusions‑ eller autoregressive baselines ved tilsvarende beregning og opløsning.
GAN’er kan udvide data, oversætte domæner, super‑resolve billeder, syntetisere medier og understøtte simulering, men syntetiske data kan forstærke bias eller lække træningseksempler. Verificer licens, samtykke, identitet og oprindelse. Beskyt mod ikke‑samtykkende efterligning og vildledende brug, mærk eller underskriv output, hvor det er passende, og gem genereringsmetadata. Et fotorealistisk billede er ikke dokumentarisk bevis; usikkerhed og syntetisk oprindelse skal forblive synlige, når output påvirker beslutninger.
Udrulning og reproducerbarhed
Registrer generator, diskriminator, optimizer, datasæt, tilfældig frø, truncation og sampling‑indstillinger. Kvantisering eller eksport kan ændre normalisering og output, så valider leveringsartefakten. Overvåg prompt‑ eller betingelsesfordeling, sikkerhedsfiltre, output‑diversitet, latenstid og rapporter. Brug hastighedsbegrænsninger og identitetssikringer i offentlige systemer. GAN‑træning er et koblet optimerings‑eksperiment: udvalgte showcase‑billeder kan ikke etablere robusthed, dækning eller fravær af memorisering, og en model bør evalueres på den fulde fordeling af de tilsigtede genereringsopgaver.
Praktisk eksempel: syntetiske fejl‑billeder med en GAN
En producent træner en betinget GAN til at skabe sjældne overflade‑fejl‑billeder. Den bekræfter, at træningsbillederne har rettigheder, og adskiller produktionslodd før træning og evaluering. Genererede prøver kontrolleres for nærmeste‑nabo‑memorisering, fejlgeometri, baggrundsartefakter, diversitet og ekspert‑plausibilitet. En klassifikator trænet med syntetisk augmentation evalueres kun på uafhængige ægte fejl, i forhold til den samme klassifikator med konventionel augmentation.
Syntetiske data accepteres kun, hvis recall i den virkelige verden forbedres uden at øge falske afvisninger eller undergruppe‑fejl. Genereringsindstillinger og oprindelse forbliver knyttet til hvert billede, og syntetiske filer kommer aldrig ind i test‑sættet eller bevis‑arkivet som ægte inspektioner. Operatører kan ikke bruge generatoren til at fabrikere audit‑registre. Teamet sammenligner diffusions‑alternativer og omkostningerne ved at indsamle flere ægte eksempler, og erkender, at et realistisk udseende ikke beviser, at GAN’en indfangede den fysiske fejlproces.
Implementeringsbeviser og driftsparathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tilsigtede brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt inden justering. Test almindelige tilfælde, kant‑betingelser, fejl‑ eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug, og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavekvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal autoritet for udgivelse, undtagelser, ændringer, rollback og udfasning tildeles. Brug en trinvis udrulning, bevar en sikker fallback, og verificer overvågning med bevidst indsprøjtede fejl. Operativ telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarmerings‑tærskler og en ansvarlig for svar, og gennemgå ægte‑verdens‑beviser efter implementering i stedet for at antage, at offline‑ydelse vil vedvare. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret gendannelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer, samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Forstår en GAN de billeder, den skaber?
En GAN lærer statistisk struktur, der er nyttig til generering. Det etablerer ikke i sig selv en menneskelig lignende semantisk eller kausal forståelse.
Er GAN‑genererede prøver sikre at bruge som træningsdata?
Kun efter at have kontrolleret dækning, etiket‑validitet, memorisering, bias og om den syntetiske fordeling hjælper på et ægte hold‑out test‑sæt.
Primære referencer












