Grundlæggende AI
Hvad er meta‑læring?

 Føj Unite.AI til dine foretrukne kilder på Google
Meta‑learning træner et system på tværs af en fordeling af opgaver, så det kan tilpasse sig en ny, relateret opgave ved brug af begrænsede data eller beregning. Det opsummeres ofte som “at lære at lære”, men det tekniske mål er mere præcist: at optimere læreren, så erfaring fra tidligere opgaver forbedrer tilpasningen til en senere.
Meta‑learning overlapper med few‑shot learning og transfer learning, men termerne er ikke udskiftelige. Few‑shot beskriver mængden af mål‑data; transfer beskriver genbrug; meta‑learning gør eksplicit, at tilpasning på tværs af opgaver er en del af træningen.
Vigtige pointer
- Meta‑træning bruger mange opgaver, ikke kun mange uafhængige eksempler.
- En N‑way K‑shot episode indeholder N klasser og K mærkede support‑eksempler pr. klasse.
- Gradient‑baserede, metric‑baserede, hukommelses‑baserede og lærte‑optimizer‑metoder tilpasser sig på forskellige måder.
- Ydeevnen afhænger stærkt af, om meta‑træningsopgaver ligner mål‑opgaven.
Opgaver, support‑sæt og forespørgsels‑sæt
Et meta‑learning‑datasæt er organiseret som opgaver. I few‑shot klassificering kan en episode være 5‑way 1‑shot: fem klasser, ét mærket support‑eksempel pr. klasse, samt yderligere forespørgsels‑eksempler brugt til at evaluere tilpasning. En 5‑way 5‑shot opgave har fem support‑eksempler for hver af fem klasser – ikke fem eksempler i alt.
Under meta‑træning tilpasser læreren sig gentagne gange på et support‑sæt og evalueres på et forespørgsels‑sæt. Det ydre mål forbedrer fremtidig forespørgsels‑præstation på tværs af opgaver. Meta‑validering finjusterer valg på separate opgaver, og meta‑test evaluerer ægte usete opgaver eller klasser.
Gradient‑baseret meta‑learning
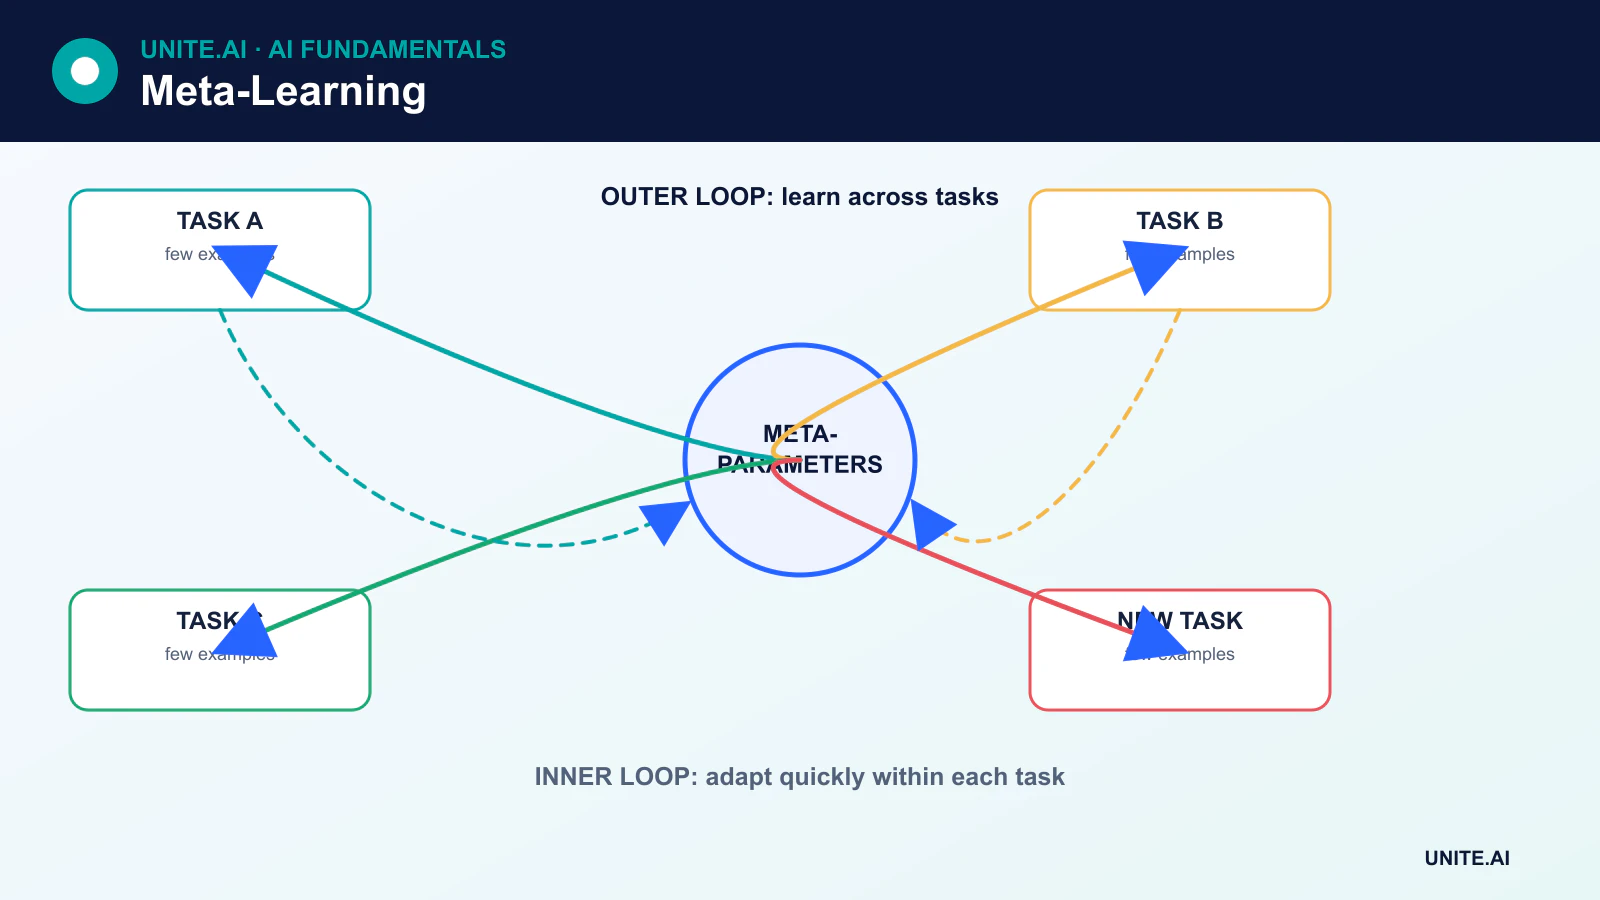
Model‑Agnostic Meta‑Learning (MAML) lærer en initialisering, hvorfra et lille antal gradient-trin giver god præstation på en ny opgave. Den indre løkke tilpasser modelparametre ved hjælp af support‑data. Den ydre løkke opdaterer den delte initialisering ved brug af forespørgsels‑tab på tværs af udvalgte opgaver.
MAML er ikke begrænset til klassificering; den kan anvendes på regression og reinforcement learning, når modellen og opgaven er differentiable. Reptile tilbyder en enklere første‑ordens tilgang, som flytter parametre mod opgave‑tilpassede løsninger uden at beregne den fulde MAML meta‑gradient.
Metric‑baseret meta‑learning
Metric‑baserede metoder lærer en indlejring, hvor eksempler fra samme klasse er tætte, og forskellige klasser er adskilte. Et prototypisk netværk gennemsnitliggør support‑indlejringer for at danne én prototype pr. klasse og klassificerer forespørgsler efter afstanden til disse prototyper.
Matching‑ og Siamese‑lignende netværk bruger relaterede lignende‑mekanismer. Disse metoder tjekker ikke blot, om en model “rammer en mål‑metric”; den lærte afstand eller repræsentation er selv en del af forudsigelsesproceduren.
Hukommelses‑baserede metoder og lærte optimerere
Hukommelses‑baserede systemer bruger rekurrent eller opmærksomheds‑baseret tilstand til at gemme information om den aktuelle opgave. Lærte optimerere tager gradienter eller træningssignaler som input og lærer, hvordan en anden model skal opdateres. Disse metoder kan opdage tilpasningsregler, men de tilføjer parametre, beregning og et ekstra lag af potentiel overfitting.
Meta‑learning og in‑context learning
Store transformere kan tilpasse deres output ud fra eksempler leveret i en prompt uden at opdatere vægte. Dette kaldes in‑context learning. Det ligner meta‑learning‑adfærd, og træningsdata kan opmuntre til opgave‑inference, men en in‑context‑lærer trænes ikke automatisk med et klassisk episodisk meta‑learning‑mål.
Hvor meta‑learning er nyttigt
Potentielle anvendelser omfatter personalisering, robotik, genkendelse med få ressourcer, videnskabelige opgaver med få målinger og hurtig tilpasning til nye miljøer. Meta‑learning er mest attraktivt, når mange relaterede kilde‑opgaver er tilgængelige, men mål‑opgavedata er knappe.
Begrænsninger
Meta‑learning kan være beregningstungt, fordi træning indlejrer tilpasning i optimeringen. Resultater er følsomme over for opgavekonstruktion, support‑/query‑lækage, arkitektur og domæneskift. En model trænet på snævre, homogene opgaver kan tilpasse sig dårligt uden for den fordeling.
Sammenligninger bør inkludere almindelig transfer‑learning og multitask‑baselines. En stærk fortrænet repræsentation efterfulgt af standard fin‑tuning kan være enklere og mere effektiv end en dedikeret meta‑learning‑algoritme.
Opgaver, tilpasning og den indre‑ydre optimeringsstruktur
Meta‑learning træner på en fordeling af opgaver, så en lærer kan tilpasse sig en ny opgave med begrænsede data eller opdateringer. Hver episode udvælger en opgave, deler eksempler i et support‑sæt brugt til tilpasning og et forespørgsels‑sæt brugt til evaluering, og opdaterer delt viden på tværs af episoder. Metric‑baserede metoder lærer en indlejring og sammenligningsregel; optimerings‑baserede metoder lærer initialisering eller opdateringsadfærd; hukommelses‑ og model‑baserede metoder betinger på opgave‑eksempler. Opgavefordelingen er de reelle træningsdata og skal ligne fremtidige tilpasningsproblemer.
I model‑agnostic meta‑learning tilpasser en indre løkke parametre på support‑eksempler, og en ydre løkke optimerer præstation på forespørgsels‑eksempler efter tilpasning. Højere‑ordens gradienter kan være dyre; første‑ordens tilnærmelser bytter nøjagtighed for omkostning. Prototypiske netværk repræsenterer hver klasse ved et support‑sæts centroid og klassificerer efter afstand. Disse metoder antager, at klassegeometri, tilpasnings‑trin og episode‑konstruktion afspejler implementeringen. En metode kan synes at lære hurtigt, mens den udnytter faste etiketter, indkøbs‑artefakter eller overlap mellem kilde‑datasæt.
Evaluering, baselines og virkelige begrænsninger
Separat trænings‑, validerings‑ og test‑opgaver – ikke blot eksempler – for at måle tilpasning til ægte usete opgaver. Rapporter nøjagtighed eller tab som funktion af shots og tilpasnings‑trin, konfidensintervaller på tværs af opgaver, beregning, hukommelse og følsomhed over for support‑sæts sammensætning. Sammenlign med transfer learning, fin‑tuning af en fortrænet model, nearest neighbors og en model trænet i fællesskab på al kilde‑data. Mange tilsyneladende meta‑learning‑gevinster mindskes, når baselines får tilsvarende backbone, augmentation og tuning.
Virkelige implementeringer har brug for en metode til at genkende, når en ny opgave ligger uden for meta‑træningsfordelingen. Dårlige eller fejlagtigt mærkede support‑eksempler kan forårsage hurtig, selvsikker fejl. Begræns opdaterings‑magnitude, valider tilpassede modeller, bevar en fallback, og beskyt tilpasningsdata mod forgiftning. Spor grundmodel, opgave‑sampler, episode‑frø og tilpasnings‑kode. Meta‑learning er nyttigt for gentagne familier af små‑dataproblemer, men skaber ikke generel lærings‑evne fra vilkårlige eksempler og fjerner ikke behovet for domænespecifik evaluering.
Arbejdseksempel: few‑shot tilpasning på tværs af maskiner
En producent betragter hver maskintype som en opgave og meta‑træner en anomalirepræsentation på tværs af mange maskiner med verificerede vedligeholdelsesresultater. Test‑maskiner ekskluderes fuldstændigt fra opgave‑træning. For en ny maskine dækker et lille support‑sæt normale drifts‑tilstande i stedet for vilkårlige minutter af data. Meta‑learning sammenlignes med en fortrænet frosset encoder, nearest neighbors og almindelig fin‑tuning ved brug af de samme support‑eksempler og beregning.
Evalueringen gentager mange support‑udvælgninger og rapporterer hændelses‑recall, falske alarmer, tilpasningstid og varians. Systemet afholder sig, når den nye maskines sensorsæt eller dynamik falder uden for opgavefordelingen. Tilpasnings‑opdateringer er begrænsede og gennemgås, før de påvirker vedligeholdelse. Support‑etiketter og maskinidentitet beskyttes mod forgiftning, og hver tilpasset model bevarer sin grundversion og eksempler. Hurtig tilpasning accepteres kun, hvis den konsekvent overgår enklere transfer under realistisk opgave‑skift.
Implementeringsbeviser og operationel beredskab
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt inden fin‑tuning. Test almindelige tilfælde, grænsetilstande, fejlformet eller manglende input, fordeling‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underbetjent. Mål opgavekvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostning, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operationel telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, gennemgå derefter virkelige beviser efter implementering i stedet for at antage, at offline‑præstation vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system har også brug for dokumenteret gendannelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er few‑shot prompting meta‑learning?
Few‑shot prompting er en in‑context tilpasningsteknik. Den kan vise adfærd forbundet med læring på tværs af opgaver, men den trænes ikke automatisk med support‑/query‑episoder eller en eksplicit meta‑optimerings‑løkke.
Hvad er den største meta‑learning‑risiko?
En uoverensstemmelse mellem meta‑træningsopgaver og mål‑opgaven kan få hurtig tilpasning til at fremstå stærk i en benchmark, men fejle i implementering. Opgave‑splits og kilde‑oprindelse skal revideres så omhyggeligt som almindelige trænings‑/test‑splits.
Primære referencer