
Grundlæggende AI
Hvad er Asset Performance Management (APM)?

 Føj Unite.AI til dine foretrukne kilder på Google
Asset performance management (APM) kombinerer asset‑strategi, vedligeholdelse, tilstandsovervågning, pålidelighedsanalyse og driftsdata for at forbedre den værdi, som fysiske aktiver leverer. Det anvendes typisk på udstyr som turbiner, pumper, køretøjer, produktionslinjer og infrastruktur.
APM er ikke et sensor‑dashboard eller en forudsigende vedligeholdelsesmodel i sig selv. Det er en beslutningsproces, der afbalancerer ydeevne, omkostninger, risiko, sikkerhed og bæredygtighed gennem aktivets livscyklus, med tydeligt ejerskab for inspektioner, arbejde, reservedele og kapitalplanlægning.
Vigtige pointer
- Start med kritikalitet og konsekvenser af fejl, ikke med den letteste sensor at indsamle.
- Kombinér tilstandsdata med vedligeholdelseshistorik, driftskontekst og ingeniørviden.
- Brug forudsigende signaler til at understøtte en defineret arbejdsbeslutning og ledetidskrav.
- Mål undgået risiko, tilgængelighed, vedligeholdelses kvalitet, livscyklusomkostninger og falske alarmer.
Fra asset‑strategi til arbejde
Organisationer definerer mål, asset‑hierarkier, kritikalitet, ydeevnestandarder, fejlkoder og vedligeholdelsesstrategier. Et arbejdsstyringssystem planlægger inspektioner og reparationer; APM‑analyse hjælper med at prioritere hvornår og hvorfor arbejde skal udføres.
Den samme tilstand kan betyde forskellige handlinger for en redundante, lavpris‑pumpe og en sikkerhedskritisk turbine. APM forbinder teknisk bevis med forretnings‑ og sikkerhedskontekst i stedet for kun at optimere én forudsigelses‑score.
Data og digitale repræsentationer
Nyttige kilder omfatter sensors tidsserier, alarmer, operatør‑runder, vedligeholdelsesnoter, dele, miljø, belastninger og designgrænser. Asset‑identifikatorer og tidsstempler skal stemme overens før analyse. Manglende, driftende eller udskiftede sensorer kan skabe falske tendenser.
En digital tvilling kan kombinere ingeniørmodeller og live‑tilstand, men den kræver validerede antagelser og opdateringsregler. Ustruktureret tekniker‑noter kan tilføre kontekst, som telemetri mangler.
Tilstand, forudsigelse og beslutning
Tærskler opdager kendte grænser; anomali‑modeller flagger afvigelser; diagnostiske modeller estimerer årsager; prognostiske modeller estimerer resterende brugbare levetid. Hver kræver en tidshorisont og usikkerhed, der passer til vedligeholdelsesbeslutningen.
En model, der forudsiger en fejl fem minutter før den indtræffer, kan være præcis men operationelt ubrugelig, hvis dele kræver en uge. Maskinlæring bør sammenlignes med regler og pålidelighedsmethoden og testes på tværs af driftsregimer.
Implementering og måling
Start med en kritisk aktivklasse, en troværdig fejlkode, tilgængelig ledetid og en ejer, der kan handle. Integrer anbefalinger i planlægning, arbejdsordrer og lager; indsamle resultatet, så reglen eller modellen kan gennemgås.
Følg tilgængelighed, uplanlagt nedetid, vedligeholdelsesomkostninger, overholdelse af tidsplan, falske alarmer, missede hændelser, sikkerhedseksponering og livscyklusværdi. Undgå at påstå undgåede fejl uden en kontrafaktisk metode og dokumenterede antagelser.
Asset‑hierarki, fejladfærd og kritikalitet
Et APM‑program starter med et asset‑hierarki, der forbinder lokationer, systemer, udstyr, samlinger og vedligeholdelige komponenter. Hvert niveau kræver konsistente identifikatorer, ejerskab, placering, specifikationer og relationer. Uden dette fundament kan sensorstrømme, arbejdsordrer, inspektionsresultater og omkostningsoptegnelser ikke pålideligt beskrive det samme fysiske aktiv.
Fejlkoder forklarer, hvordan et aktiv kan holde op med at opfylde sin påkrævede funktion, hvorfor fejlen opstår, hvilket bevis der dukker op først, og hvilken konsekvens der følger. Failure mode and effects analysis, reliability‑centered maintenance og root‑cause analysis gør vedligeholdelse fra en kalenderaktivitet til en risikoinformeret disciplin. Analysen bør skelne symptomer fra årsagsmekanismer.
Kritikalitet kombinerer sandsynlighed med konsekvenser for sikkerhed, miljø, produktion, kvalitet, overholdelse og omkostninger. En redundant pumpe, der betjener en ikke‑kritisk kreds, bør ikke modtage samme overvågningsbudget som en enkelt‑punkt‑af‑fejl kompressor. Kritikalitet ændrer sig med driftskonteksten, så teams bør genoverveje rangeringerne efter proces‑, asset‑ eller efterspørgselsændringer.
Tilstandsovervågning, forudsigelse og vedligeholdelsesbeslutninger
Tilstandsovervågning kan anvende vibration, temperatur, tryk, strøm, akustisk emission, smøremiddelanalyse, visuel inspektion og operatørobservationer. Prøvefrekvensen skal matche fejlfysikken. Højfrekvent leje‑vibration og langsomt driftende korrosion kræver forskellige sensorer, lagring, funktioner og alarmlogik. Kalibrering og installationskvalitet er en del af datakvaliteten.
Forudsigende modeller kan opdage anomalier, klassificere kendte fejl, estimere sundhedsindikatorer eller forudsige resterende brugbare levetid. Et statistisk usædvanligt signal er ikke automatisk en handlingsbar fejl. Modeller har brug for drifts‑tilstandskontekst, usikkerhed, ledetidsvurdering og validering på tværs af udstyr, årstider, belastninger og vedligeholdelsesbegivenheder. Falske alarmer forbruger tillid og arbejdskraft; missede detektioner kan forårsage alvorlige tab.
Resultatet af analyser skal kobles til en beslutning: inspicere, smøre, nedbruge, planlægge arbejde, bestille en del eller lukke ned. Beslutningstærskler bør afspejle fejlkonssekvens, interventions‑ledetid, arbejdsstyrkekapacitet, reservedele og produktionsvinduer. Den økonomisk optimale tærskel er sjældent den tærskel, der maksimerer en generisk model‑metrik.
APM‑integration, værdimåling og styring
APM forbinder operationel teknologi med virksomhedssystemer såsom computeriseret vedligeholdelsesstyring, enterprise asset management, historikere, lager og planlægning. Integration bør bevare tidsstempler, enheder, asset‑identitet, arbejdsstatus og oprindelse. Netværkssegmentering og kontrollerede gateways er afgørende, fordi diagnostisk bekvemmelighed ikke må skabe en vej ind i sikkerhedskritiske styresystemer.
Mål værdi gennem undgået nedetid, reduceret akut arbejde, vedligeholdelsesomkostninger, reservedele‑tilgængelighed, energieffektivitet, udbytte, sikkerhedseksponering og aktivlevetid. Undgåede fejl er kontrafaktiske, så brug troværdige grundlinjer, sammenlignelige aktiver, dokumenterede antagelser og følsomhedsområder. En pilot, der finder mange anomalier men ikke ændrer vedligeholdelsesbeslutninger, har ikke demonstreret forretningsværdi.
Styring tildeler ejere for sensorer, modeller, alarmregler, fejlbiblioteker og arbejdsprocesser. Gennemgå alarmer efter hver intervention, registrer om diagnosen var korrekt, og fød bekræftede resultater tilbage i regler og modeller. Operatører og vedligeholdere har brug for en måde at udfordre anbefalinger på; lokal viden er bevis, ikke modstand mod automatisering.
Praktisk eksempel: beskyttelse af et kritisk roterende aktiv
For en produktionskompressor kortlægger teamet komponenter og fejlkoder, rangordner tab af produktion og sikkerhedskonsekvenser, og forbinder historik‑tags, vibrationssensorer, smøremiddelsprøver, inspektioner og arbejdsordrer til én asset‑identitet. Grunddata skal dække opstart, stabil belastning, nedtrapning og sæsonbetingelser. Ellers kan modellen flagge normale driftsovergange som fejl eller overse nedbrydning, der kun er synlig ved en bestemt belastning.
Et analyse‑lag opdager ændringer i vibrationsspektret og leje‑temperaturen, estimerer usikkerhed og viser beviset ved siden af sammenlignelige historiske hændelser. En vedvarende alarm opretter en inspektionsanmodning i stedet for automatisk at lukke ned. Vedligeholderen registrerer fund, handling, udskiftet del og bekræftet årsag. Disse resultater bestemmer, om tærsklen, fejlsmodellen eller sensorinstallationen skal ændres.
Evaluer advarsels‑ledetid, bekræftet detektionsrate, falsk‑alarm‑byrde, undgået nedetid, akut arbejde, reservedele‑beredskab og vedligeholdelsesomkostninger i forhold til en dokumenteret grundlinje. Inkluder omkostningerne ved sensorer, integration, analyse og ændrede arbejdsprocesser. En cybersikkerhedsgennemgang isolerer overvågning fra kontrol, og styring tildeler ejere for data og modeller. Målet er en sikrere økonomisk vedligeholdelsesbeslutning, ikke den størst mulige samling af asset‑telemetri.
Praktisk implementerings‑tjekliste
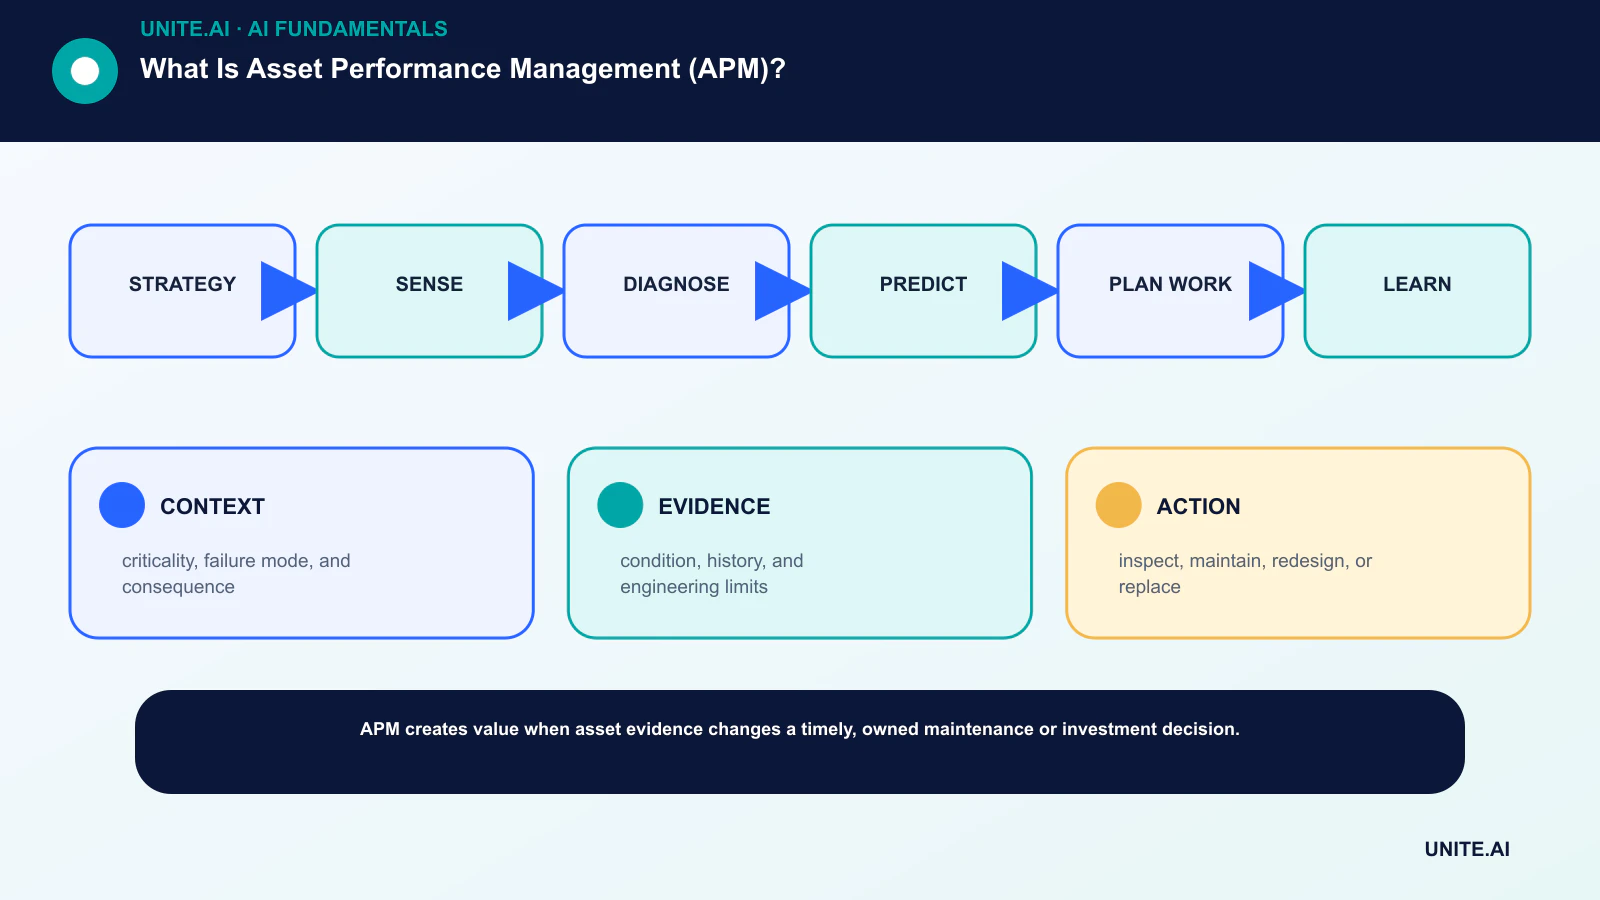
Omform konceptet til en afgrænset, testbar arbejdsproces: strategi → sanse → diagnosticere → forudsige → planlægge arbejde → lære. Navngiv en ansvarlig ejer, dokumenter data og afhængigheder, etabler en simpel grundlinje, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definer overvågning, rollback og gennemgang før udvidelse af omfanget. Registrer versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der er ændret.
Før lancering skal der udføres en dokumenteret beredskabsgennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænsebetingelser, afhængighedsfejl og misbrug; bevar beviserne og uafklarede risici. Definér hvem der kan godkende frigivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når virkelige data ankommer, fordi en teknisk succesfuld pilot ikke garanterer pålidelig ydeevne i større skala.
- KONTEKST: kritikalitet, fejlkode og konsekvens.
- BEVIS: tilstand, historik og ingeniørlimitter.
- HANDLING: inspicere, vedligeholde, redesigne eller udskifte.
Ofte stillede spørgsmål
Hvordan adskiller APM sig fra et CMMS?
Et CMMS håndterer primært vedligeholdelsesarbejde, planlægning og registrering. APM tilføjer asset‑strategi, pålideligheds‑ og tilstandsanalyse, prioritering og præstationsbeslutninger; systemerne integreres ofte.
Er forudsigende vedligeholdelse påkrævet for APM?
Nej. Forebyggende, tilstandsbaserede, run‑to‑failure, redesign‑ og udskiftningsstrategier kan alle være relevante. Forudsigelse er et værktøj inden for en asset‑strategi.
Primære referencer












