Grundlæggende AI
Hvad er IT-drift (ITOps)?

 Føj Unite.AI til dine foretrukne kilder på Google
IT-drift (ITOps) er arbejdet med at drive de teknologitjenester, som en organisation er afhængig af. Det omfatter beregning, netværk, identitet, slutpunkter, cloud‑platforme, databaser, lager, sikkerhedskopier og de operationelle processer, der holder disse komponenter tilgængelige, sikre og understøttelige.
Moderne ITOps er ikke begrænset til et netværksoperationscenter, der overvåger dashboards. Teams håndterer i stigende grad softwaredefineret infrastruktur, platformstjenester, automatisering og distribueret ejerskab, mens de bevarer ansvaret for hændelser, kapacitet, kontinuitet og serviceniveauer.
Vigtige pointer
- ITOps styrer tjenester og deres afhængigheder på tværs af on‑premise, cloud og edge‑miljøer.
- Observabilitet, konfiguration og inventar giver den kontekst, der er nødvendig for at fortolke fejl.
- Hændelseshåndtering genopretter tjenesten; problemhåndtering adresserer tilbagevendende eller systemiske årsager.
- ITOps overlapper med ITSM, SRE, DevOps, SecOps og AIOps, men er ikke identisk med nogen af dem.
Tjenester, aktiver og konfiguration
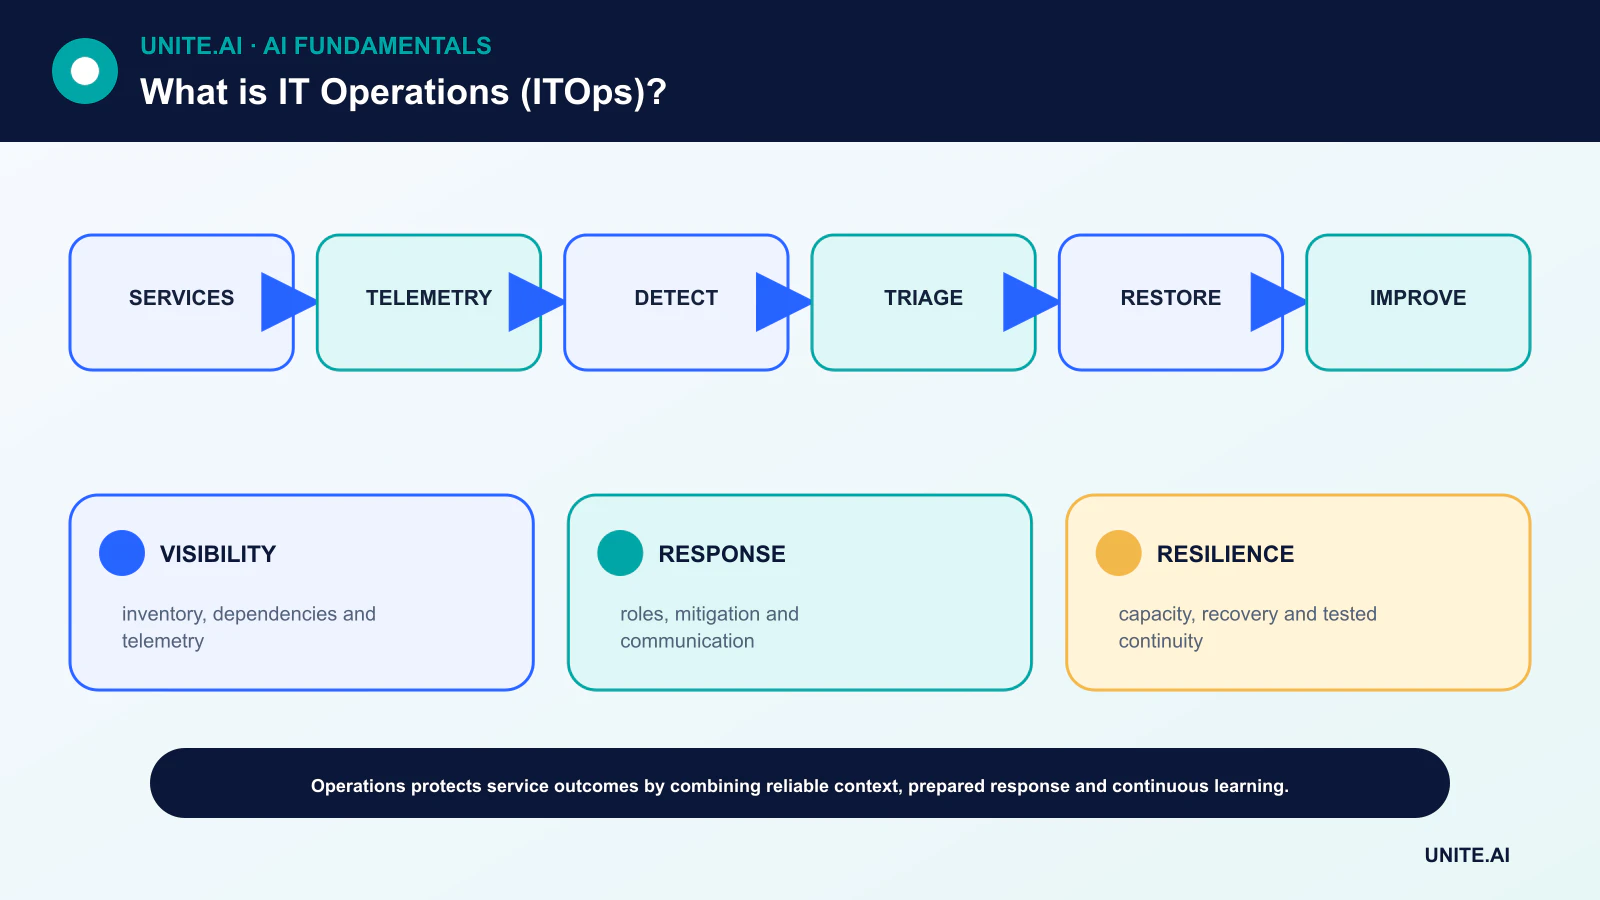
Drift starter med at vide, hvilke tjenester der findes, hvem der ejer dem, hvilke brugere der er afhængige af dem, og hvilken infrastruktur der understøtter dem. Aktiventinventar registrerer komponenter; konfigurationsstyring registrerer relevante relationer og kontrolleret tilstand.
Et inventar, der aldrig afstemmes, bliver vildledende. Automatiser opdagelse, hvor det er nyttigt, identificer autoritative kilder og registrer tillid eller friskhed i stedet for at foregive, at hvert afhængighedskort er komplet.
Observabilitet og tjenestemål
Målinger kvantificerer adfærd, logfiler registrerer hændelser, og spor følger arbejde på tværs af tjenester. Syntetiske checks kan teste en brugerrejse. Brugbar observabilitet starter med spørgsmål og tjenestemål og indsamler derefter de signaler, der er nødvendige for at besvare dem.
Alarmering bør identificere betingelser, der kræver rettidig handling. Grænseværdier uden brugerpåvirkning skaber støj, mens manglende afhængighedskontekst bremser diagnosen. AIOps kan hjælpe med korrelation, men det har brug for pålidelig telemetri og operationel feedback.
Hændelses-, problem- og ændringsstyring
Hændelseshåndtering koordinerer opdagelse, triage, afbødning, kommunikation og genoprettelse. Klare roller reducerer forvirring under pres. En midlertidig løsning kan genoprette tjenesten, mens en senere problemundersøgelse adresserer dybere årsager.
Ændringsstyring evaluerer og registrerer risiko uden at gøre hver ændring til en kø. Standard, automatiserede og lavrisikoændringer kan følge forudgodkendte veje; ændringer med stor påvirkning kræver stærkere beviser, planlægning og forberedelse af rollback.
Kapacitet, robusthed og kontinuitet
Teams forudsiger ressourcebehov, fjerner flaskehalse og tester adfærd under belastning. Sikkerhedskopier er kun nyttige, når genoprettelse er testet. Redundans hjælper kun, når fejlsituationer er uafhængige, og failover faktisk fungerer.
Forretningskontinuitet definerer prioriteter, genoprettelsestid og acceptabelt datatab. Afhængigheder af identitet, DNS, cloud‑kontrolplaner og leverandører bør inkluderes i øvelser i stedet for at antage, at de er tilgængelige.
ITOps, ITSM, SRE og DevOps
IT‑service management leverer processer til at tilpasse tjenester til organisationens behov. Site reliability engineering anvender software‑engineering på drift og bruger serviceniveau‑mål og fejlbudgetter. DevOps forener udviklings‑ og driftsfeedback.
SecOps fokuserer på trusler og respons, mens ITOps opretholder en bredere tjeneste‑sundhed. Organisationsdiagrammer varierer; den vigtige krav er eksplicit ejerskab og delt evidens på tværs af disse discipliner.
ITOps‑driftsmodellen
IT‑drift holder organisationens teknologitjenester tilgængelige, ydeevnedrevne, sikre og genoprettelige. Omfanget omfatter typisk slutpunkter, identitet, netværk, servere, cloud, lager, samarbejde, databaser, overvågning, servicedesk, sikkerhedskopi og leverandørtjenester. Moderne ITOps spænder over ejet infrastruktur og administrerede platforme, så ansvaret skal være eksplicit, selv når driften er outsourcet. En konfigurations‑ eller tjeneste‑inventar forbinder tekniske komponenter med ejere, brugere, afhængigheder, dataklassificering og forretningskritikalitet.
Service management organiserer hændelser, anmodninger, problemer, ændringer, aktiver, viden og serviceniveauer. Hændelseshåndtering genopretter tjenesten; problemhåndtering undersøger tilbagevendende årsager; ændringsmuliggørelse vurderer og koordinerer risiko. At behandle hver ændring som en langsom godkendelse skaber omveje, mens ureguleret automatisering skaber ukontrollerede fejl. Standard lavrisiko‑ændringer kan forudautoriseres og automatiseres; højrisiko‑ændringer kræver beviser, kommunikation, rollback og planlægning baseret på påvirkning.
Pålidelighed, kapacitet og kontinuitet
Overvågning bør følge brugerrettede tjenester og afhængigheder, ikke kun antallet af enheder. Definér tilgængelighed, latenstid, kapacitet, friskhed og supportmål sammen med forretningsansvarlige. Alarmer på handlingsbare symptomer og forbrug af fejlbudget; berig hændelser med ejerskab og nylige ændringer. Kapacitetsplanlægningsmodeller omfatter efterspørgsel, mætning, licenser og leveringstid. Cloud‑elasticitet reducerer provisioning‑forsinkelse, men eliminerer ikke kvoter, regionale grænser eller omkostningsstyring.
Forretningskontinuitet kræver testede sikkerhedskopier, genoprettelse, identitetsgenoprettelse, netværksalternativer, leverandørkontakter og manuelle procedurer. Definér genoprettelsestid‑ og genoprettelses‑punkt‑mål pr. tjeneste. En sikkerhedskopi er ikke bevis på genoprettelse, før den er genoprettet og valideret. Øv ransomware, regions‑tab, udløbne certifikater, identitetsnedbrud og leverandørfejl. Spor konfiguration og infrastruktur som kode, hvor det er muligt, så genoprettelse kan reproduceres.
Sikkerhed, automatisering og målinger
Brug mindst mulige rettigheder, patch‑ og sårbarhedsstyring, slutpunktskontroller, netværkssegmentering, logning og hændelsesrespons. Automatisér gentagne opgaver med idempotens, begrænsninger, godkendelser og revision. Mål tjenestetilgængelighed, hændelsesgentagelse, anmodningsopfyldelse, ændringsfejl, genoprettelse, patch‑eksponering, kapacitet, omkostninger og bruger‑tilfredshed – ikke kun lukning af tickets. ITOps er succesfuld, når teknologien understøtter arbejdet forudsigeligt og kan genoprette efter fejl, ikke når infrastrukturen ser travl ud eller dashboards indeholder flere grønne indikatorer.
Praktisk eksempel: Gendannelse af en samarbejdstjeneste
En virksomhed fastsætter et fire‑timer genoprettelsestid‑mål og et én‑timer genoprettelses‑punkt‑mål for en samarbejdsplatform. Den foretager inventar over identitet, DNS, netværk, data, nøgler, konfiguration, integrationer og leverandør‑afhængigheder. En genoprettelsesøvelse antager, at den primære region og admin‑konto er utilgængelige. Operatører aktiverer en uafhængigt beskyttet nødidentitet, genopretter tjenestekonfiguration og data i en isoleret region og validerer tilladelser, beskeder, integrationer og klientadgang. Forretningsansvarlige bekræfter den genoprettede tjeneste med realistiske brugerrejser i stedet for kun at stole på infrastruktur‑helbreds‑checks.
Øvelsen registrerer faktisk datatab, forløbet tid, manuelle trin, mislykkede kontakter og skjulte afhængigheder. En sikkerhedskopi, der gendanner filer, men ikke krypteringsnøgler eller identitetspolitik, markeres som ufuldstændig. Korrigerende handlinger får ejere og datoer, og runbooken opdateres og testes igen. Overvågnings‑ og kommunikationsskabeloner inkluderes. Organisationen måler genoprettelses‑bevis i stedet for backup‑job‑succes, idet den anerkender, at pålidelig ITOps skal genoprette den tjeneste, brugerne har brug for under realistiske fejlsituationer.
Implementeringsbeviser og operationel parathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tilsigtede brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsetilstande, fejlagtig eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for frigivelse, undtagelser, ændringer, rollback og udfasning. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operationel telemetri skal afsløre inputkvalitet, output‑adfærd, model‑ eller regel‑version, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarmerings‑tærskler og en respons‑ejer, og gennemgå real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil fortsætte. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system har også brug for dokumenterede genoprettelses‑, hændelses‑lærings‑, slette‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Hvad er det primære mål med ITOps?
At levere og genoprette pålidelige teknologitjenester inden for aftalte sikkerheds-, ydelses-, kontinuitets- og omkostningsrammer.
Drives cloud‑infrastrukturen udelukkende af cloud‑udbyderen?
Nej. Udbydere driver dele af den underliggende platform, mens kunderne forbliver ansvarlige for konfiguration, identitet, data, arbejdsbelastninger, overvågning og mange serviceniveau‑beslutninger.
Primære referencer