Grundlæggende AI
Hvad er hændelsesautomatisering? Arbejdsprocesser, sikkerhedsrammer og anvendelsestilfælde

 Føj Unite.AI til dine foretrukne kilder på Google
Hændelsesautomatisering bruger software til at opdage, berige, dirigere, koordinere og nogle gange afhjælpe operationelle eller sikkerhedshændelser. Den forbinder overvågningssignaler med runbooks, billetsystemer, kommunikation, adgangskontroller og genopretningshandlinger, så responderende bruger mindre tid på at kopiere data og mere tid på at træffe beslutninger.
Automatisering er ikke fjernelsen af menneskelig ansvarlighed. Et sikkert program skelner mellem lavrisiko‑deterministiske trin og handlinger, der kan påvirke kunder eller produktion, og anvender derefter godkendelser, afgrænsede legitimationsoplysninger, revisionsspor, tidsbegrænsninger og rollback i forhold til påvirkningen.
Vigtige pointer
- Automatiser gentagelig indsamling af beviser, før du forsøger autonom afhjælpning.
- Brug alvorlighedsgrad, sikkerhed, påvirkningsradius og reversibilitet til at vælge et godkendelsesniveau.
- Behandl hver runbook som versioneret produktionskode med tests og en ejer.
- Mål opdagelse, anerkendelse, genopretning, gentagelse og brugerpåvirkning – ikke kun alarmvolumen.
Fra signal til koordineret respons
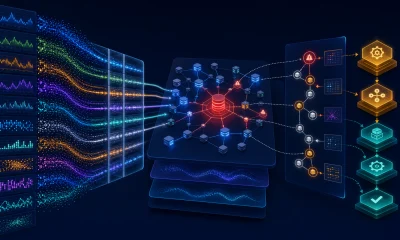
En arbejdsproces kan deduplere alarmer, vedhæfte nylige udrulninger og logfiler, identificere serviceejeren, åbne en hændelsespost, alarmere det beredskab på vagt, oprette en kommunikationskanal og starte en tidslinje. Disse trin reducerer den kognitive belastning uden automatisk at foretage en risikabel diagnose.
Korrelation skal bevare beviser. Hvis en platform grupperer symptomer for aggressivt, kan den skjule samtidige hændelser. Kobl automatiseringen til IT-drift-ejerskab og bevar de rå signaler, som responderende kan have brug for.
Vælg handlinger efter risiko
Kun‑læse‑forespørgsler, snapshots og reversible trafikskift er generelt lettere at automatisere end at slette data, rotere brede legitimationsoplysninger eller ændre et produktionsskema. Definér forudsætninger, en udførelsestidsgrænse, efterbetingelser og en rollback for hver handling.
Brug mindst‑privilegierede serviceidentiteter og adskil autorisation fra arbejdsprocesmotoren. Høj‑impact‑trin bør kræve en identificeret godkender. Hvis AIOps foreslår en årsag eller løsning, har responderende stadig brug for understøttende beviser og en sikker måde at afvise den på.
Byg pålidelige runbooks
En runbook bør angive input, afhængigheder, ejer, omfang, fejladfærd og producerede beviser. Test den i staging og under øvelsesdage. Idempotente trin er værdifulde, fordi gentagne forsøg ikke forårsager yderligere skade.
Versionér og gennemgå automatisering som anden software. Overvåg udløb af legitimationsoplysninger, API‑ændringer, hastighedsbegrænsninger, delvis udførelse og skjult kobling mellem tjenester. Manuelle procedurer forbliver nødvendige, når automatiseringsplatformen selv er utilgængelig.
Lær efter genopretning
Automatisering bør bevare en tidsstemplet registrering af signaler, beslutninger, handlinger, godkendelser og resultater. En skyldfri gennemgang kan derefter adskille bidragende systemforhold fra den endelige udløser og omsætte læring til afprøvede forbedringer.
Nyttige målinger omfatter gennemsnitlig tid til anerkendelse og genoprettelse, procentdel af sikre trin automatiseret, fejlagtig‑handlingsrate, gentagne hændelser og kundepåvirkning. Forbind resultaterne med DevOps-planlægning i stedet for at optimere for antallet af lukkede tickets.
Typer af hændelsesautomatisering
Hændelsesautomatisering normaliserer og beriger indkommende signaler. Koordinationsautomatisering opretter en hændelsespost, alarmerer ejere, åbner kommunikationskanaler og poster statusopdateringer. Diagnostisk automatisering udfører kun‑læse‑forespørgsler eller indfanger snapshots. Afhjælpsautomatisering ændrer systemtilstand, mens genopretningsautomatisering bekræfter tjenestens sundhed og lukker midlertidige afhjælpninger.
Disse kategorier bør ikke dele samme standardtillidsniveau. Berigelse kan ofte køre automatisk; en produktions‑failover kan kræve tillidskontroller og en godkender; datagendannelse kræver normalt en hændelseskommando og en applikationsejer. Styringen bør følge den potentielle påvirkning, ikke om trinnet er implementeret af en regel eller en maskin‑læringsmodel.
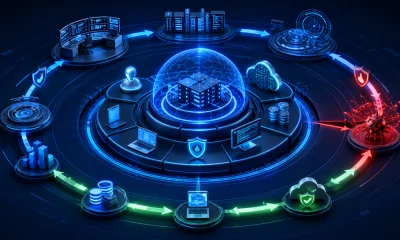
Sikkerhedshændelser tilføjer krav om bevarings af beviser. Automatisering skal undgå at ændre en kompromitteret vært, før flygtige data er indsamlet, afsløre følsomme indikatorer i offentlige kanaler eller karantæne delt infrastruktur uden at forstå påvirkningsradiusen. Operative og retsmedicinske runbooks kan overlappe, men deres rækkefølge kan variere.
Design af arbejdsproces og kontrolplan
Modellér runbook’en som eksplicitte tilstande med forudsætninger og terminale udfald. Hver handling bør rapportere startet, lykkedes, mislykkedes, tidsudløb eller sprunget over, sammen med en uforanderlig udførelses‑identifikator. En central orkestrator kan koordinere trin, men efterfølgende tjenester bør håndhæve deres egen autorisation og validere input uafhængigt.
Brug afgrænsede, kort‑levet legitimationsoplysninger og begræns netværksstier fra automatiseringsmotoren. Adskil udviklings‑, test‑ og produktions‑kørere. Hemmeligheder må ikke forekomme i chat‑udskrifter eller logfiler. For handlinger med høj påvirkning kræves to‑personers godkendelse eller en nødhåndterings‑rolle, hvis brug skaber et umiddelbart revisionsspor.
Design til delvis fejl. En ticket kan oprettes, mens alarmen fejler; et trafikskift kan lykkes i én region og tidsudløbe i en anden. Kompenserende handlinger, afstemnings‑jobs og klar ejerskab forhindrer arbejdsprocessen i at rapportere succes kun fordi orkestreringsprocessen er afsluttet.
Eksempler, test og modenhed
Et modent første anvendelsestilfælde er udtømning af databaseforbindelser: indsamle pool‑metrik, nylige udrulninger, langsomme forespørgsler og ejerinformation; åbne en hændelse; foreslå en reversibel skalering eller trafikhandling; kræve godkendelse; og derefter bekræfte fejlrate og latenstid. Det samme mønster kan anvendes på certifikatudløb, disk‑pres, mislykkede jobs eller mistænkelig kontoadfærd.
Test runbooks via enhedstests, mock‑API’er, staging‑hændelser, øvelsesdage og kontrollerede produktionsøvelser. Indsprøjt forældet data, tilladelsesafslag, langsomme afhængigheder, duplikerede hændelser og konflikterende hændelser. Bekræft at gentagelser er sikre, og at responderende kan tage manuel kontrol uden at kæmpe imod automatiseringen.
Modenhed udvikler sig fra underretning til berigelse, til guidede handlinger, til afgrænset auto‑afhjælpning. Fremskridt bør afhænge af beviser: stabil diagnose, lav fejlagtig‑handlingsrate, verificeret rollback og klar brugerfordel. Autonom lukning bør være sjælden, indtil systemet kan bevise genopretning og bevare tilstrækkelige beviser til senere læring.
Eksempel på arbejde: automatisering af en produktionsservice‑hændelse
Forestil dig et betalings‑API, hvis fejlrate stiger efter en udrulning. Overvågning udsender en struktureret alarm, der indeholder service, miljø, region, version, fejlbudget og runbook‑link. Automatisering beriger den med ændringsposten, afhængighedssundhed, nylige logfiler og ejerskab og grupperer duplikerede alarmer til én hændelse. En deterministisk politik kan straks pause yderligere udrulning; en rollback bør kræve beviser for, at den nye version er årsagssammenhængende, og at rollback er sikker.
Arbejdsprocessen udpeger en hændelseskommando, åbner kommunikationskanaler, registrerer en tidslinje og foreslår diagnostiske trin. Automatisk afhjælpning starter med lav‑risiko reversible handlinger såsom at flytte trafik til en sund instans. Hver handling kræver autorisation, samtidighedsbegrænsninger, en tidsgrænse, verificerede efterbetingelser og rollback. Generative opsummeringer kan hjælpe responderende, men kilde‑telemetri og kommandoer forbliver synlige, så teamet kan udfordre en forkert fortælling.
Mål tid til opdagelse, anerkendelse, afbødning og genopretning; alarmvolumen; duplikat‑undertrykkelse; afhjælps‑succes; gentagelse; og automatiserings‑påvirket skade. Afhold øvelsesdage for udløbne legitimationsoplysninger, delvise regioner, vildledende alarmer og mislykkede rollbacks. Efter genopretning skal den faktiske tidslinje bevares, bidragende tekniske og organisatoriske forhold identificeres, runbooks og tests opdateres, og korrigerende arbejde spores til færdiggørelse i stedet for at betragte en hurtig afbødning som afslutningen på pålidelighedsarbejdet.
Praktisk implementerings‑tjekliste
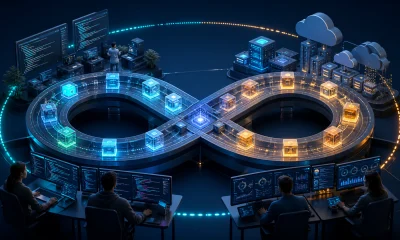
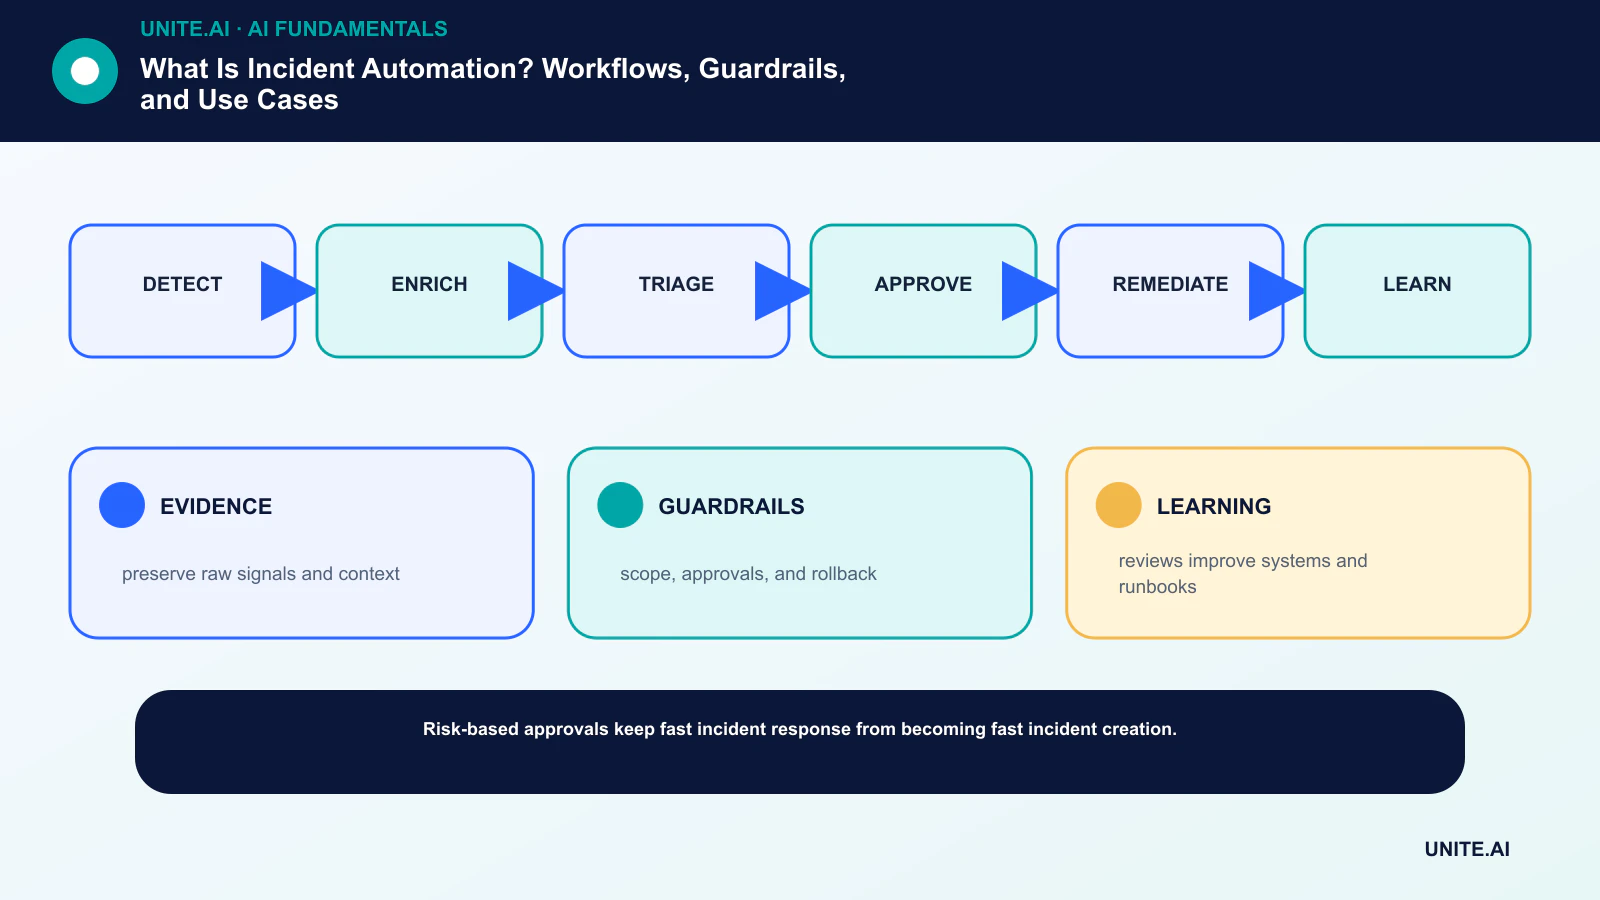
Omform konceptet til en afgrænset, testbar arbejdsproces: opdage → berige → triagere → godkende → afhjælpe → lære. Navngiv en ansvarlig ejer, dokumentér data og afhængigheder, etabler en simpel baseline, fastsæt accept‑ og stop‑kriterier, test repræsentative fejl, og definér overvågning, rollback og gennemgang, før omfanget udvides. Registrér versioner og antagelser, så et andet team kan reproducere resultatet og forstå, hvad der ændrede sig.
Før lancering skal du gennemføre en dokumenteret beredskabsgennemgang med de personer, der bygger, driver, sikrer og påvirkes af systemet. Test normale tilfælde, grænsebetingelser, afhængighedsfejl og misbrug; bevar beviserne og de uafklarede risici. Definér hvem der kan godkende en udgivelse, ændre en tærskel, tilsidesætte et output eller stoppe driften. Genovervej beslutningen, når virkelige data ankommer, fordi en teknisk vellykket pilot ikke garanterer pålidelig ydeevne i større skala.
- BEVIS: bevar rå signaler og kontekst.
- SIKKERHEDSGRÆNSER: omfang, godkendelser og rollback.
- LÆRING: gennemgange forbedrer systemer og runbooks.
Ofte stillede spørgsmål
Er hændelsesautomatisering det samme som AIOps?
Nej. AIOps anvender analyse eller maskinlæring på driftsdata. Hændelsesautomatisering er det bredere udførelses‑ og koordineringslag; den kan bruge simple regler, AIOps‑output eller begge dele.
Hvad bør automatiseres først?
Start med høj‑frekvente, lav‑risiko, velkendte trin såsom berigelse, ejerskabs‑opslag, indsamling af beviser, statusopdateringer og reversible diagnostikker.
Primære referencer