
Grundlæggende AI
Hvad er gradientnedstigning?

 Føj Unite.AI til dine foretrukne kilder på Google
Gradient descent er en optimeringsmetode, der justerer modellens parametre for at reducere en målfunktion. I træning af neurale netværk er dette mål typisk et tab beregnet over eksempler. Gradientens retning peger mod den stejleste lokale stigning, så gradientnedstigning tager et skridt i den modsatte retning.
Gradienten beskriver lokal følsomhed; dens størrelse er ikke en direkte måling af, hvor hurtigt en model “lærer”. Den faktiske fremdrift afhænger også af læringsraten, krumning, støj, parameterisering, optimeringsstatus og data.
Vigtige pointer
- Backpropagation beregner gradienter, mens gradient descent bruger dem til at opdatere parametre.
- Mini‑batch‑optimering er den standardpraksis inden for dyb læring.
- Læringsraten styrer opdateringsskalaen og kan følge en plan i stedet for at falde efter hvert skridt.
- Momentum, AdamW, clipping og normalisering tackler forskellige optimeringsproblemer.
Den grundlæggende opdateringsregel
For parametervektoren θ, læringsraten η og tabet L:
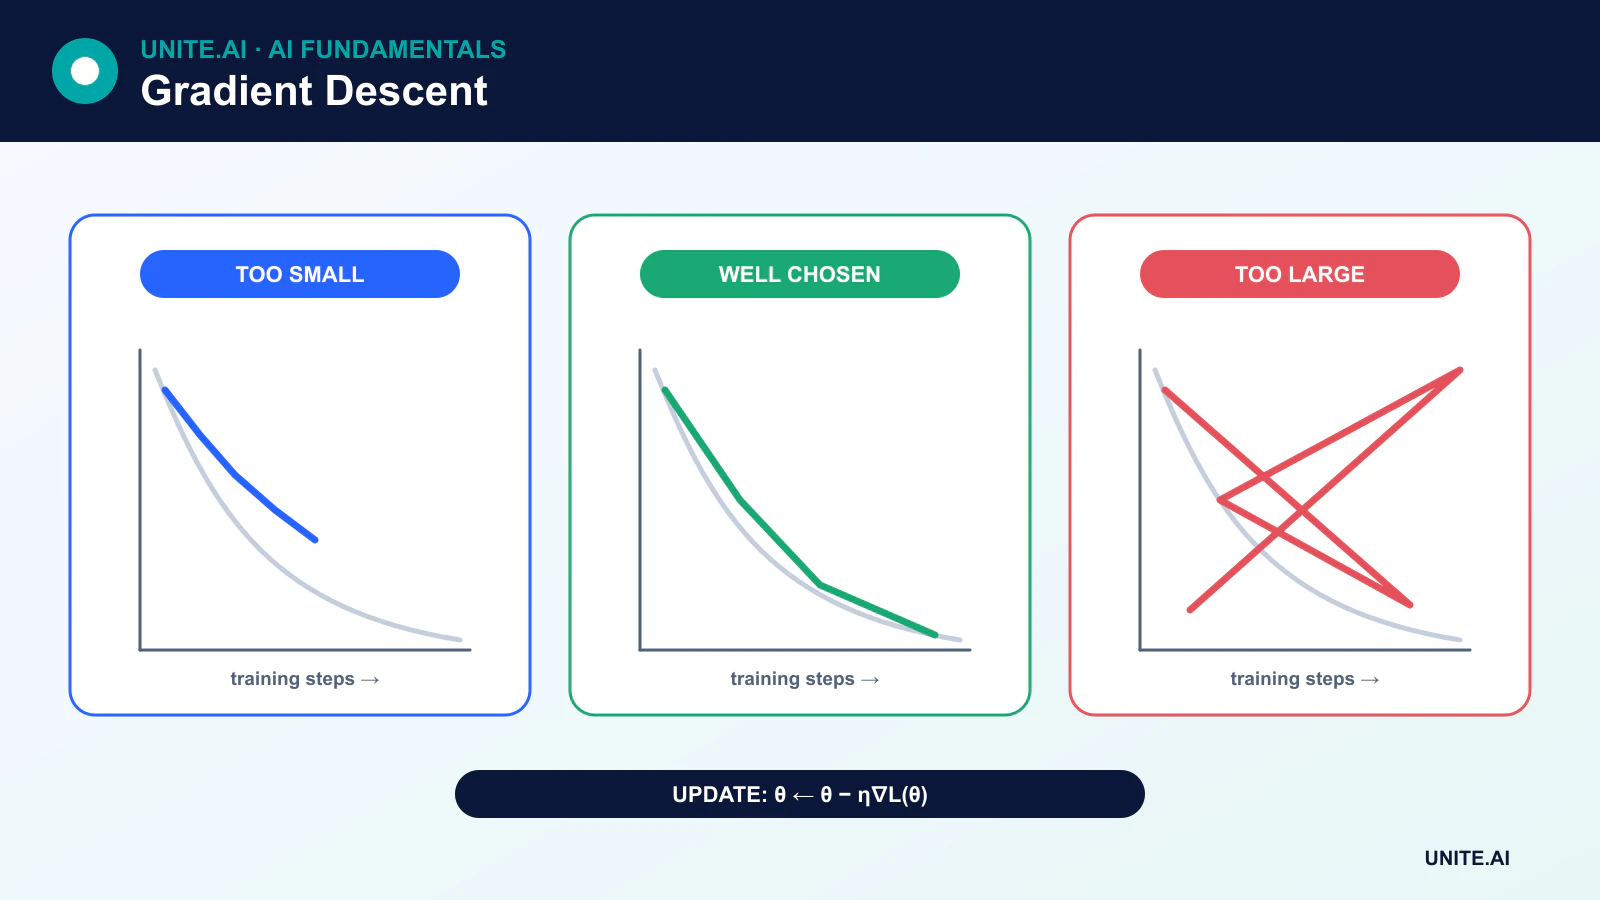
θ ← θ - η∇L(θ)
Gradienten ∇L(θ) indeholder én partiel afledning per parameter. At trække den fra flytter lokalt ned ad bakke. Et stationært punkt har gradienten nul, men det kan være et minimum, maksimum, saddelpunkt eller en flad region. Tabsoverflader i dyb læring er ikke‑konvekse, så træning garanterer ikke at finde et entydigt globalt minimum eller nul tab.
Batch‑, stokastiske‑ og mini‑batch‑metoder
Batch‑gradientnedstigning
Batch‑gradientnedstigning beregner en gradient ved hjælp af hele træningssættet for hver opdatering. Estimatet er stabilt, men kan være tids- og hukommelseskrævende, og én opdatering kan underudnytte moderne acceleratorer.
Stokastisk gradientnedstigning
Streng stokastisk gradientnedstigning bruger ét tilfældigt udvalgt eksempel per opdatering. Dens gradienter er støjende, hvilket kan hjælpe med at udforske tabsoverfladen, men enkelt‑eksempel‑operationer kan være ineffektive på parallel hardware.
Mini‑batch‑gradientnedstigning
Mini‑batch‑træning estimerer gradienten ud fra et delmængde af eksempler. Den balancerer statistisk støj med effektive matrixoperationer og er den sædvanlige tilgang inden for deep learning. Batch‑størrelsen påvirker hukommelse, gennemløb, gradientstøj, normalisering og undertiden generalisering.
Valg af læringsrate
En rate, der er for stor, kan overskride nyttige regioner eller forårsage divergens. En rate, der er for lille, kan gøre træningen upraktisk langsom eller få den til at gå i stå i flade regioner. Den optimale skala afhænger af optimeringsalgoritmen, batch‑størrelsen, modellen, initialiseringen og målet.
Planer kan varme gradvist op, falde ved milepæle, følge en cosinuskurve eller reagere på valideringsfremskridt. Raten behøver ikke at falde monotonisk efter hver opdatering. Varme genstarter og cykliske planer øger den bevidst i dele af træningen.
Momentum
Momentum opretholder et eksponentielt glidende gennemsnit af tidligere gradienter. Det kan accelerere fremdrift langs konsistente retninger og reducere oscillerende bevægelser i stejle, smalle retninger. Nesterov‑stil momentum evaluerer eller tilnærmer gradienten efter at have kigget frem langs momentum‑retningen.
Adaptiv optimeringsalgoritmer
RMSProp skalerer opdateringer ved hjælp af et glidende gennemsnit af kvadrerede gradienter. Adam kombinerer momentum‑lignende første momenter med skalering af andet moment. AdamW adskiller vægtforfald fra den adaptive gradientopdatering og er bredt anvendt til transformer‑modeller.
Adaptiv optimering gør ofte den tidlige træning lettere, men de er ikke automatisk overlegne for enhver model eller endelige generaliseringsmål. Sammenligninger af optimerere kræver matchede planer og omhyggelig finjustering.
Gradient‑klipning og -akkumulering
Gradient‑klipning begrænser en gradients norm eller værdier for at reducere påvirkningen af eksploderende gradienter, især i rekurrent eller ustabil træning. Gradient‑akkumulering tilføjer gradienter fra flere mindre batches før en opdatering, hvilket efterligner en større effektiv batch, når hukommelsen er begrænset.
Overvågning af optimering
Følg trænings‑ og valideringstab, opgave‑metrikker, læringsrate, gradientnormer, parameternormer og numeriske fejl. Faldende træningstab kombineret med forværret valideringspræstation indikerer overfitting, ikke en optimeringssucces der automatisk bør fortsætte.
Optimering minimerer det givne mål. Et lavt tab beviser ikke, at data, metrik eller virkelighedsadfærd er passende. Lækage, dårlige etiketter og et fejlagtigt mål kan producere en veloptimeret men skadelig model.
Optimeringsgeometri og opdateringsregler
Gradientnedstigning opdaterer parametre i den modsatte retning af en tabs gradient. Full‑batch‑nedstigning bruger hvert træningseksempel per skridt; stokastisk nedstigning bruger ét; mini‑batch‑metoder estimerer gradienten ud fra et delmængde og dominerer dyb læring. Læringsraten fastsætter skridtskalaen. For lille spilder beregning eller får processen til at stå stille; for stor får oscillerende eller divergerende adfærd. Momentum akkumulerer en bevægelsesretning, mens adaptive metoder som Adam skalerer koordinater ved hjælp af gradient‑momenter. Deres forskellige implicitte bias kan producere modeller med lignende træningstab men forskellig generalisering.
Tabsoverflader i neurale netværk indeholder flade og skarpe regioner, saddel‑punkter, symmetrier og dårligt konditionerede retninger. Feature‑scaling, normalisering, initialisering, residual‑forbindelser og præ‑konditionering ændrer den geometri, som optimereren ser. Planer kan varme op, falde, cykle eller reagere på plateau‑faser. Vægt‑decay er forskellig fra blot at tilføje en L2‑straff i nogle adaptive optimerere. Batch‑størrelsen påvirker støj, hukommelse, parallelisme og læringsrate‑regimet, så sammenligninger af optimerere kræver matchede træningsbudgetter og omhyggelig finjustering.
Diagnose, reproducerbarhed og stop
Følg trænings‑ og valideringstab, opgave‑metrikker, gradient‑ og parameternormer, læringsrate, gennemløb og numeriske advarsler. Divergens kan skyldes korrupte batches, ugyldige etiketter, ustabil blandet præcision eller en forkert tabsreduktion. Plateau‑faser kan indikere underkapacitet, mættede aktiveringer, dårlige features, overdreven regularisering eller et planlægningsproblem. Overfitting kræver data, augmentation, regularisering eller tidlig stop‑ning – ikke en påstand om at optimereren fejlede. Undersøg repræsentative fejl og sammenlign en simpel baseline før træningskompleksiteten øges.
Reproducerbarhed kræver frø, data‑rækkefølge, kode, konfiguration, hardware‑ og biblioteks‑versioner, selvom nogle accelerator‑kerner forbliver nondeterministiske. Gem checkpoints med optimizer‑ og scheduler‑status, så træningen kan genoptages konsistent. Vælg et checkpoint baseret på valideringskriterier fastlagt på forhånd og reserver et ubrugt test‑sæt. I distribueret træning skal den effektive batch‑størrelse, gradient‑gennemsnit og håndtering af fejlede arbejdere bekræftes. Optimering minimerer det valgte mål på tilgængelige data; den garanterer ikke kalibrerede sandsynligheder, kausal ræsonnement, retfærdighed, sikkerhed eller reel nytte.
Praktisk eksempel: justering af en optimizer for en sprogmodel
Et team fastlægger tokenizer, data‑rækkefølge, model, effektiv batch og træning‑token‑budget, og sammenligner derefter SGD med momentum og AdamW over forsvarlige læringsrate‑planer. Warm‑up, decay, weight decay, clipping og præcision logges. Hver kandidat køres med flere frø, og valideringen bruger et hold‑out tids‑slice plus opgave‑evalueringer. Gennemløb og energi rapporteres sammen med tab, så en let bedre optimizer ikke vælges til en uforholdsmæssig omkostning.
Diagnostik afslører, om ustabilitet stammer fra en datashard, for stor skridtlængde, underflow eller modelarkitektur. Checkpoints bevarer optimizer‑ og scheduler‑status og genoptages i en test. Det endelige valg baseres på valideringskvalitet og robusthed, ikke det laveste træningstab. Et lukket test‑sæt køres én gang efter udvælgelse. Produktion‑inference kalibreres og overvåges separat, fordi optimizer‑succes under fortræning ikke etablerer sikker eller sandfærdig adfærd.
Implementeringsbeviser og driftsklarhed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før justering. Test almindelige tilfælde, grænseforhold, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underforsynet. Mål opgavekvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der tildeles myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operativ telemetri bør afsløre inputkvalitet, outputadfærd, model‑ eller regel‑version, afhængighedssundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en respons‑ejer, og gennemgå real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstation vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Opnår gradientnedstigning altid det globale minimum?
Nej. For konvekse mål giver passende betingelser stærke garantier. Målsætninger i dybe netværk er ikke‑konvekse, og praktiske optimerere søger typisk en brugbar løsning frem for at bevise, at de har fundet det entydige globale minimum.
Hvorfor kan en nul‑gradient være vildledende?
En nul‑ eller meget lille gradient kan indikere et minimum, maksimum, saddelpunkt, mætning eller fladt plateau. Træningsdiagnostik skal tage højde for tabshistorik, krumning, parameterskala og valideringspræstation.
Primære referencer












