
Grundlæggende AI
Hvad er en autoencoder?

 Føj Unite.AI til dine foretrukne kilder på Google
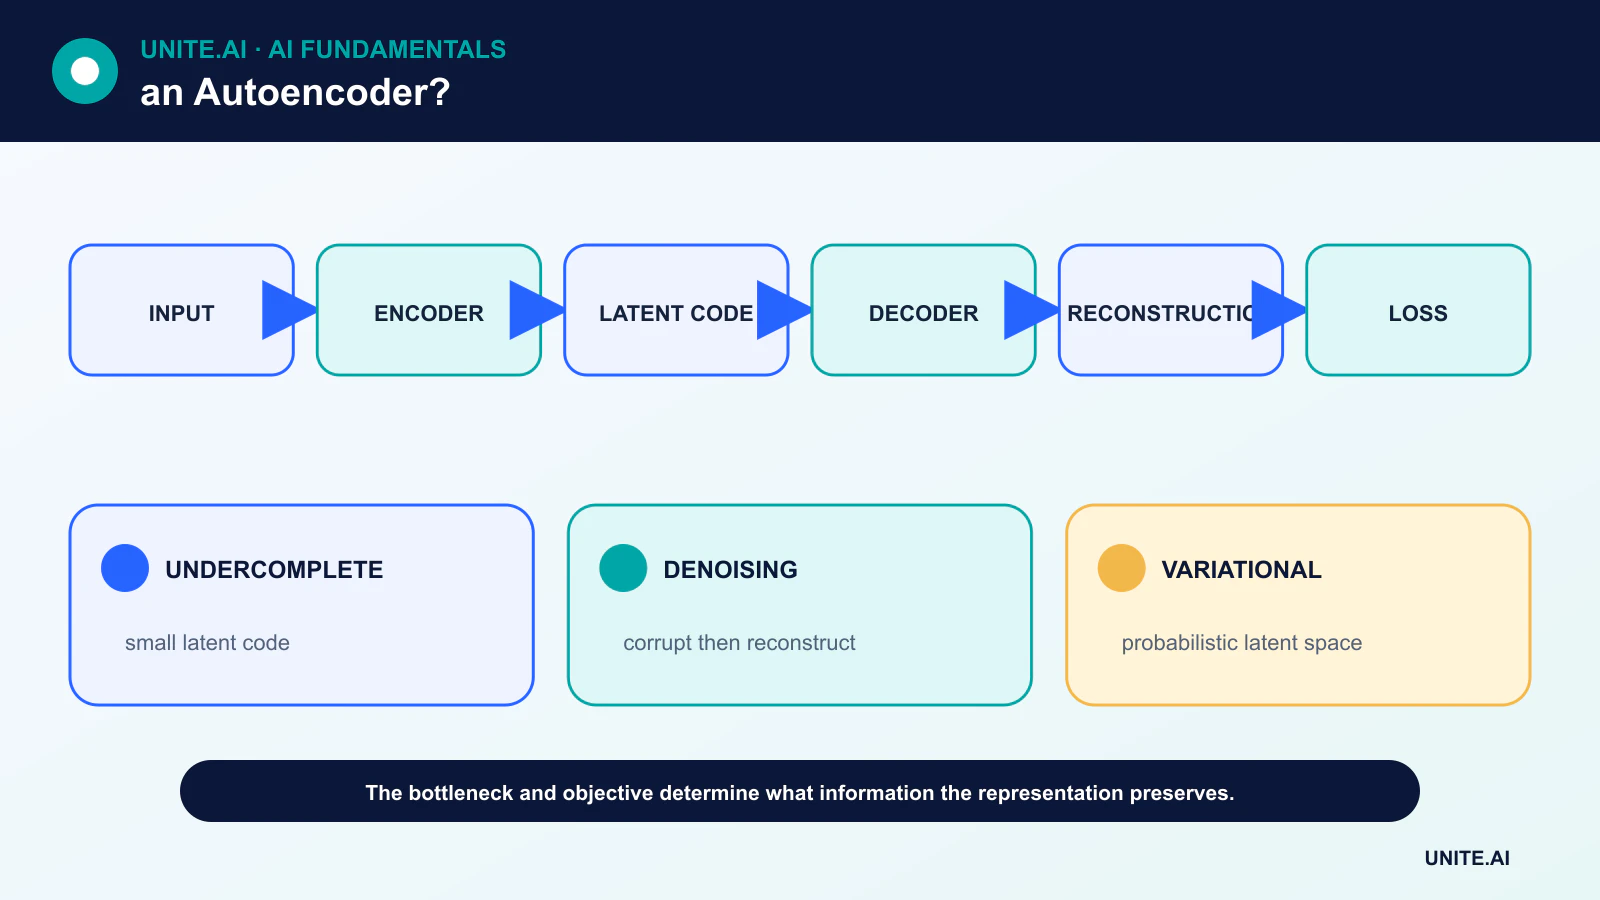
En autoencoder er et neuralt netværk, der er trænet til at rekonstruere sin input. En encoder kortlægger inputtet til en latent repræsentation; en decoder kortlægger den repræsentation tilbage til en rekonstruktion. Træning minimerer et rekonstruktions‑tab, nogle gange med yderligere begrænsninger.
At kopiere inputtet perfekt er ikke automatisk nyttigt. Arkitekturen eller målet skal skabe en flaskehals, tilføje støj, pålægge sparsitet eller på anden måde forhindre en triviel identitets‑mapping, så den latente kode fanger nyttig struktur.
Vigtige pointer
- Encoderen komprimerer eller transformerer et input; decoderen rekonstruerer det ud fra en latent kode.
- En underkomplet flaskehals, støj eller regularisering opmuntrer modellen til at lære struktur i stedet for blot at kopiere.
- Rekonstruktionsfejl kan understøtte anomalidetektion, men anomalier garanteres ikke at have høj fejl.
- Variationale autoencodere lærer en probabilistisk latent model og adskiller sig fra deterministiske autoencodere.
Encoder, latente rum og decoder
For input x producerer encoderen den latente kode z = f(x) og decoderen producerer rekonstruktionen x̂ = g(z). Tabet sammenligner x og x̂, for eksempel med middelkvadreret fejl for kontinuerlige værdier eller en sandsynlighed, der passer til dataene.
Den latente dimension kan være mindre end inputtet, hvilket skaber en underkomplet autoencoder. Et dybt netværk kan også lære ikke‑lineære repræsentationer, som udvider idéen bag dimensionality reduction.
Almindelige autoencoder-varianter
En sparsom autoencoder straffer udbredt aktivering. En denoiserende autoencoder modtager et beskadiget input og rekonstruerer den rene version. En kontraktiv autoencoder straffer følsomheden af koden over for små inputændringer.
En variational autoencoder (VAE) indkoder parametre for en sandsynlighedsfordeling, sampler en latent værdi og balancerer rekonstruktion med et regulariseringsterm, der former det latente rum. Dette understøtter sampling, men ændrer målet og fortolkningen.
Træning og undgåelse af trivielle løsninger
Autoencodere bruger backpropagation ligesom andre neural networks. Et netværk med for stor kapacitet kan memorere træningseksempler eller lære en næsten identitetsfunktion. Flaskehalsens størrelse, korruption, straf og validering på usete data begrænser det.
Valg af tab er vigtigt. Pixel‑vis tab kan producere slørede billedrekonstruktioner, mens perceptuelle tab arver antagelser fra et andet netværk. Den bedste rekonstruktionsmåling er ikke nødvendigvis den bedste målestok for semantisk lighed.
Anvendelser og begrænsninger
Autoencodere kan lære funktioner, fjerne støj fra signaler, komprimere data, initialisere modeller og producere latente variable til visualisering. Til anomalidetektion kan en model, der er trænet på normal data, tildele højere rekonstruktionsfejl til usædvanlige input.
Den tilgang kan fejle, når autoencoderen også rekonstruerer anomalier godt, eller når harmløs variation er sværere at rekonstruere end den ønskede anomali. Tærskler kræver mærkede eller omhyggeligt gennemgåede valideringsdata, og fejl bør overvåges efter undergruppe og driftsforhold.
Autoencodere versus andre generative modeller
En deterministisk autoencoder er ikke automatisk en probabilistisk generativ model. VAE’er definerer en struktureret latent fordeling; GANs træner en generator mod en diskriminator; diffusionsmodeller lærer en denoiseringsproces.
Valget afhænger af, om målet er rekonstruktion, repræsentation, sandsynlighed, prøvens nøjagtighed, kontrollerbarhed eller anomaliscoring. En mindre opgavespecifik model er ofte mere praktisk end en stor billedgenerator.
Encoder‑decoder‑mål og latente repræsentationer
En autoencoder lærer en encoder, der kortlægger input x til en latent kode z, og en decoder, der rekonstruerer x fra z. Hvis kapaciteten er ubegrænset, kan den lære en identitets‑mapping med lidt nyttig struktur. Flaskehalse, regularisering, korruption, sparsitet eller arkitektoniske begrænsninger tvinger en repræsentation, der bevarer udvalgt information. Rekonstruktions‑tabet definerer, hvad der tæller som lignende: middelkvadreret fejl favoriserer gennemsnitlig pixel‑trofasthed, mens perceptuelle eller modalitiespecifikke tab lægger vægt på forskellige funktioner. Et lavt tab garanterer ikke semantisk mening.
Underkomplette autoencodere begrænser den latente dimension. Denoiserende autoencodere rekonstruerer rene data fra beskadiget input. Sparsomme varianter straffer aktivering; kontraktive varianter straffer følsomhed. Variationale autoencodere lærer en probabilistisk latent fordeling ved at kombinere rekonstruktion med et divergens‑term, hvilket muliggør sampling men ændrer målet. Konvolutionelle, sekvens‑, graf‑ og transformer‑autoencodere indkoder modalitiestrukturen. Vælg latent størrelse og regularisering gennem efterfølgende validering, ikke kun ved attraktive todimensionale plot.
Anomalidetektion, kompression og evaluering
Til anomalidetektion trænes på repræsentativ normal data og scores på rekonstruktionsfejl eller latent sandsynlighed, men anomalier kan nogle gange rekonstrueres godt, mens sjældne normale tilfælde kan rekonstrueres dårligt. Vælg tærskler på mærkede eller gennemgåede validerings‑cases, rapportér hændelses‑recall og falske alarmer, og test ændringer i drifts‑tilstand. Sammenlign med simple statistiske og én‑klasse‑baselines. Til kompression skal hele codec’en tælles – inklusive modelstørrelse, kvantisering, metadata og dekodnings‑beregning – og kvaliteten sammenlignes ved tilsvarende bitrate med etablerede codecs.
Repræsentationskvalitet kan evalueres gennem lineære sondringer, klynge‑stabilitet, genfinding, rekonstruktion og efterfølgende opgaver, hver svarende på et andet spørgsmål. Undgå lækage, når encoder‑en læres, og når tærskler vælges. Undersøg hvilke funktioner tabet ignorerer, og om følsomme attributter forbliver indkodet. En komprimeret latent er ikke automatisk anonymiseret; inversion og attribut‑inference kan genvinde private oplysninger. Genererede rekonstruktioner kan også fremstå plausible, mens de ændrer kritiske detaljer.
Implementering og overvågning
Versionér encoder og decoder sammen, valider numeriske ændringer efter eksport, og bevar input‑skalering. Overvåg rekonstruktionsfordeling, latent drift, tærskel‑alarmer og bekræftede resultater. I industriel overvågning skal modellen betinges af drifts‑tilstand, så normale overgange ikke behandles som fejl. Til medicinsk eller videnskabelig rekonstruktion må man aldrig præsentere en genereret detalje som målt bevis uden validering og oprindelse. Autoencodere er fleksible repræsentations‑lærere, men begrænsningerne og tabet – ikke arkitekturens navn – bestemmer, hvilken information der bevares, kasseres eller fabrikeres.
Arbejdeeksempel: en autoencoder til pumpenomalier
En underkomplet autoencoder lærer vibrations‑vinduer fra bekræftet sund pumpedrift på tværs af belastning og temperatur. Den sammenlignes med statistiske tærskler og én‑klasse‑metoder, og dens rekonstruktions‑tærskel vælges på gennemgåede normale overgange og kendte fejl. Evalueringen bruger hændelses‑recall, advarsels‑forsinkelse, falske alarmer pr. driftstime og resultater pr. pumpe, ikke tilfældige vinduer, der placerer tilstødende prøver i trænings‑ og test‑sættet.
Produktionsmodellen betinges af drifts‑tilstand og eksponerer restmønstre for ingeniører. En høj fejl udløser inspektion; den diagnosticerer ikke delen eller stopper pumpen automatisk. Sensor‑frakobling, clipping og uset belastning skaber eksplicitte ugyldige tilstande. Overvågning sporer rekonstruktionsfordeling, alarm‑bekræftelse og sensorsundhed. Når vedligeholdelse eller hardware ændrer grundlaget, forbliver den gamle model tilgængelig, mens en kandidat trænes på gennemgåede data og afspilles mod historiske hændelser.
Implementeringsbeviser og driftsparathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér en reproducerbar baseline og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, randbetingelser, fejlformet eller manglende input, distributions‑skift, afhængigheds‑nedbrud, misbrug og de grupper eller miljøer, der mest sandsynligt er underforsynet. Mål opgavekvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne bevis fra en attraktiv prototype.
Før lancering skal der udpeges myndighed for udgivelse, undtagelser, ændringer, rollback og pensionering. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst injicerede fejl. Operativ telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret genoprettelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er autoencodere tabsfri kompression?
Ikke generelt. De lærer typisk opgave‑ og distributionsspecifikke tabs‑repræsentationer og kræver den trænede decoder for at rekonstruere data.
Er hver flaskehals fortolkelig?
Nej. En kompakt kode kan være nyttig uden at hver dimension svarer til et menneskelæsbart koncept.
Primære referencer












