
Anderson 视角
UniTune:谷歌的替代神经图像编辑技术

 将 Unite.AI 添加到您在 Google 上的首选来源
要点UniTune 在单张图像上微调扩散模型,以实现精确的文本驱动编辑。
查看更多
- UniTune 在单张图像上微调扩散模型,以实现精确的文本驱动编辑。
- 与 DreamBooth 或 Textual Inversion 不同,UniTune 摒弃了这两种方法,以更好地保留细节。
- 该方法实现了高语义解耦,在彻底改变背景的同时保持面部完整。
谷歌研究似乎正在从多个方向攻击基于文本的图像编辑,并且可能正在等待看哪种方法会成功。就在本周发布了Imagic论文之后,搜索巨头提出了另一种基于潜在扩散的方法,用于通过文本命令对图像进行其他方式无法实现的AI编辑,这次被称为UniTune。
根据项目的新论文中给出的示例,UniTune已经在将语义姿态和概念与实际图像内容解耦方面取得了非凡进展:

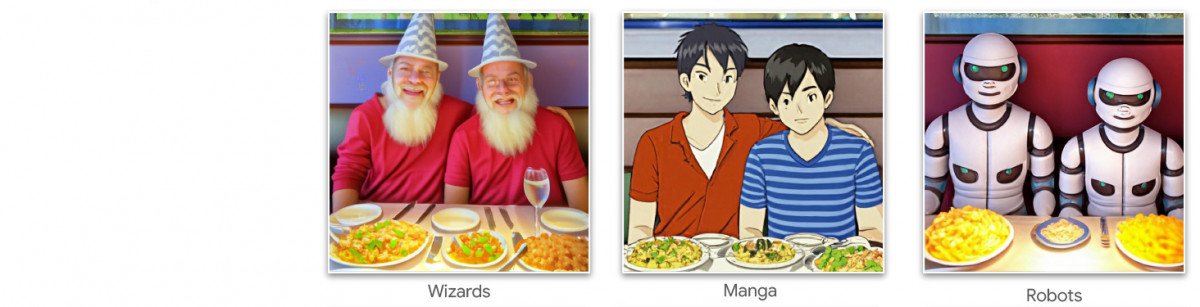

UniTune的语义组合能力出色。注意在图片的最上一行中,两个人的脸没有被图像的非凡转换所扭曲(右)。来源:https://arxiv.org/pdf/2210.09477.pdf
Stable Diffusion的粉丝可能已经知道,应用编辑到图片的部分区域而不对图片的其他部分产生负面影响可能是一个棘手的操作。虽然像AUTOMATIC1111这样的流行分布可以为局部和受限的编辑创建掩码,但这个过程是繁琐的,且经常不可预测。
显然的解决方案,至少对于计算机视觉从业者来说,是插入一个能够在不需要用户干预的情况下识别和隔离图像中的对象的语义分割层。确实,最近有几项新倡议沿着这条思路发展。
另一个可能性是利用OpenAI的有影响力的对比语言-图像预训练(CLIP)模块,它是潜在扩散模型(如DALL-E 2和Stable Diffusion)的心脏。CLIP应该作为一个过滤器,在文本到图像模型准备将解释后的渲染发送回用户时发挥作用。在这种情况下,CLIP应该作为一个哨兵和质量控制模块,拒绝格式错误或不合适的渲染。这即将实施于Stability.ai由API驱动的DreamStudio门户(Discord链接)。
然而,由于CLIP在这种情况下既是罪魁又是解决方案(因为它本质上也告知了图像的演化),并且由于硬件要求可能超过最终用户可能拥有的,因此这种方法可能不是理想的。
压缩语言
提出的UniTune方法“微调”一个现有的扩散模型——在这种情况下,谷歌自己的Imagen,尽管研究人员表示该方法与其他潜在扩散架构兼容——通过将一个唯一的令牌注入其中,该令牌可以通过在文本提示中包含它来调用。
从表面上看,这听起来像谷歌的DreamBooth,目前是Stable Diffusion粉丝和开发人员的痴迷,可以在现有的检查点中注入新角色或对象,通常不到一小时,基于少数几个源图片;或者像Textual Inversion,它为检查点创建“伴侣”文件,然后像原始训练到模型一样对待它们,从而可以利用模型自身的巨大资源来修改其文本分类器,结果是一个与DreamBooth最小2GB剪枝检查点相比非常小的文件。
实际上,研究人员断言,UniTune拒绝了这两种方法。他们发现Textual Inversion省略了太多重要的细节,而DreamBooth比他们最终采用的方案“表现更差,耗时更长”。
尽管如此,UniTune仍采用与DreamBooth相同的封装式语义“元提示”方法,由训练者选择独特词语来调用学到的变化,避免与经过艰苦训练的公开模型中已有的词语冲突。QUOTEOPEN“执行编辑时,我们使用提示«[rare_tokens] edit_prompt»对微调模型采样(例如«beikkpic 餐厅里的两只狗»或«beikkpic 一个小黄人»)。”QUOTECLOSE
过程
尽管两篇几乎相同的论文在功能上似乎同时来自谷歌,但UniTune和Imagic之间至少有一个明显的区别——后者使用“未压缩”的自然语言提示来指导图像编辑操作,而UniTune则以DreamBooth风格训练唯一令牌。
因此,如果您使用Imagic进行编辑,并希望对图像进行这种转换…

来自UniTune论文——UniTune将自己与谷歌最喜欢的对手神经编辑框架SDEdit对立起来。UniTune的结果在最右边,而估计的掩码在左边第二张图片中。
.. 在Imagic中,您将输入‘背景中第三个人作为一个可爱的毛绒怪物’。
UniTune的等效命令将是‘后面的家伙作为[x]’,其中x是与与毛绒怪物角色相关的精细训练概念绑定的任何奇怪且唯一的单词。
DreamBooth和Textual Inversion接收多幅图像,以创建能够呈现多种姿态的深度伪造式抽象概念;而UniTune和Imagic只向系统输入一幅图像——原始的、纯净的图像。
这与过去几年许多基于GAN的编辑工具的工作方式类似,它们通过将输入图像转换为GAN的潜在空间中的潜在代码,然后将这些代码发送到潜在空间的其他部分进行修改(例如,输入一张年轻的黑发人的图片,并将其投影到“老”或“金发”相关的潜在代码中等)。
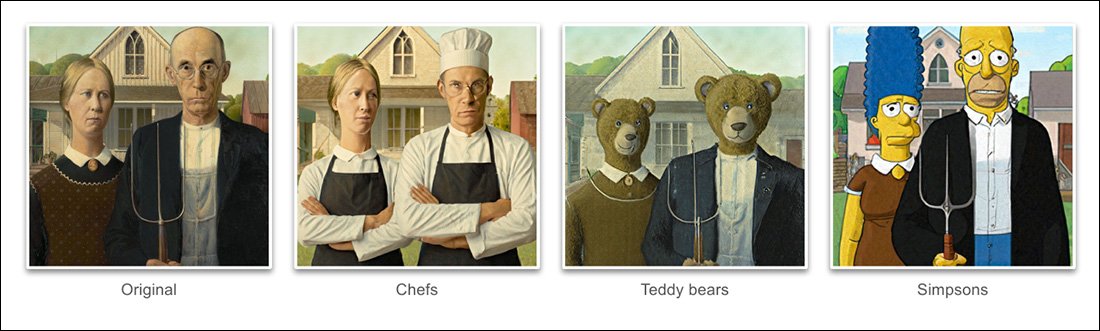
然而,与这种方法相比,通过扩散模型实现的结果相当惊人地准确且不模糊:
微调过程
UniTune方法本质上是将原始图像通过一个扩散模型,带有一组关于如何修改它的指令,使用训练到模型中的大量可用数据。实际上,您可以使用Stable Diffusion的img2img功能来实现这一点——但不能在不扭曲或以某种方式更改您希望保留的图像部分的情况下实现。
在UniTune过程中,系统被微调,即UniTune强制模型恢复训练,大部分层都解冻(见下文)。在大多数情况下,微调将损害高性能模型的整体通用损失值,以注入或完善某些其他方面的创建或增强。
不过,在UniTune中,接受处理的模型副本即使占用数GB或更多空间,似乎也只是一次性的附带“外壳”,完成单一任务后便在流程结束时丢弃。这种庞大的临时数据正在给DreamBooth用户带来日常存储危机,因为他们的模型即使经过剪枝,每个主体仍不少于2GB。与Imagic一样,UniTune主要微调Imagen三个层级中的较低两级(基础64px、64px>256px和256px>1024px)。不同于Imagic,研究人员认为对最后、最大的超分辨率层进行优化也可能有价值,不过尚未尝试。针对最底部64px层,训练使模型偏向基础图像,将多组重复的图像/文本对输入系统,共128次迭代、批量大小4,以Adafactor作为损失函数,学习率为0.0001。此微调期间只有T5编码器被冻结;它在Imagen最初训练时也被冻结。随后在64>256px层重复上述操作,采用与Imagen原始训练相同的噪声增强程序。
采样
有多种可能的采样方法可以从微调模型中获取更改,包括无分类器引导(CFG),这是Stable Diffusion的主要内容。CFG基本上定义了模型可以自由“遵循其想象力”和探索渲染可能性——或者在较低的设置中,定义了模型应该遵循输入源数据并进行更少的、更不显著的更改的程度。

像Textual Inversion(DreamBooth稍微少一些),UniTune可以将不同的图形样式应用于原始图像,以及更逼真的编辑。
研究人员还尝试了SDEdit的“晚期开始”技术,该技术鼓励系统通过仅部分“噪声”从一开始就保留原始细节,而不是完全“噪声”。虽然研究人员只在最低层(64px)上使用了它,但他们相信它可以成为一种有用的辅助采样技术。
研究人员还利用了提示到提示作为一种额外的基于文本的技术来调节模型:
QUOTEOPEN‘在“提示到提示”设置中,我们发现了一种特殊的技术,我们称之为提示指导,特别有助于调整保真度和表达性。 ‘QUOTECLOSE
QUOTEOPEN‘提示指导类似于无分类器引导,除了基线是一个不同的提示,而不是无条件的模型。这种方法引导模型朝着两个提示之间的差异方向。’QUOTECLOSE

UniTune中的提示到提示方法能够有效分离需要修改的区域。
作者指出,只有在CFG未能产生所需结果的某些情况下,才需要提示引导。开发UniTune时发现的另一种新采样方法是插值:图像区域足够独立,且原图和修改图的构图十分接近,因此可以采用更“朴素”的插值。

当需要变换的区域独立且边界清晰时,插值可以使UniTune中更费力的过程变得多余。
作者认为,插值对大量目标源图像的效果可能好到足以作为默认设置。他们还指出,在无需借助更密集的方法处理复杂遮挡时,插值也能够实现非凡变化。UniTune可以使用或不使用编辑掩码来进行局部修改,还能自行决定修改位置,将解释能力与对源输入数据本质特征的稳健保留结合起来:

在第二列最上方的图像中,UniTune根据“背景中的红色列车”指令,将列车放在恰当而真实的位置。其他示例表明,即使像素内容和基本样式发生巨大变化,与源图像之间的语义完整性仍然得以保持。
延迟
虽然任何新系统的第一次迭代都会很慢,而且可能社区参与或企业承诺(通常不是两者兼有)最终会加速和优化资源密集型的例行程序,但UniTune和Imagic正在执行一些相当重要的机器学习操作,以创建这些惊人的编辑,并且值得怀疑这种资源密集型的过程是否可以缩小到家庭使用,而不是API驱动的访问(尽管后者可能更受谷歌欢迎)。
目前,从输入到结果的往返时间约为T4 GPU上的3分钟,推理需要额外30秒(如任何推理例行程序)。作者承认这是高延迟,几乎不符合“交互式”的标准,但他们也指出,模型在最初调整后将保持可用状态,直到用户完成该过程,这减少了每次编辑的时间。
首次发表于2022年10月21日。


