
AI 模型与平台
多模态 AI 演进:ChatGPT 获得视觉能力与 GPT-4V(ision)

 将 Unite.AI 添加到您在 Google 上的首选来源

要点OpenAI的GPT-4V为ChatGPT新增图像分析功能,将人工智能的应用范围从文本扩展至多模态领域。
查看更多
- OpenAI的GPT-4V为ChatGPT新增图像分析功能,将人工智能的应用范围从文本扩展至多模态领域。
- GPT-4V在技术任务中展现出潜力,但在医疗应用方面仍存在关键缺陷。
- 以Med-PaLM M为代表的多模态模型正在推动医疗等专业领域的进步。
在使 AI 更加像人类的持续努力中,OpenAI 的 GPT 模型不断推动着边界。GPT-4 现在能够接受文本和图像的提示。
多模态生成 AI 表示模型能够产生多种输出,如文本、图像或音频,基于输入。这些模型经过特定数据的训练,学习潜在模式以生成类似的新数据,丰富 AI 应用。
多模态 AI 的最新进展
最近,在这个领域的一个显著进步是 DALL-E 3 与 ChatGPT 的集成,这是 OpenAI 文本到图像技术的一个重大升级。这种结合允许更流畅的交互,ChatGPT 帮助创建精确的提示用于 DALL-E 3,将用户的想法转化为生动的 AI 生成艺术。因此,虽然用户可以直接与 DALL-E 3 交互,但拥有 ChatGPT 的参与使得创建 AI 艺术的过程更加用户友好。
查看更多关于 DALL-E 3 和其与 ChatGPT 集成的信息 这里。这种合作不仅展示了多模态 AI 的进步,也使得 AI 艺术创作变得轻松。

Google Health 则在今年六月推出了 Med-PaLM M,这是一个多模态生成模型,擅长编码和解释多样化的生物医学数据。这一成果是通过对 PaLM-E 进行微调来实现的,PaLM-E 是一个语言模型,利用一个开源基准 MultiMedBench 来适应医疗领域。这个基准包括超过 100 万个样本,跨越 7 种生物医学数据类型和 14 项任务,如医疗问答和放射学报告生成。
各个行业正在采用创新多模态 AI 工具来推动业务扩张、简化运营和提高客户参与度。语音、视频和文本 AI 能力的进步正在推动多模态 AI 的增长。
企业正在寻找能够改变业务模式和流程的多模态 AI 应用,开辟数据工具到新兴 AI 应用的整个生成 AI 生态系统中的增长途径。
在 GPT-4 发布后的几个月里,一些用户观察到其响应质量随时间的推移而下降,这一担忧也得到了知名开发者和 OpenAI 论坛用户的呼应。最初被 OpenAI 驳斥,但后来的 研究 确认了这个问题,研究显示,从三月到六月,GPT-4 的准确率从 97.6% 降至 2.4%,表明答案质量随着模型更新而下降。

ChatGPT(蓝色)与人工智能(红色)的 Google 搜索趋势
OpenAI 的 ChatGPT 现在又引起了人们的关注。它现在拥有一个视觉功能 GPT-4V,允许用户让 GPT-4 分析由用户提供的图像。这是最新的功能,已经开放给用户。
将图像分析添加到像 GPT-4 这样的大型语言模型(LLM)中被一些人视为 AI 研究和开发的一个巨大步骤。这种多模态 LLM 开启了新的可能性,超越文本,提供新的接口和解决新的任务,创造新的用户体验。
GPT-4V 的训练于 2022 年完成,早期访问于 2023 年三月推出。GPT-4V 中的视觉功能由 GPT-4 技术提供支持。训练过程保持不变,最初,模型被训练来预测文本中的下一个词,使用来自互联网等多个来源的大型文本和图像数据集。
后来,它通过一种名为基于人类反馈的强化学习(RLHF)的方法进行了微调,以生成人类喜欢的输出。
GPT-4 视觉能力的机制
GPT-4 的视觉语言能力令人印象深刻,但其背后的方法仍有待深入理解。
为探索这一思路,研究人员推出了新的视觉语言模型 MiniGPT-4,它采用名为 Vicuna 的先进大型语言模型。MiniGPT-4 使用带有预训练组件的视觉编码器进行视觉感知,通过单一投影层将编码后的视觉特征与 Vicuna 语言模型对齐。其架构简单而有效,重点是对齐视觉与语言特征,以改善视觉对话能力。
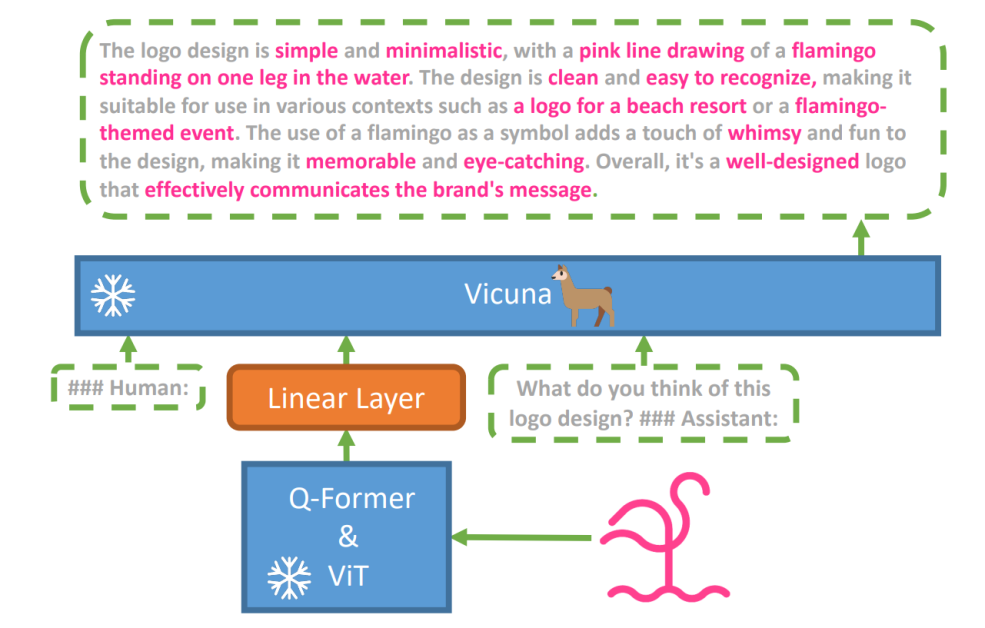
MiniGPT-4 的架构包含预训练的 ViT 与 Q-Former 视觉编码器、单一线性投影层和先进的 Vicuna 大型语言模型。
自回归语言模型在视觉语言任务中的应用也日益增多,通过跨模态迁移在语言领域与多模态领域之间共享知识。
MiniGPT-4 将预训练视觉编码器产生的视觉信息与先进的大型语言模型对齐,从而连接视觉和语言领域。它以 Vicuna 作为语言解码器,并采用两阶段训练:先在大规模图像文本配对数据集上学习视觉语言知识,再用规模较小但质量更高的数据集进行微调,提高生成内容的可靠性和可用性。
为提高 MiniGPT-4 生成语言的自然度与实用性,研究人员设计了两阶段对齐过程,并针对视觉语言对齐数据不足的问题整理了专门的数据集。
首先,模型使用符合 Vicuna 语言模型格式的对话提示,生成输入图像的详细描述,以获得更全面的图像说明。
初始图像描述提示:
###Human: <Img><ImageFeature></Img>Describe this image in detail. Give as many details as possible. Say everything you see. ###Assistant:
该提示要求模型详细描述图像,尽可能提供细节,并说明看到的所有内容。数据后处理阶段使用 ChatGPT 修正描述中的不一致和错误,再进行人工核验以确保质量。
第二阶段微调提示:
###Human: <Img><ImageFeature></Img><Instruction>###Assistant:
这项探索帮助我们理解 GPT-4 等多模态生成式 AI 的运作机制,说明如何有效整合视觉和语言模态,生成连贯且富有上下文信息的内容。
探索 GPT-4 视觉
使用 ChatGPT 确定图像来源
GPT-4 视觉增强了 ChatGPT 分析图像和确定其地理来源的能力。这个功能将用户交互从纯文本转变为文本和视觉的混合,成为那些通过图像数据对不同地方感到好奇的人的有用工具。

向 ChatGPT 查询地标图像的拍摄位置
复杂数学概念
GPT-4 视觉在分析图形或手写表达式方面表现出色。这个功能成为解决复杂数学问题的有用工具,在教育和学术领域具有重要意义。

向 ChatGPT 查询复杂数学概念
将手写输入转换为 LaTeX 代码
GPT-4V 的一个显著能力是将手写输入转换为 LaTeX 代码。这个功能对于经常需要将手写数学表达式或其他技术信息转换为数字格式的研究人员、学者和学生来说是一个福音。从手写到 LaTeX 的转换扩大了文档数字化的范围,并简化了技术写作过程。

GPT-4V 的手写输入转 LaTeX 代码能力
提取表格详细信息
GPT-4V 展示了从表格中提取详细信息和回答相关问题的能力,这对于数据分析来说是一个至关重要的资产。用户可以利用 GPT-4V 来浏览表格,收集关键见解,并解决问题,使其成为数据分析师和其他专业人士的强大工具。

GPT-4V 解析表格详细信息并回答相关问题
理解视觉指向
GPT-4V 独特的理解视觉指向的能力为用户交互添加了一个新维度。通过理解视觉提示,GPT-4V 可以以更高的上下文理解来响应查询。

GPT-4V 展示理解视觉指向的能力
使用绘图构建简单的模拟网站
受这条 推文 的启发,我尝试为 unite.ai 网站创建一个模拟。
虽然结果并没有完全符合我的最初设想,但以下是我的成果。

ChatGPT Vision 生成的 HTML 前端
GPT-4V(ision) 的限制和缺陷
为了分析 GPT-4V,Open AI 团队进行了定性和定量评估。定性评估包括内部测试和外部专家评审,而定量评估则衡量了模型拒绝和在各种场景中的准确性,例如识别有害内容、人口统计识别、隐私问题、地理定位、网络安全和多模态越狱攻击。
然而,该模型并非完美。
该 论文 强调了 GPT-4V 的限制,例如对图像作出错误推断,以及遗漏图像中的文字或字符。它可能会产生幻觉或编造事实。特别地,它不适合识别图像中的危险物质,经常将其误识。
在医疗成像方面,GPT-4V 可能会提供不一致的响应,并缺乏对标准实践的认识,这可能会导致潜在的误诊。

医疗用途中的表现不可靠 (来源)
它还无法理解某些仇恨符号的细微差别,并可能根据视觉输入生成不适当的内容。OpenAI 建议不要将 GPT-4V 用于关键解释,特别是在医疗或敏感的背景下。
总结

使用 Fast Stable Diffusion XL 创建 https://huggingface.co/spaces/google/sdxl
GPT-4 视觉(GPT-4V)的到来带来了许多新可能性和挑战。在推出之前,已经投入了大量的努力,以确保风险,尤其是与人脸图片相关的风险得到充分考虑和减轻。令人印象深刻的是,GPT-4V 在诸如医学和科学等领域表现出巨大的潜力。
现在,有一些重大的问题摆在我们面前。例如,这些模型是否应该能够从照片中识别名人?是否应该根据图片猜测一个人的性别、种族或情绪?是否应该有特殊的调整来帮助视觉障碍人士?这些问题引发了关于隐私、公平和 AI 如何融入我们生活的讨论,这是每个人都应该参与的。


