AI 基础
大型语言模型(LLMs)是什么?

 将 Unite.AI 添加到您在 Google 上的首选来源
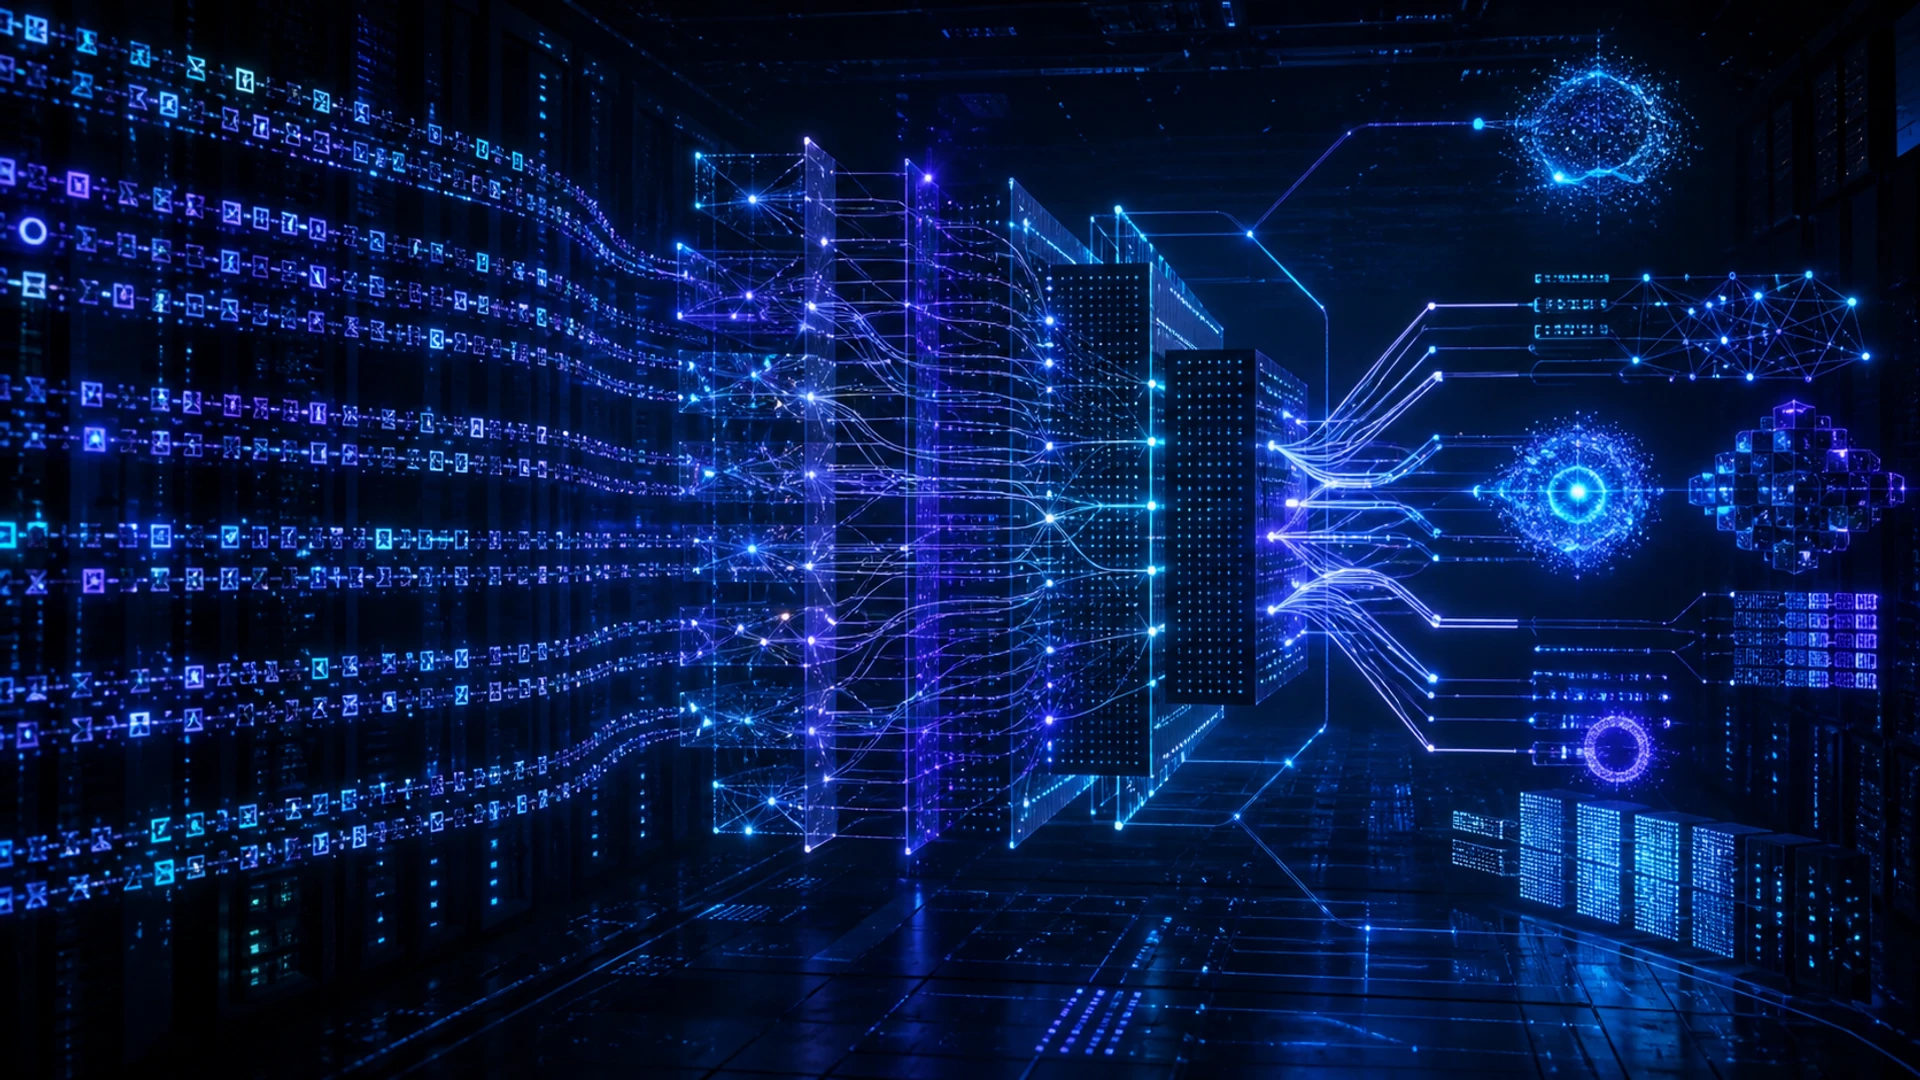
大型语言模型(LLM)是一种在海量序列集合上进行训练的神经网络,用于预测词元或相关语言目标。大多数当前的LLM采用Transformer架构,并能够通过统一接口生成、分类、摘要、翻译、检索和转换语言。
LLM并非数据库或可靠的推理器。其输出是受训练数据、后训练、上下文、工具和解码方式影响的条件预测。流畅性可能与事实错误、不确定性、偏见或不安全行为并存。
要点摘要
- 分词将文本转换为离散单元;嵌入和注意力构建上下文表示。
- 预训练学习广泛模式,而微调和偏好方法塑造任务行为。
- 检索和工具可以添加最新证据或操作,但需要单独的权限和验证。
- 评估已部署系统的质量、可靠性、安全性、延迟、成本和漂移情况。
词元、Transformer 与预训练
文本被划分为词元。Transformer将其映射为向量,通过注意力和前馈层混合信息,并生成下一个或缺失词元的概率分布。
自监督目标从原始序列中创建训练信号。参数、数据和计算规模的提升可以在一定范围内可预测地降低损失,但数据集质量、模型架构、优化方式和评估决定了实际出现的能力。
后训练与推理
指令微调使用示例;偏好优化可以使输出更符合人类判断或策略。在推理时,提示词和对话历史定义上下文,而温度和采样设置影响输出的多样性。
RLHF 等方法塑造模型行为,而不是安装完整的事实检查器。模型仍可能生成看似合理但缺乏依据的答案。
检索、工具与代理
检索增强生成提供从外部集合中挑选的段落。工具调用使应用代码能够查询数据库、计算、搜索或执行操作。这些模式将部分知识和执行从模型权重中分离出来。
应用必须验证工具参数、执行权限控制、保留引用,并将检索内容视为不可信输入。向量相似度搜索有助于检索,但并不能证明某段落支持答案。
局限性与评估
LLM可能出现幻觉、泄露记忆内容、执行恶意指令、复制偏见,并在看似与训练示例相似的任务上失效。长上下文并不保证每个事实都被正确使用或调和。
在具代表性的私有任务上使用已记录的提示词和版本进行评估。衡量来源支持、拒绝率、校准、安全性、子群体结果、人力工作量、延迟和成本。发布后需持续监控,因为模型、数据和用户行为会变化。
训练数据与模型开发
预训练语料库包括网页、书籍、代码、学术材料、对话以及授权或精选的来源。流水线会检测语言、去除重复、过滤质量和不安全内容、处理个人数据,并选择混合权重。这些选择决定了知识、语言覆盖、风格、偏见和记忆程度。
优化过程对批量词元序列进行梯度下降以最小化预测损失。分布式训练在加速器之间划分数据、模型张量、流水线阶段或专家。检查点、数值稳定性、网络通信和故障恢复在大规模时成为主要工程挑战。
训练期间的评估会跟踪损失和能力套件,但基准污染可能导致结果夸大。保留时间段和专有任务,检查重叠,并报告精确的提示词、解码方式、工具和评分。模型可能在平均损失上有所提升,却在安全性或低资源语言上出现退化。
上下文窗口、解码与推理
在推理时,键值缓存存储早期词元的注意力投影,从而无需在每一步重新计算。缓存内存随层数、序列、批次和表示的增大而增长。量化和分页可以降低压力,但可能影响质量或延迟。
贪婪解码选择最高概率的词元;温度重新缩放概率;top‑k 与 top‑p 限制候选集合;束搜索跟踪多个序列。最佳策略取决于任务是更看重确定性、多样性、结构化输出还是序列概率。生成后务必验证模式。
长上下文增加了可用信息量,但并不保证召回或推理的准确性。位置、干扰项、矛盾以及提示结构都会影响使用。检索可以选择更小的证据集,而摘要则在压缩历史的同时可能丢失细节。需在不同上下文长度和位置上衡量性能。
适配、部署与经济性
完整微调会更新所有参数;参数高效方法更新适配器或低秩矩阵;持续预训练适应领域分布;指令和偏好微调塑造响应。对于经常变化的事实,检索通常更合适,而微调更适用于行为和任务格式。这些方法可以组合使用。
部署选项包括托管 API、托管端点、自托管开源权重、设备端模型以及混合方案。比较数据处理、版本控制、延迟、吞吐量、地域、可用性、模型可移植性、支持与总体成本。自托管将安全、扩展、更新和滥用监控的责任转移给用户。
每个词元的成本并不完整。弱模型可能需要重试、更长的提示词、更多审查或代价高昂的错误。应衡量在所需质量和风险水平下成功完成任务的成本。使用缓存、批处理、更小的路由模型以及确定性代码,以提升整体工作流。
案例示例:在企业文档中为 LLM 打下基础
文档助理应从具备权限感知的语料库、稳定的文档标识符、版本和生效日期、可解析的结构以及包含可回答、不可回答、模糊和冲突问题的评估集开始。检索会为块和元数据建立索引,但块大小和重叠必须匹配文档结构。搜索质量在生成前独立评估,以防流畅模型隐藏缺失证据。
运行时,验证用户身份、按访问权限过滤检索、检索并重新排序证据、构建受限提示词、生成带引用的答案,并验证所需输出。模型应在来源冲突或不支持答案时予以说明。工具使用和外部操作需要单独授权。通过将内容视为数据而非更高优先级的系统策略,防止检索文档中嵌入的指令。
在不同角色和文档类型下评估检索召回率、引用精度、答案正确性、可靠性、拒绝率、延迟和成本。对每次测试记录模型、提示词、索引、解析器和语料库的版本。在生产环境中,记录证据 ID 与反馈而不泄露私有文本,监控内容变更后出现的新不可回答问题,并保持安全的回退机制。LLM 接口并不能取代记录管理、访问控制或负责任的主题审查。
容量规划应对提示词和输出长度分布、并发用户、缓存行为、工具延迟和重试率进行建模。流式传输可降低感知延迟,但会使审核和取消变得复杂,因为不安全或错误的内容可能在完整响应检查前就到达用户。设定词元和工具预算,隔离租户,保护提供商凭证,并演练模型版本之间的故障转移,避免在不知情的情况下改变用户依赖的行为。
实用实施清单
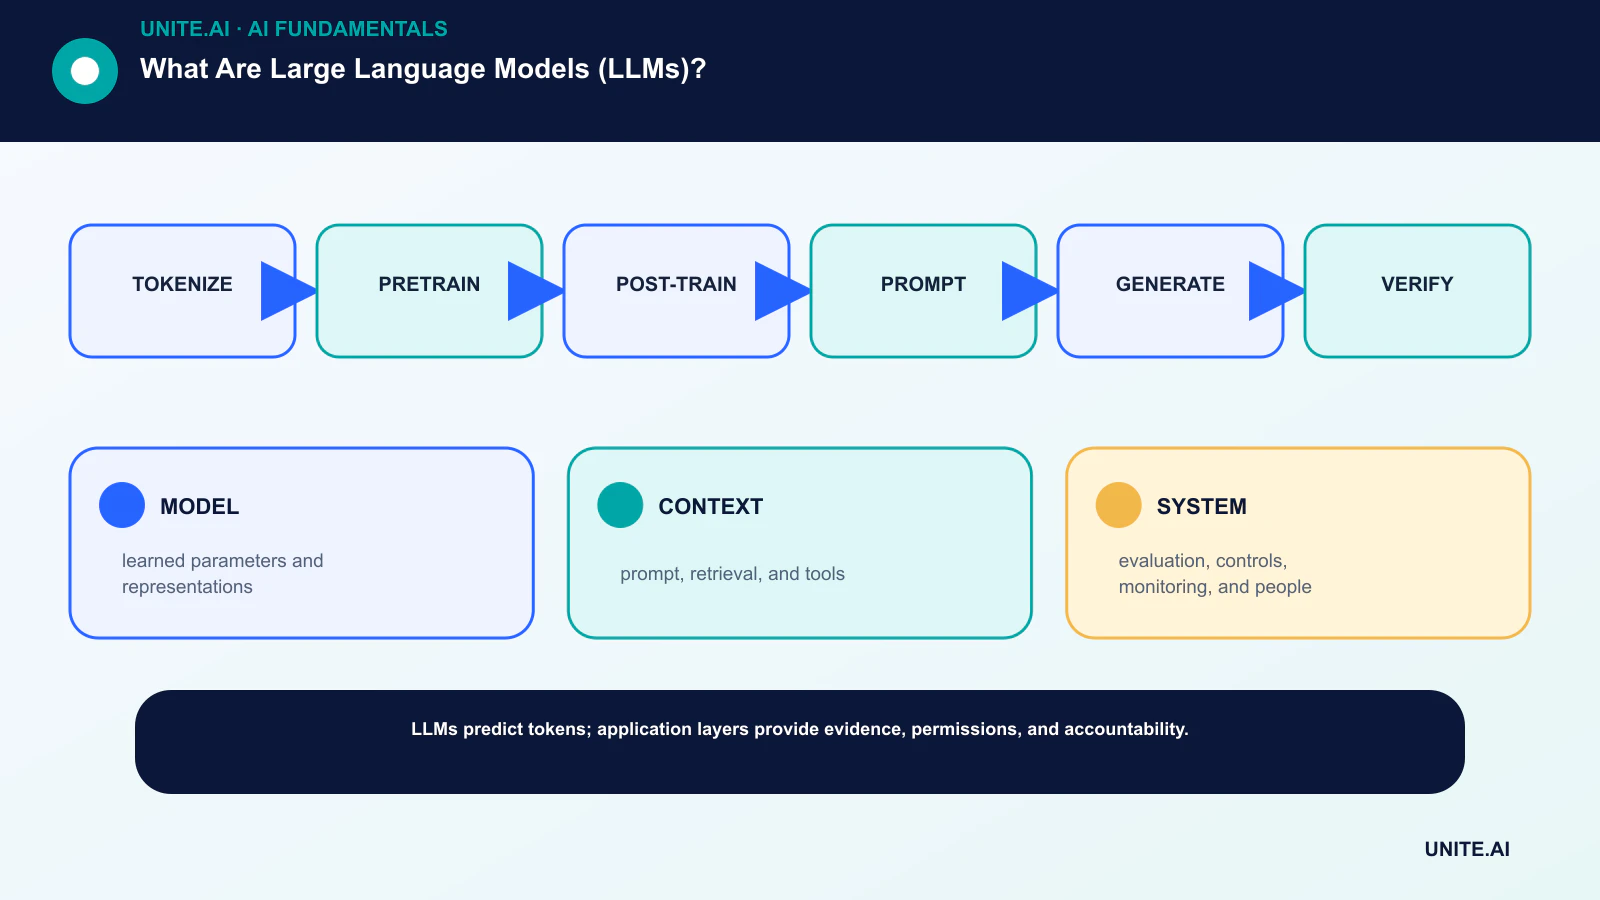
将概念转化为受限且可测试的工作流:分词 → 预训练 → 后训练 → 提示 → 生成 → 验证。指定负责的所有者,记录数据和依赖关系,建立简易基线,设定接受和停止标准,测试代表性失败,并在扩展范围前定义监控、回滚和审查。记录版本和假设,以便其他团队复现结果并了解变更情况。
在发布前,进行有文档记录的就绪评审,邀请构建、运营、保障以及受系统影响的人员参与。测试正常情况、边界条件、依赖失效和误用;保留证据和未解决的风险。明确谁可以批准发布、调整阈值、覆盖输出或停止运行。实际数据到来后重新审视决策,因为技术上成功的试点并不保证在更大规模下的可靠性能。
- MODEL: 学习到的参数和表示。
- CONTEXT: 提示、检索和工具。
- SYSTEM: 评估、控制、监控和人员。
常见问题
为什么 LLM 被称为“大型”?
没有统一的参数阈值。‘大型’指相对于早期语言模型的规模,包括参数数量、训练数据、计算量以及使用范围。
LLM 能理解语言吗?
它们构建有用的内部表示并展示复杂行为,但‘理解’一词有多重含义。性能应通过逐任务演示,而不是从流畅性推断。
主要参考文献