
AI 基础
图像分类是如何工作的?

 将 Unite.AI 添加到您在 Google 上的首选来源
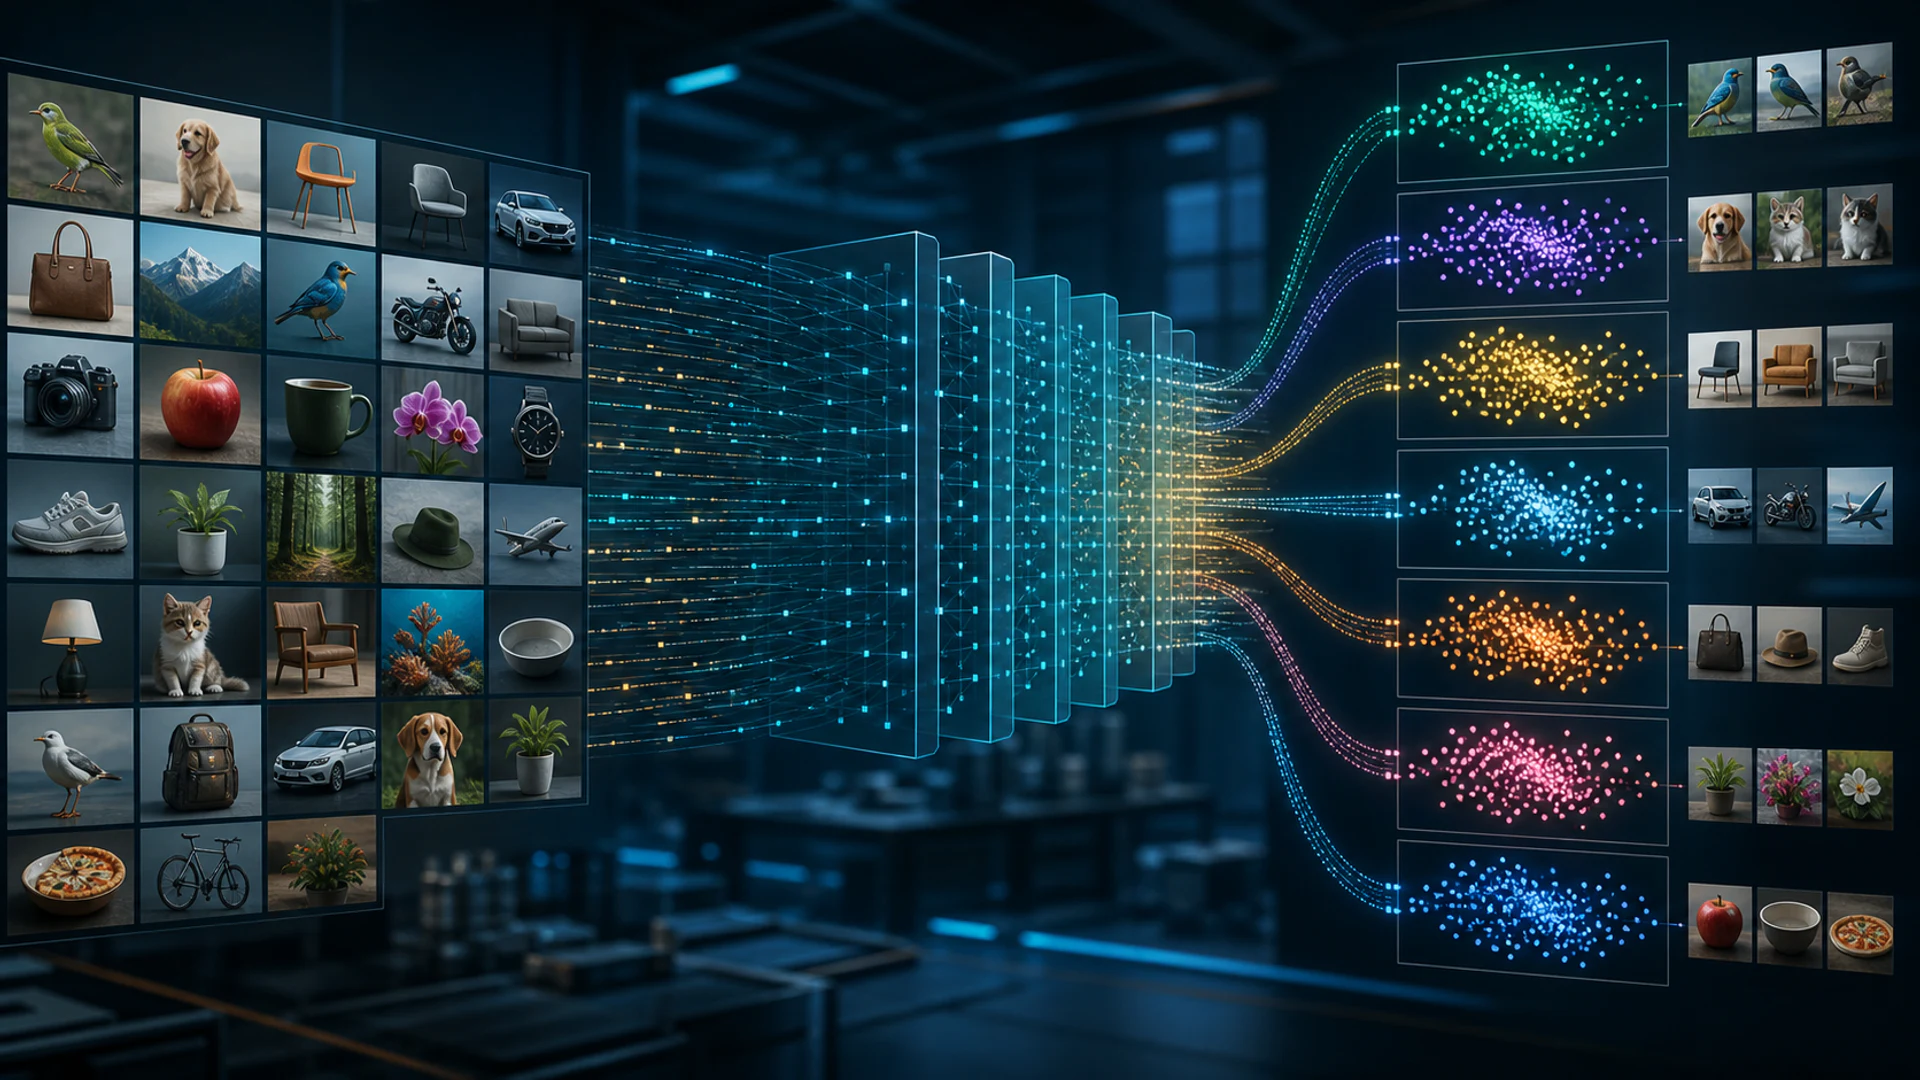
图像分类 为整张图像预测一个标签。它可以回答诸如“显示的是哪种产品类别?”或“此扫描是否包含目标发现?”之类的问题。它本身并不会定位每个对象或描绘其像素。
现代系统通常使用卷积神经网络或视觉转换器,并常常以预训练权重进行初始化。可靠的性能仍然依赖于标签、抽样、数据增强、校准以及在真实部署条件下的测试。
关键要点
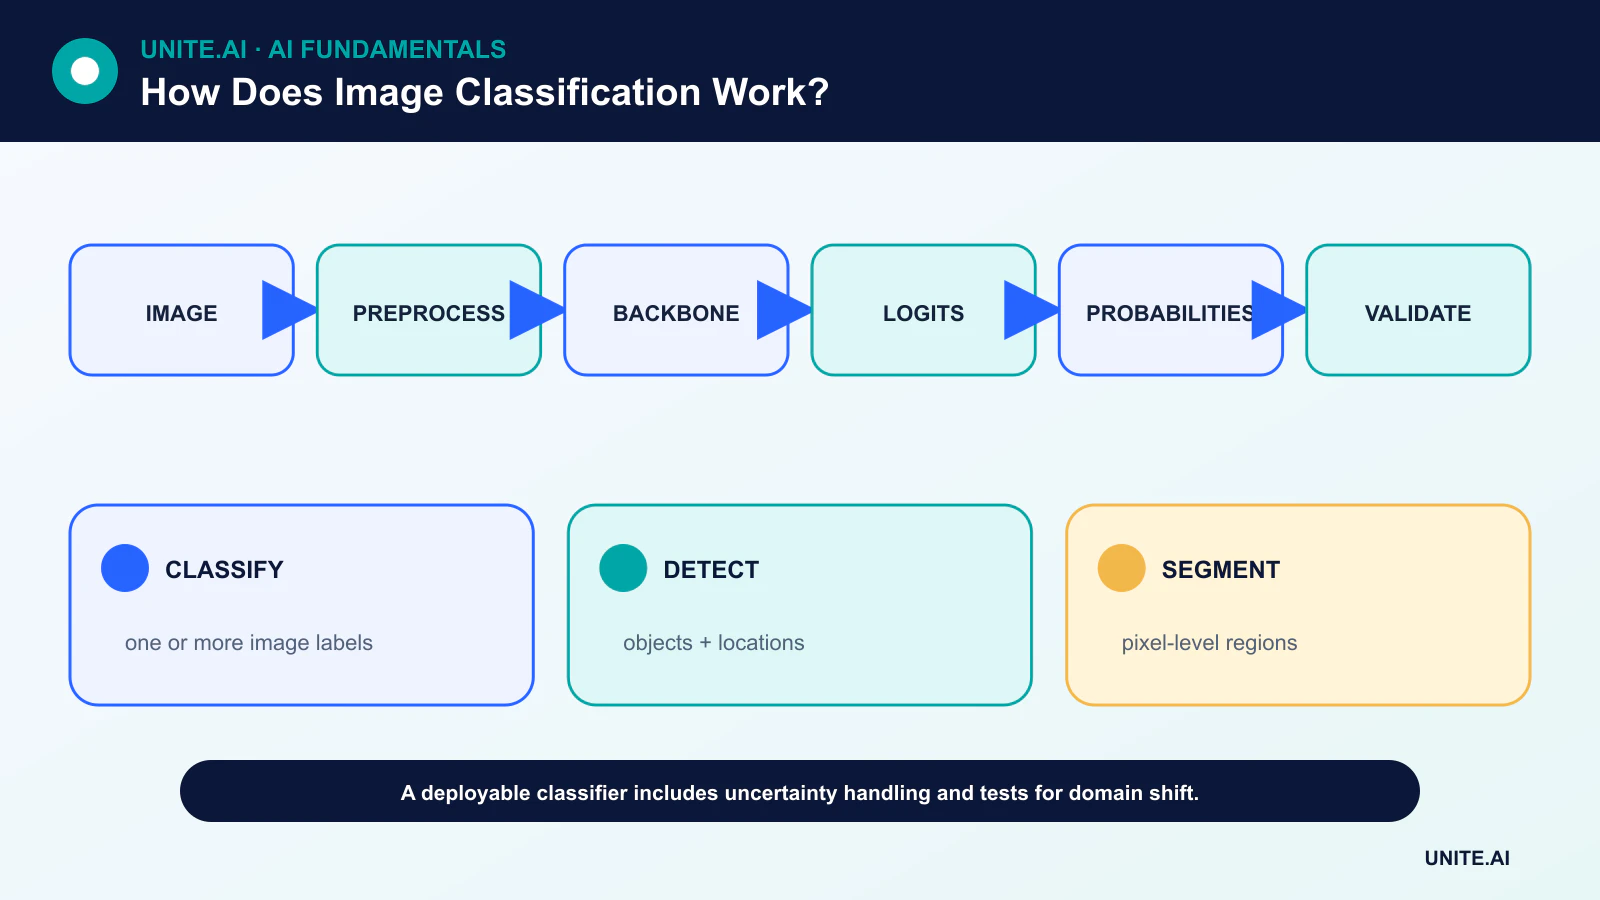
- 分类为整张图像标记标签;检测绘制对象框,分割则分配像素级区域。
- 预训练和迁移学习可以降低数据需求,但领域不匹配可能抵消其优势。
- 总体准确率可能掩盖类别不平衡、虚假捷径以及校准不足。
- 图像质量、采集设备、地理位置和工作流的变化都可能导致分布漂移。
从像素到分数
图像会被调整大小或裁剪、归一化并转换为张量。数据增强可能会应用保持标签不变的变换,如翻转、裁剪或颜色变化。主干网络将像素映射为特征;分类头产生对数值(logits),随后转换为相对类别分数。
所选的预处理必须与部署相匹配。中心裁剪若去除相关对象,或归一化不匹配,都可能在权重保持不变的情况下损害性能。
卷积神经网络与视觉转换器
卷积神经网络 使用局部滤波器和共享权重来构建空间特征。残差连接使得非常深的 CNN 更易于优化。视觉转换器将图像划分为若干块,并使用注意力来建模它们之间的关系。
在进行架构比较时应控制训练数据、数据增强、计算资源和分辨率等因素。公共基准上表现最好的模型未必最适合边缘设备、小规模数据集或可解释性需求。
迁移学习与数据设计
迁移学习 从在更大源数据集上训练的权重开始。团队可以冻结主干网络、微调后期层或更新整个模型。微调通常需要较低的学习率以及防泄漏的验证集。
标签应描述可直接从图像中推断的内容。如果诊断依赖于图像中未呈现的患者历史信息,分类器无法学习完整的临床决策。重复图像、同一视频的帧以及同一受试者的图像必须位于同一划分中。
指标、 不确定性 与捷径
Top-1 准确率要求得分最高的类别正确;Top-k 准确率则接受正确类别位于前 k 高分之列。每类的精确率、召回率以及混淆矩阵能够揭示不均衡的错误。
模型可能利用背景、水印、采集设备或取景方式,而非目标对象本身。反事实测试、子群分析和显著性工具可以帮助发现捷径,但解释热图并不等同于因果推理的证据。
部署监控
生产环境的检查应覆盖损坏的文件、异常尺寸、模糊、光照、相机型号以及新类别。置信度应在接近部署的数据上进行校准,超出范围的输入应被拒绝或人工审查。
监控标签延迟以及错误成本的变化至关重要。即使模型在输入统计上看似稳定,一旦像素与标签之间的关系改变,也可能出现失效。
构建图像分类数据集
图像分类为整张图像分配一个或多个标签。它不同于检测(定位对象)和分割(为像素标记)。需要定义类别范围、层次结构、多标签规则、背景或未知类别,以及必须可见的证据。收集能够代表部署场景的相机、地点、光照、视角、距离和主体。 在数据增强之前按主体、场景、会话或来源进行划分;相邻视频帧或跨划分的重复产品图像会导致严重泄漏。
标注指南应涵盖遮挡、模糊对象、多类别、低质量以及放弃标注的情况。测量标注一致性并审查系统性分歧。仅有类别平衡并不能保证覆盖范围: 某疾病类别可能只包含一种设备,或某野生动物类别仅对应一种背景。检查元数据和近似重复图像,并保留来自独立采集的受保护测试集。合成数据和网络爬取可以扩展多样性,但会带来授权、来源、风格和标签问题,这些必须在真实图像上进行评估。
模型、训练与评估
传统方法将工程特征描述子与分类器结合;现代系统则使用卷积网络或视觉转换器,通常通过迁移学习实现。尺寸调整和裁剪的选择决定了哪些信息得以保留。数据增强应反映合理的变化并保持标签不变。优化与任务相匹配的损失函数,谨慎通过加权或采样处理不平衡,并在验证数据上选择检查点。与简单基线进行比较,并对数据增强、分辨率和预训练初始化进行消融实验,以了解收益来源。
报告每类的精确率、召回率、F1、混淆矩阵、在相关情况下的 Top‑k 准确率、校准情况以及按条件划分的性能。测试模糊、压缩、光照、裁剪、遮挡、设备以及不属于任何支持类别的输入。置信阈值可将不确定案例转交审查;softmax 概率并不等同于置信度,尤其在分布漂移时。反事实背景和遮挡测试能够揭示捷径学习。针对安全相关的使用,需要评估最坏情况的失效以及假阳性和假阴性的后果。
部署与监控
将解码、颜色转换、方向校正、归一化、模型和标签映射打包在一起。 在目标设备上验证导出或量化后的产物,并测量端到端延迟、内存、功耗和吞吐量。监控图像质量、输入输出分布、校准情况、已确认的标签以及传感器健康状态。尽量减少并确保图像保存的安全,尤其是人脸、位置和旁观者的图像。为损坏或超出范围的输入提供回退方案,并能够回滚模型版本。分类回答的是预定义的图像级问题;不应将其强行用于不支持的定位、身份或意图声明。
实际案例:可回收材料分类
某设施对传送带上的物品进行拍摄,并标注材料类别、污染程度以及未知情况。图像按采集日期和物体批次划分,涵盖光照、潮湿表面、皱折、重叠和空输送带等情形。将小型 CNN 与预训练模型以及基于颜色和形状的规则进行比较。每类召回率、误分率、校准情况、吞吐量以及按相机和材料状态的结果用于指导模型选择。
生产流水线会验证相机曝光和输送带时序,然后将不确定的物品发送至通用流,而不是强行分类。量化推理在对应硬件上进行验证。监控记录输入质量、各类比例、拒绝率以及抽样人工审计;新包装出现时会触发数据审查更新。模型控制带有物理防护的限位分拣器,传感器或模型失效时会将机构恢复到安全状态,而不是悄然误导材料流向。
实施证据与运营准备
生产决策需要的不仅是成功的演示。需明确预期用户、运行环境、输入、输出、依赖关系、负责人以及每类重要失效的后果。在调优前建立可复现的基线和带版本号的评估集。测试常规案例、边界条件、畸形或缺失的输入、分布漂移、依赖中断、误用以及最可能被服务不足的群体或环境。将任务质量与校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全性一起衡量。记录每一次转换和阈值,以便独立审阅者能够复现结果,并将证据与吸引人的原型区分开来。
在上线前,指定发布、例外、变更、回滚和退役的责任人。采用分阶段发布,保留安全回退机制,并通过有意注入的故障验证监控。运营遥测应揭示输入质量、输出行为、模型或规则版本、依赖健康状况、人为覆盖以及已确认的结果,同时避免收集不必要的敏感数据。设定警报阈值和响应负责人,然后在部署后审查真实世界的证据,而非假设离线性能会持续。每当数据来源、用户、模型、供应商、政策、硬件或目标发生变化时都需重新评估。维护中的系统还需有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时点。
常见问题
图像分类器能识别多个对象吗?
多标签分类器可以指出存在哪些类别,但不会定位各个实例。若需框选或计数,需要使用目标检测。
为什么模型会在对人类看起来正常的照片上失效?
模型可能依赖于已改变的拍摄伪影、纹理或相关性。细微的预处理差异以及领域漂移也会影响已学习的特征。
主要参考文献












