
AI 基础
生成式 vs 判别式机器学习模型

 将 Unite.AI 添加到您在 Google 上的首选来源
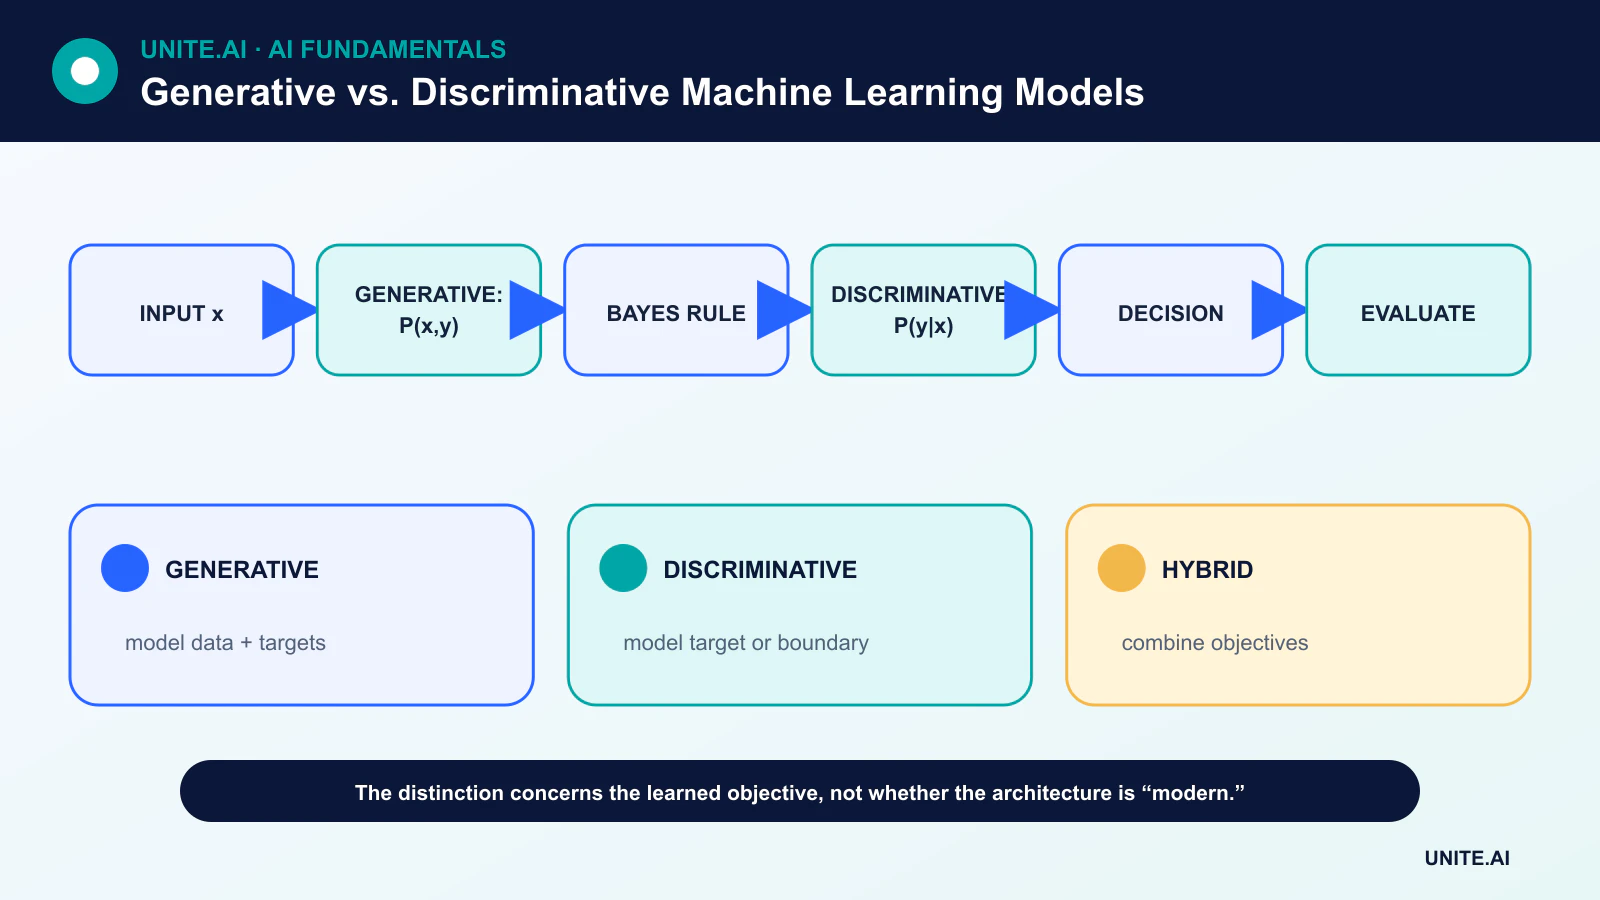
生成式和判别式描述模型对数据和目标的学习内容。在经典的监督分类中,生成式模型学习联合分布,例如 P(x, y) 或类别条件分布 P(x|y),而判别式模型学习 P(y|x) 或直接的决策边界。
这种区分很有用,但现代系统常常结合两种目标。模型可以先学习生成式表征,然后再微调用于判别式预测,或在生成与分类之间共享同一主干网络。
关键要点
- 生成式分类器对输入和标签的生成过程建模;判别式分类器对给定输入的标签或决策边界进行建模。
- 生成式假设在标记数据稀缺时可能有帮助,但也可能不准确。
- 判别式方法通常将模型容量集中在预测任务上,可能实现更低的渐近分类误差。
- GAN、VAE 和语言模型是生成式系统,但“生成式”并不意味着每个组件都是生成式分类器。
概率分解
生成式分类器可以估计 P(x|y) 和 P(y),随后利用贝叶斯定理推导出 P(y|x)。朴素贝叶斯是经典案例。判别式分类器如逻辑回归直接估计 P(y|x);支持向量机则学习分离边界。
对 P(x,y) 进行建模的任务范围比仅从 x 预测 y 更广。额外的结构可以支持采样或缺失数据推理,但也需要对输入分布作出假设。
数据效率与渐近行为
Ng 与 Jordan 对朴素贝叶斯和逻辑回归的比较展示了一个有用的权衡:在其假设下,生成式模型可以用更少的样本接近其极限性能,而判别式模型则能够达到更低的渐近误差。
这并非普遍的排名。结果取决于模型族是否适配数据、特征维度、正则化、优化方式以及标签质量。对具有代表性的验证设计进行实证比较仍然至关重要。
代表性模型族
生成式模型包括类别条件分布、隐马尔可夫模型、混合模型、变分自编码器、自动回归语言模型、扩散模型以及 GAN。
判别式模型包括逻辑回归、决策树、条件随机场、支持向量机以及神经分类器。相同的神经网络主干可以根据训练目标和输出属于任一类别。
混合与自监督系统
预训练的语言或视觉模型可以通过生成式或自监督目标从未标记数据中学习,然后在目标任务上接入判别式头部。半监督方法可能同时优化有标签的分类目标和未标记数据的目标。
混合化使得仅凭架构标签难以完整描述模型,文档应明确说明目标、数据、输出以及预期的推理方式,而不是仅仅称模型为生成式。
在不同方法之间的选择
应依据具体任务进行选择。如果目标是拥有充足标签的校准边界,判别式模型是自然的基线;如果采样、密度估计、缺失数据结构或未标记数据是核心,则生成式组件可能有帮助。
应根据需要比较鲁棒性、样本效率、计算成本、似然或校准等指标。高质量的生成样本并不证明分类器优秀,且高准确率的分类器也不意味着对输入分布的真实建模。
概率方向与建模目标
判别式模型学习边界或条件分布 P(y|x):给定特征 x,预测标签 y。逻辑回归、支持向量机、条件随机场以及众多分类器都是判别式的。生成式模型学习联合分布 P(x,y)、类别条件分布 P(x|y) 或无条件数据分布,从而支持采样或与似然相关的任务。朴素贝叶斯和线性判别分析属于生成式分类器;GAN、变分自编码器、扩散模型以及自动回归模型则通过不同的目标生成数据。
此区分关注的是建模的分布或决策规则,而非是否使用神经网络。生成式语言模型可以通过提示进行分类,而判别式重排序器可以引导生成。生成式假设可能提升数据效率或处理缺失变量,但也会带来模型误设的风险。判别式方法在标记数据充足时常表现出色,因为它们直接聚焦于预测边界。比较模型族时应在特征、数据、调参和计算资源相同的前提下进行,而不是将某一类别视为普遍更优。
按使用场景的训练与评估
分类评估使用精确率、召回率、校准、鲁棒性和错误代价。生成式评估则需关注保真度、多样性、覆盖率、似然或任务效用、记忆性以及安全性。模型可能生成诱人的样本却遗漏模式,或在似然上表现良好却缺乏感知质量。合成数据的效用应通过在独立真实数据上训练并评估下游模型来检验,包括对稀有群体的表现。生成提示和选择时应排除测试数据。
在半监督学习中,生成式模型可利用未标记数据的结构;在异常检测中,若分布外数据因无关原因获得高密度,似然评估可能失效。检索增强生成中,生成式答案模型与判别式检索器或重排序器构成混合系统。应对各阶段单独诊断,防止流畅输出掩盖检索失效。选择能够让证据与控制可观测的拆解方式。
部署与治理
生成式系统带来内容来源、知识产权、冒充、提示注入以及输出审查等风险;判别式系统则增加阈值、拒绝和不平等错误风险。两者都需要数据使用权、安全构件、版本管理、代表性测试、监控以及与后果相称的人为授权。文档中应记录精确的目标和输出语义。生成式与判别式是有用的统计区分,但实际系统常常将两者结合,可靠性取决于完整的数据与决策流水线。
案例示例:分类与生成支持回复
某客服平台使用判别式分类器识别问题类型和紧急程度,并使用生成式模型根据已批准的政策草拟回复。分类器通过类别特定召回率和校准进行评估;检索器通过证据召回评估;生成器通过落地性、正确性和拒绝率评估。每个阶段的结果均不可预知,生成式模型无法通过说服性文本改变分类结果或客户权益。
坐席在发送前可查看预测的路由、来源以及草稿,并进行批准或修正。检索前会应用权限过滤,客户文本中的提示注入无法授权工具。监控将路由错误、检索缺口、不支持的陈述和坐席编辑区分开来。政策变更会立即更新来源并触发回归测试;调参仅在行为稳定时进行。该混合设计利用判别式和生成式的优势,同时保留证据和人工授权。
实施证据与运营准备
生产决策需要的不仅是一次成功演示。应明确预期用户、运行环境、输入、输出、依赖、负责人以及每类关键失效的后果。调参前建立可复现的基线和版本化的评估集。测试常规案例、边界条件、格式错误或缺失的输入、分布漂移、依赖中断、误用以及最可能被忽视的群体或环境。衡量任务质量时同步评估校准或不确定性、延迟、吞吐量、资源成本、可访问性、隐私和安全性。记录每一次转换和阈值,以便独立审阅者复现结果并将证据与诱人的原型区分开来。
上线前,需指定发布、例外、变更、回滚和退役的授权人。采用分阶段发布,保留安全回退,并通过有意注入的故障验证监控。运营遥测应揭示输入质量、输出行为、模型或规则版本、依赖健康状况、人工干预以及已确认的结果,同时避免收集不必要的敏感数据。设定警报阈值和响应负责人,然后在部署后审查真实世界的证据,而非假设离线表现会持续。每当数据来源、用户、模型、供应商、政策、硬件或目标发生变化时都需重新评估。维护中的系统还需有文档化的恢复、事件学习、删除与保留流程,以及明确的停用或替换时点。
常见问题
GAN 的判别器是判别式模型吗?
它在训练期间执行判别任务,但整个 GAN 是一个生成式框架,其输出由生成器产生。
判别式学习总是监督学习吗?
不是。该术语描述的是被建模的关系或边界,而监督描述的是训练信号。现代目标可能模糊这两类的界限。
主要参考文献












