Anderson 视角
借助人工智能通过文字排版表达情感

 将 Unite.AI 添加到您在 Google 上的首选来源
要点语音调制排版将音高、时长和响度映射到基线偏移、字距调整和字体粗细上。
查看更多
- 语音调制排版将音高、时长和响度映射到基线偏移、字距调整和字体粗细上。
- 动态字幕的得分低于静态字幕,因为动态阅读会增加观看者的认知负荷。
- 由于认知负荷,静态调制文本的正确率为67%,而动态文本为63%。
当前的文本通信趋势和创新(包括电子邮件、消息和字幕系统)必须以粗糙和近似的方式协商书面和口头言语之间的情感差距。
例如,过去几年里,大小写字母交替成了社交媒体争论中的挑衅性迷因,而备受厌恶的全大写文字(以及某些评论平台允许的粗体等突兀的排版效果)仍不断引来版主干预。这些方法单一而粗略,只能大致表达书面文字的意图。
同时,情绪符号和表情符号作为混合文本/视觉情感传达器的受欢迎程度的增长,近年来已经积极吸引了自然语言处理(NLP)研究领域的注意力,另外还有用户在评论线程中发布的动画GIF的含义。
随着时间的推移,书面语言已经发展出了一系列“附加”的语言方法,试图要么代理情感,要么在没有口头语言的语调信息的情况下唤起情感。
通常,然而,我们需要从书面文字的上下文中尽可能准确地推断情感。考虑,例如,感叹‘哦,哦,哦!’,在麦克白夫人的疯狂夜间独白的结尾,这可能是语调影响意义的程度的案例研究。
在大多数改编中,这种痛苦的哀叹持续2-6秒;在1976年特雷弗·纳恩的皇家莎士比亚剧团的麦克白中,朱迪·丹奇以24.45秒的时间解读了这句话,这可能创造了至今无人超越的纪录,也是对这一角色的一次标志性演绎。
(YouTube自己的自动字幕系统将丹奇的嚎叫标为 [音乐])
将语调转换为字体
最近,巴西的一篇论文提出了一个语音调节字体系统的概念,该系统可以将韵律和其他副语言特征直接纳入字幕中,为书面文字添加了一个情感维度,这是通过在字幕中添加形容词(如[大声])或其他“平面”技巧无法捕捉到的。
‘我们提出了一个语音调节字体的新模型,其中语音的声学特征用于调节文本的视觉外观。这可以让一个特定语句的转录不仅代表所说的话,还代表说话的方式。 ‘
‘通过这种方式,我们希望揭示可以被普遍识别为振幅、音高和时长等韵律特征的视觉对应形式的字体参数。’

将语调转换为字体样式的工作流程。为了产生最通用和最广泛部署的系统,作者们仅限于基线偏移、字距和粗体,后者由OpenType字体的灵活性提供。来源:https://arxiv.org/pdf/2202.10631.pdf
这篇论文题为隐藏的哭泣、低语和尖叫:文本可以被赋予超越其文字的意义吗?的论文来自巴西坎皮纳斯州立大学的两位研究人员卡卢阿·德·拉塞尔达·帕塔卡和保拉·多恩霍费尔·帕罗·科斯塔。
粗体文字
虽然该项目的更广泛目标是开发能够在字幕中传达语调和其他副语言特征的系统,但作者们也相信这种系统最终可以在听力世界中发展出更广泛的受众。
在这个领域,有很多先前的计划,包括1983年的一个项目,该项目提出了一个字幕系统,该系统可能包括‘特殊效果、颜色和大写字母,[用于表达]聋童无法获得的丰富语调信息。’
相比之下,巴西项目能够利用自动转录和情感识别的新发展,这些结合起来使得可以导入和特征化语音音轨的组成部分的工作流程成为可能。
提取和处理语调特征后,将它们映射到语音中的单词时间戳,生成可以用于应用基于规则的字幕字体调制的令牌(见上图)。
这可以视觉地代表一个特定的音节可能被延长、低声说出、强调或以其他方式持有上下文信息,这些信息将在原始转录中丢失。

从项目的测试阶段来看,字距(单词中字母之间的空间)已经被扩大以反映延长的发音。
作者们明确表示,他们的工作并不是直接为情绪与情感状态识别研究做出贡献,而是试图对语音特征进行分类,并用简单和有限的新视觉惯例来表示它们。
至少,这个系统提供的额外强调消除了句子中动作对象可能不明确的歧义,尤其是对于那些无法听到声音的观众(无论是由于残疾还是播放环境,如嘈杂的环境)。
为了引用我自己2017年的例子,该例子研究了机器学习系统如何难以理解句子中动作和对象的位置,可以看出强调如何极大地改变甚至一个简单句子的含义:
我 没有偷那件东西。(别人偷了它)
我 没有 偷那件东西,(我否认我偷了它)
我没有 偷那件东西。(我拥有它,盗窃不适用)
我没有偷 那件东西。(但我偷了别的东西)
可能,巴西作者提出的这种机械语调转字体工作流程也可以作为情感计算研究数据集开发的辅助工具,因为它可以处理纯文本数据,这些数据中已经包含了一些预先推断的副语言维度。
此外,研究人员指出,具有语调感知文本的额外语言有效载荷可以在一系列基于NLP的任务中发挥作用,包括客户满意度评估和从文本内容中推断抑郁症。
弹性字体
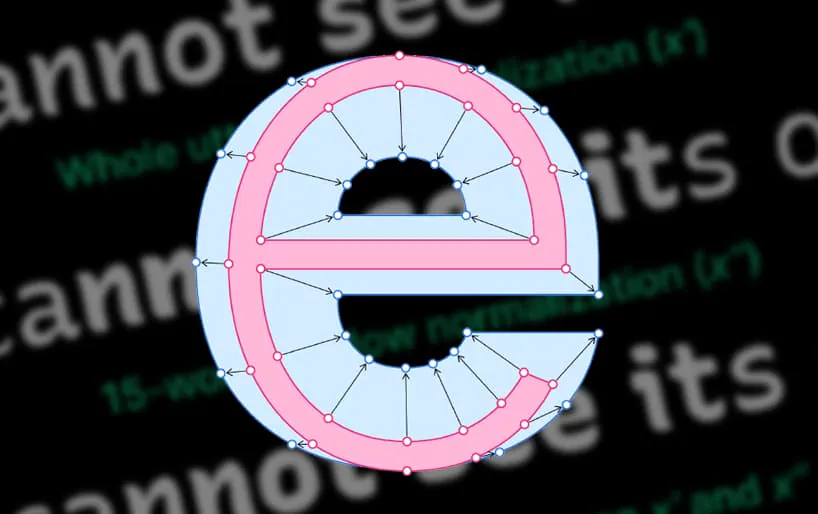
研究人员开发的框架提供了基线偏移的变化,在那里一个字母可能相对于句子所在的基线更高或更低;字距,在那里一个单词的字母之间的空间可能被收缩或扩张;以及字重(粗细)。
这三个样式映射到项目所约束的语音提取特征:分别为音调、时长和幅度。

句子的样式进展。在#1中,我们看到定义的音节边界。在#2中,我们看到每个调制(振幅|字重、字距|时长和音调|基线偏移)的表示,单独应用。在#3中,我们看到最终输出中组合的字体调制,如呈现给117名参与者试验的那样。
由于单个字体可能需要为粗体和斜体等变体提供额外的单独字体,研究人员使用了谷歌的实现的OpenType字体Inter,它将一系列可精细调节的字重集成到一个字体中。

从论文中,一个图表详细说明了Inter字体的OpenType字形可以沿着最简基础样条曲线的骨架呈现不同程度的粗体强调的程度。
测试
字距和基线偏移的表达被集成到一个浏览器插件中,允许对117名具有听力能力的参与者进行测试。
测试数据集是为该项目专门创建的,通过雇佣一位演员多次以不同的强调朗读一系列诗歌,每次对应于项目正在研究的三个特征。选择诗歌是因为它允许在不听起来人为的情况下有多种强调(甚至超出了诗人的意图)。
参与者被分成两组。第一组在15轮中收到了演员朗读诗句的同步、动画和调制文本,随着音频片段的播放而展开。
第二组收到了相同的一套任务,但他们收到的调制文本是静态图像,在音频片段播放期间没有变化。
正确答案的平均比例为:静态图像组达到非随机水平的67%,动态文本组的63%。研究人员在试验后征求的参与者评论证实了他们的理论,即动态解释的认知负担可能导致了非静态测试的较低分数。然而,字幕和消息系统通常提供默认的已完成文本。
参与者评论还表明,使用字距来表示时长存在硬性限制,一位评论者指出,当字母之间的距离太远时,很难识别单词。
研究人员还指出:
‘[一些]参与者觉得模型应该能够体现更细致和复杂的语音表示,它应该做到这一点,使用更丰富和更富有表现力的视觉词汇。虽然这不是一个简单的任务,但想象不同语音调节字体应用如何随着这一新领域的发展而分支出来还是很有启发性的。’
首次发表于2022年2月24日。