
Anderson 视角
一致的 AI 视频内容编辑与文本引导输入

 将 Unite.AI 添加到您在 Google 上的首选来源
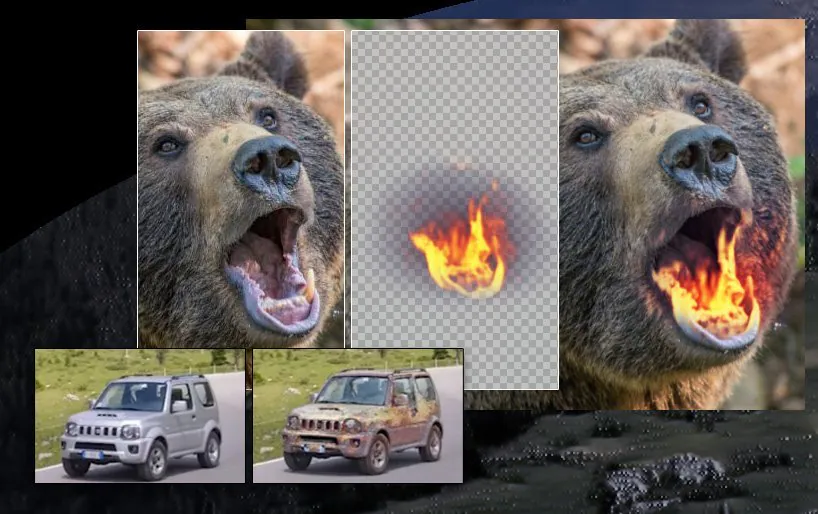
要点Text2Live能够根据文本提示实现一致的视频编辑,无需逐帧处理。
查看更多
- Text2Live能够根据文本提示实现一致的视频编辑,无需逐帧处理。
- 该系统利用神经分层图集,只需一次编辑即可应用于整个视频时间线。
- Text2Live自动完成遮罩和合成,省去了转描或绿幕的需求。
虽然专业的 VFX 社区对新兴的图像和视频合成技术感到着迷,并且偶尔会感到有点威胁,但大多数基于 AI 的视频编辑项目缺乏时间连续性,这使得它们局限于“迷幻”领域,伴随着闪烁且快速变化的纹理和结构、不一致的效果,以及让人想起视觉效果光化学时代的粗糙技术操作。
如果您想改变视频中非常具体的内容,而不是深度伪造(即,将新身份强加于现有的人物镜头),大多数当前的解决方案都受到严重的限制,尤其是在需要生产级别的视觉效果的精度方面。
一个例外是威兹曼科学研究所一个松散学术合作团队正在推进的工作。2021 年,其中三位研究人员与 Adobe 合作,公布了一种分解视频的新方法,将一致的内部映射——分层神经图集——叠加到合成输出中,并提供 alpha 通道和时间连贯的结果。
(ADBE )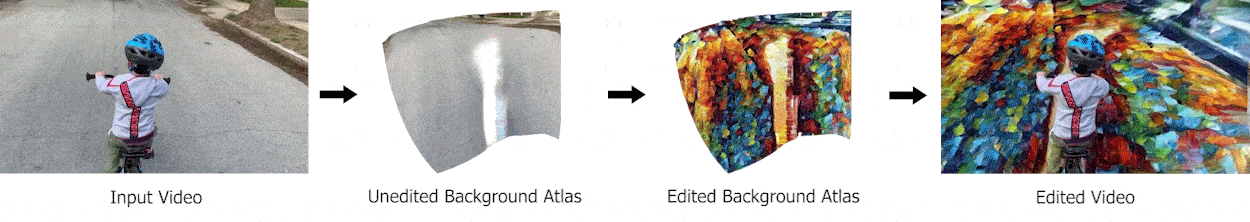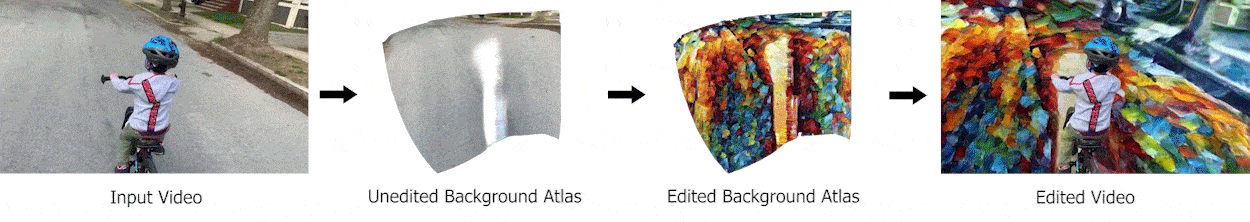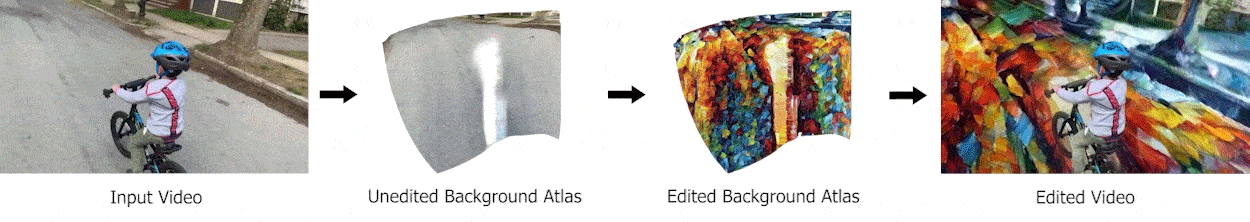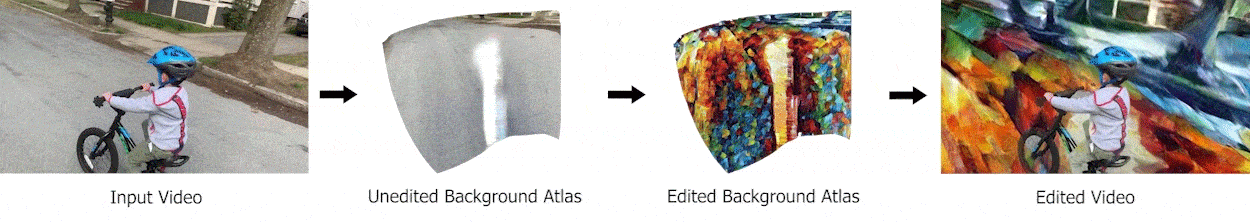
来自 2021 年论文:源片段中的道路的完整遍历估计通过神经网络编辑,传统上需要大量转描和运动匹配。由于背景和前景元素由不同的网络处理,掩码是真正的“自动”生成的。来源:https://layered-neural-atlases.github.io/
虽然它与 VFX 流程中光流所覆盖的领域有一定重叠,但分层图集在传统 CGI 工作流中没有直接对应物,因为它本质上是可以用传统软件方法生成和编辑的“时间纹理图”。上方插图的第二幅图,将路面背景象征性地表示为贯穿整个视频时段的图像。改变这幅基础图像,即插图中从左数第三幅图,会使背景产生一致的变化。
上述图中的“展开”地图仅代表个别解释帧;在任何目标视频帧中的一致变化都映射回原始帧,保留任何必要的遮挡和其他必要的场景效果,例如阴影或反射。
核心架构使用多层感知器(MLP)来表示展开的地图、alpha 通道和映射,这些表示在完全二维的空间中共同优化,不需要 NeRF 风格的 3D 几何点、深度图和类似的 CGI 风格的附加物。
可以可靠地改变个别对象的参考地图:
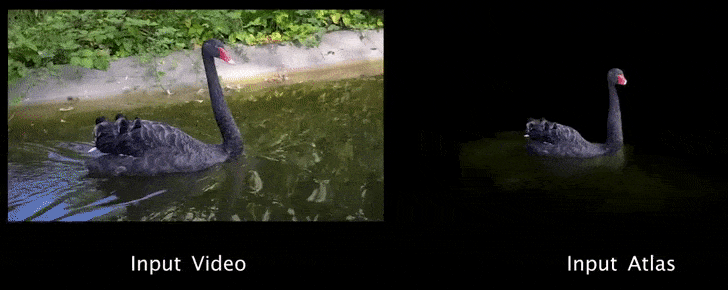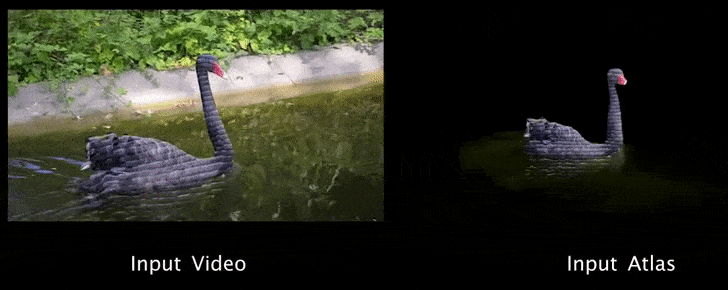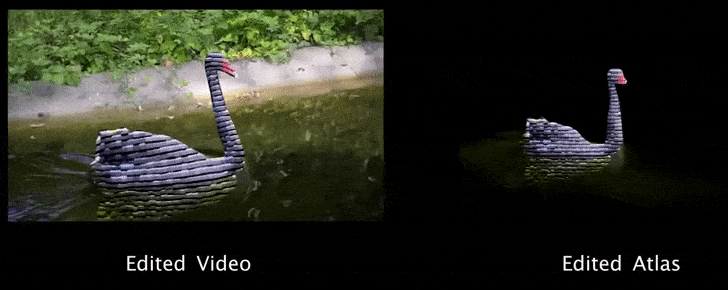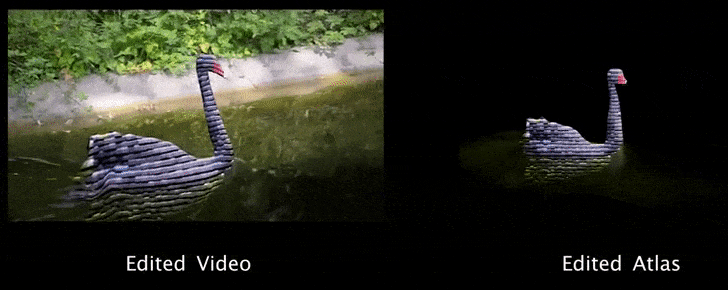
在 2021 年框架下移动对象的一致变化。来源:https://www.youtube.com/watch?v=aQhakPFC4oQ
基本上,2021 年的系统将几何对齐、匹配移动、映射、重新纹理和转描合并为一个离散的神经过程。
Text2Live
2021 年论文的三位原始研究人员与 NVIDIA (NVDA ) 研究人员一起,为该技术开发了一种新的创新方法,结合了分层地图的力量和文本引导的 CLIP 技术,这种技术本周因 OpenAI 发布 DALL-E 2 框架而再次受到关注。
新的架构,称为 Text2Live,允许最终用户根据文本提示创建对实际视频内容的局部编辑:
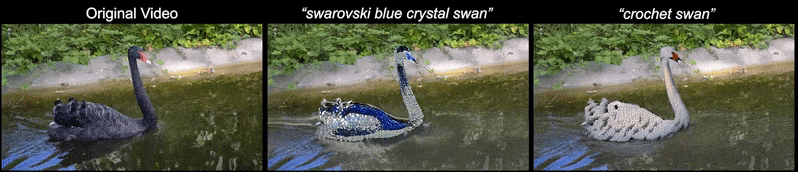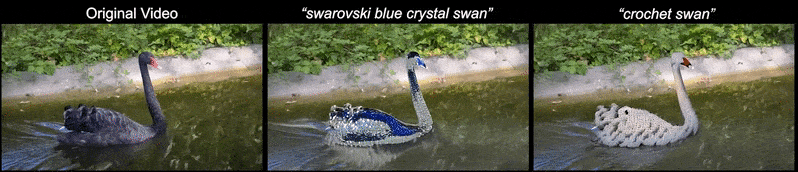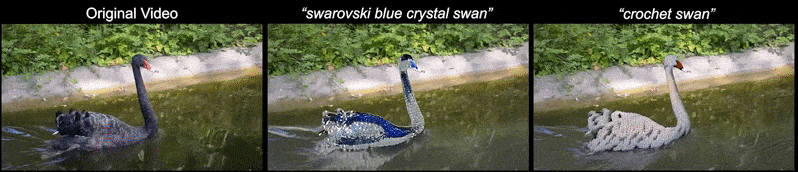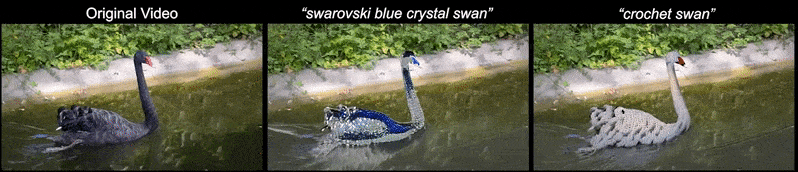
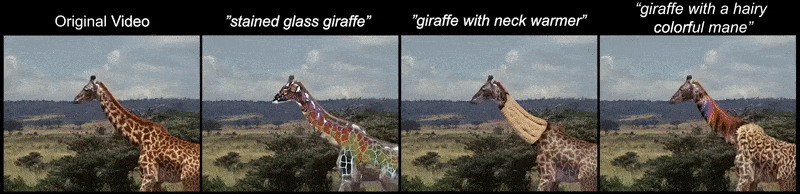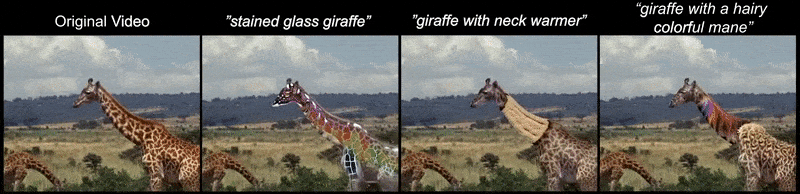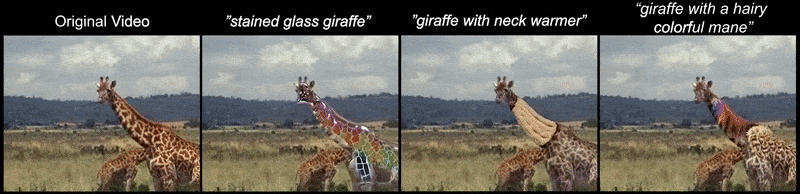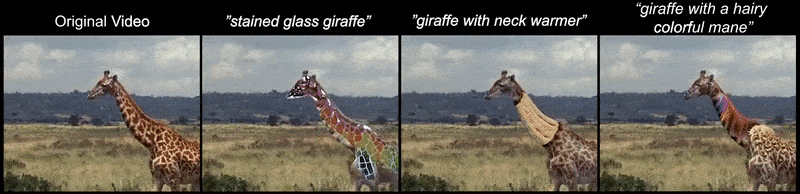
前景编辑的两个示例。为了获得更好的分辨率和清晰度,请查看原始视频:https://text2live.github.io/sm/pages/video_results_atlases.html
Text2Live 提供语义和高局部编辑,而无需预训练生成器,通过使用特定于正在编辑的视频片段的内部数据库来实现这一点。

Text2Live 下的背景和前景(对象)变换。来源:https://text2live.github.io/sm/pages/video_results_atlases.html
该技术不需要用户像传统转描或绿幕工作流那样提供蒙版,而是通过自举技术估计相关性图。这项技术基于特拉维夫大学计算机科学学院和 Facebook AI Research(FAIR)的2021 年研究。

通过基于转换器的通用注意力模型生成的输出地图。
新论文的标题是 Text2LIVE:基于文本的分层图像和视频编辑。威兹曼科学研究所的 Omer Bar-Tal 和 NVIDIA Research 的 Yoni Kasten 加入了原来的 2021 年团队。
架构
Text2Live 由一个接受单个输入图像和目标文本提示的生成器组成。一个在 4 亿个文本/图像对上预训练的对比语言–图像预训练(CLIP)模型提供了相关的视觉材料,可以从中解释用户输入的变换。

生成器接受一个输入图像(帧)并输出一个目标 RGBA 层,包含颜色和不透明度信息。然后将该层合成到原始镜头中,并进行额外的增强。

生成的 RGBA 层中的 alpha 通道提供了一个内部合成函数,而无需传统的涉及像素级软件(如 After Effects)的管道。
通过在与目标视频或图像相关的内部图像上训练,Text2Live 避免了两类需求:一是将输入图像反演到生成对抗网络(GAN)的潜在空间,而这种做法目前远未达到生产级视频编辑所需的精度;二是使用更精确、更可配置的扩散模型,但扩散模型无法保持对目标视频的忠实度。

Text2Live 的基于提示的变换编辑。
以前的方法使用基于传播的方法,或基于光流的方法。由于这些技术在某种程度上都是基于帧的,因此都无法创建输出视频中变化的一致时间外观。相比之下,神经分层地图提供了一个单一的空间来处理变化,这些变化可以保持对提交的变化的忠实度,当视频进展时。
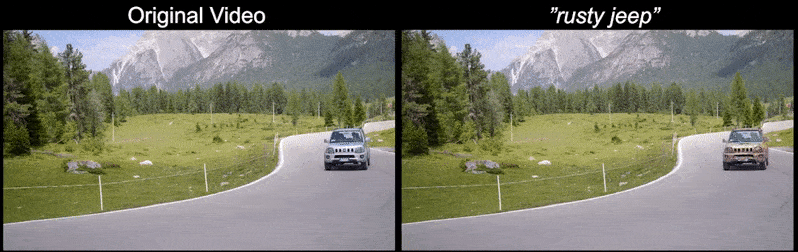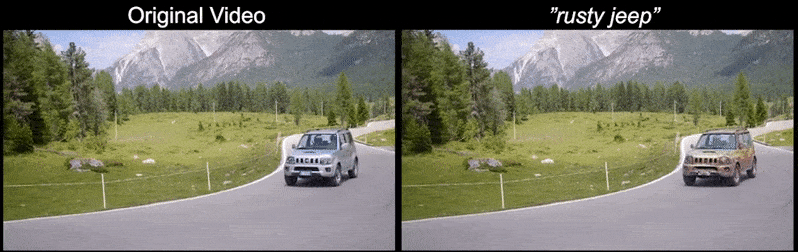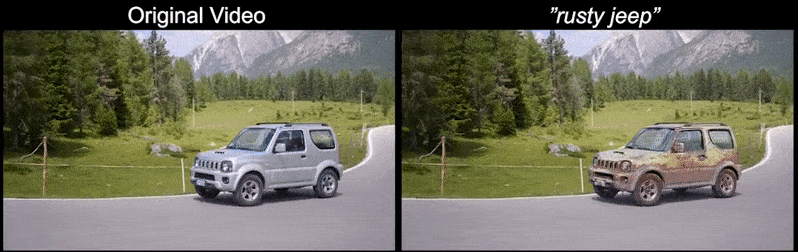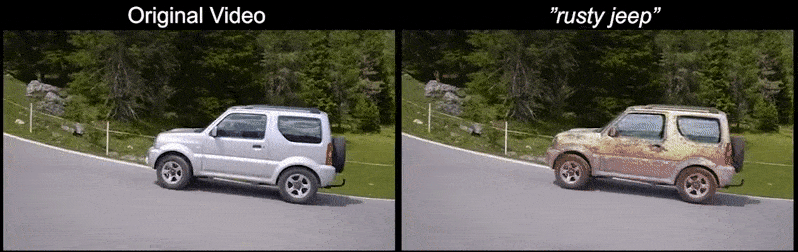
没有“闪烁”或随机的幻觉:Text2Live 解释文本提示“生锈的吉普”,并将其应用于视频中的汽车的神经分层地图,而不是为每个解释帧重新开始变换。

Text2Live 将吉普车变成生锈遗物的变换工作流。
Text2Live 更接近于在 AI 合成方面取得突破,而不是在蓬勃发展的文本生成图像领域取得突破。后者因本周 OpenAI 发布 DALL-E 框架的第二代版本而受到广泛关注。该框架可将目标图像纳入变换过程,但直接修改照片的能力仍有限,此外还有为防止用户滥用而设置的源训练数据审查和过滤措施。
相比之下,Text2Live 允许最终用户提取图集,然后在 Photoshop 这样控制程度很高的像素级环境中一次性编辑它,甚至可以说也能在 NeRF 等更抽象的图像合成框架中编辑,随后再将图集送回方向正确的环境,而无须依赖 3D 估计或回归旧有方式的 CGI 方法。
此外,Text2Live 的作者声称,这是第一个在完全自动化的方式下实现蒙版和合成的可比框架。
首次发布于 2022 年 4 月 7 日。





