
AI 模型与平台
ASUS 在 OCP 推出搭载双 NVIDIA Vera CPU 的 XA P2N-E2 服务器

 将 Unite.AI 添加到您在 Google 上的首选来源
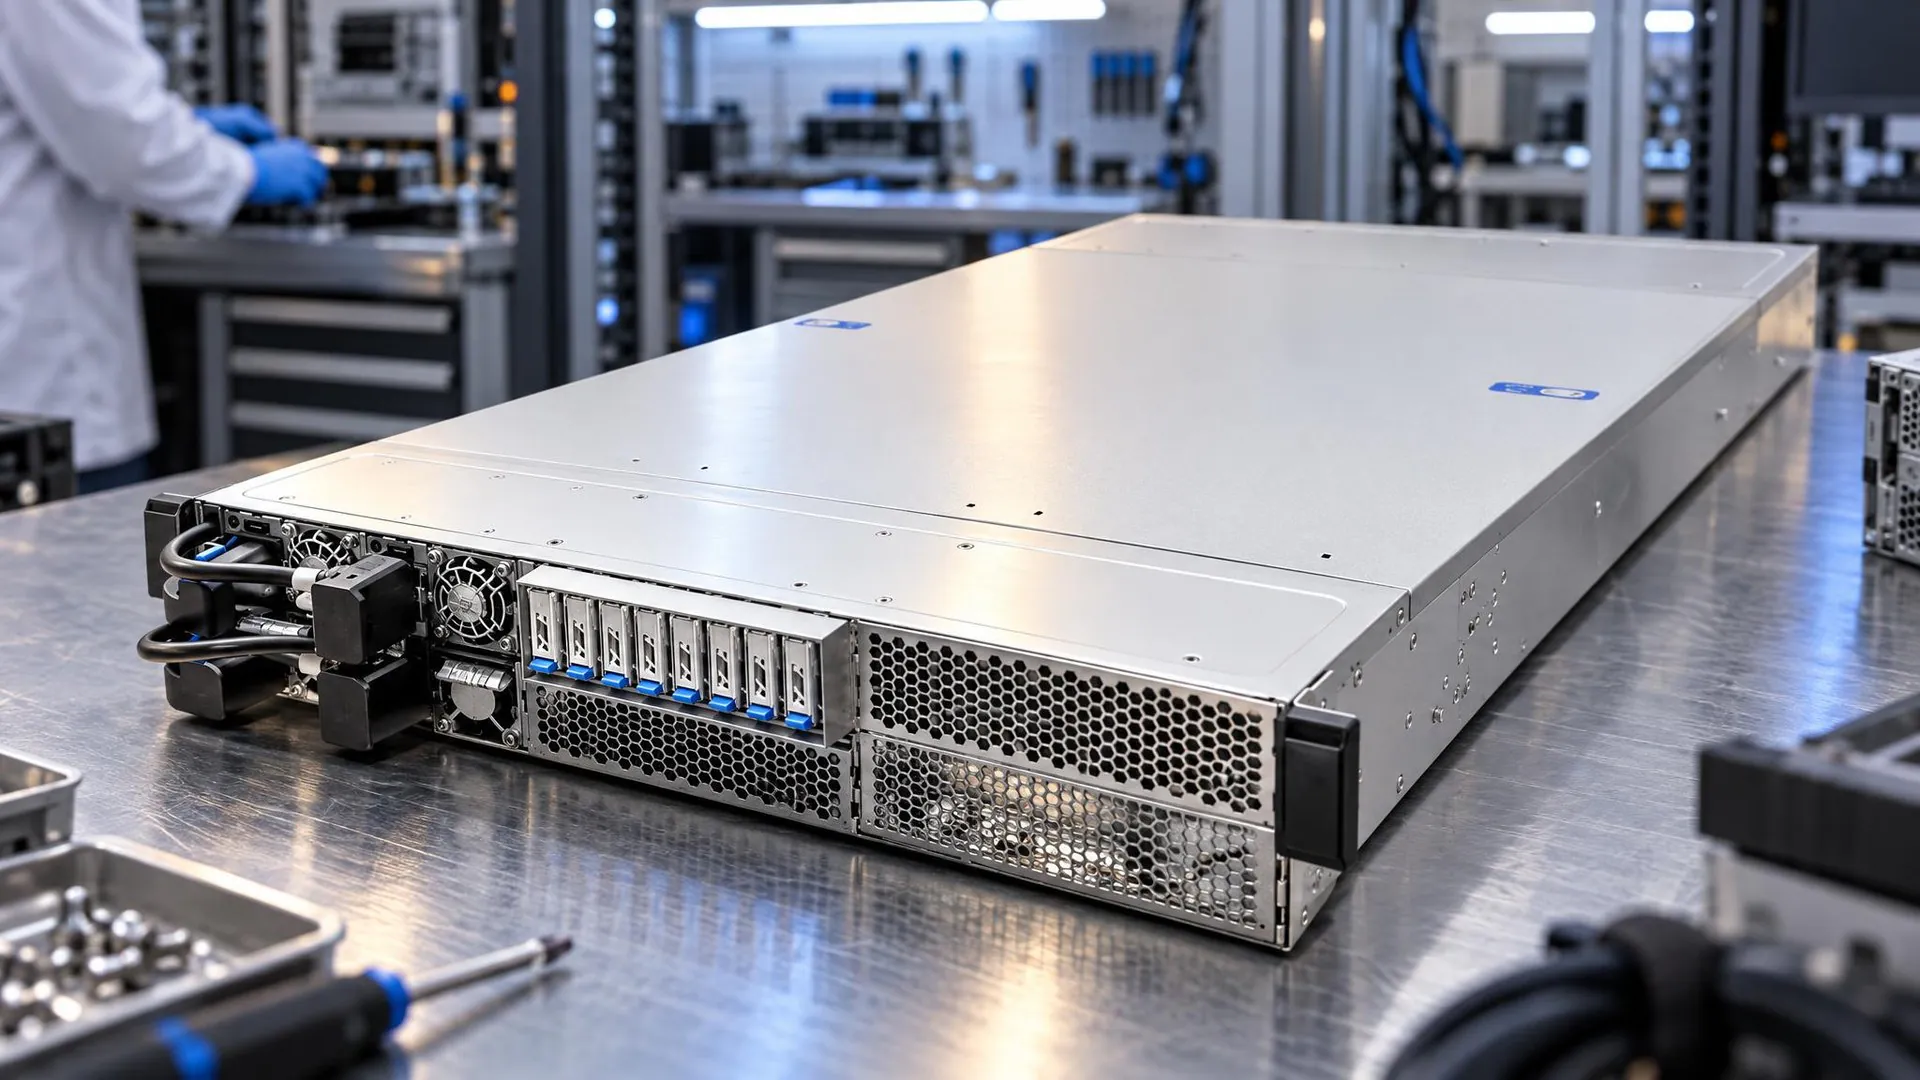
2026 年 10 月 12 日,在加利福尼亚州圣何塞举行的 OCP Global Summit 2026 上,ASUS 发布了 XA P2N-E2。这是一款基于 NVIDIA MGX 架构、搭载两颗 NVIDIA Vera CPU的 2U 服务器。该公司在一份新闻稿中表示,该系统专为智能体 AI 和强化学习工作负载而设计。
新闻稿称,这款服务器面向 AI 应用的执行层,可处理代码执行、工具调用、沙箱隔离、数据处理和编排等任务;这些工作已超出 AI 模型本身的范畴。XA P2N-E2 最多支持两块双插槽 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU,在 2U 平台中结合 CPU 计算与 GPU 加速。ASUS 表示,该系统的 CPU 单线程性能以及高带宽、能效出色的内存,旨在让 AI 智能体在执行和评估高负载任务时仍能保持响应。
双 Vera 处理器,搭配风冷 2U 机箱
XA P2N-E2 产品页面标注为“新品”,列出了双NVIDIA Vera 处理器。每颗处理器集成 88 个定制 Olympus 核心,并支持空间多线程,可提供 176 个线程;每个插槽的 TDP 最高为 480W。ASUS 将 Vera 描述为首款专为 AI 智能体打造的 CPU:按照 ASUS 所述的工作流程,CPU 负责沙箱隔离的代码执行、工具调用、编排和数据处理,而 GPU 则专用于训练和推理。
据产品页面介绍,第二代 NVIDIA NVLink-C2C 可提供最高 1.8TB/s 的 CPU 间一致性通信带宽,核心间带宽最高可达 3.4TB/s。内存由 16 个以 9600MT/s 运行的 SOCAMM2 LPDDR5X 模组组成,容量最高可达 1.5TB。ASUS 表示,与传统 RDIMM 内存相比,这一配置的能效最高可提升一倍,内存功耗可降低 50%。
存储配置包括 8 个支持热插拔的 E1.S 硬盘托架;扩展部分则包括两个 PCIe Gen6 x16 插槽,以及一个专用的双插槽 DPU/NIC 插槽。机箱采用全风冷设计,气流由前向后穿过处理器、内存和 GPU 区域,并配备 2+2 冗余 2000W 80 PLUS Titanium 电源,无需液冷基础设施。基于 MGX 模块化设计,主机处理器模块与 GPU 托架可分别维护;GPU 托架最多可容纳两块双插槽 RTX PRO 6000 Blackwell Server Edition GPU,每块功耗最高为 600W。
ASUS 指出的智能体 AI 部署四大硬件瓶颈
在一篇2026 年 8 月 10 日发布的分析文章中,ASUS 指出,智能体 AI 部署受到四大硬件瓶颈制约:大规模应用时单线程性能不足、每核心内存带宽不够、跨芯片数据访问延迟,以及缺乏硬件级沙箱隔离。该公司表示,XA P2N-E2 通过为智能体代码执行提供硬件级沙箱隔离,解决了最后一项问题;此外,ASUS 称 Vera CPU 的单线程性能最高可达传统 x86 CPU 的 1.8 倍,沙箱代码执行性能可达传统 x86 基础设施的 1.8 倍,编码工作流速度最高可提升至 1.5 倍。ASUS 将这些数据归因于 Vera CPU 的 88 核设计、最高 1.2TB/s 的 LPDDR5X 内存带宽,以及 3.4TB/s 的内部互连带宽。
在那篇 8 月发布的分析文章中,ASUS 此前已将 XA P2N-E2 描述为与另外几款服务器同期推出的产品;这些服务器基于 AMD EPYC 9006 处理器,包括 RS700A-E14B、RS720A-E14B 和 XA P8A-E14A 系列。对于这些系统,ASUS 表示,每个插槽最多可支持 256 个核心,整体性能较上一代提升约 70%;其 16 通道 DDR5 内存可提供约 1.6TB/s 的带宽。
机架级系统与 NVIDIA 平台技术
除 2U 服务器外,ASUS 还在 OCP 展示机架级系统。XA VR721-E3 ASUS AI POD 通过NVIDIA Vera Rubin NVL72平台,将 36 颗 NVIDIA Vera CPU 与 72 个 NVIDIA Rubin GPU 集成在全液冷架构中,用于大规模 AI 训练、后训练和推理。XR R1I12B-M1BHFS 将 NVIDIA HGX Rubin NVL8 与芯片直冷相结合,为 GPU 基板提供液冷,同时为 Intel Xeon 6 处理器提供风冷。
ASUS 还提到了 NVIDIA DSX 参考设计和 NVIDIA Omniverse DSX Blueprint。据该公司介绍,这两项技术将经过验证的架构与高保真仿真结合起来,可构建物理精确的数字孪生,以便在部署之前优化 AI 工厂的设计和运营。ASUS 展台重点展示了四项 NVIDIA 技术:HGX Rubin NVL8 加速计算、基于 Spectrum-6 的 Spectrum-X 以太网交换、CMX Context Memory Storage Platform,以及面向 Vera Rubin NVL72 的 Groq 3 LPX 推理加速器。新闻稿称,该加速器可扩展 NVL72 平台,为响应迅速的推理提供超高速词元生成能力。
Intel 与 AMD 平台系统亮相
Intel 展区展示了 RS700-E12-RS4U 和 RS720-E12-RS12U。这两款分别为 1U 和 2U 的双路服务器搭载 Intel Xeon 6 处理器,采用 DC-MHS 设计并支持免工具维护,面向智能体 AI、虚拟化和数据密集型工作负载。AMD 展区则推出 RS700A-E14B-R16U,这是一款基于代号为“Venice”的第 6 代 AMD EPYC 9006 系列处理器打造的 1U 双路系统,结合 DC-MHS 架构与 PCIe 6.0 连接能力,并支持最多 16 个 E3.S 硬盘。ASUS Thermal Radar 3.0 可对系统进行温度监控和管理。
在加速 AI 计算方面,ESC8000A-E13P 支持 AMD Instinct MI350P PCIe 加速器;XA AM3A-E13 则采用 10U 风冷设计,集成八块 AMD Instinct MI355X 加速器。ASUS 表示,该设计可在无需专用冷冻水基础设施的情况下实现高密度部署。整个产品组合将在 OCP Global Summit 2026 期间于 ASUS 的 #B9 展位展出。ASUS 还表示,其服务器在全球范围内均有供应,但具体产品和配置的供货情况因地区而异。


