
Основи ШІ
Що таке NPU? Пояснення нейронних процесорних блоків

 Додайте Unite.AI до бажаних джерел у Google
Нейронний процесорний блок (NPU) — це спеціалізований прискорювач, розроблений для ефективного виконання типових операцій нейронних мереж. У телефонах, ПК, автомобілях, камерах та вбудованих системах він може запускати підтримувані AI‑навантаження з меншим споживанням енергії або звільняти процесор і графічний процесор для інших завдань.
NPU — це широке галузеве поняття, а не єдина універсальна архітектура. Продуктивність залежить від підтримуваних операторів, числових форматів, пам’яті, компілятора та середовища виконання, теплових обмежень і того, яку частину застосунку можна залишити на прискорювачі.
Ключові висновки
- NPU орієнтуються на матричні, векторні та тензорні операції з високим повторним використанням даних та низьким споживанням енергії.
- Пікові TOPS не є комплексним тестом застосунку і можуть передбачати певну точність або розрідженість.
- Модель може вимагати конвертації, квантування, розподілу графу та резервного виконання для непідтримуваних операцій.
- Порівнюйте затримку, пропускну здатність, енергію, пам’ять, якість, конфіденційність та портативність на реальному навантаженні.
Ролі CPU, GPU та NPU
CPU відмінно підходять для загального управління потоком і широкої сумісності. GPU забезпечують програмовану паралельну пропускну здатність та великі екосистеми програмного забезпечення. NPU спеціалізуються на повторюваних тензорних операціях і можуть включати локальну пам’ять, масиви множення‑накопичення та оптимізований для інференсу потік даних.
Гетерогенні системи планують різні частини там, де вони найкраще підходять. Це важливо для edge AI, де стійка потужність і швидкість реакції можуть бути важливішими за пікову пропускну здатність дата‑центру.
Компіляція та виконання моделі
Граф фреймворку перетворюється в проміжне представлення, оптимізується, квантується за потреби та компілюється для підтримуваних операторів. Середовище виконання може розбивати граф, щоб непідтримувані шари виконувалися на CPU або GPU.
Передача даних між процесорами може знести переваги прискорювача. Статичні форми, розташування, точність, пакетування та повторне використання пам’яті впливають на продуктивність. Перевіряйте скомпільований артефакт, оскільки якість deep‑learning-моделі може змінитися після конвертації.
Розуміння TOPS та заяв про ефективність
TOPS вказує на трильйони операцій за секунду за визначених припущень. Виробники можуть рахувати множення та додавання окремо, використовувати низькобітову цілочисельну точність або передбачати розрідженість. Більше число не гарантує меншої затримки для конкретної моделі.
Вимірюйте холодний та теплий запуск, затримку на запит, пропускну здатність, енергію, пікову пам’ять, теплове обмеження, підтримуваний контекст чи розмір зображення та частку графу, що прискорюється. Використовуйте однакову точність та версії програмного забезпечення.
Компроміси AI на пристрої
Локальне виконання може зменшити залежність від мережі та залишити необроблені дані на пристрої, проте завантажені моделі, журнали, резервні копії та резервні рішення в хмарі все одно створюють потоки даних. Забезпечення безпечної доставки моделей та оновлень платформи залишається необхідним.
NPU можуть підтримувати застосунки візуального, аудіо, мовного та сенсорного типу, включаючи TinyML. Розробники мають передбачати плавний резервний варіант і повідомляти, коли обробка виходить за межі пристрою.
Архітектура NPU та підтримувані операції
NPU прискорює тензорні операції, використовуючи масиви блоків множення‑накопичення, локальну пам’ять, планування потоку даних та спеціалізовані числові формати. Тримання ваг і активацій близько до обчислень зменшує витратне переміщення даних. Реальні пристрої різняться підтримкою операторів, ієрархією пам’яті, точністю, розрідженістю, програмованістю та способом розподілу роботи між CPU та GPU.
Пікова продуктивність часто рекламуються у TOPS, проте TOPS не вказує точність, використання ресурсів, обмеження пам’яті, охоплення операторів чи сквозну затримку. Два процесори з однаковим заголовковим числом можуть працювати по‑різному на одній і тій же моделі. Проводьте бенчмарки скомпільованої моделі, реальні розміри пакетів і послідовностей, передобробку, передачі та режим живлення.
NPU ефективні для підтримуваних нейронних навантажень, таких як візуальне розпізнавання, мовлення, шумозаглушення, ефекти фону та компактні мовні моделі. Непідтримувані оператори можуть переходити на CPU або GPU, створюючи передачі та непередбачувану затримку. Перевіряйте звіти компілятора та трасування середовища виконання, щоб підтвердити розміщення, а не припускати, що весь граф використовує прискорювач.
Конвертація моделі, квантування та розгортання
Розгортання зазвичай проходить від навчального фреймворку через експорт, оптимізацію графу, квантування, компіляцію виробником та інтеграцію середовища виконання. Статичні форми та поширені оператори найпростіше прискорюються. Динамічний контроль потоку, власні ядра, великі проміжні тензори та непідтримувані нормалізації або схеми уваги можуть вимагати змін графу або гібридного виконання.
Цілочисельні та менш точні формати зменшують розмір моделі, пропускну здатність, енергію та затримку, проте дані калібрування мають відображати реальні вхідні дані. Порівнюйте квантування після навчання з квантуванням під час навчання, коли якість чутлива. Оцінюйте поведінку за класами та у найгіршому випадку, оскільки середня точність може приховувати погіршення у рідкісних або безпечних сценаріях.
Інференція на пристрої покращує затримку, автономну роботу та конфіденційність, обмежуючи передачу даних, проте пристрій все одно потребує захищених моделей, доступу до даних з урахуванням дозволів та механізмів оновлення. Захищайте файли моделей за потреби, підписуйте оновлення, повідомляйте про резервний хмарний варіант і переконайтеся, що телеметрія не відновлює витік конфіденційності, який мала зменшити локальна архітектура.
Оцінка продуктивності та системні компроміси
Вимірюйте холодний запуск і стабільну затримку, пропускну здатність, енергію на інференцію, пам’ять, теплову поведінку, точність та вплив на батарею. Тривалі тести виявляють обмеження, які пропускаються у коротких бенчмарках. Враховуйте передобробку та постобробку, оскільки зміна розміру, токенізація, декодування чи копіювання даних можуть домінувати над швидким прискорювачем.
Планування — це системна проблема. CPU керує логікою застосунку, GPU може рендерити або виконувати непідтримувані шари, а NPU запускає сумісні графи. Одночасні навантаження камери, аудіо, дисплея та AI конкурують за пропускну здатність пам’яті та енергію. Тестуйте повний сценарій користувача, а не окрему модель у інструменті виробника.
Портативність залишається обмеженою між компіляторами та середовищами виконання. Віддавайте перевагу стандартним представленням моделей, де це можливо, ізолюйте специфічний для виробника код за інтерфейсами, зберігайте референтні результати та підтримуйте тестове покриття пристроїв. Обирайте обладнання, орієнтуючись на перевірені навантаження, підтримку ПЗ, перспективу оновлень та загальну вартість системи, а не лише на одну специфікацію прискорювача.
Практичний приклад: розгортання візуальної моделі на ноутбуці з NPU
Команда навчає модель сегментації для ефектів фону, експортує її у підтримуваний формат обміну, замінює непідтримувані оператори та калібрує цілочисельне квантування за допомогою представницьких камер, освітлення, відтінків шкіри, одягу та фонів. Компілятор виробника повідомляє, які вузли працюють на NPU, а які переходять у резерв. Команда розглядає будь-яке переходження в резерв як системний витрат, оскільки передача тензорів може домінувати над швидким окремим ядром.
Бенчмаркінг вимірює передобробку камери, виконання моделі, композитинг, пам’ять, холодний запуск, стабільну затримку, стабільність кадрів, енергію та теплове обмеження під час реального відеодзвінка. Результати порівнюються з шляхами CPU та GPU при однаковій якості виходу. Застосунок використовує виявлення можливостей та перевірений резервний варіант, а не припускає, що прискорювач існує або підтримує той самий граф після оновлення драйвера.
Тестування випуску охоплює моделі пристроїв, версії операційної системи та драйверів, одночасні навантаження, режими батареї та некоректні вхідні дані. Пакети моделей підписані та мають версію; телеметрія фіксує продуктивність і помилки без збору зайвого відео. Продукт пояснює, коли обробка залишається на пристрої, а коли використовуються хмарні функції. NPU заслужує свого місця, покращуючи повний досвід за реалістичних обмежень, а не лише досягаючи ізольованого TOPS чи бенчмарку ядра.
Практичний чек‑лист впровадження
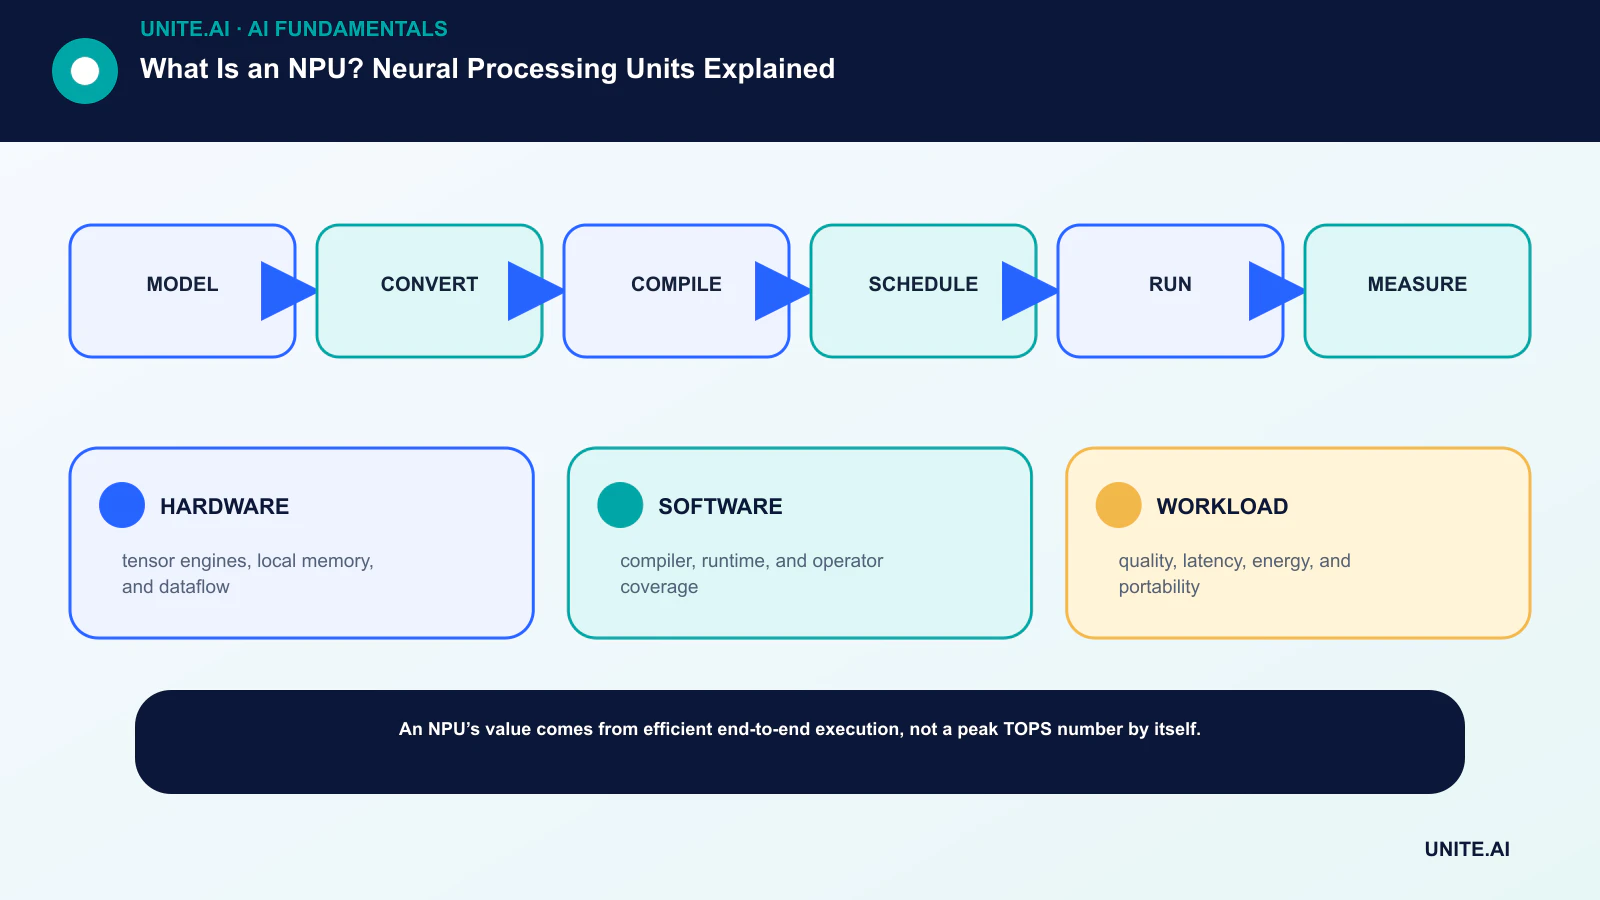
Перетворіть концепцію у чіткий, придатний до тестування робочий процес: модель → конвертація → компіляція → планування → запуск → вимірювання. Призначте відповідального, задокументуйте дані та залежності, встановіть просту базову лінію, визначте критерії прийняття та зупинки, протестуйте типові відмови та визначте моніторинг, відкат і перегляд перед розширенням охоплення. Фіксуйте версії та припущення, щоб інша команда могла відтворити результат і зрозуміти, що змінилося.
Перед запуском проведіть задокументований огляд готовності разом із людьми, які створюють, експлуатують, захищають та постраждають від системи. Тестуйте звичайні випадки, граничні умови, відмови залежностей та неправильне використання; зберігайте докази та нерозв’язані ризики. Визначте, хто може схвалювати випуск, змінювати поріг, перевизначати результат або зупиняти роботу. Перегляньте рішення після отримання реальних даних, оскільки технічно успішний пілот не гарантує надійної продуктивності у масштабі.
- HARDWARE: тензорні рушії, локальна пам’ять та потік даних.
- SOFTWARE: компілятор, середовище виконання та охоплення операторів.
- WORKLOAD: якість, затримка, енергія та портативність.
Часті запитання
Чи є NPU швидшим за GPU?
Залежить від моделі, точності, підтримки операторів, розміру пакету, обмеження енергії та ПЗ. NPU може бути ефективнішим для підтримуваного навантаження на пристрої, тоді як GPU швидший або гнучкіший в інших випадках.
Чи зберігає NPU всю AI‑дані конфіденційними?
Ні. Він дозволяє локальну обробку, проте застосунок може все ж надсилати дані або результати в хмарні сервіси. Конфіденційність залежить від повної архітектури та політики.
Основні джерела












