
Основи ШІ
Що таке механістична інтерпретованість? Як дослідники аналізують моделі ШІ

 Додайте Unite.AI до бажаних джерел у Google
Механістична інтерпретованість вивчає, як вивчені компоненти всередині нейронної мережі причинно впливають на поведінку. Замість простого корелювання вхідних даних з виходами, дослідники формулюють гіпотези щодо ознак, голів уваги, нейронів і схем, а потім втручаються, щоб перевірити ці гіпотези.
Ця галузь створила докладні пояснення для окремих поведінкових патернів у малих і середніх моделях, проте повний, достовірний опис передової моделі залишається недосяжним. Автоматизовані пояснення та привабливі візуалізації можуть слугувати корисними стартовими точками, а не доказом.
Ключові висновки
- Ознаки – це представлення патернів; схеми – це взаємодіючі компоненти, які пропонуються для реалізації обчислення.
- Патчинг активацій, абляція та причинний трасинг перевіряють, чи змінює компонент поведінку.
- Суперпозиція означає, що один нейрон може брати участь у багатьох ознаках; розріджені автокодери намагаються створити іншу основу ознак.
- Методи інтерпретованості потребують «золотої» правди, фальсифікованих тестів, охоплення та оцінки проти альтернативних пояснень.
Від представлення до механізму
Пробування (probing) запитує, чи можна декодувати інформацію з активації. Атрибуція оцінює, які входи або компоненти мають значення. Механістична робота йде далі, пропонуючи внутрішнє обчислення і перевіряючи, чи змінюють втручання очікувані проміжні та кінцеві результати.
Тому це пов’язано, проте вузьше, ніж пояснювальний ШІ. Пояснення пост-гіко для одного рішення не обов’язково є зворотньо інженерованим алгоритмом всередині моделі.
Схеми та причинні втручання
Дослідники можуть ідентифікувати голову уваги або ознаку, пов’язану із завданням, аблювати її, патчити активації з іншого запуску або трасувати, як інформація переміщується між шарами. Хороша гіпотеза передбачає поведінку на нових прикладах і витримує контроль.
Втручання можуть створювати стан поза розподілом, тому зміна поведінки не обов’язково розкриває природний обчислювальний процес. Використовуйте кілька методів, відповідні контролі та кількісні ефекти, а не один ілюстративний запит.
Суперпозиція та розріджені ознаки
Нейронні мережі можуть представляти більше ознак, ніж окремих вимірів, шляхом їх накладання. Тому нейрон може активуватись за кількома несумісними патернами, що робить мітки на рівні нейрону оманливими.
Розріджені автокодери вивчають більший словник ознак з активацій моделі. Вони можуть робити патерни більш роздільними, проте вибрана розрідженість, навчальні дані, помилка реконструкції та автоматичні мітки впливають на те, що відновлюється. Neural-network ознаки все ще потребують причинної валідації.
Безпека, налагодження та обмеження
Механістичні інструменти можуть допомогти виявити запам’ятовані факти, упередження, обманні стратегії або «циркуїти» збоїв і можуть підтримувати редагування або моніторинг. Ті ж інструменти можуть пропускати розподілені, рідкісні або контекстно-залежні обчислення.
Ставте результати у вигляді обмежених доказів: версія моделі, завдання, набір даних, шар, втручання, ефект і невизначеність. Поєднуйте інтерпретацію з поведінковими оцінками, ред‑тімінгом і управлінням відповідального ШІ, а не використовуйте її як універсальний сертифікат безпеки.
Представлення, схеми та причинні докази
Механістична інтерпретованість досліджує, як внутрішні обчислення породжують поведінку моделі. Дослідники аналізують активації, ваги, увагу та проміжні ознаки, а потім формулюють гіпотези щодо представлень і схем. Представлення не обов’язково зберігається в одному нейроні; воно може бути розподілене по напрямках, шарах, токенах і контекстно‑залежних комбінаціях.
Розріджені автокодери намагаються розкласти щільні активації на більший набір ознак, які активуються вибірково. Мітки ознак – це людські інтерпретації спостережуваних прикладів, а не «золота» правда. Помилка реконструкції, розрідженість, розщеплення ознак, абсорбція та «мертві» ознаки впливають на те, що розклад виявляє і що пропускає.
Кореляція недостатня для механістичного твердження. Патчинг активацій, абляція, причинний трасинг, спрямування та цілеспрямовані втручання у ваги перевіряють, чи змінює компонент поведінку, як передбачено. Втручання також можуть створювати стани поза розподілом, тому результати потребують контролів, аналізу дози‑відповідності, альтернативних пояснень і реплікації на різних запитах і моделях.
Ригорозна робоча процедура інтерпретованості
Почніть із точно виміряної поведінки та набору даних, який розділяє конкуруючі гіпотези. Локалізуйте релевантні шари, позиції, компоненти або ознаки; проаналізуйте кандидат‑механізми; втручайтеся; і перевірте, чи запропонована схема передбачає нові випадки. Тримайте дослідницькі приклади окремо від підтверджувальної оцінки, щоб зменшити вибірковий упереджений.
Автоматизовані інструменти можуть ранжувати нейрони, ознаки, голови чи шляхи, а мовні моделі можуть пропонувати описи. Автоматизація підвищує охоплення, але може генерувати правдоподібні історії. Оцінюйте пояснення за допомогою відкладених прикладів активацій і причинних передбачень, реєструйте невизначеність і робіть артефакти відтворюваними, зазначаючи версію моделі, токенізатор, запити та код.
Механізми можуть бути полісемантичними, надлишковими, нелінійними та розподіленими. Видалення одного компонента може бути компенсовано іншими, тоді як ознака може брати участь у кількох поведінках. Негативні результати інформативні: очевидна схема, що не працює поза кураторськими прикладами, повинна бути уточнена або відхилена, а не «рятувана» дедалі розмитішим поясненням.
Застосування, обмеження та заяви про безпеку
Інтерпретованість може допомогти налагоджувати галюцинації, упередження, запам’ятовування, обходи безпеки або несподівані узагальнення; порівнювати моделі; і генерувати наукові гіпотези. Вона також може виявляти ознаки для моніторингу або втручання. Такі використання вимагають валідації під конкретне завдання, бо візуалізація, корисна в дослідженнях, не автоматично стає надійним інструментом у виробництві.
Відсутність виявленої ознаки не доводить відсутність можливості чи наміру, а наявна ознака не доводить, що модель використовує її у конкретній відповіді. Інструменти спостерігають лише проекцію обчислення з обмеженим охопленням. Заяви про безпеку мають уточнювати чутливість виявлення, хибнопозитивність, розподіл, потенційного противника та відомі «сліпі» ділянки.
Використовуйте інтерпретованість разом із поведінковими оцінками, ред‑тімінгом, управлінням даними, контролем доступу, моніторингом та реагуванням на інциденти. Публікуйте методи та контр‑приклади, коли це можливо. Галузь швидко розвивається, проте поточні техніки не забезпечують повного, достовірного пояснення мислення передових моделей чи загальної гарантії вирівнювання.
Практичний приклад: тестування запропонованої схеми моделі
Уявімо, що модель, здається, використовує набір голів уваги та ознак для розв’язання непрямого об’єкта у реченні. Дослідники створюють контрольний набір даних з різними іменами, позиціями, відволікаючими елементами та контр‑прикладами, а потім вимірюють поведінку. Перевірка активацій виявляє кандидат‑компоненти, проте гіпотеза формулюється до втручання: яку інформацію кожен компонент переносить, куди вона переміщується і як її зміна повинна змінити вихід.
Патчинг активацій і абляція тестують необхідність і достатність на відкладених прикладах. Цілеспрямоване редагування, яке змінює передбачений токен у потрібному напрямку, підтримує механізм; широке погіршення продуктивності – ні. Контр‑контроли патчать несуттєві позиції та компоненти, варіюють інтенсивність втручання і порівнюють альтернативні схеми. Команда публікує негативні випадки, коли пояснення не спрацьовує, і уникає присвоювати людсько‑читабельну мету лише на підставі кореляції.
Щоб заявити про застосування у безпеці, метод має виявляти релевантну поведінку з відомою чутливістю за реалістичних запитів і при адаптації противника. Монітори ознак оцінюються за хибнопозитивність, ухилення, оновлення моделі та причинну релевантність. Докази інтерпретованості можуть керувати налагодженням і подальшими тестами, проте забезпечення залишається у зовнішніх контролях і поведінковому моніторингу. Вражаюча схема схеми – це наукова гіпотеза з доказами, а не повне пояснення моделі чи гарантія щодо невідомої поведінки.
Практичний чек‑лист впровадження
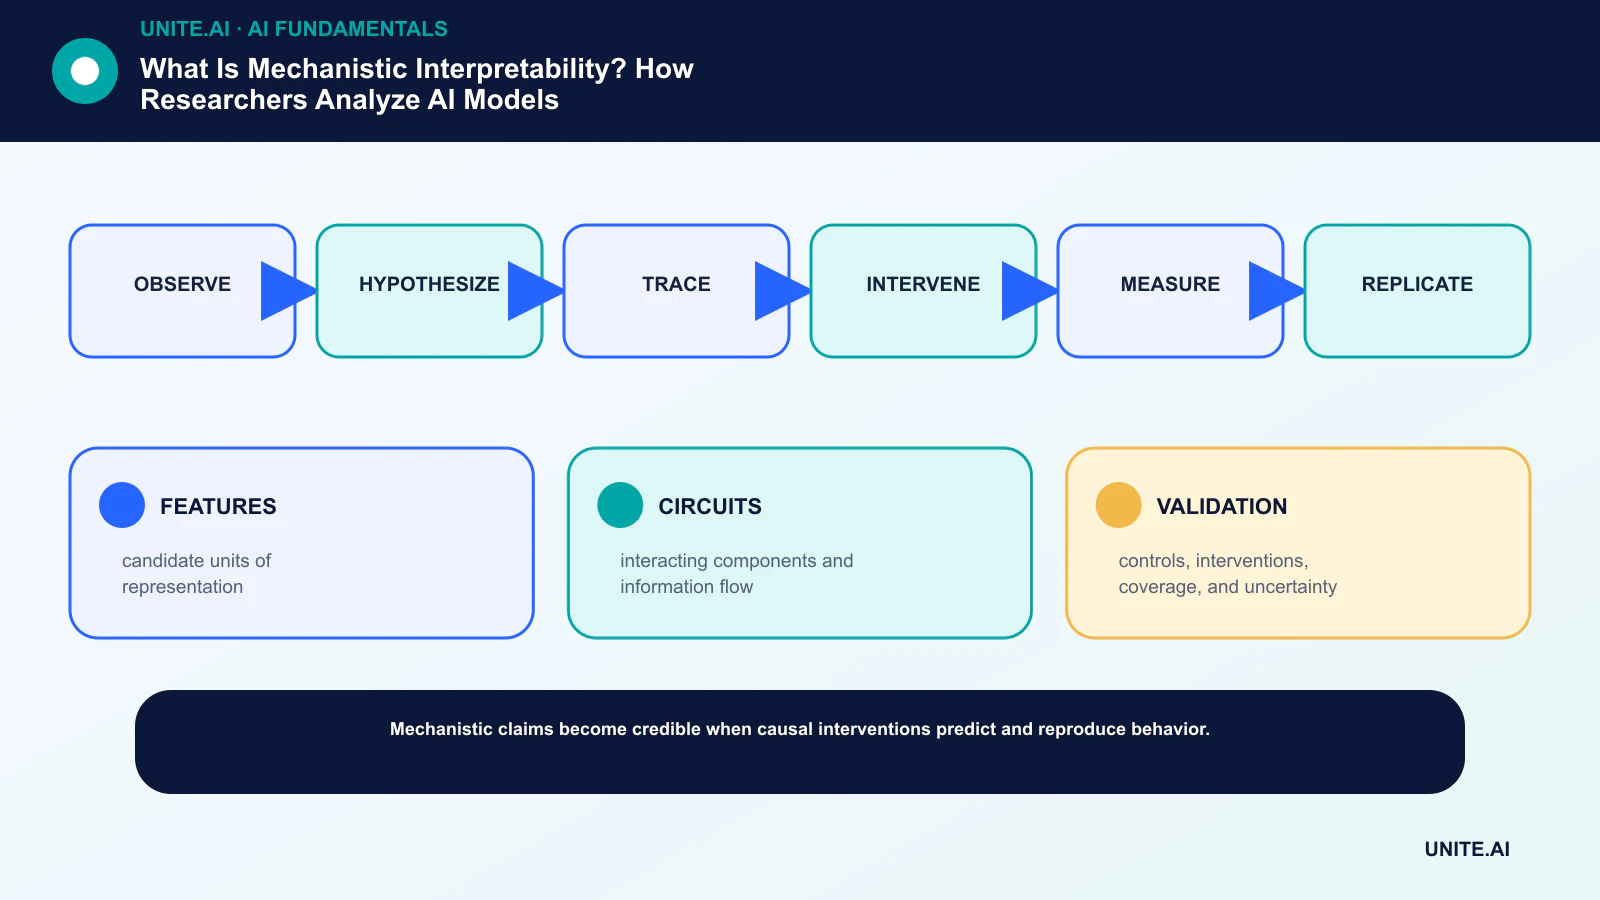
Перетворіть концепцію у обмежений, тестований робочий процес: спостерігати → гіпотезувати → трасувати → втручатися → вимірювати → реплікувати. Призначте відповідального власника, задокументуйте дані та залежності, встановіть просту базову лінію, визначте критерії прийняття та зупинки, протестуйте типові відмови і визначте моніторинг, відкат і огляд перед розширенням охоплення. Фіксуйте версії та припущення, щоб інша команда могла відтворити результат і зрозуміти, що змінилося.
Перед запуском проведіть задокументований огляд готовності з людьми, які будують, експлуатують, захищають і постраждають від системи. Тестуйте звичайні випадки, граничні умови, відмови залежностей і зловживання; зберігайте докази та нерозв’язані ризики. Визначте, хто може схвалити випуск, змінити поріг, перевизначити вихід або зупинити роботу. Переглядайте рішення після надходження реальних даних, бо технічно успішний пілот не гарантує надійної роботи у масштабі.
- FEATURES: кандидат‑одиниці представлення.
- CIRCUITS: взаємодіючі компоненти та потік інформації.
- VALIDATION: контролі, втручання, охоплення та невизначеність.
Поширені запитання
Чи є механістична інтерпретованість тим же, що читання ваг моделі?
Ні. Самі ваги не пояснюються самі по собі. Дослідники аналізують активації, ознаки, компоненти та втручання, щоб будувати та тестувати причинні гіпотези.
Чи можуть розріджені автокодери повністю пояснити LLM?
Ні. Вони пропонують кандидат‑базу ознак і можуть підтримувати аналіз схем, проте охоплення, достовірність, реконструкція, мітки та масштабованість залишаються відкритими проблемами.
Primary references












