Погляд Anderson
Як визначити, чи системи синтезу зображень створюють справді оригінальний матеріал

 Додайте Unite.AI до бажаних джерел у Google

Ключові моментиKAIST і NAVER оцінюють оригінальність зображень за допомогою показника рідкісності, що…
Показати більше
- KAIST і NAVER оцінюють оригінальність зображень за допомогою показника рідкісності, що базується на відстанях до найближчих сусідів.
- Існуючі метрики, як-от Truncation Trick, надають перевагу автентичності, а не новизні згенерованих зображень.
- Показник рідкісності може виявити справді винахідливі результати таких систем, як DALL-E 2.
Нове дослідження з Південної Кореї запропонувало метод визначення того, чи системи синтезу зображень створюють справжньо нові зображення, або лише «дрібні» варіанти навчальних даних, потенційно підриваючи мету таких архітектур (як виробництво нових та оригінальних зображень).
Більшість часу, як стверджує стаття, останнє є правдою, оскільки існуючі метрики, які такі системи використовують для поліпшення своїх генеративних можливостей під час навчання, змушені віддавати перевагу зображенням, які відносно близькі до (не фальшивих) джерельних зображень у наборі даних.
Якщо згенероване зображення «візуально близьке» до джерельних даних, воно, безумовно, отримає вищу оцінку за «автентичність», ніж за «оригінальність», оскільки воно вірне джерелу, хоча й не надто винахідливе.
У галузі, яка ще занадто молода і не випробувана, щоб її юридичні наслідки були ще відомі, це може виявитися важливим юридичним питанням, якщо виявиться, що комерціалізовані синтетичні зображення не відрізняються достатньо від (часто) авторських джерельних матеріалів, які зараз допускаються у дослідницькій сфері у вигляді популярних веб-скрейпінгових наборів даних (потенціал майбутніх претензій щодо порушення прав цього типу нещодавно привернув увагу щодо Microsoft GitHub Co-Pilot AI).
Відносно все більш зрозумілих і семантично сильних результатів з систем, таких як OpenAI DALL-E 2, Google Imagen, і Китаю CogView релізів (а також нижчою специфікацією DALL-E mini), існує дуже мало пост-факто способів надійно перевірити оригінальність згенерованого зображення.
Дійсно, пошук деяких з найбільш популярних нових зображень DALL-E 2 часто веде лише до подальших екземплярів тих самих зображень, залежно від пошукової системи.

Завантаження повної групи з дев’яти зображень DALL-E 2 веде лише до інших таких груп, бо сітка є найсильнішою ознакою. Якщо виокремити перше зображення з цього допису у Twitter від 8 червня 2022 року з акаунта Weird Dall-E Generations і завантажити його, Google зосереджується на баскетбольному м’ячі й заводить пошук у семантичний глухий кут. Для того самого зображення Yandex принаймні начебто справді аналізує пікселі та зіставляє ознаки.
Хоча Yandex більш схильний використовувати фактичні ознаки (тобто виведені/обчислені ознаки зображення, не обов’язково риси облич людей) і візуальні (а не семантичні) характеристики наданного зображення для пошуку подібних зображень, усі пошукові системи зображень мають якийсь порядок денний або практику, яка може ускладнити ідентифікацію випадків джерело>генерований плагіату через веб-пошук.
Крім того, навчальні дані для генеративної моделі можуть не бути публічно доступними в повному обсязі, що ще більше ускладнює судову експертизу оригінальності згенерованих зображень.
Цікаво, що виконання зображення-орієнтованого веб-пошуку на одному з синтетичних зображень, представлених Google на сайті Imagen, нічого порівнянного з предметом зображення не знаходить, щодо фактичного огляду зображення та безстороннього пошуку подібних зображень. Навпаки, семантично фіксований, як завжди, результати пошуку Google зображень для цього зображення Imagen не дозволять здійснити чистий зображення-орієнтований веб-пошук зображення без додавання пошукових термінів «imagen google» як додаткового (і обмежувального) параметра:

Yandex, навпаки, знаходить багато подібних (або хоча б візуально пов’язаних) реальних зображень з аматорської художньої спільноти:

Загалом, було б краще, якщо новизна або оригінальність виводу систем синтезу зображень можна було якимось чином виміряти, без необхідності видобувати ознаки з кожного можливого веб-зображення в інтернеті на момент навчання моделі або в не публічних наборах даних, які можуть використовувати авторські матеріали.
Пов’язано з цією проблемою, дослідники з Kim Jaechul Graduate School of AI в Korea Advanced Institute of Science and Technology (KAIST AI) співпрацювали з глобальною ІКТ-компанією NAVER Corp для розробки Баллу Рідкості, який може допомогти ідентифікувати більш оригінальні творіння систем синтезу зображень.

Зображення створено за допомогою StyleGAN-FFHQ. Стовпці зліва направо показують результати від найгірших до найкращих. Truncation trick і Realism мають власні цілі, тоді як новий бал рідкісності у верхньому рядку шукає цілісні й оригінальні, а не просто цілісні зображення. Через обмеження розміру ілюстрацій у статті подробиці та вищу роздільну здатність дивіться в оригінальному дослідженні. Джерело: https://arxiv.org/pdf/2206.08549.pdf
Нова стаття називається Бал Рідкості: Нова Метрика для Оцінки Незвичності Синтезованих Зображень, і походять від трьох дослідників з KAIST та трьох з NAVER Corp.
Поза «дешевим трюком»
Серед попередніх метрик, на які нова стаття намагається покращити, є «трюк обрізання» пропонований у 2019 році у співпраці між університетом Heriot-Watt у Великій Британії та Google DeepMind.
Трюк обрізання фактично використовує інший латентний розподіл для вибірки, ніж той, який використовувався для навчання генеративної моделі.
Дослідники, які розробили цей метод, були здивовані, що він працює, але визнають у початковій статті, що він зменшує різноманітність згенерованих результатів. Тим не менш, трюк обрізання став ефективним і популярним у контексті того, що можна назвати «дешевим трюком» для отримання автентичних результатів, які не зовсім засвоюють усі можливості, закладені в даних, і можуть нагадувати джерельні дані більше, ніж бажано.
Відносно трюку обрізання автори нової статті відзначають:
‘[Він] не призначений для генерації рідкісних зразків під час навчання, а радше для синтезу типових зображень більш стабільно. Ми припускаємо, що існуючі генеративні моделі зможуть виробляти зразки, багатші на реальному розподілі даних, якщо генератор можна змусити ефективно виробляти рідкісні зразки.’
Відносно загальної тенденції до традиційних метрик, таких як Frechet Inception Distance (FID, який піддався інтенсивній критиці у грудні 2021 року), inception score (IS) і Kernel Inception Distance (KID) як «покажчиків прогресу» під час навчання генеративної моделі, автори далі коментують*:
‘Ця схема навчання веде генератор не до синтезу багатьох рідкісних зразків, які унікальні та мають сильні характеристики, які не становлять велику частку реального розподілу зображень. Приклади рідкісних зразків з публічних наборів даних включають людей з різними аксесуарами в FFHQ, білих тварин в AFHQ, і рідкісні статуї в Metfaces.
‘Здатність генерувати рідкісні зразки важлива не тільки тому, що вона пов’язана з краєм можливостей генеративних моделей, але також тому, що унікальність відіграє важливу роль у творчих застосуваннях, таких як віртуальні люди.
‘Однак, якісні результати кількох останніх досліджень рідко містять ці рідкісні приклади. Ми припускаємо, що природа схеми суперницького навчання змушує розподіл згенерованих зображень бути схожим на той, який використовувався для навчання моделі. Отже, зображення з чіткою індивідуальністю або рідкістю займають лише невелику частку зображень, згенерованих моделями.’
Техніка
Дослідники запропонували новий бал рідкості, який адаптує ідею, представлену в раніших працях – використання K-Nearest Neighbors (KNNs) для представлення масивів справжніх (навчальних) і синтетичних (вивідних) даних у системі синтезу зображень.
Відносно цього нового методу аналізу автори стверджують:
‘Ми припускаємо, що звичайні зразки будуть ближче один до одного, тоді як унікальні та рідкісні зразки будуть розріджені у просторі ознак.’
Результати зображення вище показують найменші найближчі відстані сусідів (NNDs) до найбільших, у архітектурі StyleGAN, навченій на FFHQ.
‘Для всіх наборів даних зразки з найменшими NNDs показують типові зображення. Навпаки, зразки з найбільшими NNDs мають сильну індивідуальність і суттєво відрізняються від типових зображень з найменшими NNDs.’
У теорії, використовуючи цю нову метрику як дискримінатор, або хоча б включивши її в більш складну архітектуру дискримінатора, генеративна система могла б бути спрямована від чистої імітації до більш винахідливого алгоритму, зберігаючи при цьому суттєву узгодженість концепцій, які можуть бути критичними для автентичного виробництва зображень (тобто «чоловік», «жінка», «автомобіль», «церква» тощо).
Порівняння та Експерименти
У тестах дослідники провели порівняння продуктивності балу рідкості з трюком обрізання та балом реалізму NVIDIA 2019 року, і виявили, що в різних рамках і наборах даних підхід здатний індивідуалізувати «унікальні» результати.
Хоча результати, представлені в статті, надто обширні, щоб включити їх тут, дослідники здаються здатними продемонструвати можливість нового методу ідентифікувати рідкість як у джерельних (реальних), так і в згенерованих (фальшивих) зображеннях у генеративній процедурі:
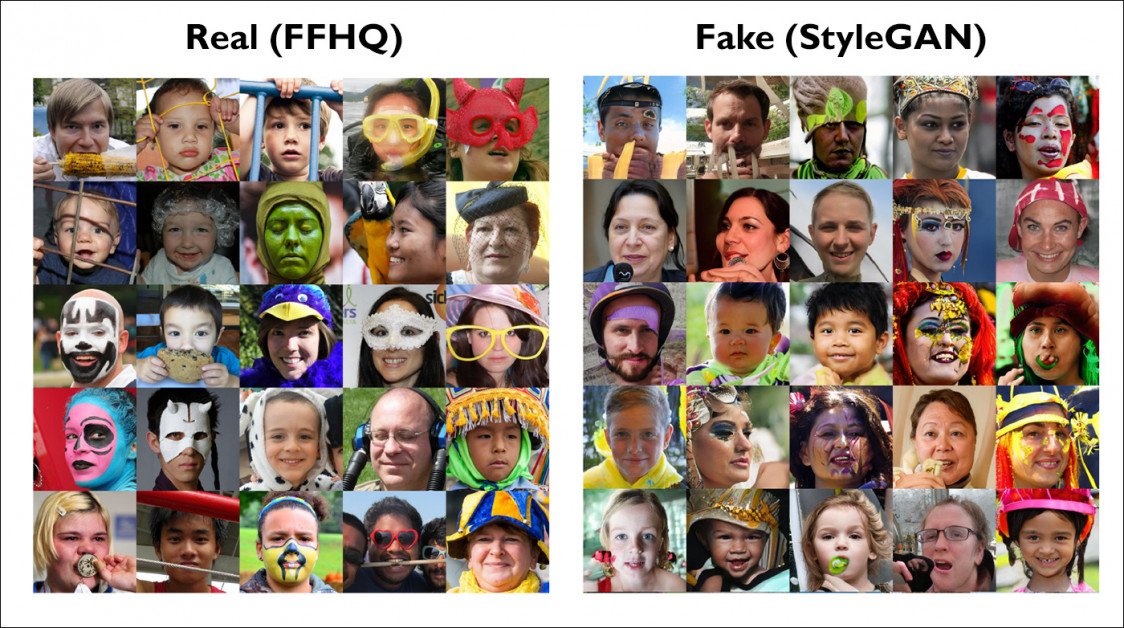
Вибрані приклади з великих візуальних результатів дослідження; подробиці за джерелом вище. Ліворуч справжні приклади FFHQ, які мають дуже мало близьких сусідів у початковому наборі, тобто нові й незвичні. Праворуч створені StyleGAN зображення, які нова метрика визначила як справді нові. Через обмежений розмір ілюстрацій подробиці та вищу роздільну здатність дивіться в оригіналі.
Новий бал рідкості не тільки дозволяє ідентифікувати «нові» генеративні результати в одній архітектурі, але також, стверджують дослідники, дозволяє порівнювати між генеративними моделями різних архітектур (тобто автоенкодер, VAE, GAN тощо).
Стаття відзначає, що бал рідкості відрізняється від попередніх метрик, зосереджуючись на здатності генеративної структури створювати унікальні та рідкісні зображення, на відміну від «традиційних» метрик, які вивчають (більш міопічно) різноманітність між генераціями під час навчання моделі.
Поза обмеженими завданнями
Хоча дослідники провели тести на обмежених завданнях (наприклад, генератор/набір даних, призначені для створення зображень людей або котів), бал рідкості потенційно можна застосувати до будь-якої довільної процедури синтезу зображень, де потрібно ідентифікувати згенеровані приклади, які використовують розподіли, виведені з навчених даних, а не збільшувати автентичність (і зменшувати різноманітність) шляхом додавання сторонніх латентних розподілів або використання інших коротких шляхів, які компрометують новизну на користь автентичності.
Така метрика могла б розрізняти справді нові результати в системах на кшталт DALL-E за визначеною відстанню між начебто нетиповим результатом, навчальними даними та результатами схожих запитів чи входів, зокрема запитів на основі зображень.
На практиці, за відсутності чіткого розуміння ступеня, у якому система справді засвоює візуальні та семантичні концепції (часто перешкоджає обмежена інформація про навчальні дані), це може бути життєздатним методом ідентифікації справжньої «миті натхнення» в генеративній системі – моменту, у якому достатня кількість вхідних концепцій і даних призвела до чогось справді винахідливого, а не чогось надміру похідного або близького до джерельних даних.
* Мої конверсії вбудованих цитат авторів у гіперпосилання.
Перше видання 20 червня 2022 року.