
โมเดลและแพลตฟอร์ม AI
ปัญหา Black Box ใน LLMs: ความท้าทายและวิธีแก้ปัญหาที่เกิดขึ้นใหม่

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญลักษณะกล่องดำของ LLM…
ดูเพิ่มเติม
- ลักษณะกล่องดำของ LLM สร้างความเสี่ยงด้านความปลอดภัยและความรับผิดชอบอย่างร้ายแรงในสาขาวิกฤต เช่น การดูแลสุขภาพและการเงิน
- เทคนิคอย่าง LIME และ SHAP ให้ความสามารถในการตีความที่ไม่ขึ้นกับโมเดล โดยอธิบายการทำนายเฉพาะจุดและความสำคัญของฟีเจอร์ในภาพรวม
- วิธีการประมาณเชิงปฏิปักษ์แบบใหม่นำเสนอคำอธิบายเชิงเหตุผลสำหรับผลลัพธ์ของ LLM แต่ต้องเผชิญกับการแลกเปลี่ยนระหว่างความแม่นยำกับการใช้ทรัพยากร
การเรียนรู้ของเครื่องจักร ซึ่งเป็นส่วนหนึ่งของ AI ประกอบด้วยสามส่วนหลัก ได้แก่ อัลกอริทึม ข้อมูลการฝึกอบรม และโมเดลที่ได้จากการฝึกอบรม อัลกอริทึม ซึ่งเป็นชุดของขั้นตอนการทำงาน จะเรียนรู้เพื่อระบุรูปแบบจากตัวอย่างข้อมูลการฝึกอบรมที่มีจำนวนมาก ผลลัพธ์ของการฝึกอบรมนี้คือโมเดลการเรียนรู้ของเครื่องจักร ตัวอย่างเช่น อัลกอริทึมที่ได้รับการฝึกอบรมด้วยรูปภาพของสุนัขจะทำให้ได้โมเดลที่สามารถระบุสุนัขในรูปภาพได้
ปัญหา Black Box ในการเรียนรู้ของเครื่องจักร
ในการเรียนรู้ของเครื่องจักร ส่วนใดส่วนหนึ่งของสามส่วนหลัก (อัลกอริทึม ข้อมูลการฝึกอบรม หรือโมเดล) อาจเป็นปัญหา Black Box อัลกอริทึมมักเป็นที่รู้จักอย่างกว้างขวาง แต่นักพัฒนาอาจเลือกที่จะเก็บโมเดลหรือข้อมูลการฝึกอบรมเป็นความลับเพื่อป้องกันการละเมิดทรัพย์สินทางปัญญา ความไม่ชัดเจนนี้ทำให้ยากต่อการทำความเข้าใจกระบวนการตัดสินใจของ AI
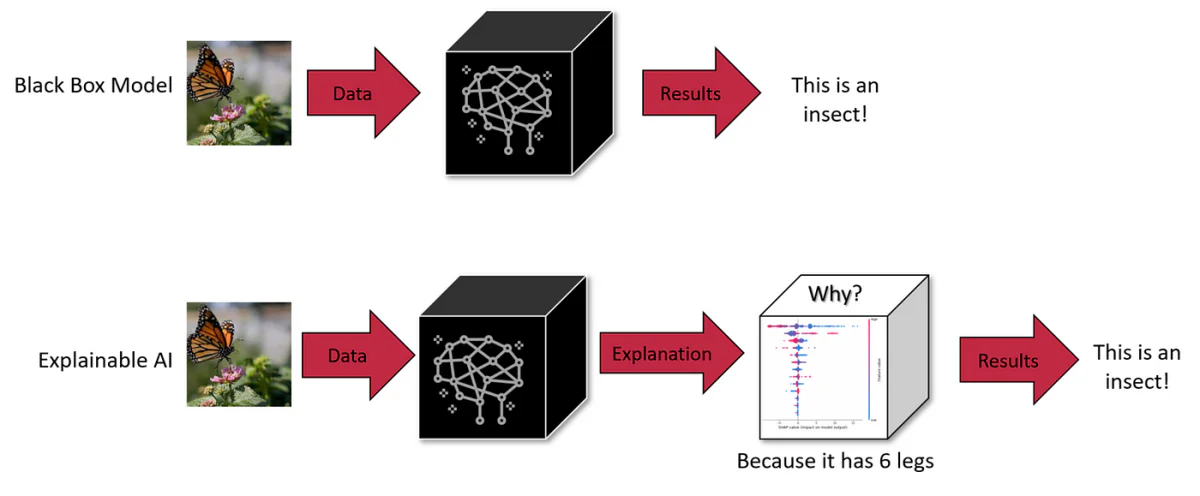
ระบบ Black Box ของ AI คือระบบที่การทำงานภายในไม่ชัดเจนหรือไม่สามารถมองเห็นได้โดยผู้ใช้ ผู้ใช้สามารถใส่ข้อมูลและได้รับผลลัพธ์ แต่ตรรกะหรือโค้ดที่สร้างผลลัพธ์นั้นยังคงซ่อนอยู่ นี่เป็นลักษณะที่พบได้ทั่วไปในหลายระบบ AI รวมถึงโมเดลที่ซับซ้อนเช่น ChatGPT และ DALL-E 3
โมเดล LLM เช่น GPT-4 นำเสนอความท้าทายที่สำคัญ เนื่องจากการทำงานภายในของโมเดลเหล่านี้ไม่ชัดเจน ทำให้พวกมันเป็น “ปัญหา Black Box” ความไม่ชัดเจนนี้ไม่ใช่แค่ปัญหาเทคนิค แต่ยังเป็นปัญหาเรื่องความปลอดภัยและจริยธรรมด้วย ตัวอย่างเช่น หากเราไม่สามารถเข้าใจว่าระบบเหล่านี้ตัดสินใจอย่างไรได้ เราจะสามารถไว้วางใจพวกมันในด้านที่สำคัญ เช่น การวินิจฉัยทางการแพทย์หรือการประเมินทางการเงินได้หรือไม่?


ขนาดและความซับซ้อนของ LLMs
ขนาดของโมเดลเหล่านี้เพิ่มความซับซ้อนขึ้นไปอีก ตัวอย่างเช่น GPT-3 มีพารามิเตอร์ 175 พันล้านตัว และโมเดลใหม่ๆ มีพารามิเตอร์ระดับล้านล้านตัว แต่ละพารามิเตอร์ทำงานร่วมกันในลักษณะที่ซับซ้อนภายในเครือข่ายประสาทเทียม ทำให้เกิดความสามารถที่ไม่สามารถคาดเดาได้โดยการตรวจสอบส่วนประกอบแต่ละส่วนเพียงอย่างเดียว ความซับซ้อนและขนาดนี้ทำให้การเข้าใจตรรกะภายในของโมเดลเหล่านี้เป็นเรื่องที่ยากมาก และเป็นอุปสรรคต่อการวินิจฉัยความลำเอียงหรือพฤติกรรมที่ไม่พึงประสงค์ในโมเดลเหล่านี้
การแลกเปลี่ยน: ขนาด vs การอธิบาย
การลดขนาดของ LLMs อาจเพิ่มความสามารถในการอธิบาย แต่ก็ส่งผลต่อความสามารถที่ทันสมัยของพวกมัน ขนาดของโมเดลคือสิ่งที่ทำให้เกิดพฤติกรรมที่โมเดลขนาดเล็กไม่สามารถทำได้ ซึ่งนำไปสู่การแลกเปลี่ยนระหว่างขนาด ความสามารถ และการอธิบาย
ผลกระทบของปัญหา Black Box ใน LLMs
1. การตัดสินใจที่มีข้อบกพร่อง
ความไม่ชัดเจนในกระบวนการตัดสินใจของ LLMs เช่น GPT-3 หรือ BERT อาจนำไปสู่ความลำเอียงและข้อผิดพลาดที่ไม่ได้รับการตรวจจับ ในด้านต่างๆ เช่น การแพทย์หรือกระบวนการยุติธรรม ซึ่งการตัดสินใจมีผลกระทบอย่างกว้างขวาง ความไม่สามารถตรวจสอบ LLMs สำหรับความถูกต้องตามหลักจริยธรรมและเหตุผลเป็นข้อกังวลหลัก ตัวอย่างเช่น ระบบการวินิจฉัยทางการแพทย์ที่พึ่งพาข้อมูลที่ล้าสมัยหรือมีความลำเอียงอาจให้คำแนะนำที่เป็นอันตราย ในทำนองเดียวกัน LLMs ในกระบวนการสรรหาบุคลากรอาจส่งเสริมความลำเอียงทางเพศโดยไม่ตั้งใจ ปัญหา Black Box ไม่เพียงแต่ซ่อนข้อบกพร่องเท่านั้น แต่ยังอาจเพิ่มความเสี่ยงด้วย ทำให้ต้องมีการดำเนินการเชิงรุกเพื่อเพิ่มความโปร่งใส
2. การปรับตัวที่จำกัดในบริบทที่หลากหลาย
การขาดความเข้าใจเกี่ยวกับการทำงานภายในของ LLMs ทำให้การปรับตัวของพวกมันถูกจำกัด ตัวอย่างเช่น ระบบ LLM สำหรับการสรรหาบุคลากรอาจไม่มีประสิทธิภาพในการประเมินผู้สมัครสำหรับบทบาทที่ให้ความสำคัญกับทักษะปฏิบัติมากกว่าคุณสมบัติทางวิชาการ เนื่องจากความไม่สามารถปรับเกณฑ์การประเมินของตนเองได้ ในทำนองเดียวกัน ระบบ LLM ทางการแพทย์อาจต้องดิ้นรนในการวินิจฉัยโรคที่หายากเนื่องจากความไม่สมดุลของข้อมูล การไม่ยืดหยุ่นนี้เน้นย้ำถึงความจำเป็นในการมีความโปร่งใสเพื่อปรับ LLMs สำหรับงานและบริบทเฉพาะ
3. ความลำเอียงและช่องว่างความรู้
การประมวลผลข้อมูลการฝึกอบรมจำนวนมากของ LLMs ต้องเผชิญกับการจำกัดที่กำหนดโดยอัลกอริทึมและโครงสร้างโมเดล ตัวอย่างเช่น ระบบ LLM ทางการแพทย์อาจแสดงความลำเอียงทางประชากรหากได้รับการฝึกอบรมจากชุดข้อมูลที่ไม่สมดุล นอกจากนี้ ความเชี่ยวชาญของ LLM ในหัวข้อเฉพาะอาจทำให้เข้าใจผิดและนำไปสู่การผลิตข้อมูลที่ไม่ถูกต้องและมั่นใจมากเกินไป การแก้ไขความลำเอียงและช่องว่างความรู้เหล่านี้ต้องการมากกว่าการเพิ่มข้อมูลเพียงอย่างเดียว แต่ต้องตรวจสอบกลไกการประมวลผลของโมเดลด้วย
4. ความรับผิดชอบทางกฎหมายและจริยธรรม
ลักษณะที่ไม่โปร่งใสของ LLMs สร้างพื้นที่สีเทาในด้านกฎหมายเกี่ยวกับความรับผิดชอบสำหรับอันตรายใดๆ ที่เกิดจากการตัดสินใจของพวกมัน หาก LLM ในสภาพแวดล้อมทางการแพทย์ให้คำแนะนำที่ผิดพลาดซึ่งนำไปสู่อันตรายต่อผู้ป่วย การกำหนดความรับผิดชอบจะกลายเป็นเรื่องที่ยากเนื่องจากความไม่โปร่งใสของโมเดล ความไม่แน่นอนทางกฎหมายนี้ทำให้เกิดความเสี่ยงสำหรับหน่วยงานที่ใช้ LLMs ในพื้นที่ที่มีความอ่อนไหว โดยเน้นย้ำถึงความจำเป็นในการมีการกำกับดูแลและความโปร่งใสที่ชัดเจน
5. ปัญหาเรื่องความไว้วางใจในแอปพลิเคชันที่มีความอ่อนไหว
สำหรับ LLMs ที่ใช้ในด้านสำคัญ เช่น การแพทย์และการเงิน การขาดความโปร่งใสทำให้ความน่าเชื่อถือลดลง ผู้ใช้และผู้กำกับดูแลต้องแน่ใจว่าโมเดลเหล่านี้ไม่มีความลำเอียงหรือตัดสินใจตามเกณฑ์ที่ไม่ยุติธรรม การตรวจสอบการไม่มีความลำเอียงใน LLMs ต้องการความเข้าใจเกี่ยวกับกระบวนการตัดสินใจของพวกมัน ซึ่งเน้นย้ำถึงความสำคัญของการอธิบายสำหรับการใช้งานที่มีจริยธรรม
6. ความเสี่ยงกับข้อมูลส่วนบุคคล
LLMs ต้องการข้อมูลการฝึกอบรมจำนวนมาก ซึ่งอาจรวมถึงข้อมูลส่วนบุคคลที่มีความอ่อนไหว ลักษณะ Black Box ของโมเดลเหล่านี้ทำให้เกิดความกังวลเกี่ยวกับวิธีการประมวลผลและใช้ข้อมูลนี้ ตัวอย่างเช่น LLM ทางการแพทย์ที่ได้รับการฝึกอบรมจากบันทึกผู้ป่วยทำให้เกิดคำถามเกี่ยวกับการรักษาความเป็นส่วนตัวของข้อมูลและวิธีการใช้ข้อมูล การรับรองว่าข้อมูลส่วนบุคคลไม่ถูกใช้ในทางที่ผิดหรือแสวงหาประโยชน์จำเป็นต้องมีการประมวลผลข้อมูลที่โปร่งใสภายในโมเดลเหล่านี้
วิธีแก้ปัญหาที่เกิดขึ้นใหม่สำหรับการอธิบาย
เพื่อแก้ไขความท้าทายเหล่านี้ เทคนิคใหม่ๆ กำลังถูกพัฒนา เทคนิคเหล่านี้รวมถึงวิธีการประมาณการแบบสมมุติ (CF) วิธีแรกเกี่ยวข้องกับการกระตุ้น LLM เพื่อเปลี่ยนแนวคิดเฉพาะในข้อความโดยการรักษาแนวคิดอื่นๆ ไว้เท่าเดิม วิธีการนี้แม้จะมีประสิทธิภาพ แต่ต้องใช้ทรัพยากรมากในขณะอินเฟอร์เรนซ์
วิธีที่สองเกี่ยวข้องกับการสร้างปริภูมิเวกเตอร์ฝังตัวเฉพาะที่ได้รับการชี้นำจาก LLM ในระหว่างการฝึกอบรม พื้นที่นี้สอดคล้องกับกราฟเชิงสาเหตุและช่วยในการระบุการประมาณการแบบสมมุติที่ตรงกัน วิธีการนี้ต้องการทรัพยากรน้อยกว่าในขณะทดสอบและได้แสดงให้เห็นแล้วว่าสามารถอธิบายการคาดการณ์ของโมเดลได้อย่างมีประสิทธิภาพ แม้แต่ใน LLMs ที่มีพารามิเตอร์หลายพันล้านตัว
วิธีการเหล่านี้เน้นย้ำถึงความสำคัญของการอธิบายเชิงสาเหตุในระบบ NLP เพื่อให้แน่ใจถึงความปลอดภัยและสร้างความไว้วางใจ การประมาณการแบบสมมุติให้วิธีการในการจินตนาการว่าข้อความที่กำหนดจะเปลี่ยนแปลงไปอย่างไรหากแนวคิดใดๆ ในกระบวนการสร้างข้อความนั้นแตกต่างออกไป ซึ่งช่วยในการประเมินผลกระทบเชิงสาเหตุของแนวคิดระดับสูงต่อโมเดล NLP
การสำรวจลึก: วิธีการอธิบายและความสัมพันธ์เชิงสาเหตุใน LLMs
การตรวจสอบและเครื่องมือความสำคัญของฟีเจอร์
การตรวจสอบเป็นเทคนิคที่ใช้เพื่อถอดรหัสสิ่งที่การแสดงออกภายในของโมเดลเข้ารหัสไว้ สามารถเป็นแบบมีการกำกับหรือไม่มีการกำกับ และมุ่งหมายที่จะกำหนดว่าแนวคิดเฉพาะถูกเข้ารหัสไว้ที่จุดใดในเครือข่าย แม้ว่าจะมีประสิทธิภาพถึงจุดหนึ่ง แต่การตรวจสอบยังคงไม่เพียงพอในการให้คำอธิบายเชิงสาเหตุ ดังที่ Geiger และคณะ (2021) ชี้ไว้
เครื่องมือความสำคัญของฟีเจอร์เป็นอีกวิธีในการอธิบาย โดยมักมุ่งที่ฟีเจอร์อินพุต แม้ว่าวิธีที่ใช้เกรเดียนต์บางวิธีจะขยายไปถึงสถานะซ่อนเร้น ตัวอย่างเช่น วิธีเกรเดียนต์แบบอินทิเกรต (Integrated Gradients) ให้การอธิบายเชิงสาเหตุโดยการสำรวจอินพุตฐานแบบสมมุติตรงข้ามข้อเท็จจริง (CF) แม้ว่าวิธีการเหล่านี้จะมีประโยชน์ แต่ก็ยังคงดิ้นรนในการเชื่อมโยงการวิเคราะห์ของตนเองกับแนวคิดในโลกแห่งความเป็นจริงนอกเหนือจากคุณลักษณะการเข้าแบบง่ายๆ
วิธีการแบบการแทรกแซง
วิธีการแบบการแทรกแซงเกี่ยวข้องกับการปรับเปลี่ยนข้อมูลเข้าหรือการแสดงออกภายในเพื่อศึกษาการเปลี่ยนแปลงของพฤติกรรมของโมเดล วิธีการเหล่านี้สามารถสร้างสถานะสมมุติได้เพื่อประมาณการผลกระทบเชิงสาเหตุ แต่โดยทั่วไปจะสร้างข้อมูลเข้าที่ไม่น่าเชื่อถือหรือสถานะเครือข่ายที่ไม่ได้รับการควบคุมอย่างดี เว้นแต่จะถูกควบคุมอย่างระมัดระวัง โมเดลตัวแทนเชิงสาเหตุ (Causal Proxy Model, CPM) ซึ่งได้รับแรงบันดาลใจจากแนวคิด S-learner เป็นวิธีการใหม่ในด้านนี้ โดยเลียนแบบพฤติกรรมของโมเดลที่อธิบายได้ภายใต้การเข้าแบบสมมุติ อย่างไรก็ตาม การต้องการตัวอธิบายที่แยกจากกันสำหรับแต่ละโมเดลเป็นข้อจำกัดหลัก
การประมาณการสมมุติ
การประมาณการสมมุติเป็นวิธีการที่ใช้กันอย่างแพร่หลายในการเรียนรู้ของเครื่อง สำหรับการเพิ่มข้อมูล โดยเกี่ยวข้องกับการเปลี่ยนแปลงปัจจัยหรือป้ายกำกับต่างๆ การประมาณการเหล่านี้สามารถสร้างขึ้นได้โดยการแก้ไขด้วยมือ การแทนที่คำสำคัญด้วยกฎเชิงฮิวริสติก หรือการเขียนข้อความใหม่โดยอัตโนมัติ แม้ว่าการแก้ไขด้วยมือจะแม่นยำ แต่ก็ใช้ทรัพยากรมาก วิธีการที่ใช้คีย์เวิร์ดมีข้อจำกัด และวิธีการสร้างข้อความใหม่ให้ความสมดุลระหว่างความคล่องตัวและความครอบคลุม
การอธิบายที่ซื่อสัตย์
ความซื่อสัตย์ในการอธิบายหมายถึงการพรรณนาการให้เหตุผลที่ซ่อนอยู่ของโมเดลอย่างถูกต้อง ไม่มีนิยามที่ได้รับการยอมรับอย่างกว้างขวางเกี่ยวกับความซื่อสัตย์ ซึ่งนำไปสู่การอธิบายผ่านเมตริกต่างๆ เช่น ความไวต่อการเปลี่ยนแปลง ความสอดคล้อง ความสอดคล้องของการประเมินความสำคัญฟีเจอร์ ความแข็งแกร่ง และความสามารถในการจำลองได้ วิธีการส่วนใหญ่เน้นไปที่การอธิบายระดับฟีเจอร์ และมักจะสับสนระหว่างสหสัมพันธ์กับความเป็นเหตุเป็นผล งานของเรามุ่งหมายที่จะให้การอธิบายแนวคิดระดับสูง โดยใช้เอกสารเชิงสาเหตุเพื่อเสนอเกณฑ์ที่มีเหตุผล: Order-Faithfulness
เราลงลึกเข้าไปในความซับซ้อนของ LLMs โดยเข้าใจถึงลักษณะ Black Box และความท้าทายที่สำคัญที่พวกมันนำมาให้ จากความเสี่ยงของการตัดสินใจที่มีข้อบกพร่องในด้านที่สำคัญ เช่น การแพทย์และการเงิน ไปจนถึงปัญหาเชิงจริยธรรมที่เกี่ยวข้องกับความลำเอียงและความยุติธรรม ความจำเป็นของความโปร่งใสใน LLM ชัดเจนยิ่งกว่าที่เคย
อนาคตของ LLMs และการรวมเข้ากับชีวิตประจำวันและกระบวนการตัดสินใจที่สำคัญขึ้นอยู่กับความสามารถของเราในการทำให้โมเดลเหล่านี้ไม่เพียงแต่ซับซ้อนมากขึ้น แต่ยังเข้าใจได้และรับผิดชอบมากขึ้นด้วย การมุ่งพัฒนาความสามารถในการอธิบายและตีความโมเดลไม่ใช่แค่ความพยายามทางเทคนิคเท่านั้น แต่ยังเป็นส่วนสำคัญในการสร้างความไว้วางใจในระบบ AI เมื่อ LLMs ถูกนำไปใช้ในสังคมมากขึ้น ความต้องการความโปร่งใสจะเพิ่มขึ้น ไม่ใช่แค่จากผู้ปฏิบัติงาน AI เท่านั้น แต่จากผู้ใช้ทุกคนที่โต้ตอบกับระบบเหล่านี้


