
การแพทย์
การปฏิวัติระบบสุขภาพ: การสำรวจผลกระทบและอนาคตของโมเดลภาษาขนาดใหญ่ในด้านการแพทย์

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การบูรณาการและประยุกต์ใช้โมเดลภาษาขนาดใหญ่ (LLM) ในการแพทย์และบริการสุขภาพเป็นเรื่องที่ได้รับความสนใจและมีการพัฒนาอย่างมาก
ดังที่กล่าวถึงในการประชุมระดับโลกของ Healthcare Information Management and Systems Society และงานสำคัญอื่นๆ บริษัทอย่าง Google (GOOGL ) เป็นผู้นำในการสำรวจศักยภาพของ AI เชิงกำเนิดในบริการสุขภาพ โครงการอย่าง Med-PaLM 2 สะท้อนความก้าวหน้าของโซลูชันสุขภาพที่ขับเคลื่อนด้วย AI โดยเฉพาะด้านการวินิจฉัย การดูแลผู้ป่วย และประสิทธิภาพงานบริหาร
Med-PaLM 2 ของ Google เป็น LLM บุกเบิกด้านสุขภาพที่แสดงความสามารถน่าประทับใจ โดยตอบโจทย์รูปแบบการสอบใบอนุญาตประกอบวิชาชีพแพทย์ของสหรัฐฯ ได้ในระดับ “ผู้เชี่ยวชาญ” โมเดลนี้และโมเดลลักษณะเดียวกันอาจเปลี่ยนวิธีที่บุคลากรทางการแพทย์เข้าถึงและใช้ข้อมูล และอาจเพิ่มความแม่นยำในการวินิจฉัยและประสิทธิภาพการดูแลผู้ป่วย
อย่างไรก็ตาม ยังมีข้อกังวลเรื่องความเหมาะสมในการใช้งานจริงและความปลอดภัยในบริบทคลินิก การฝึกโมเดลด้วยข้อมูลอินเทอร์เน็ตจำนวนมหาศาลแม้มีประโยชน์ในบางกรณี ก็อาจไม่เหมาะสมหรือน่าเชื่อถือสำหรับการแพทย์เสมอไป Nigam Shah ผู้มีวุฒิ PhD และ MBBS และเป็นหัวหน้านักวิทยาศาสตร์ข้อมูลของ Stanford Health Care ชี้ว่าคำถามสำคัญคือโมเดลเหล่านี้ทำงานอย่างไรในสถานการณ์แพทย์จริง และส่งผลต่อการดูแลผู้ป่วยและประสิทธิภาพบริการสุขภาพจริงเพียงใด
มุมมองของ Shah เน้นความจำเป็นในการใช้ LLM ทางการแพทย์อย่างเหมาะกับงาน แทนที่จะใช้โมเดลอเนกประสงค์ที่ฝึกจากข้อมูลอินเทอร์เน็ตกว้างๆ เขาเสนอให้มุ่งฝึกด้วยข้อมูลทางการแพทย์ที่เฉพาะเจาะจงและเกี่ยวข้อง คล้ายการฝึกแพทย์ฝึกหัด โดยมอบหมายงานเฉพาะ กำกับดูแลผลงาน และค่อยๆ เพิ่มอิสระเมื่อแสดงความสามารถได้
การพัฒนา Meditron โดยนักวิจัย EPFL สอดคล้องกับแนวทางนี้ Meditron เป็น LLM โอเพนซอร์สที่ออกแบบสำหรับงานแพทย์โดยเฉพาะ ฝึกด้วยข้อมูลแพทย์ที่คัดสรรจากแหล่งน่าเชื่อถือ เช่น PubMed และแนวทางเวชปฏิบัติ จึงเป็นเครื่องมือที่ตรงกับงานมากขึ้นและอาจน่าเชื่อถือยิ่งขึ้นสำหรับบุคลากรแพทย์ ลักษณะโอเพนซอร์สสนับสนุนความโปร่งใส ความร่วมมือ การปรับปรุงอย่างต่อเนื่อง และการทดสอบภายใต้ภาวะกดดันโดยชุมชนนักวิจัยที่กว้างขึ้น

MEDITRON-70B มีความแม่นยำ 70.2% ในคำถามรูปแบบ USMLE ของชุดข้อมูล MedQA แบบ 4 ตัวเลือก
การพัฒนา Meditron, Med-PaLM 2 และเครื่องมืออื่นๆ สะท้อนการตระหนักถึงข้อกำหนดเฉพาะของภาคสุขภาพในการประยุกต์ AI การฝึกด้วยข้อมูลแพทย์ที่เกี่ยวข้องและมีคุณภาพสูง รวมถึงการรับรองความปลอดภัยและความน่าเชื่อถือในบริบทคลินิก เป็นเรื่องสำคัญอย่างยิ่ง
การรวมชุดข้อมูลที่หลากหลาย เช่น ข้อมูลจากบริบทด้านมนุษยธรรมของคณะกรรมการกาชาดระหว่างประเทศ ยังแสดงถึงการคำนึงถึงความต้องการและความท้าทายที่แตกต่างกันของบริการสุขภาพทั่วโลก สอดคล้องกับพันธกิจของศูนย์วิจัย AI หลายแห่งที่ต้องการสร้างเครื่องมือซึ่งก้าวหน้าทางเทคโนโลยี พร้อมมีความรับผิดชอบและเป็นประโยชน์ต่อสังคม
บทความวิจัยเรื่อง “Large language models encode clinical knowledge” ที่ตีพิมพ์ใน Nature สำรวจการใช้ LLM อย่างมีประสิทธิผลในบริบทคลินิก โดยนำเสนอข้อมูลเชิงลึกและวิธีการที่ช่วยให้เข้าใจทั้งความสามารถและข้อจำกัดของ LLM ทางการแพทย์
การแพทย์มีความซับซ้อนจากอาการ โรค และวิธีรักษาจำนวนมากที่เปลี่ยนแปลงอยู่เสมอ LLM จึงต้องทั้งเข้าใจความซับซ้อนนี้และติดตามความรู้และแนวทางทางการแพทย์ล่าสุด
แกนหลักของงานวิจัยคือเกณฑ์ประเมินใหม่ชื่อ MultiMedQA ซึ่งรวมชุดข้อมูลถามตอบทางการแพทย์เดิม 6 ชุดกับชุดข้อมูลใหม่ HealthSearchQA ที่รวบรวมคำถามสุขภาพซึ่งมักมีการค้นหาบนอินเทอร์เน็ต แนวทางนี้ประเมิน LLM หลายด้าน ทั้งความถูกต้องตามข้อเท็จจริง ความเข้าใจ การให้เหตุผล ความเสี่ยงที่จะก่ออันตราย และอคติ เพื่อแก้ข้อจำกัดของการประเมินอัตโนมัติเดิมที่ใช้เกณฑ์จำกัด
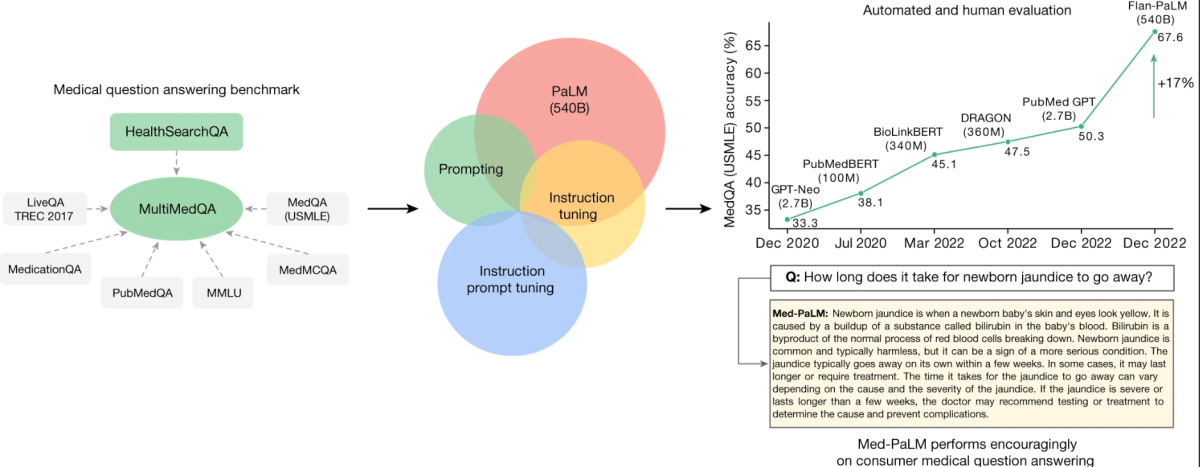
MultiMedQA เป็นเกณฑ์ประเมินการตอบคำถามทางการแพทย์ที่ครอบคลุมคำถามจากการสอบแพทย์
งานวิจัยประเมิน Pathways Language Model (PaLM) ซึ่งมีพารามิเตอร์ 540,000 ล้านตัว และ Flan-PaLM ซึ่งเป็นรุ่นที่ปรับด้วยคำสั่ง บน MultiMedQA โดย Flan-PaLM มีความแม่นยำระดับสูงสุดในขณะนั้นในชุดข้อมูลแบบปรนัยทุกชุดของ MultiMedQA รวมถึงความแม่นยำ 67.6% บน MedQA ที่มีคำถามรูปแบบการสอบใบอนุญาตแพทย์สหรัฐฯ บทความต้นฉบับระบุว่าผลงานนี้สูงกว่าสถิติเดิมมากกว่า 17%
MedQA
ชุดข้อมูล MedQA มีคำถามรูปแบบ USMLE ซึ่งแต่ละข้อมีตัวเลือก 4 หรือ 5 ตัวเลือก ชุดสำหรับการพัฒนามี 11,450 ข้อ และชุดทดสอบมี 1,273 ข้อ
รูปแบบ: คำถามและคำตอบ (Q + A) แบบปรนัย ในโดเมนเปิด
ตัวอย่างคำถาม: ชายอายุ 65 ปีที่มีความดันโลหิตสูงมาพบแพทย์เพื่อตรวจสุขภาพตามปกติ ยาที่ใช้อยู่คือ atenolol, lisinopril และ atorvastatin ชีพจร 86 ครั้งต่อนาที อัตราการหายใจ 18 ครั้งต่อนาที และความดันโลหิต 145/95 มิลลิเมตรปรอท การตรวจหัวใจพบเสียงฟู่ช่วงปลายระยะคลายตัว สาเหตุใดมีความเป็นไปได้มากที่สุดสำหรับสิ่งตรวจพบนี้?
คำตอบ (ตัวหนาคือคำตอบที่ถูกต้อง): (A) ความยืดหยุ่นในการขยายตัวของหัวใจห้องล่างซ้ายลดลง (B) การเสื่อมแบบมิกโซมาตัสของลิ้นไมตรัล (C) เยื่อหุ้มหัวใจอักเสบ (D) โคนหลอดเลือดแดงใหญ่ขยายตัว (E) แผ่นลิ้นไมตรัลหนาตัว
งานวิจัยยังพบช่องว่างสำคัญของความสามารถโมเดล โดยเฉพาะการตอบคำถามสุขภาพของประชาชน นักวิจัยจึงเสนอวิธี instruction prompt tuning ซึ่งปรับ LLM ให้เหมาะกับโดเมนใหม่ได้อย่างมีประสิทธิภาพด้วยตัวอย่างเพียงไม่กี่รายการ และนำไปสู่ Med-PaLM แม้ Med-PaLM แสดงผลที่น่าสนใจและดีขึ้นด้านความเข้าใจ การเรียกคืนความรู้ และการให้เหตุผล แต่ยังทำได้ด้อยกว่าแพทย์ผู้ดูแลผู้ป่วย
จุดสำคัญอีกประการคือกรอบการประเมินโดยมนุษย์อย่างละเอียด ซึ่งตรวจว่าคำตอบสอดคล้องกับฉันทามติทางวิทยาศาสตร์หรือไม่ และอาจนำไปสู่อันตรายหรือไม่ คำตอบแบบยาวของ Flan-PaLM สอดคล้องกับฉันทามติทางวิทยาศาสตร์เพียง 61.9% ขณะที่ Med-PaLM อยู่ที่ 92.6% ใกล้เคียงกับคำตอบที่แพทย์เขียน นอกจากนี้ ความเป็นไปได้ที่จะก่ออันตรายในคำตอบของ Med-PaLM ยังลดลงอย่างมากเมื่อเทียบกับ Flan-PaLM
การประเมินคำตอบ Med-PaLM โดยมนุษย์แสดงความสามารถหลายด้านที่ใกล้เคียงคำตอบของแพทย์ จึงสะท้อนศักยภาพในการเป็นเครื่องมือสนับสนุนงานคลินิก
เทคนิคและข้อสังเกตจากงานวิจัยนี้อาจนำไปปรับปรุง LLM ในโดเมนอื่นได้ ประเด็นสำคัญมีดังนี้
การปรับโมเดลด้วยคำสั่งช่วยเพิ่มประสิทธิภาพ
- การประยุกต์ทั่วไป: Instruction tuning คือการปรับแต่ง LLM ด้วยคำสั่งหรือแนวทางเฉพาะ ซึ่งแสดงให้เห็นว่าช่วยเพิ่มประสิทธิภาพในหลายโดเมน อาจนำไปใช้กับกฎหมาย การเงิน หรือการศึกษา เพื่อเพิ่มความถูกต้องและความเกี่ยวข้องของผลลัพธ์
การเพิ่มขนาดโมเดล
- ความหมายในวงกว้าง: ข้อสังเกตว่าการเพิ่มขนาดโมเดลช่วยเพิ่มประสิทธิภาพไม่ได้จำกัดอยู่ที่คำถามทางการแพทย์ โมเดลที่มีพารามิเตอร์มากขึ้นสามารถประมวลผลและสร้างคำตอบที่ละเอียดและซับซ้อนได้มากขึ้น จึงอาจมีประโยชน์ในงานบริการลูกค้า การเขียนเชิงสร้างสรรค์ และการสนับสนุนทางเทคนิค ซึ่งต้องเข้าใจรายละเอียดและสร้างคำตอบอย่างเหมาะสม
การให้พรอมต์แบบห่วงโซ่ความคิด (CoT)
- การใช้งานในโดเมนต่างๆ: แม้ CoT ไม่ได้เพิ่มประสิทธิภาพในชุดข้อมูลแพทย์เสมอไป แต่มีคุณค่าในงานที่ต้องแก้ปัญหาซับซ้อน เช่น การแก้ปัญหาทางเทคนิคหรือการตัดสินใจซับซ้อน โดยช่วยให้ LLM ประมวลผลข้อมูลทีละขั้น เพื่อให้คำตอบถูกต้องและมีเหตุผลมากขึ้น
ความสอดคล้องในตัวเองเพื่อเพิ่มความแม่นยำ
- การประยุกต์ในวงกว้าง: วิธี self-consistency สร้างผลลัพธ์หลายรายการแล้วเลือกคำตอบที่สอดคล้องกันมากที่สุด ซึ่งอาจเพิ่มประสิทธิภาพในหลายสาขา ในการเงินหรือกฎหมายที่ความแม่นยำสำคัญ วิธีนี้ช่วยตรวจสอบผลลัพธ์ไขว้เพื่อเพิ่มความน่าเชื่อถือ
ความไม่แน่นอนและการเลือกงดทำนาย
- ความเกี่ยวข้องข้ามโดเมน: การสื่อสารค่าประเมินความไม่แน่นอนสำคัญในงานที่ข้อมูลผิดอาจมีผลร้ายแรง เช่น สุขภาพและกฎหมาย การให้ LLM แสดงความไม่แน่นอนและงดทำนายเมื่อความมั่นใจต่ำอาจช่วยป้องกันการเผยแพร่ข้อมูลที่ไม่ถูกต้อง
การใช้งานจริงไม่ได้มีเพียงการตอบคำถาม แต่รวมถึงการให้ความรู้แก่ผู้ป่วย การช่วยกระบวนการวินิจฉัย และการฝึกนักศึกษาแพทย์ อย่างไรก็ตาม ต้องจัดการการนำไปใช้อย่างระมัดระวัง เพื่อหลีกเลี่ยงการพึ่ง AI โดยไม่มีมนุษย์กำกับดูแลอย่างเหมาะสม
เมื่อความรู้ทางการแพทย์เปลี่ยนแปลง LLM ก็ต้องปรับตัวและเรียนรู้ด้วย จึงจำเป็นต้องมีกลไกการเรียนรู้และการอัปเดตอย่างต่อเนื่อง เพื่อให้โมเดลยังเกี่ยวข้องกับงานและถูกต้องเมื่อเวลาผ่านไป


