
พื้นฐาน AI
โมเดลการเรียนรู้ของเครื่องแบบสำเร็จรูป vs. โมเดลที่กำหนดเอง

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การเลือกโซลูชันการเรียนรู้ของเครื่องมักไม่ใช่การตัดสินใจแบบซื้อเทียบสร้างอย่างง่าย ๆ ช่วงต่อเนื่องที่แท้จริงเริ่มตั้งแต่ API ที่โฮสต์หรือโมเดลที่จัดเตรียมไว้, ผ่านการสร้างพรอมต์, การดึงข้อมูลและการปรับจูน, ไปจนถึงสถาปัตยกรรมที่กำหนดเองอย่างเต็มรูปแบบที่ฝึกด้วยข้อมูลเฉพาะขององค์กร.
ทางเลือกที่ดีที่สุดคือวิธีที่ซับซ้อนน้อยที่สุดที่ตอบสนองต่อความต้องการของผลิตภัณฑ์ที่ได้รับการตรวจสอบ โมเดลที่กำหนดเองอาจให้การควบคุมและความแตกต่าง, แต่ก็ทำให้ต้องรับภาระต่อเนื่องในการดำเนินการสายข้อมูล, การประเมินผล, การตรวจสอบ, ความปลอดภัย, การอัปเดตและการย้อนกลับ.
ประเด็นสำคัญ
- เริ่มด้วยงานที่วัดผลได้, เกณฑ์พื้นฐานที่ไม่ใช้ ML และเกณฑ์การยอมรับ.
- ประเมินโมเดลผู้สมัครด้วยข้อมูลส่วนตัวที่เป็นตัวแทนแทนการพึ่งคะแนนมาตรฐานสาธารณะเพียงอย่างเดียว.
- รวมค่าใช้จ่ายการบูรณาการ, ความหน่วง, การตรวจสอบ, การฝึกซ้ำและเหตุการณ์ในต้นทุนการเป็นเจ้าของโดยรวม.
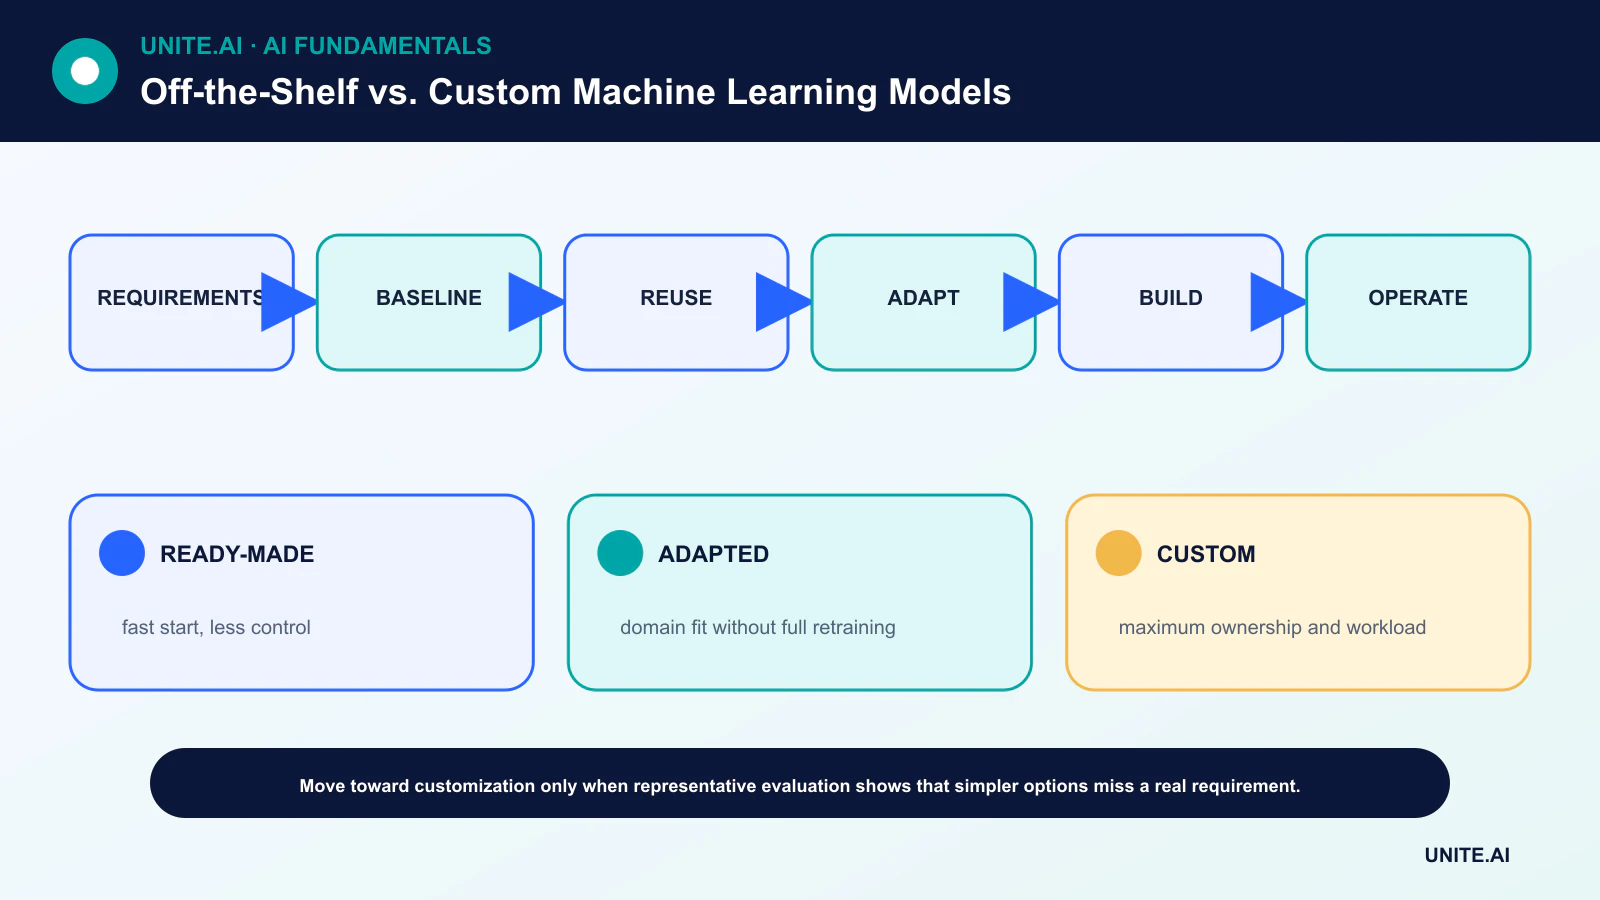
- ควรเลือกขั้นตอนที่สามารถย้อนกลับได้: เกณฑ์พื้นฐาน, ดึงข้อมูลหรือสร้างพรอมต์, ปรับจูน, แล้วจึงฝึกจากศูนย์เฉพาะเมื่อมีหลักฐานสนับสนุน.
กำหนดการตัดสินใจก่อนเลือกโมเดล
ระบุผู้ใช้, การตัดสินใจ, อินพุต, เอาต์พุต, ต้นทุนข้อผิดพลาด, งบประมาณความหน่วง, รูปแบบการจราจรและเส้นทางการขยายระดับ ตรวจสอบว่ากฎเชิงกำหนดหรือระบบค้นหาสามารถแก้ปัญหาได้เพียงพอหรือไม่ แนวทาง Rules of ML ของ Google แนะนำให้ใช้เกณฑ์พื้นฐานที่เรียบง่ายและโครงสร้างพื้นฐานที่เชื่อถือได้ก่อนการทำโมเดลที่ซับซ้อน.
สร้างชุดการประเมินออฟไลน์ที่สะท้อนการผลิต, รวมถึงกรณีที่หายากและการโจมตีแบบตรงกันข้าม เมื่อการตัดสินใจมีผลต่อผู้คน, กำหนดการตรวจสอบกลุ่มย่อยและกฎการตรวจสอบโดยมนุษย์ ประตูเหล่านี้ทำให้การเปรียบเทียบเป็นรูปธรรมแทนการทำให้การเลือกสถาปัตยกรรมกลายเป็นความชอบส่วนบุคคล.
ช่วงต่อเนื่องของการนำกลับมาใช้ใหม่และการปรับแต่ง
API ที่โฮสต์ให้การบูรณาการที่รวดเร็วและการขยายแบบจัดการ แต่ควบคุมภายในโมเดล, เวอร์ชันและการจัดการข้อมูลได้จำกัด โมเดลที่เปิดเผยและผ่านการฝึกล่วงหน้าช่วยเพิ่มการควบคุมการปรับใช้ การดึงข้อมูลหรือการสร้างพรอมต์ (prompt engineering) สามารถเพิ่มบริบทโดเมนโดยไม่ต้องเปลี่ยนค่าน้ำหนัก.
การปรับจูนหรืออะแดปเตอร์ที่มีประสิทธิภาพพารามิเตอร์สามารถทำให้พฤติกรรมเฉพาะเจาะจง การฝึกจากศูนย์เป็นเหตุผลเฉพาะเมื่อข้อมูล, วัตถุประสงค์, ขนาดหรือความต้องการด้านการเป็นเจ้าของไม่สามารถตอบสนองได้ผ่านการนำกลับมาใช้ใหม่ การเรียนรู้แบบถ่ายโอนมักจะจับคุณค่าส่วนใหญ่ด้วยข้อมูลและการประมวลผลที่น้อยกว่ามาก.
คุณภาพ, การควบคุมและการล็อกอิน
วัดคุณภาพของงาน, การปรับเทียบ, ความหน่วง, ปริมาณการทำงาน, ความพร้อมใช้งานและความสอดคล้องของความล้มเหลว โมเดลจากผู้ขายอาจปรับปรุงอัตโนมัติแต่ก็อาจเปลี่ยนพฤติกรรมได้; โมเดลที่โฮสต์เองสามารถตรึงไว้ได้แต่ต้องให้ทีมจัดการการอัปเกรดและช่องโหว่.
เงื่อนไขสัญญาควรครอบคลุมการเก็บรักษาข้อมูล, การใช้เพื่อการฝึก, การประมวลผลตามภูมิภาค, สิทธิ์ในทรัพย์สินทางปัญญา, ระดับการให้บริการ, เส้นทางการส่งออกและการยกเลิกการสนับสนุน ความสามารถในการพกพาจะดีขึ้นเมื่อแอปพลิเคชันแยกอะแดปเตอร์เฉพาะโมเดลออกจากตรรกะธุรกิจและเก็บบันทึกการประเมินที่ทำซ้ำได้.
ความเป็นส่วนตัว, ความปลอดภัยและการดำเนินงาน
ทำแผนที่การไหลของข้อมูลและขอบเขตภัยคุกคามทุกประการ อินพุตที่ละเอียดอ่อนอาจต้องการเครือข่ายส่วนตัว, การสรุปผลบนเครื่องหรือ edge AI การโฮสต์เองไม่ได้ทำให้ระบบปลอดภัยโดยอัตโนมัติ; มันโอนความรับผิดชอบด้านความปลอดภัยและการปฏิบัติตามกฎระเบียบให้กับผู้ดำเนินการ.
การเป็นเจ้าของการผลิตรวมถึงการสังเกต, การตรวจสอบการเปลี่ยนแปลง, การตรวจสอบการละเมิด, การตอบสนองต่อเหตุการณ์และการย้อนกลับ ทีมปฏิบัติการต้องสามารถตอบได้ว่าโมเดล, พรอมต์, เวอร์ชันข้อมูลและนโยบายใดที่สร้างผลลัพธ์.
ใช้หลักฐานเป็นขั้นตอน ไม่ใช่อุดมการณ์
ดำเนินการ benchmark ที่มีกรอบเวลากับชุดข้อมูลและเกณฑ์การยอมรับเดียวกันในทุกตัวเลือก ประเมินเวลาวิศวกรรม, การทำเครื่องหมาย, การใช้เครื่องเร่ง, ค่าธรรมเนียมผู้ขาย, แรงงานตรวจสอบ, ต้นทุนความล้มเหลวและจังหวะการเปลี่ยนแปลงที่คาดหวัง.
เลือกผู้สมัครที่ง่ายที่สุดที่ผ่านเกตแล้ว, จากนั้นประเมินใหม่เมื่อความต้องการหรือราคามีการเปลี่ยนแปลง การปรับแต่งมีคุณค่าเมื่อให้ประโยชน์ที่วัดได้หรือการควบคุมที่จำเป็น—not เพียงเพราะโมเดลที่ทำขึ้นเฉพาะดูเหมือนสำคัญเชิงกลยุทธ์.
ความต้องการและการเปรียบเทียบต้นทุนรวม
โมเดลแบบสำเร็จรูป, API หรือระบบที่จัดเตรียมไว้ให้มอบความสามารถที่สร้างไว้ล่วงหน้าพร้อมการสนับสนุนจากผู้ขายและการปรับใช้เริ่มต้นที่เร็วขึ้น โมเดลที่กำหนดเองถูกฝึกหรือปรับอย่างมากสำหรับงานเฉพาะ, ข้อมูลและสภาพแวดล้อมการทำงาน การเลือกเริ่มจากความต้องการ: ผลลัพธ์เป้าหมาย, คุณภาพตามกลุ่มย่อยและกรณีขอบ, ความหน่วง, ปริมาณการทำงาน, ความพร้อมใช้งาน, ความสามารถอธิบาย, การอยู่ของข้อมูล, การควบคุมการอัปเดต, การบูรณาการ, ความปลอดภัย, และผลลัพธ์ของความล้มเหลว การ benchmark หรือสาธิตทั่วไปไม่สามารถตอบได้ว่าผลิตภัณฑ์ตอบสนองความต้องการเหล่านั้นหรือไม่.
ต้นทุนรวมรวมถึงการประเมิน, การเตรียมข้อมูล, การทำเครื่องหมาย, การบูรณาการ, ไลเซนส์หรือการใช้งาน, โครงสร้างพื้นฐาน, การตรวจสอบ, การตรวจสอบ, การตอบสนองต่อเหตุการณ์, การอัปเกรดและการออกจากระบบ โมเดลสำเร็จรูปลดภาระวิศวกรรมเริ่มต้นแต่สามารถสร้างต้นทุนแปรผัน, การล็อกอิน, การเปลี่ยนแปลงพฤติกรรมและการสังเกตที่จำกัด การพัฒนาที่กำหนดเองเพิ่มความรับผิดชอบด้านข้อมูลและ MLOps และอาจยังพึ่งพาน้ำหนักที่ฝึกล่วงหน้าและผู้ขาย ต้นทุนโมเดลควรวัดต่อภารกิจที่สำเร็จที่มีคุณภาพตามที่ต้องการ, ไม่ใช่ต่อโทเคนหรือการฝึกครั้งเดียว.
การประเมิน, การจัดซื้อ, และการปรับแต่ง
สร้างชุดทดสอบส่วนตัวที่เป็นตัวแทนก่อนการเลือกผู้ขายและรันผู้สมัครทุกคนภายใต้พรอมต์, การเตรียมข้อมูล, เกณฑ์และขีดจำกัดการดำเนินการที่เหมือนกัน รวมกรณีที่คลุมเครือ, การโจมตี, ไม่รองรับ, หลายภาษา, และกรณีที่มีผลสำคัญสูง วัดความแม่นยำ, การปรับเทียบ, ความหน่วง, ต้นทุน, การปฏิเสธ, ความปลอดภัย, และผลกระทบต่อกระบวนการทำงานของมนุษย์ ทดสอบการหยุดทำงานของ API, ขีดจำกัดอัตรา, พฤติกรรมตามภูมิภาค, และการเปลี่ยนแปลงเวอร์ชัน การอ้างสิทธิ์ของผู้ขายต้องมีเอกสารเกี่ยวกับการฝึก, สิทธิ์, ความเป็นส่วนตัว, การเก็บรักษา, ผู้ประมวลผลย่อย, ความปลอดภัย, การสนับสนุน, และการแจ้งเหตุ.
ตัวเลือกการปรับแต่งมีสเปกตรัม: การกำหนดค่า, การดึงข้อมูล, การสร้างพรอมต์, การปรับจูน, การอัปเดตที่มีประสิทธิภาพพารามิเตอร์, ส่วนหัวแบบกำหนดเอง, หรือการฝึกจากศูนย์ ใช้วิธีที่ซับซ้อนน้อยที่สุดที่สอดคล้องกับหลักฐาน การดึงข้อมูลเหมาะสำหรับความรู้ที่เปลี่ยนแปลงบ่อย; การปรับจูนสามารถกำหนดรูปแบบหรือพฤติกรรมโดเมน; โค้ดเชิงกำหนดควรจัดการกฎที่แน่นอน ตรวจสอบระบบที่รวมกันเนื่องจากโมเดลฐานที่แข็งแกร่งอาจยังล้มเหลวจากการดึงข้อมูลที่ไม่ดี, สิทธิ์, หรือการบูรณาการ.
วงจรชีวิตและการวางแผนการออกจากระบบ
ผลิตภัณฑ์ที่โฮสต์อาจเปลี่ยนแปลงหรือหายไป, ในขณะที่โมเดลที่กำหนดเองกลายเป็นหนี้ทางเทคนิคหากไม่มีเจ้าของ ขึ้นอยู่กับเวอร์ชัน, ตรวจสอบพฤติกรรมและผลลัพธ์, กำหนดตัวกระตุ้นการฝึกซ้ำหรือการประเมินใหม่, และรักษาการย้อนกลับ เก็บรักษาข้อมูลและอินเทอร์เฟซที่จำเป็นสำหรับการย้าย, ต่อรองการลบและการส่งออก, และหลีกเลี่ยงการเปิดเผยสคีมาที่เป็นกรรมสิทธิ์ของผู้ขายหนึ่งตลอดแอปพลิเคชัน ตัวเลือกที่ดีที่สุดอาจเป็นแบบผสม: ความสามารถเชิงพาณิชย์สำหรับงานพื้นฐานและส่วนประกอบที่กำหนดเองเมื่อประสิทธิภาพโดเมน, การควบคุม, หรือความเสี่ยงสร้างคุณค่าที่ยั่งยืน.
ตัวอย่างการทำงาน: การเลือกโมเดลการสกัดเอกสาร
บริษัทสร้างชุดทดสอบส่วนตัวของใบแจ้งหนี้จากผู้จัดหา, ภาษาต่าง ๆ, การสแกน, การเขียนด้วยมือ, และกรณีขอบ, แล้วเปรียบเทียบ API ที่จัดการ, โมเดลที่เปิดเผยและผ่านการฝึกล่วงหน้า, โมเดลที่ปรับแต่ง, และเกณฑ์พื้นฐานแบบกฎ ระบบให้คะแนนความแม่นยำของฟิลด์, ความผิดพลาดทางการเงิน, เอกสารที่ไม่รองรับ, ความหน่วง, ปริมาณการทำงาน, ความเป็นส่วนตัว, การอยู่ของข้อมูล, การบูรณาการ, และต้นทุนต่อใบแจ้งหนี้ที่ประมวลผลอย่างถูกต้อง การสาธิตของผู้ขายและ benchmark สาธารณะไม่สามารถทดแทนการประเมินที่จับคู่นี้ได้.
แบบผสมที่เลือกใช้บริการ OCR เชิงพาณิชย์พร้อมการตรวจสอบภายในและการตรวจสอบโดยมนุษย์สำหรับความมั่นใจต่ำหรือจำนวนสูง สัญญากำหนดการเก็บรักษา, ผู้ประมวลผลย่อย, การอัปเดต, และการลบ; สถาปัตยกรรมรักษาไฟล์ต้นฉบับและเส้นทางการออกจากระบบ ช่วงเงาสังเกตพบช่องว่างของสคีมาและผู้จัดหา การตรวจสอบแยก OCR, การสกัด, การตรวจสอบ, และการแก้ไขของผู้ตรวจสอบ หากพฤติกรรมของผู้ขายเปลี่ยนแปลง ทีมสามารถหยุด, เปลี่ยน, หรือย้ายงานเพิ่มเติมไปยังส่วนประกอบที่กำหนดเองโดยไม่ต้องเขียนใหม่กระบวนการทางการเงิน.
หลักฐานการดำเนินการและความพร้อมใช้งาน
การตัดสินใจในระดับการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้ที่ตั้งใจ, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวที่สำคัญแต่ละรายการ สร้างเกณฑ์พื้นฐานที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับจูน ทดสอบกรณีทั่วไป, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของส่วนต่อขยาย, การใช้ผิดวัตถุประสงค์, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับบริการอย่างเพียงพอ วัดคุณภาพของงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วง, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่น่าสนใจ.
ก่อนการเปิดใช้งาน, มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การปล่อยแบบขั้นตอน, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการตรวจสอบด้วยการฉีดความล้มเหลวโดยเจตนา ระบบเทเลเมทรีการทำงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันโมเดลหรือกฎ, สถานะสุขภาพของส่วนต่อขยาย, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง, จากนั้นตรวจสอบหลักฐานจากโลกจริงหลังการปรับใช้แทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้ขาย, นโยบาย, ฮาร์ดแวร์, หรือวัตถุประสงค์มีการเปลี่ยนแปลง ระบบที่ดูแลรักษาต้องมีขั้นตอนการกู้คืนที่บันทึกไว้, การเรียนรู้จากเหตุการณ์, การลบและการเก็บรักษา, และจุดที่ชัดเจนว่าควรปิดใช้งานหรือแทนที่.
คำถามที่พบบ่อย
เมื่อใดที่ทีมควรฝึกโมเดลตั้งแต่ต้น?
เมื่อทางเลือกที่ผ่านการฝึกล่วงหน้าหรือโฮสต์ไม่สามารถตอบสนองความต้องการที่ตรวจสอบได้และทีมมีข้อมูลที่เป็นกรรมสิทธิ์, การประมวลผล, ความเชี่ยวชาญและความสามารถในการดำเนินงานระยะยาวเพียงพอ.
โมเดลแบบสำเร็จรูปปลอดการบำรุงรักษาได้หรือไม่?
ไม่. การบูรณาการ, การประเมิน, การเปลี่ยนแปลงเวอร์ชัน, การตรวจสอบ, การควบคุมความเป็นส่วนตัวและพฤติกรรมสำรองยังคงเป็นความรับผิดชอบของผู้นำไปใช้.
แหล่งอ้างอิงหลัก











