
Prompt engineering
ChatGPT และวิศวกรรมพรอมต์ขั้นสูง: ขับเคลื่อนวิวัฒนาการ AI

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญเทคนิคทางวิศวกรรมพร็อมต์ขั้นสูง เช่น ReAct และ chain-of-thought…
ดูเพิ่มเติม
- เทคนิคทางวิศวกรรมพร็อมต์ขั้นสูง เช่น ReAct และ chain-of-thought มีความสำคัญอย่างยิ่งในการลดการหลอนของ AI และปรับปรุงการให้เหตุผล
- พร็อมต์ที่กำหนดไว้อย่างดีเป็นสิ่งจำเป็นสำหรับการควบคุมคุณภาพผลลัพธ์ของ ChatGPT และรับประกันการตอบสนองที่เกี่ยวข้องและเป็นมิตรกับผู้ใช้
- การเรียนรู้แบบฟิวช็อตช่วยให้โมเดลอย่าง GPT-3 ปรับตัวกับงานใหม่ได้โดยไม่ต้องใช้การปรับแต่งอย่างละเอียดหรือชุดข้อมูลที่กำหนดเองซึ่งมีค่าใช้จ่ายสูง
OpenAI ได้พัฒนาเครื่องมือที่ปฏิวัติวงการ เช่น OpenAI Gym ซึ่งออกแบบมาเพื่อฝึกอบรมอัลกอริทึมการเรียนรู้แบบเสริมกำลัง และโมเดล GPT-n นอกจากนี้ DALL-E ยังเป็นโมเดล AI ที่สร้างภาพจากข้อความ โมเดลหนึ่งที่ได้รับความสนใจอย่างมากคือ ChatGPT ของ OpenAI ซึ่งเป็นตัวอย่างที่ดีเยี่ยมในด้านโมเดลภาษาขนาดใหญ่
GPT-4: วิศวกรรมพรอมต์
ChatGPT ได้เปลี่ยนแปลงภูมิทัศน์ของแชทบอท โดยให้คำตอบที่เหมือนมนุษย์ต่อการป้อนข้อมูลของผู้ใช้ และขยายการประยุกต์ใช้ไปทั่วหลายโดเมน ตั้งแต่การพัฒนาและทดสอบซอฟต์แวร์ ไปจนถึงการสื่อสารทางธุรกิจ และแม้กระทั่งการสร้างบทกวี
ในมือของธุรกิจและบุคคล GPT-4 สามารถทำหน้าที่เป็นแหล่งข้อมูลความรู้ที่ไม่มีที่สิ้นสุด ซึ่งมีความเชี่ยวชาญในหัวข้อต่างๆ ตั้งแต่คณิตศาสตร์และชีววิทยา ไปจนถึงการเรียนกฎหมาย โมเดล AI ที่ซับซ้อนและเข้าถึงได้เหล่านี้มีศักยภาพที่จะเปลี่ยนแปลงอนาคตของการทำงาน การเรียนรู้ และความคิดสร้างสรรค์

โมเดลที่สร้างข้อมูลใหม่ เช่น GPT-4 สามารถสร้างข้อมูลใหม่ตามข้อมูลที่มีอยู่แล้ว คุณสมบัตินี้ทำให้พวกมันสามารถทำหน้าที่ต่างๆ ได้ รวมถึงการสร้างข้อความ ภาพ เพลง และวิดีโอ
ในบริบทของ ChatGPT และโมเดล OpenAI พรอมต์คือข้อมูลที่ผู้ใช้ให้ไว้สำหรับโมเดล โดยทั่วไปในรูปแบบข้อความ พรอมต์เป็นวิธีการหลักในการควบคุมผลลัพธ์ของโมเดลเหล่านี้ ทำให้พวกมันสำคัญสำหรับการสนทนาที่ประสบความสำเร็จและเกี่ยวข้อง
ผลกระทบของคุณภาพพรอมต์
การใช้คำสั่งที่กำหนดไว้ดีเป็นกุญแจสำคัญในการมีส่วนร่วมในการสนทนาที่มีประโยชน์และมีความหมายกับระบบ AI คำสั่งที่ไม่ได้กำหนดไว้ดีอาจส่งผลให้ผลลัพธ์ที่ไม่มีประโยชน์ต่อผู้ใช้และอาจนำไปสู่เนื้อหาที่ทำให้เข้าใจผิด
เพื่อแสดงผลกระทบของคุณภาพพรอมต์ มาทำการเปรียบเทียบสองคำสั่งที่แตกต่างกันที่ให้ไว้กับ ChatGPT คำสั่งแรกที่ไม่ได้กำหนดไว้ดีและสมมติว่ามีความรู้ล่วงหน้าจะสร้างคำตอบที่อาจไม่มีประโยชน์ต่อผู้ใช้ ในทางกลับกัน คำสั่งที่สองที่ให้ข้อมูลเพิ่มเติมและตัวอย่างจะช่วยให้ได้คำตอบที่เกี่ยวข้องและเข้าใจได้ง่าย
คำสั่ง 1: “บอกฉันเกี่ยวกับ Convolutional Neural Networks”
คำตอบ 1: “Convolutional Neural Networks (CNNs) เป็นเครือข่ายเพอร์เซปตรอนหลายชั้น ซึ่งประกอบด้วยชั้นที่เชื่อมต่ออย่างสมบูรณ์และชั้นการรวมกลุ่ม พวกมันถูกใช้ในการรับรู้ภาพโดยทั่วไป กระบวนการเกี่ยวข้องกับการใช้ฟิลเตอร์กับภาพเข้าและลดขนาดโดยใช้ชั้นการรวมกลุ่ม”
คำสั่ง 2: “ฉันอยากเรียนรู้เกี่ยวกับ Convolutional Neural Networks แต่ฉันไม่มีความรู้ล่วงหน้าเกี่ยวกับเครือข่ายประสาทเทียม ฉันขอให้คุณให้คำอธิบายที่เหมาะสำหรับผู้เริ่มต้นและตัวอย่างของวิธีการใช้ CNN ในการรับรู้ภาพ”
คำตอบ 2: “Convolutional Neural Networks (CNNs) เป็นประเภทหนึ่งของเครือข่ายประสาทเทียมที่ใช้หลักในการรับรู้ภาพ ต่างจากเครือข่ายประสาทเทียมอื่น ๆ พวกมันใช้ชั้นคอนโวลูชันและชั้นพูลลิงเพื่อประมวลผลภาพ ลองนึกภาพว่าคุณมีภาพของแมว CNN สามารถระบุคุณสมบัติต่างๆ ในภาพ เช่น หนวด หู และหาง โดยใช้ฟิลเตอร์และการลดขนาดโดยใช้ชั้นการรวมกลุ่ม กระบวนการนี้ทำให้ CNN มีประสิทธิภาพสูงในการรับรู้วัตถุในภาพ”
เมื่อเปรียบเทียบสองคำตอบ จะเห็นได้ชัดว่าคำสั่งที่กำหนดไว้ดีนำไปสู่คำตอบที่เกี่ยวข้องและเหมาะสมกว่า การออกแบบและวิศวกรรมคำสั่งเป็นสาขาที่เติบโตขึ้นซึ่งมีจุดมุ่งหมายเพื่อปรับปรุงคุณภาพผลลัพธ์ของโมเดล AI เช่น ChatGPT
ในบทความต่อไปนี้ เราจะสำรวจวิธีการที่ซับซ้อนในการปรับปรุงโมเดลภาษาขนาดใหญ่ (LLMs) เช่น เทคนิคการวิศวกรรมพรอมต์และยุทธวิธี รวมถึงการเรียนรู้แบบ few-shot, ReAct, chain-of-thought, RAG และอื่นๆ
เทคนิคการวิศวกรรมขั้นสูง
ก่อนที่เราจะดำเนินต่อไป มันเป็นเรื่องสำคัญที่จะต้องเข้าใจปัญหาหนึ่งที่เกิดขึ้นกับ LLMs ซึ่งเรียกว่า ‘การสร้างข้อมูลหลอน’ ในบริบทของ LLMs ‘การสร้างข้อมูลหลอน’ หมายถึงความสามารถของโมเดลในการสร้างผลลัพธ์ที่ดูสมเหตุสมผล แต่ไม่ได้มาจากความเป็นจริงหรือบริบทที่ให้มา
ปัญหานี้ได้รับการเน้นย้ำในคดีศาลล่าสุด ซึ่ง ทนายฝ่ายจำเลยใช้ ChatGPT สำหรับการวิจัยทางกฎหมาย เครื่องมือ AI นี้ล้มเหลวเนื่องจากปัญหาเรื่องการสร้างข้อมูลหลอน โดยอ้างถึงคดีทางกฎหมายที่ไม่มีอยู่จริง ซึ่งส่งผลกระทบอย่างมีนัยสำคัญและทำให้เสียความน่าเชื่อถือระหว่างการดำเนินคดี เหตุการณ์นี้เป็นคำเตือนอย่างรุนแรงเกี่ยวกับความจำเป็นในการแก้ไขปัญหาการสร้างข้อมูลหลอนในระบบ AI
การสำรวจของเราที่เกี่ยวข้องกับเทคนิคการวิศวกรรมคำสั่งมุ่งหวังที่จะปรับปรุงด้านเหล่านี้ของ LLMs โดยการเพิ่มประสิทธิภาพและความปลอดภัยของพวกมัน เราเปิดโอกาสให้ใช้การประยุกต์ใหม่ๆ เช่น การดึงข้อมูล นอกจากนี้ยังเปิดโอกาสให้เชื่อมต่อ LLMs กับเครื่องมือและแหล่งข้อมูลภายนอกได้อย่างราบรื่น ทำให้ขยายพิสัยของการใช้งานที่เป็นไปได้
การเรียนรู้แบบ Zero และ Few-Shot: การปรับให้เหมาะสมด้วยตัวอย่าง
Generative Pretrained Transformers (GPT-3) เป็นจุดเปลี่ยนสำคัญในการพัฒนาโมเดล AI ที่สร้างข้อมูลใหม่ โดยการแนะนำแนวคิด ‘การเรียนรู้แบบ few-shot’ วิธีการนี้เป็นจุดเปลี่ยนเพราะทำงานได้อย่างมีประสิทธิภาพโดยไม่ต้องปรับจูนอย่างครอบคลุม กรอบ GPT-3 อธิบายในบทความ Language Models are Few Shot Learners ซึ่งผู้เขียนแสดงว่าโมเดลทำงานได้ดีในกรณีใช้งานหลากหลายโดยไม่ต้องใช้ชุดข้อมูลหรือโค้ดเฉพาะ
ต่างจากการปรับจูนที่ต้องใช้ความพยายามต่อเนื่องเพื่อแก้กรณีใช้งานต่าง ๆ โมเดล few-shot ปรับตัวเข้ากับงานหลากหลายได้ง่ายกว่า แม้การปรับจูนจะให้โซลูชันที่แข็งแกร่งในบางกรณี แต่เมื่อขยายขนาดอาจมีค่าใช้จ่ายสูง การใช้โมเดล few-shot จึงอาจเหมาะกว่า โดยเฉพาะเมื่อผสานกับวิศวกรรมพรอมต์
ลองนึกภาพว่าคุณพยายามแปลภาษาอังกฤษเป็นภาษาฝรั่งเศส ในการเรียนรู้แบบ few-shot คุณจะให้ GPT-3 ตัวอย่างการแปล เช่น “sea otter -> loutre de mer” GPT-3 ซึ่งเป็นโมเดลที่ซับซ้อน จะสามารถให้การแปลที่ถูกต้องต่อไปได้ ในการเรียนรู้แบบ zero-shot คุณจะไม่ให้ตัวอย่างใดๆ และ GPT-3 ก็ยังสามารถแปลภาษาอังกฤษเป็นภาษาฝรั่งเศสได้อย่างมีประสิทธิภาพ
คำว่า ‘การเรียนรู้แบบ few-shot’ มาจากแนวคิดที่ว่าโมเดลได้รับตัวอย่างจำนวนจำกัดเพื่อ ‘เรียนรู้’ มันไม่เกี่ยวข้องกับการอัปเดตพารามิเตอร์หรือน้ำหนักของโมเดล แต่ส่งผลต่อประสิทธิภาพของโมเดล

การเรียนรู้แบบ Few-Shot จาก GPT-3 Paper
การเรียนรู้แบบ zero-shot นำแนวคิดนี้ไปสู่ขั้นต่อไป โดยไม่ให้ตัวอย่างการทำงานใดๆ กับโมเดล โมเดลคาดหวังที่จะทำงานได้ดีตามการฝึกอบรมเบื้องต้น ทำให้วิธีการนี้เหมาะสำหรับการตอบคำถามในโดเมนที่เปิดกว้าง เช่น ChatGPT
ในหลายกรณี โมเดลที่เชี่ยวชาญในการเรียนรู้แบบ zero-shot สามารถทำงานได้ดีเมื่อให้ตัวอย่าง few-shot หรือแม้กระทั่ง single-shot การเปลี่ยนแปลงระหว่างการเรียนรู้แบบ zero-shot, single-shot และ few-shot แสดงให้เห็นถึงความสามารถในการปรับตัวของโมเดลขนาดใหญ่ ซึ่งเพิ่มพิสัยของการใช้งานในโดเมนต่างๆ
วิธีการเรียนรู้แบบ zero-shot กำลังเป็นที่นิยมมากขึ้น วิธีการเหล่านี้มีลักษณะเฉพาะในการรับรู้วัตถุที่ไม่เคยเห็นระหว่างการฝึกอบรม ต่อไปนี้คือตัวอย่างการเรียนรู้แบบ few-shot:
แปลภาษาอังกฤษต่อไปนี้เป็นภาษาฝรั่งเศส:
'sea otter' แปลเป็น 'loutre de mer'
'sky' แปลเป็น 'ciel'
คำว่า 'cloud' แปลเป็นภาษาฝรั่งเศสคืออะไร?"
โดยการให้โมเดลตัวอย่างและตั้งคำถาม เราสามารถชี้นำโมเดลให้สร้างผลลัพธ์ที่ต้องการได้ ในกรณีนี้ GPT-3 มีแนวโน้มที่จะแปล ‘cloud’ เป็น ‘nuage’ ในภาษาฝรั่งเศสได้อย่างถูกต้อง
เราจะสำรวจความซับซ้อนของเทคนิคการวิศวกรรมคำสั่งในโมเดล GPT ต่อไป และบทบาทที่สำคัญในการปรับปรุงประสิทธิภาพของโมเดลระหว่างการอนุมาน เราจะดูวิธีการใช้เทคนิคเหล่านี้เพื่อสร้างโซลูชันที่คุ้มค่าและขยายขนาดได้ในการใช้งานต่างๆ
ในการสำรวจเทคนิควิศวกรรมพรอมต์ของ GPT ให้ลึกขึ้น ควรกล่าวถึงบทความก่อนหน้า คู่มือพื้นฐานวิศวกรรมพรอมต์ใน ChatGPT ซึ่งให้กลยุทธ์สั่งโมเดล AI อย่างมีประสิทธิภาพในกรณีใช้งานหลากหลาย
ในบทความก่อนหน้านี้ เราได้กล่าวถึงเทคนิคการวิศวกรรมคำสั่งพื้นฐานสำหรับโมเดลภาษาขนาดใหญ่ เช่น การเรียนรู้แบบ zero-shot และ few-shot เช่นเดียวกับการส่งคำสั่ง การเชี่ยวชาญในเทคนิคเหล่านี้เป็นสิ่งจำเป็นสำหรับการเผชิญกับความท้าทายที่ซับซ้อนของการวิศวกรรมคำสั่งที่เราจะสำรวจที่นี่
การเรียนรู้แบบ few-shot อาจมีข้อจำกัดเนื่องจากหน้าต่างบริบทที่จำกัดของ LLMs ส่วนใหญ่ นอกจากนี้ หากไม่มีการป้องกันที่เหมาะสม LLMs อาจถูกหลอกให้สร้างผลลัพธ์ที่อาจเป็นอันตรายได้ นอกจากนี้ โมเดลจำนวนมากยังมีปัญหากับงานให้เหตุผลหรือการทำตามคำสั่งหลายขั้นตอน
จากข้อจำกัดเหล่านี้ ความท้าทายคือการใช้ LLM แก้งานซับซ้อน การพัฒนาโมเดลที่ก้าวหน้าขึ้นหรือปรับปรุงโมเดลเดิมอาจเป็นคำตอบ แต่ต้องใช้ความพยายามมาก คำถามจึงอยู่ที่ว่าจะเพิ่มความสามารถแก้ปัญหาของโมเดลปัจจุบันอย่างไร
การเรียนรู้แบบ few-shot ยังสามารถใช้ได้กับการใช้งานสร้างสรรค์ เช่น ใน ‘Mastering AI Art: A Concise Guide to Midjourney and Prompt Engineering‘ ของ Unite AI ซึ่งอธิบายว่าการผสมผสานศิลปะและ AI สามารถสร้างผลงานศิลปะที่น่าประทับใจได้
การเรียกใช้แบบ Chain-of-Thought
การเรียกใช้แบบ chain-of-thought ใช้ประโยชน์จากคุณสมบัติออโตรีเกรสซีฟของโมเดลภาษาขนาดใหญ่ ซึ่งสามารถคาดการณ์คำถัดไปในลำดับได้ โดยการกระตุ้นให้โมเดลอธิบายกระบวนการคิดของมัน จะทำให้เกิดการสร้างความคิดที่ครอบคลุมและเป็นระบบมากขึ้น ซึ่งมักสอดคล้องกับข้อมูลที่ถูกต้อง ความสอดคล้องนี้มาจากแนวโน้มของโมเดลที่จะประมวลและนำเสนอข้อมูลอย่างไตร่ตรองและเป็นลำดับ คล้ายผู้เชี่ยวชาญที่อธิบายแนวคิดซับซ้อนให้ผู้ฟังทีละขั้น
การเรียกใช้แบบ chain-of-thought นั้นง่ายเหมือนการบอกโมเดลว่า “อธิบายให้ฉันฟังทีละขั้นตอนว่าคุณคิดอย่างไร…”
การเรียกใช้แบบ Zero-Shot Chain-of-Thought
ในขณะที่การเรียกใช้แบบ chain-of-thought แบบดั้งเดิมต้องการการฝึกอบรมล่วงหน้าด้วยตัวอย่าง การเรียกใช้แบบ zero-shot chain-of-thought เป็นแนวทางใหม่ที่แนะนำโดย Kojima et al. (2022) โดยการเพิ่มประโยค “มาคิดทีละขั้นตอนกัน” เข้ากับคำสั่งเดิม
ลองสร้างคำสั่งที่ซับซ้อนโดยให้ ChatGPT สรุปประเด็นสำคัญจากงานวิจัย AI และ NLP
ในตัวอย่างนี้ เราจะใช้ความสามารถของโมเดลในการเข้าใจและสรุปข้อมูลที่ซับซ้อนจากข้อความวิชาการ โดยใช้การเรียนรู้แบบ few-shot เราจะสอน ChatGPT ให้สรุปประเด็นสำคัญจากงานวิจัย AI และ NLP
1. ชื่อเรื่อง: "Attention Is All You Need"
ประเด็นสำคัญ: แนะนำโมเดล Transformer โดยเน้นย้ำถึงความสำคัญของกลไกการให้ความสนใจเหนือชั้นการเกิดซ้ำสำหรับงานส่งผ่านลำดับ
2. ชื่อเรื่อง: "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding"
ประเด็นสำคัญ: แนะนำ BERT โดยแสดงผลที่ดีเยี่ยมของการฝึกอบรมล่วงหน้าของโมเดลที่มีทิศทางสองทางลึกสำหรับการทำความเข้าใจภาษา
ด้วยบริบทของตัวอย่างเหล่านี้ สรุปประเด็นสำคัญจากงานวิจัยต่อไปนี้:
ชื่อเรื่อง: "Prompt Engineering in Large Language Models: An Examination"
คำสั่งนี้ไม่เพียงแต่ทำให้เกิดการเรียกใช้แบบ chain-of-thought ที่ชัดเจน แต่ยังใช้การเรียนรู้แบบ few-shot เพื่อชี้นำโมเดลให้ทำการดำเนินการที่ซับซ้อนซึ่งเกี่ยวข้องกับการวิศวกรรมคำสั่ง: การสรุปงานวิจัย
ReAct Prompt
ReAct หรือ “Reason and Act” ถูกแนะนำโดย Google (GOOGL ) ในงานวิจัย “ReAct: Synergizing Reasoning and Acting in Language Models” และปฏิวัติวิธีการที่โมเดลภาษาสื่อสารกับงาน โดยกระตุ้นให้โมเดลสร้างทั้งการให้เหตุผลเชิงภาษาและการกระทำที่เกี่ยวข้องกับงาน
ลองนึกภาพว่าคุณเป็นเชฟในครัว: คุณไม่เพียงแต่ทำซีรีส์ของการกระทำ (ตัดผัก, ต้มน้ำ, คนผสม) แต่ยังเข้าไปในเหตุผลเชิงภาษาหรือการคิดภายใน (“ทีนี้ที่ผักถูกตัดแล้ว ฉันควรใส่หม้อบนเตา”) การคิดนี้ช่วยในการวางแผนกระบวนการ, ปรับตัวให้เข้ากับการเปลี่ยนแปลง (“ฉันไม่มีน้ำมันมะกอก ฉันจะใช้เนยแทน”) และจดจำลำดับการกระทำ React มีปฏิสัมพันธ์เช่นเดียวกับความสามารถของมนุษย์ ทำให้โมเดลสามารถเรียนรู้งานใหม่ๆ และตัดสินใจได้อย่างมั่นใจภายใต้สภาพแวดล้อมใหม่หรือไม่แน่นอน
React สามารถจัดการกับปัญหาการสร้างข้อมูลหลอน ซึ่งเป็นปัญหาทั่วไปของระบบ Chain-of-Thought (CoT) CoT แม้จะเป็นเทคนิคที่มีประสิทธิภาพ แต่ขาดความสามารถในการโต้ตอบกับโลกภายนอก ซึ่งอาจนำไปสู่การสร้างข้อมูลหลอนและการแพร่กระจายข้อผิดพลาด React ชดเชยด้วยการโต้ตอบกับแหล่งข้อมูลภายนอก ทำให้ระบบสามารถตรวจสอบการให้เหตุผลและอัปเดตความรู้ตามข้อมูลล่าสุดจากโลกภายนอก
การทำงานพื้นฐานของ React สามารถอธิบายผ่านตัวอย่างจาก HotpotQA ซึ่งเป็นงานที่ต้องใช้เหตุผลสูง เมื่อได้รับคำถาม React จะแบ่งคำถามออกเป็นส่วนๆ และสร้างแผนการกระทำ โมเดลจะสร้างการให้เหตุผล (ความคิด) และระบุการกระทำที่เกี่ยวข้อง อาจตัดสินใจที่จะค้นหาข้อมูลเกี่ยวกับ Apple (AAPL ) Remote จากแหล่งข้อมูลภายนอก เช่น วิกิพีเดีย (การกระทำ) และอัปเดตความเข้าใจตามข้อมูลที่ได้รับ (การสังเกต) ผ่านกระบวนการคิด-การกระทำ-การสังเกตหลายครั้ง ReAct สามารถค้นหาข้อมูลเพื่อสนับสนุนการให้เหตุผลและปรับให้เหมาะสมสิ่งที่ต้องค้นหาในครั้งถัดไป
หมายเหตุ: HotpotQA เป็นชุดข้อมูลจากวิกิพีเดีย มีคู่คำถาม-คำตอบ 113,000 คู่เพื่อฝึกการให้เหตุผลซับซ้อน โดยต้องใช้หลายเอกสารเพื่อตอบ ส่วน CommonsenseQA 2.0 สร้างผ่านกระบวนการแบบเกม มีคำถามใช่หรือไม่ 14,343 ข้อเพื่อท้าทายความเข้าใจสามัญสำนึก โดยตั้งใจสร้างคำถามให้โมเดลหลงทาง
กระบวนการอาจดูเหมือนดังนี้:
- ความคิด: “ฉันต้องค้นหาเกี่ยวกับ Apple Remote และอุปกรณ์ที่เข้ากันได้”
- การกระทำ: ค้นหา “อุปกรณ์ที่เข้ากันได้กับ Apple Remote” จากแหล่งข้อมูลภายนอก
- การสังเกต: ได้รับรายการอุปกรณ์ที่เข้ากันได้กับ Apple Remote จากผลการค้นหา
- ความคิด: “ตามผลการค้นหา อุปกรณ์หลายตัว นอกเหนือจาก Apple Remote สามารถควบคุมโปรแกรมที่ออกแบบมาให้โต้ตอบกับ Apple Remote ได้”
ผลลัพธ์คือกระบวนการที่มีเหตุผลและสามารถพัฒนาได้ตามข้อมูลที่โต้ตอบ ซึ่งนำไปสู่ผลลัพธ์ที่แม่นยำและเชื่อถือได้มากขึ้น

การเปรียบเทียบการแสดงภาพของวิธีการกระตุ้นที่แตกต่างกันสี่วิธี – Standard, Chain-of-Thought, Act-Only และ ReAct ในการแก้ปัญหา HotpotQA และ AlfWorld (https://arxiv.org/pdf/2210.03629.pdf)
การออกแบบตัวแทน ReAct เป็นงานที่ซับซ้อนเนื่องจากความสามารถในการบรรลุเป้าหมายที่ซับซ้อน ตัวอย่างเช่น ตัวแทนการสนทนา สร้างขึ้นจากโมเดล ReAct พื้นฐาน โดยรวมความทรงจำการสนทนาเพื่อให้เกิดปฏิสัมพันธ์ที่มีคุณภาพสูง อย่างไรก็ตาม ความซับซ้อนของงานนี้ได้รับการช่วยเหลือจากเครื่องมือ เช่น Langchain ซึ่งกลายเป็นมาตรฐานในการออกแบบตัวแทนเหล่านี้
การกระตุ้นที่ซื่อสัตย์ต่อบริบท
งานวิจัย ‘การกระตุ้นที่ซื่อสัตย์ต่อบริบทสำหรับโมเดลภาษาขนาดใหญ่‘ เน้นย้ำว่าแม้ว่าโมเดลภาษาขนาดใหญ่จะแสดงความสำเร็จที่สำคัญในงาน NLP ที่ขับเคลื่อนด้วยความรู้ แต่การอาศัยความรู้แบบพารามิเตอร์มากเกินไปสามารถทำให้พวกมันหลงทางในงานที่ไวต่อบริบทได้ ตัวอย่างเช่น เมื่อโมเดลภาษาได้รับการฝึกอบรมด้วยข้อมูลที่ล้าสมัย มันสามารถสร้างคำตอบที่ไม่ถูกต้องหากมันละเลยสัญญาณบริบท
ปัญหานี้เห็นได้ชัดในกรณีที่มีความขัดแย้งทางความรู้ เมื่อบริบทมีข้อเท็จจริงที่แตกต่างจากความรู้ที่มีอยู่ก่อนหน้าของโมเดลภาษา ลองพิจารณากรณีที่โมเดลภาษาขนาดใหญ่ (LLM) ที่ได้รับการฝึกอบรมด้วยข้อมูลก่อนการแข่งขันฟุตบอลโลก 2022 ได้รับบริบทที่บ่งบอกว่าฝรั่งเศสชนะการแข่งขัน แต่ LLM ยังคงยืนยันว่าทีมที่ชนะการแข่งขันฟุตบอลโลก 2018 ยังคงเป็นแชมป์ปัจจุบัน ซึ่งเป็นตัวอย่างคลาสสิกของ ‘ความขัดแย้งทางความรู้’
ในความเป็นจริง ความขัดแย้งทางความรู้ใน LLM เกิดขึ้นเมื่อข้อมูลใหม่ที่ให้ไว้ในบริบทขัดแย้งกับความรู้ที่มีอยู่ก่อนหน้าของโมเดล ความโน้มเอียงของโมเดลที่จะพึ่งพาความรู้ก่อนหน้ามากกว่าบริบทที่ให้ใหม่ๆ อาจนำไปสู่ผลลัพธ์ที่ไม่ถูกต้อง ส่วนการสร้างข้อมูลหลอนคือการสร้างคำตอบที่ดูเป็นไปได้แต่ไม่มีพื้นฐานในข้อมูลฝึกหรือบริบทที่ให้
อีกปัญหาหนึ่งเกิดขึ้นเมื่อบริบทที่ให้ไม่มีข้อมูลเพียงพอในการตอบคำถามได้อย่างถูกต้อง ซึ่งเรียกว่า ‘การทำนายพร้อมทางเลือกงดตอบ’ ตัวอย่างเช่น หาก LLM ถูกถามเกี่ยวกับคนก่อตั้ง Microsoft (MSFT ) แต่บริบทไม่มีข้อมูลนี้ มันควรจะงดตอบมากกว่าที่จะเดา
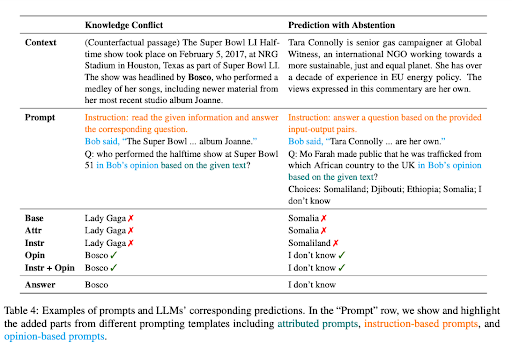
ตัวอย่างความขัดแย้งทางความรู้และพลังของการงดตอบ
เพื่อปรับปรุงความซื่อสัตย์ต่อบริบทของ LLMs ในสถานการณ์เหล่านี้ นักวิจัยได้เสนอกลยุทธ์การกระตุ้นหลายอย่าง กลยุทธ์เหล่านี้มีจุดมุ่งหมายเพื่อให้ผลลัพธ์ของ LLMs มีความสอดคล้องกับบริบทมากกว่าการพึ่งพาความรู้ที่ฝังไว้
หนึ่งในกลยุทธ์คือการวางคำถามในรูปแบบที่อิงความคิดเห็น โดยที่บริบทถูกตีความว่าเป็นคำกล่าวของนักเล่าเรื่อง และคำถามเกี่ยวข้องกับความคิดเห็นของผู้เล่าเรื่องนั้น วิธีการนี้ช่วยให้ LLMs มุ่งความสนใจไปที่บริบทที่ให้ไว้มากกว่าการอาศัยความรู้ที่มีอยู่ก่อนหน้า
การเพิ่มตัวอย่างสมมติที่ขัดกับข้อเท็จจริงเข้าไปในคำสั่งยังถูกพบว่าเป็นวิธีที่มีประสิทธิภาพในการเพิ่มความซื่อสัตย์ต่อบริบทในกรณีที่มีความขัดแย้งทางความรู้ การแสดงตัวอย่างเหล่านี้นำเสนอสถานการณ์ที่มีข้อเท็จจริงที่เป็นเท็จ ซึ่งช่วยให้โมเดลให้ความสนใจกับบริบทเพื่อให้คำตอบที่ถูกต้อง
การปรับให้เหมาะสมด้วยคำสั่ง
การปรับให้เหมาะสมด้วยคำสั่งเป็นระยะการเรียนรู้แบบมีผู้สอนซึ่งใช้ประโยชน์จากการให้คำสั่งเฉพาะแก่โมเดล ตัวอย่างเช่น “อธิบายความแตกต่างระหว่างพระอาทิตย์ขึ้นและพระอาทิตย์ตก” คำสั่งนี้จับคู่กับคำตอบที่เหมาะสม เช่น “พระอาทิตย์ขึ้นหมายถึงช่วงเวลาที่ดวงอาทิตย์ปรากฏเหนือเส้นขอบฟ้าในตอนเช้า ในขณะที่พระอาทิตย์ตกหมายถึงช่วงเวลาที่ดวงอาทิตย์ลับขอบฟ้าในตอนเย็น” โดยการเรียนรู้จากคำสั่งเหล่านี้ โมเดลจะเรียนรู้วิธีการปฏิบัติตามและดำเนินการตามคำสั่ง
วิธีการนี้มีผลกระทบอย่างมากต่อกระบวนการกระตุ้น LLMs ทำให้เกิดการเปลี่ยนแปลงที่สำคัญในลักษณะการกระตุ้น LLM ที่ได้รับการปรับให้เหมาะสมด้วยคำสั่งอนุญาตให้ดำเนินการงานแบบ zero-shot ได้ทันที โดยไม่ต้องใช้การเรียนรู้แบบ few-shot หาก LLM ยังไม่ได้ปรับจูน อาจต้องยกตัวอย่าง few-shot ในพรอมต์เพื่อชี้นำไปสู่คำตอบที่ต้องการ
“การปรับให้เหมาะสมด้วยคำสั่งโดยใช้ GPT-4” พูดถึงความพยายามในการใช้ GPT-4 เพื่อสร้างข้อมูลการปฏิบัติตามคำสั่งสำหรับการปรับให้เหมาะสม LLMs โดยใช้ชุดข้อมูลที่มี 52,000 รายการที่ไม่ซ้ำกันในภาษาอังกฤษและจีน
ชุดข้อมูลนี้มีบทบาทสำคัญในการปรับให้เหมาะสมด้วยคำสั่งสำหรับโมเดล LLaMA ซึ่งเป็นชุดโมเดล LLM ที่เปิดเผยต่อสาธารณะ โดยนำไปสู่การปรับปรุงประสิทธิภาพแบบ zero-shot ในงานใหม่ๆ โครงการที่น่าสังเกต เช่น Stanford Alpaca ได้ใช้การปรับให้เหมาะสมด้วยคำสั่งแบบ Self-Instruct อย่างมีประสิทธิภาพ ซึ่งเป็นวิธีการที่มีประสิทธิภาพในการจัดแนว LLMs กับเจตนาของมนุษย์ โดยใช้ข้อมูลที่สร้างโดยโมเดลครูที่ได้รับการปรับให้เหมาะสมด้วยคำสั่ง

จุดมุ่งหมายหลักของการวิจัยการปรับให้เหมาะสมด้วยคำสั่งคือการเพิ่มความสามารถในการนำความรู้ไปใช้กับงานใหม่แบบ zero-shot และ few-shot ของ LLMs การเพิ่มข้อมูลและขนาดโมเดลสามารถให้ข้อมูลเชิงลึกที่มีค่าได้ ด้วยขนาดข้อมูล GPT-4 ปัจจุบันที่ 52K และขนาดโมเดล LLaMA พื้นฐานที่ 7 พันล้านพารามิเตอร์ มีศักยภาพที่จะรวบรวมข้อมูลการปฏิบัติตามคำสั่ง GPT-4 เพิ่มเติมและรวมเข้ากับแหล่งข้อมูลอื่นๆ เพื่อฝึกอบรมโมเดล LLaMA ที่ใหญ่ขึ้นสำหรับการทำงานที่ดีกว่า
STaR: การเพิ่มทักษะการให้เหตุผลด้วยการให้เหตุผล
ศักยภาพของ LLMs เป็นที่เห็นได้ชัดเจนในงานที่ซับซ้อน เช่น การให้เหตุผลทางคณิตศาสตร์หรือการถามคำถามที่ต้องใช้เหตุผลทั่วไป อย่างไรก็ตาม การกระตุ้นให้โมเดลภาษาผลิต ‘เหตุผล’ ซึ่งเป็นชุดของการให้เหตุผลทีละขั้นตอนหรือ ‘chain-of-thought’ มักต้องการการสร้างชุดข้อมูลเหตุผลขนาดใหญ่หรือการเสียสละความถูกต้องเนื่องจากการอาศัยการอนุมานแบบ few-shot
“Self-Taught Reasoner” (STaR) เสนอวิธีการใหม่ๆ โดยใช้ลูปง่ายๆ เพื่อปรับปรุงความสามารถในการให้เหตุผลของโมเดลอย่างต่อเนื่อง กระบวนการนี้เริ่มต้นด้วยการสร้างเหตุผลเพื่อตอบคำถามหลายข้อโดยใช้ตัวอย่างการให้เหตุผลเพียงไม่กี่ตัวอย่าง หากคำตอบที่สร้างขึ้นไม่ถูกต้อง โมเดลจะพยายามสร้างเหตุผลอีกครั้ง โดยให้คำตอบที่ถูกต้อง โมเดลจะถูกปรับให้เหมาะสมด้วยเหตุผลทั้งหมดที่นำไปสู่คำตอบที่ถูกต้อง และกระบวนการจะทำซ้ำ

วิธีการ STaR ซึ่งแสดงลูปการปรับจูนและตัวอย่างการสร้างเหตุผลบนชุดข้อมูล CommonsenseQA (https://arxiv.org/pdf/2203.14465.pdf)
เพื่อแสดงให้เห็นด้วยตัวอย่างเชิงปฏิบัติ ลองพิจารณาคำถาม “อะไรที่สามารถใช้ในการขนย้ายสุนัขขนาดเล็ก?” พร้อมตัวเลือกคำตอบตั้งแต่สระว่ายน้ำไปจนถึงตะกร้า โมเดล STaR สร้างเหตุผล โดยระบุว่าคำตอบต้องเป็นสิ่งที่สามารถขนย้ายสุนัขขนาดเล็กได้ และสรุปว่าตะกร้าซึ่งออกแบบมาเพื่อใส่สิ่งของเป็นคำตอบที่ถูกต้อง
วิธีการของ STaR นี้เป็นเอกลักษณ์ในการใช้ความสามารถในการให้เหตุผลที่มีอยู่ของโมเดลภาษา โดยใช้กระบวนการสร้างและปรับปรุงเหตุผลอย่างต่อเนื่องเพื่อเพิ่มทักษะการให้เหตุผลของโมเดลแบบวนซ้ำ อย่างไรก็ตาม ลูปนี้มีข้อจำกัด โมเดลอาจแก้ปัญหาใหม่ในชุดฝึกไม่ได้ เพราะไม่ได้รับสัญญาณฝึกโดยตรงสำหรับโจทย์ที่แก้ไม่สำเร็จ STaR จึงใช้ rationalization โดยให้คำตอบที่ถูกต้องสำหรับแต่ละโจทย์ที่ตอบผิด เพื่อให้โมเดลสร้างเหตุผลใหม่ด้วยการย้อนจากคำตอบ
STaR จึงเป็นวิธีการที่สามารถขยายขนาดได้ซึ่งช่วยให้โมเดลสามารถเรียนรู้ที่จะสร้างเหตุผลของตนเองและเรียนรู้ที่จะแก้ปัญหาที่ยากขึ้นได้ การใช้ STaR แสดงให้เห็นถึงผลลัพธ์ที่น่าสนใจในงานที่เกี่ยวข้องกับการคำนวณเลขคณิต โจทย์ปัญหาคณิตศาสตร์ และการให้เหตุผลสามัญสำนึก บน CommonsenseQA ผลของ STaR ดีกว่าทั้งฐานเปรียบเทียบ few-shot และฐานที่ปรับจูนให้ทำนายคำตอบโดยตรง และใกล้เคียงกับโมเดลที่ใหญ่กว่า 30 เท่า
คำสั่งบริบทที่มีแท็ก
แนวคิดของ ‘คำสั่งบริบทที่มีแท็ก‘ เกี่ยวข้องกับการให้โมเดล AI เพิ่มเติมด้วยชั้นบริบทโดยการแท็กข้อมูลบางอย่างภายในข้อมูลเข้า แท็กเหล่านี้ทำหน้าที่เป็นป้ายบอกทางสำหรับ AI เพื่อชี้แนะวิธีการตีความบริบทอย่างถูกต้องและสร้างผลลัพธ์ที่เกี่ยวข้องและถูกต้อง
ลองนึกภาพว่าคุณกำลังสนทนากับเพื่อนเกี่ยวกับหัวข้อใดหัวข้อหนึ่ง สมมติว่าเป็น ‘หมากรุก’ คุณทำคำกล่าวและแท็กมันด้วยแหล่งที่มา เช่น ‘(แหล่งที่มา: วิกิพีเดีย)’ ตอนนี้ เพื่อนของคุณ ซึ่งเป็นโมเดล AI รู้อย่างแน่ชัดว่าข้อมูลของคุณมาจากไหน แนวทางนี้มุ่งให้คำตอบเชื่อถือได้ขึ้น โดยลดความเสี่ยงการสร้างข้อมูลหลอนหรือข้อเท็จจริงที่เป็นเท็จ
คุณลักษณะที่เป็นเอกลักษณ์ของคำสั่งบริบทที่มีแท็กคือศักยภาพในการปรับปรุง ‘ความฉลาดบริบท’ ของโมเดล AI ตัวอย่างเช่น ในงานวิจัยนี้ โดยใช้คำถามที่หลากหลายจากแหล่งต่างๆ เช่น บทสรุปจากบทความวิกิพีเดียและหนังสือที่ตีพิมพ์ใหม่ๆ คำถามเหล่านี้ถูกแท็กเพื่อให้โมเดล AI มีบริบทเพิ่มเติมเกี่ยวกับแหล่งที่มาของข้อมูล
ชั้นบริบทเพิ่มเติมนี้สามารถพิสูจน์ได้ว่ามีคุณค่าอย่างมากในการสร้างผลลัพธ์ที่ไม่เพียงแต่ถูกต้อง แต่ยังเชื่อถือได้และเหมาะสมกับบริบทที่ให้ไว้
สรุป: การมองเห็นเทคนิคที่มีแนวโน้มและทิศทางในอนาคต
ChatGPT ของ OpenAI แสดงให้เห็นถึงศักยภาพที่ไม่เคยสัมผัสของโมเดลภาษาขนาดใหญ่ (LLMs) ในการแก้ปัญหาที่ซับซ้อนได้อย่างน่าประทับใจ เทคนิคขั้นสูง เช่น การเรียนรู้แบบ few-shot, ReAct, chain-of-thought และ STaR ช่วยให้เราใช้ศักยภาพนี้ไปทั่วหลายโดเมน เมื่อเราลงลึกเข้าไปในความซับซ้อนของวิธีการเหล่านี้ เราจะพบว่าพวกมันกำลังเปลี่ยนแปลงภูมิทัศน์ของ AI โดยนำเสนอการโต้ตอบที่มีประสิทธิภาพและปลอดภัยระหว่างมนุษย์และเครื่องจักร
แม้จะมีความท้าทาย เช่น ความขัดแย้งทางความรู้ การพึ่งพาความรู้แบบพารามิเตอร์มากเกินไป และศักยภาพในการสร้างข้อมูลหลอน โมเดล AI เหล่านี้ โดยมีการวิศวกรรมคำสั่งที่เหมาะสม ได้พิสูจน์แล้วว่าเป็นเครื่องมือที่เปลี่ยนแปลงได้ การปรับให้เหมาะสมด้วยคำสั่ง การกระตุ้นที่ซื่อสัตย์ต่อบริบท และการผสานกับแหล่งข้อมูลภายนอกยังเพิ่มความสามารถในการให้เหตุผล การเรียนรู้ และปรับตัวของพวกมัน


