
มุมมองของ Anderson
ระบบ Machine Learning ที่เขียนเรียงความใหม่ขณะคุณอ่าน

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
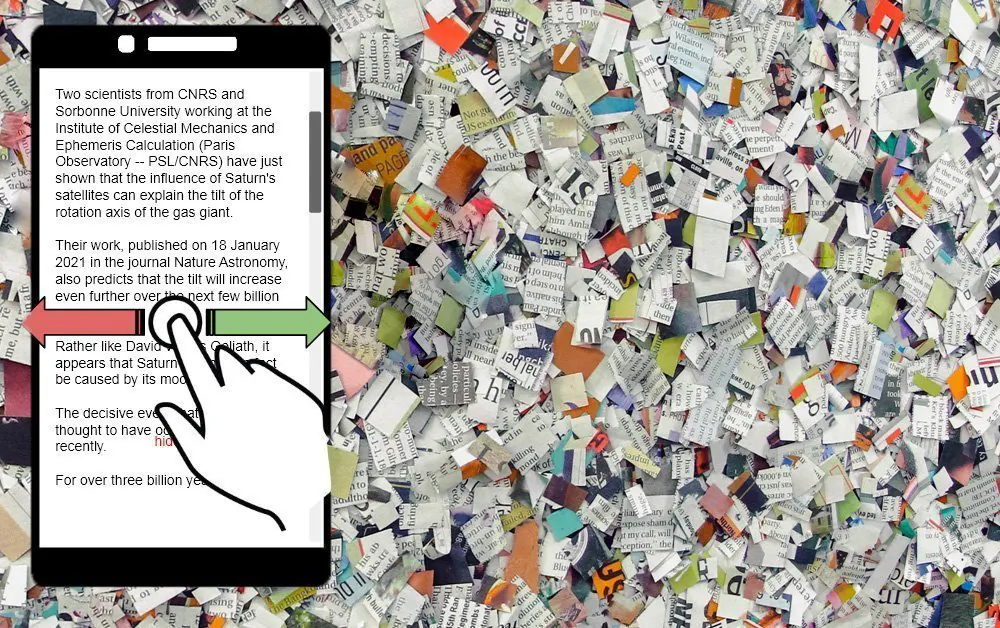
การวิจัยใหม่จากแคนาดาเสนอวิธีการเขียนเรียงความใหม่โดยอัตโนมัติขณะคุณอ่าน โดยอาศัยการวาด ‘สวाइป’ แบบ Tinder หรือการสังเกตการโต้ตอบของผู้อ่านกับเนื้อหาต่างๆ ที่เรียงความประกอบด้วย
ระบบซึ่งมีชื่อว่า Hone As You Read (HARE) ถูกนำเสนอใน เอกสาร จาก Western University ในรัฐออนตาริโอ ประเทศแคนาดา พร้อมด้วยโค้ด Python ที่ GitHub
แนวคิดหลักของโครงการคือเรียงความอาจประกอบด้วยเนื้อหาต่างๆ ที่พัฒนาไปตามหัวข้อและรายละเอียดต่างๆ ในส่วนหลังของเรียงความอาจมีเนื้อหาสนับสนุน ตัวอย่างการใช้งาน หรือสมมติฐานเกี่ยวกับผลกระทบของข่าว
ภายใต้ HARE หากคุณไม่ชอบเนื้อหาดังกล่าว คุณสามารถลงคะแนนเสียงเพื่อกำจัดมันไปตามย่อหน้าโดยระบบจะเรียนรู้ความชอบของคุณ เพื่อให้เมื่อคุณเลื่อนลงไป เนื้อหาที่คล้ายกับที่คุณ ‘ไม่ลงคะแนน’ จะถูกกำจัดหรือเขียนใหม่แล้ว หากคุณไม่ต้องการมีส่วนร่วมในการฝึกอบรมระบบอย่างแข็งขัน HARE สามารถอนุมานความชอบของคุณโดยการสังเกตการโต้ตอบของคุณกับเอกสาร
การลงคะแนนแบบ Tinder สำหรับประโยคที่ไม่พึงประสงค์
ในภาพด้านล่าง เราจะเห็นสามประเภทของการจำแนกประเภทที่ HARE ใช้ โดยอาศัยพฤติกรรมที่แสดงออกหรือไม่แสดงออกของผู้ใช้ ในกรณีแรก (ซ้าย) ผู้ใช้สามารถ ‘สวाइปซ้าย’ (หรือขวา) ในลักษณะการลงคะแนนแบบ Tinder เพื่อแสดงความชอบหรือไม่ชอบในเนื้อหาของย่อหน้าหรือประโยค หรือในลักษณะ ความซับซ้อน หรือโทน

Source: https://arxiv.org/pdf/2105.02923.pdf
ในกรณีที่สอง (กลาง) ระบบใช้เวลาในการหยุดยั้ง (dwell-time) เป็นมาตรการในการวัดความสนใจของผู้ใช้ โดยอาศัยการวางตำแหน่งและการหยุดยั้งการเลื่อน
ในกรณีที่สาม (ขวา) HARE ใช้กล้องสมาร์ทโฟนในการประมาณการเส้นทางและการหยุดยั้งตำแหน่งการมองของผู้ดูบนย่อหน้าของเอกสารที่มองเห็น
นักวิจัยอ้างว่าเวลาหยุดยั้งที่เพิ่มขึ้นในย่อหน้าใดๆ สามารถบ่งบอกถึงความสนใจของผู้ใช้ที่เพิ่มขึ้น แม้ว่าโดยตรรกะแล้วอาจไม่เป็นเช่นนั้นหากผู้ดูพยายามที่จะดูดซึมเนื้อหาที่ซับซ้อนหรือเขียนไม่ดี

การให้ข้อมูลย้อนกลับของผู้ใช้สามารถแก้ไข เขียนใหม่ หรือลบส่วนของเรียงความที่ยังไม่ได้เห็น
การประมวลผลเนื้อหาตามความชอบของผู้ใช้
เอกสารนี้พูดถึงประสบการณ์ของผู้ใช้กับ HARE ในเรียงความแต่ละเรียงความ แต่ชัดเจนว่าการโต้ตอบในอดีตของผู้ใช้กับเอกสารช่วยให้สามารถปรับแต่งประสบการณ์การอ่านในอนาคตได้ โดยการรู้จักประเภทของเนื้อหาและใช้เทมเพลตความชอบของผู้ใช้กับเรียงความใหม่ๆ เพื่อลดความจำเป็นในการโต้ตอบเมื่อผู้ใช้เห็นเนื้อหาที่ ‘ไม่พึงประสงค์’ น้อยลง
HARE ถูกอธิบายว่าเป็นอัลกอริทึมสรุป โดยอนุญาตให้เขียนเนื้อหาที่ยังไม่เห็นในย่อหน้าถัดไปใหม่ในแง่ของลักษณะหรือความกระชับก่อนที่ผู้ใช้จะไปถึงมัน แต่เอกสารชี้แจงว่าสามารถกำจัดเนื้อหาล่วงหน้าตามการให้ข้อมูลย้อนกลับของผู้ใช้ได้
เพื่อการทดสอบ ระบบใช้ คอร์ปัส ของ 11,222 เรียงความจากหนังสือพิมพ์ Daily Mail ของสหราชอาณาจักร และได้รับการประเมินผ่านการวางตัวทดสอบบนแอป Telegram Articles ที่มีน้อยกว่า 10 ย่อหน้าถูกตัดออกจากการทดสอบ

แอป Telegram HARE ในระยะทดสอบกับผู้ใช้
วิธีการของนักวิจัยใช้ K-Means clustering บน SBERT sentence embeddings ในเรียงความ โดยมีน้ำหนักเริ่มต้นแบบสุ่มสำหรับแนวคิดที่พูดถึง
ในบรรดาอัลกอริทึมและแนวทางต่างๆ HARE มีโมเดลเปรียบเทียบสามแบบ โดยโมเดลแรก (ORACLEGREEDY) มีการเข้าถึงความชอบของผู้ใช้ก่อนหน้านี้ ซึ่งบ่งบอกถึงความตั้งใจที่จะประมวลผลเรียงความเมื่อโหลด แทนที่จะโต้ตอบแบบโต้ตอบ
โมเดลอื่นๆ ORACLESORTED และ ORACLEUNIFORM เลือกประโยคตามระดับความสนใจหรือแบบสุ่มตลอดเรียงความตามลำดับ
การกำจัดและเขียนเนื้อหาใหม่
น่าประหลาดใจที่ ORACLEUNIFORM ทำได้ดีกว่าชุดควบคุม แม้ว่าจะไม่มีการเข้าถึงความสนใจของผู้ใช้ก่อนหน้านี้ก็ตาม นักวิจัยอ้างว่านี่เป็นเพราะว่ามันจัดการกับเรียงความทั้งหมดในครั้งเดียว ‘เลือกประโยคที่น่าสนใจที่สุด’ นักวิจัยยอมรับว่านี่อาจจำกัดเนื้อหาที่มีอยู่ให้กับประโยคที่เกี่ยวข้องกับแนวคิดหลักเท่านั้น โดยการกำจัดเนื้อหาอื่นที่อาจเกี่ยวข้องกับผลกระทบหรือการประเมินแนวคิด
อัลกอริทึมสรุปแบบอธิบายที่ใช้ใน HARE คือ LexRank, SumBasic และ TextRank
HARE ถูกทดสอบกับผู้เข้าร่วม 13 คนในช่วง 70 การทดสอบและแนวทางอัลกอริทึมต่างๆ และสามารถอัปเดตสรุป (เนื้อหาที่เขียนใหม่/กำจัด) ในเวลาประมาณ 1.3 มิลลิวินาทีถึง 100 มิลลิวินาทีบนแล็ปท็อประดับผู้บริโภค ขึ้นอยู่กับโมเดลที่ทดสอบ ผลการวิจัยพบว่าโมเดลที่กำจัดเนื้อหาส่วนใหญ่ไม่ได้ผลดี เนื่องจากสิ่งนี้สามารถส่งผลต่อความสอดคล้องของเนื้อหาที่เหลือ
ผลกระทบทางจริยธรรมของการเขียนเรียงความใหม่แบบไดนามิก
นักวิจัยยอมรับข้อกังวลด้านจริยธรรมเกี่ยวกับเทคโนโลยีประเภทนี้:
‘งาน HARE มีจุดมุ่งหมายเพื่อการออกแบบแอปพลิเคชันที่เผยแพร่สู่ผู้ใช้ในอนาคต โดยการออกแบบ แอปพลิเคชันเหล่านี้มีความสามารถในการควบคุมสิ่งที่ผู้ใช้อ่านจากเรียงความที่กำหนด มีความเป็นไปได้ที่เมื่อใช้งานโดยไม่มีการดูแลที่เพียงพอ เครื่องมือเหล่านี้อาจทำให้ผลกระทบ “ห้องเล็ก” ที่เกิดจากฟีดข่าวอัตโนมัติ ผลการค้นหา และชุมชนออนไลน์เล็กขึ้น’
อย่างไรก็ตาม พวกเขายังชี้ให้เห็นว่าระบบดังกล่าวสามารถใช้ในการประยุกต์ใช้ในอนาคตเพื่อลดผลกระทบของห้องเล็กโดยการฉีดเนื้อหาที่เสนอความคิดเห็นที่แตกต่างที่อาจไม่มีอยู่ในเรียงความเดิม พวกเขาสังเกตเห็นว่า ‘น้ำหนักของปัจจัยนี้สามารถปรับให้เหมาะสมเพื่อให้ได้ประสบการณ์การอ่านที่น่าดึงดูดและเปิดเผยความคิดที่หลากหลาย’
ผู้ที่น่าจะได้รับประโยชน์จากระบบดังกล่าวตามนักวิจัย คือ ผู้อ่านที่ต้องการประหยัดเวลาในการดูดซึมสารสนเทศ และผู้จัดพิมพ์ nội dung


