
พื้นฐาน AI
การประมวลผลภาษาธรรมชาติ (NLP) คืออะไร? วิธีที่เครื่องจักรเข้าใจภาษา
การประมวลผลภาษาธรรมชาติคือสาขาที่มุ่งเน้นวิธีคอมพิวเตอร์ในการวิเคราะห์ ทำความเข้าใจ สร้างสรรค์ และโต้ตอบผ่านภาษามนุษย์ คู่มือฉบับนี้อธิบายกลไก การแลกเปลี่ยน ผลการประเมิน และการควบคุมที่สำคัญในการปฏิบัติ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
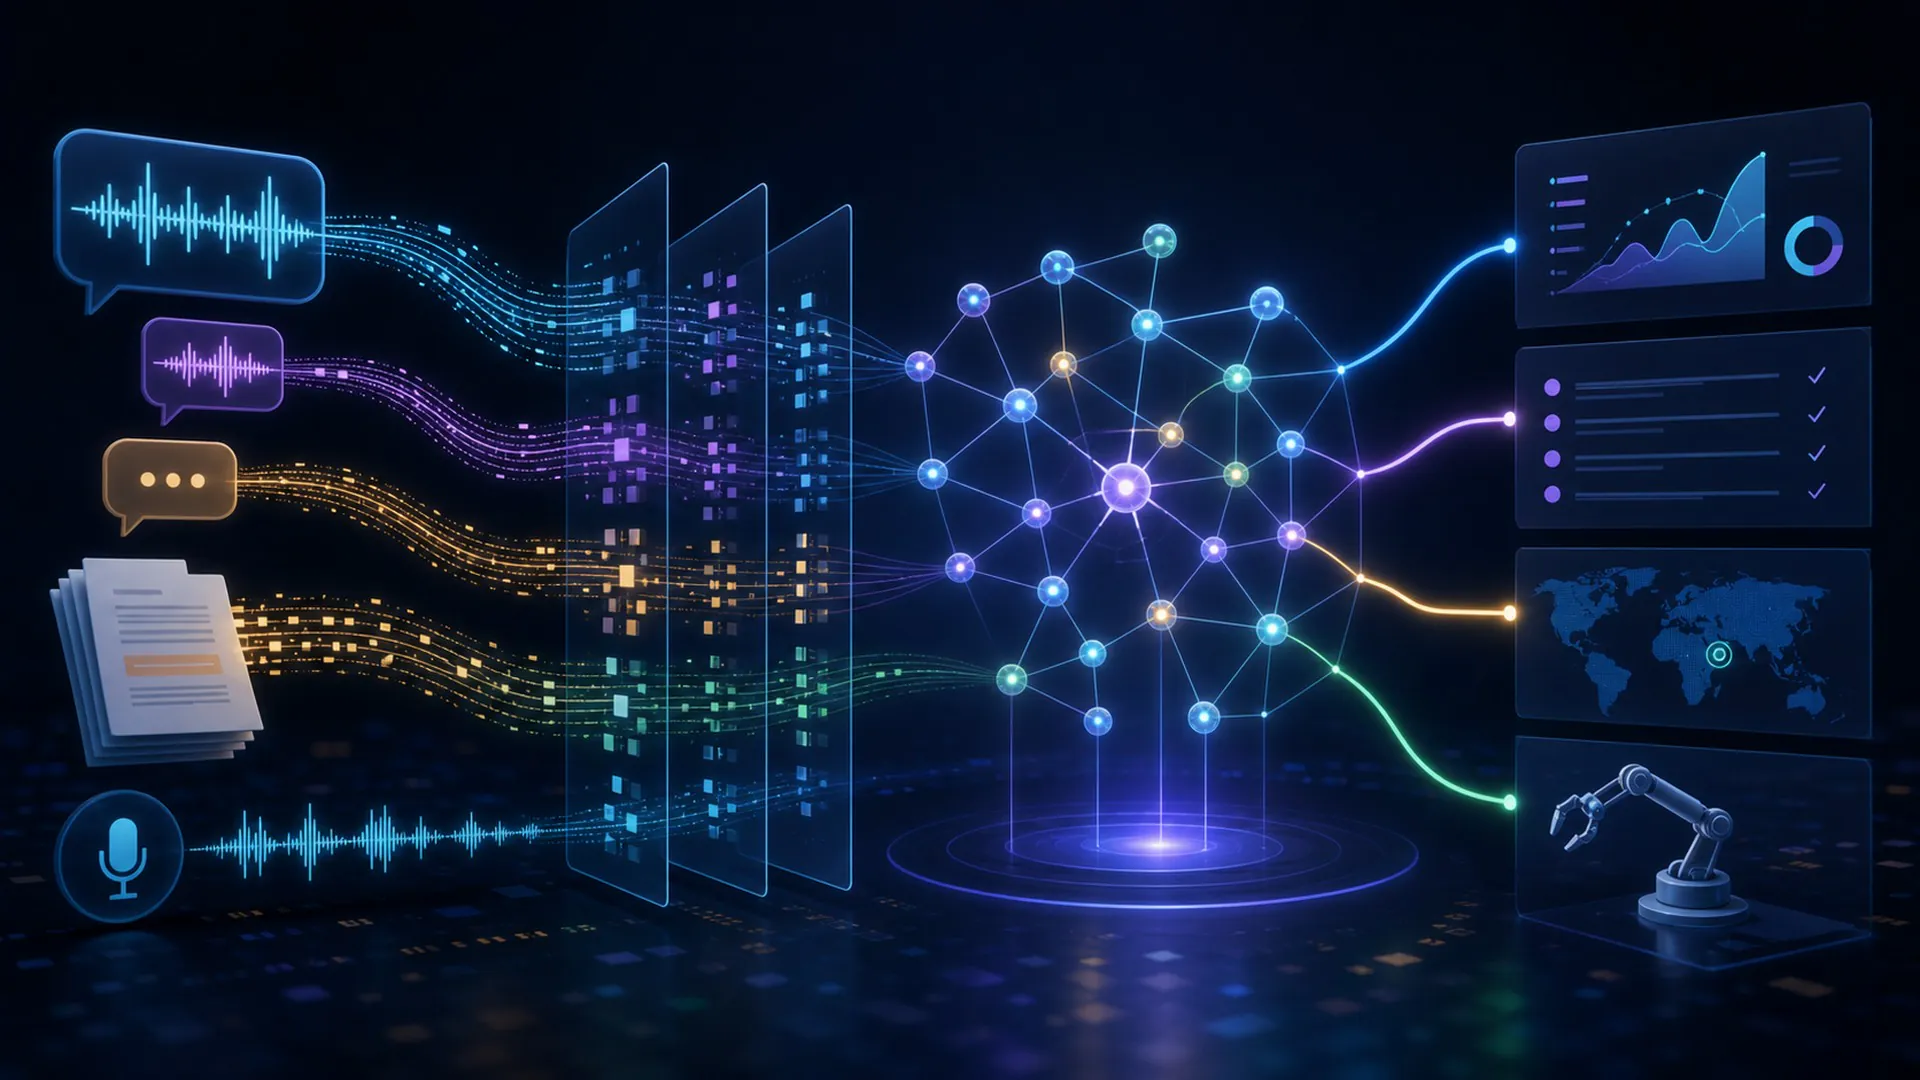
การประมวลผลภาษาธรรมชาติ (Natural Language Processing) คือสาขาที่มุ่งเน้นวิธีคอมพิวเตอร์ในการวิเคราะห์ ทำความเข้าใจ สร้างสรรค์ และโต้ตอบผ่านภาษามนุษย์
การประมวลผลภาษาธรรมชาติจำเป็นต้องอธิบายอย่างแม่นยำ เพราะชื่อของมันบ่งบอกถึงกระแสข้อมูล การเลือกการฝึกอบรม กลไกการทำงาน หรือขอบเขตการกำกับดูแล หากถือว่าเป็นคำพ้องกับ “AI ขั้นสูง” จะทำให้การตรวจสอบข้ออ้างอิงเป็นไปไม่ได้ คู่มือฉบับนี้จะติดตามแนวคิดตั้งแต่ข้อมูลเข้าและสมมติฐานจนถึงผลลัพธ์ที่สังเกตได้ แล้วทดสอบทางลัดที่มักถูกสับสนกับมัน
การประมวลผลภาษาธรรมชาติ: คำจำกัดความ, ขอบเขต, และวัตถุประสงค์
การประมวลผลภาษาธรรมชาติคือสาขาที่มุ่งเน้นวิธีคอมพิวเตอร์ในการวิเคราะห์ ทำความเข้าใจ สร้างสรรค์ และโต้ตอบผ่านภาษามนุษย์ คำจำกัดความนี้มีข้อผูกพันเชิงปฏิบัติสามประการ: มีข้อมูลเข้าแบบระบุได้ การแปลงหรือการตัดสินใจที่เป็นลักษณะเฉพาะของการประมวลผลภาษาธรรมชาติ และผลลัพธ์ที่สามารถประเมินตามวัตถุประสงค์ที่ระบุไว้ หากขาดส่วนใดส่วนหนึ่ง ป้ายชื่ออาจบรรยายความใฝ่ฝันแทนกลไกที่ได้ดำเนินการจริง
สแตก AI สมัยใหม่สร้างชั้นนามธรรมซ้อนกัน: การแสดงผลสนับสนุนสถาปัตยกรรม การฝึกล่วงหน้าสร้างความสามารถที่นำกลับมาใช้ใหม่ การปรับตัวเปลี่ยนพฤติกรรม และการเพิ่มประสิทธิภาพการใช้งานกำหนดความเป็นไปได้ของระบบ สำหรับการประมวลผลภาษาธรรมชาติ มุมมองระบบนี้สำคัญเพราะประสิทธิภาพอาจขึ้นกับข้อมูล รอบต่อข้อมูล อินเตอร์เฟซ ฮาร์ดแวร์ สิทธิ์การเข้าถึง และผู้ใช้ แม้โมเดลพื้นฐานจะไม่เปลี่ยนแปลง คำอธิบายที่เป็นประโยชน์จึงต้องแยกพฤติกรรมที่โมเดรเรียนรู้จากผลิตภัณฑ์ที่ตัดสินใจว่าเมื่อใด ที่ใด และด้วยอำนาจใดที่ใช้พฤติกรรมนั้น
ทางลัดที่ทำให้เข้าใจผิดที่พบบ่อยที่สุดคือการจับคีย์เวิร์ดอย่างง่ายโดยไม่สนใจลำดับและบริบท แม้ว่าจะมีลักษณะร่วมกับการประมวลผลภาษาธรรมชาติ แต่จะเปลี่ยนเรื่องราวสาเหตุ: หลักฐานที่ใช้ยืนยันความสำเร็จต่างกัน ทรัพยากรที่ครอบงำต้นทุนต่างกัน และการควบคุมที่ป้องกันอันตรายต่างกัน ดังนั้นขอบเขตจึงเป็นเชิงปฏิบัติ ไม่ใช่เชิงศัพท์
แผนผังการทำงานห้าขั้นตอนของการประมวลผลภาษาธรรมชาติ
แผนผังนี้เป็นแผนผังสาเหตุเชิงสั้นสำหรับการประมวลผลภาษาธรรมชาติ ไม่ได้หมายความว่าการนำไปใช้ทุกกรณีต้องมีห้าส่วนประกอบซอฟต์แวร์ บางระบบอาจรวมขั้นตอนเข้าด้วยกัน หรือทำซ้ำในลูป แผนผังยังคงมีประโยชน์เพราะบังคับให้การเปลี่ยนแปลงข้อมูลหรืออำนาจแต่ละครั้งต้องมีเจ้าของ อินพุต ผลลัพธ์ และการทดสอบ
1. แปลงข้อความหรือคำพูดเป็นรูปแบบที่เครื่องอ่านได้: ข้อมูลนำเข้าและสมมติฐานในการประมวลผลภาษาธรรมชาติ
ในขั้นตอนนี้ ระบบต้องแปลงข้อความหรือเสียงให้เป็นรูปแบบที่เครื่องอ่านได้ คำถามที่สำคัญไม่ใช่แค่การทำงานนี้เกิดขึ้นหรือไม่ แต่ข้อมูลใดที่ถูกใช้ สถานะใดที่เปลี่ยนแปลง และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นถูกต้อง ผู้ตรวจสอบควรแยกแยะการทำงานนี้จากการจับคีย์เวิร์ดอย่างง่ายที่ละเลยลำดับและบริบท และสามารถทำซ้ำผลลัพธ์ได้ภายใต้เงื่อนไขที่ระบุเดียวกัน
การส่งต่อเข้าสู่ขั้นตอนการประมวลผลภาษาธรรมชาตินี้เริ่มจากวัตถุประสงค์ที่ระบุไว้และควรจบด้วยผลลัพธ์ที่สนับสนุนการโมเดลไวยากรณ์ ความหมาย และบริบท บันทึกความไม่แน่นอน ทางเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์นำมาใช้ที่ขอบเขตนั้น ติดตามนี้เป็นจุดที่ทีมสามารถตรวจจับว่าภาษามีความคลุมเครือ วัฒนธรรม หรืออำนาจอย่างไร โมเดลที่มีตัวเลขแข็งแรงอาจยังทำให้ผู้ใช้ล้มเหลวก่อนที่ความอ่อนแอนั้นจะส่งผลต่อผลลัพธ์ที่สำคัญ
2. สร้างแบบจำลองวากยสัมพันธ์ ความหมาย และบริบท: การแทนความหมายหรือการตัดสินใจในการประมวลผลภาษาธรรมชาติ
ในขั้นตอนนี้ ระบบต้องทำโมเดลไวยากรณ์ ความหมาย และบริบท อีกครั้ง คำถามที่สำคัญไม่ใช่แค่การทำงานนี้เกิดขึ้นหรือไม่ แต่ข้อมูลใดที่ถูกใช้ สถานะใดที่เปลี่ยนแปลง และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นถูกต้อง ผู้ตรวจสอบควรแยกแยะการทำงานนี้จากการจับคีย์เวิร์ดอย่างง่ายที่ละเลยลำดับและบริบท และสามารถทำซ้ำผลลัพธ์ได้ภายใต้เงื่อนไขที่ระบุเดียวกัน
การส่งต่อเข้าสู่ขั้นตอนนี้เริ่มจากการแปลงข้อความหรือเสียงให้เป็นรูปแบบที่เครื่องอ่านได้และควรจบด้วยผลลัพธ์ที่สนับสนุนการเรียนรู้วัตถุประสงค์จากข้อมูล บันทึกความไม่แน่นอน ทางเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์นำมาใช้ที่ขอบเขตนั้น ติดตามนี้เป็นจุดที่ทีมสามารถตรวจจับว่าภาษามีความคลุมเครือ วัฒนธรรม หรืออำนาจอย่างไร โมเดลที่มีตัวเลขแข็งแรงอาจยังทำให้ผู้ใช้ล้มเหลวก่อนที่ความอ่อนแอนั้นจะส่งผลต่อผลลัพธ์ที่สำคัญ
3. เรียนรู้วัตถุประสงค์ของงานจากข้อมูล: การแปลงที่เป็นเอกลักษณ์ในการประมวลผลภาษาธรรมชาติ
ในขั้นตอนนี้ ระบบต้องเรียนรู้วัตถุประสงค์ของงานจากข้อมูล คำถามที่สำคัญไม่ใช่แค่การทำงานนี้เกิดขึ้นหรือไม่ แต่ข้อมูลใดที่ถูกใช้ สถานะใดที่เปลี่ยนแปลง และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นถูกต้อง ผู้ตรวจสอบควรแยกแยะการทำงานนี้จากการจับคีย์เวิร์ดอย่างง่ายที่ละเลยลำดับและบริบท และสามารถทำซ้ำผลลัพธ์ได้ภายใต้เงื่อนไขที่ระบุเดียวกัน
การส่งต่อเข้าสู่ขั้นตอนนี้เริ่มจากการโมเดลไวยากรณ์ ความหมาย และบริบทและควรจบด้วยผลลัพธ์ที่สนับสนุนการถอดรหัสการพยากรณ์หรือลำดับที่สร้างขึ้น บันทึกความไม่แน่นอน ทางเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์นำมาใช้ที่ขอบเขตนั้น ติดตามนี้เป็นจุดที่ทีมสามารถตรวจจับว่าภาษามีความคลุมเครือ วัฒนธรรม หรืออำนาจอย่างไร โมเดลที่มีตัวเลขแข็งแรงอาจยังทำให้ผู้ใช้ล้มเหลวก่อนที่ความอ่อนแอนั้นจะส่งผลต่อผลลัพธ์ที่สำคัญ
4. ถอดรหัสผลทำนายหรือลำดับที่สร้างขึ้น: ข้อจำกัดและขอบเขตการตรวจสอบในการประมวลผลภาษาธรรมชาติ
ในขั้นตอนนี้ ระบบต้องถอดรหัสการพยากรณ์หรือลำดับที่สร้างขึ้น คำถามที่สำคัญไม่ใช่แค่การทำงานนี้เกิดขึ้นหรือไม่ แต่ข้อมูลใดที่ถูกใช้ สถานะใดที่เปลี่ยนแปลง และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นถูกต้อง ผู้ตรวจสอบควรแยกแยะการทำงานนี้จากการจับคีย์เวิร์ดอย่างง่ายที่ละเลยลำดับและบริบท และสามารถทำซ้ำผลลัพธ์ได้ภายใต้เงื่อนไขที่ระบุเดียวกัน
การส่งต่อเข้าสู่ขั้นตอนนี้เริ่มจากการเรียนรู้วัตถุประสงค์ของงานจากข้อมูลและควรจบด้วยผลลัพธ์ที่สนับสนุนการประเมินความหมายรวมถึงความแม่นยำของพื้นผิว บันทึกความไม่แน่นอน ทางเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์นำมาใช้ที่ขอบเขตนั้น ติดตามนี้เป็นจุดที่ทีมสามารถตรวจจับว่าภาษามีความคลุมเครือ วัฒนธรรม หรืออำนาจอย่างไร โมเดลที่มีตัวเลขแข็งแรงอาจยังทำให้ผู้ใช้ล้มเหลวก่อนที่ความอ่อนแอนั้นจะส่งผลต่อผลลัพธ์ที่สำคัญ
5. ประเมินความหมายควบคู่กับความถูกต้องบนพื้นผิว: ผลลัพธ์ ข้อมูลย้อนกลับ และกฎหยุดในการประมวลผลภาษาธรรมชาติ
ในขั้นตอนนี้ ระบบต้องประเมินความหมายรวมถึงความแม่นยำของพื้นผิว คำถามที่สำคัญไม่ใช่แค่การทำงานนี้เกิดขึ้นหรือไม่ แต่ข้อมูลใดที่ถูกใช้ สถานะใดที่เปลี่ยนแปลง และหลักฐานใดที่พิสูจน์ว่าการเปลี่ยนแปลงนั้นถูกต้อง ผู้ตรวจสอบควรแยกแยะการทำงานนี้จากการจับคีย์เวิร์ดอย่างง่ายที่ละเลยลำดับและบริบท และสามารถทำซ้ำผลลัพธ์ได้ภายใต้เงื่อนไขที่ระบุเดียวกัน
การส่งต่อเข้าสู่ขั้นตอนนี้เริ่มจากการถอดรหัสการพยากรณ์หรือลำดับที่สร้างขึ้นและควรจบด้วยผลลัพธ์ที่สนับสนุนการเฝ้าติดตามหรือการตัดสินใจขั้นสุดท้าย บันทึกความไม่แน่นอน ทางเลือกที่ถูกปฏิเสธ การใช้ทรัพยากร และการควบคุมใด ๆ ที่มนุษย์หรือซอฟต์แวร์นำมาใช้ที่ขอบเขตนั้น ติดตามนี้เป็นจุดที่ทีมสามารถตรวจจับว่าภาษามีความคลุมเครือ วัฒนธรรม หรืออำนาจอย่างไร โมเดลที่มีตัวเลขแข็งแรงอาจยังทำให้ผู้ใช้ล้มเหลวก่อนที่ความอ่อนแอนั้นจะส่งผลต่อผลลัพธ์ที่สำคัญ
อ่านแผนผังการประมวลผลภาษาธรรมชาติจากด้านหน้าเพื่อเข้าใจการผลิตและจากด้านหลังเพื่อวินิจฉัยความล้มเหลว การวิเคราะห์จากด้านหน้าถามว่าขั้นตอนหนึ่งส่งต่อข้อมูลให้ขั้นต่อไปอย่างไร ส่วนการวิเคราะห์จากด้านหลังเริ่มจากผลลัพธ์ที่ไม่ถูกต้อง ช้า มีค่าใช้จ่ายสูง หรือไม่ปลอดภัยและสืบค้นว่าข้อสมมติฐานใดในขั้นตอนก่อนหน้าทำให้เกิดผลนั้น เส้นทางย้อนกลับมักเป็นที่ที่ทีมพบว่าข้อผิดพลาดสำคัญเกิดก่อนที่โมเดลจะสร้างผลลัพธ์ใด ๆ
ตัวอย่างการประมวลผลภาษาธรรมชาติที่ทำงานจริง
ระบบ NLP สามารถสกัดภาระผูกพันจากสัญญาโดยคงไว้ซึ่งข้อมูลว่าฝ่ายใด ทำอะไร ภายใต้เงื่อนไขใดและวันที่ใดเป็นคู่กัน
ตัวอย่างนี้มีประโยชน์เพราะการประมวลผลภาษาธรรมชาติสามารถเชื่อมโยงกับข้อมูลเข้า สถานะกลาง และผลลัพธ์ที่สังเกตได้ แทนที่จะประเมินจากการสาธิตที่ดูดี การทดสอบอย่างเข้มงวดควรสร้างกรณีที่ง่าย ยาก และหลอกลวงรอบสถานการณ์นั้น เก็บฐานข้อมูลที่ไม่มีเทคนิคนี้เป็นพื้นฐาน และบันทึกทั้งประสิทธิภาพเฉลี่ยและความรุนแรงของความล้มเหลวแต่ละกรณี
เปลี่ยนสมมติฐานหนึ่งในตัวอย่าง NLP แล้วทำการวิเคราะห์ซ้ำ ลบข้อมูลเข้าแบบจำเป็น แทรกสัญญาณที่ขัดแย้ง จำกัดการคำนวณ ปรับเปลี่ยนกลุ่มผู้ใช้ หรือบังคับให้ระบบละเลย การทำงานที่สำเร็จเพียงในสาธิตที่จัดเตรียมอย่างระมัดระวังไม่ได้พิสูจน์ว่ามันสามารถทั่วไปได้กับสภาพแวดล้อมการทำงานจริง
การประมวลผลภาษาธรรมชาติกับทางลัดที่พบบ่อยที่สุด
การประมวลผลภาษาธรรมชาติมักถูกลดทอนให้เป็นการจับคีย์เวิร์ดอย่างง่ายที่ละเลยลำดับและบริบท การลดทอนนี้ทำให้ขอบเขตที่กำหนดแนวคิดหายไป อาจทำให้ผู้ซื้อเปรียบเทียบผลิตภัณฑ์ที่ไม่เหมือนกัน นักวิจัยอ้างอ้างเกินจริงเกี่ยวกับสิ่งที่การทดลองแสดงให้เห็น และผู้ปฏิบัติงานเฝ้าติดตามสัญญาณที่ไม่ถูกต้องหลังการเปิดใช้งาน
| Lens | Practical answer |
|---|---|
| Definition | การประมวลผลภาษาธรรมชาติคือสาขาที่ศึกษาวิธีการเชิงคำนวณสำหรับวิเคราะห์ ทำความเข้าใจ สร้าง และโต้ตอบผ่านภาษามนุษย์ |
| Confusion | การจับคู่คำสำคัญแบบง่ายที่ไม่คำนึงถึงลำดับและบริบท |
| Risk | ภาษาสะท้อนความกำกวม วัฒนธรรม และอำนาจ ดังนั้นแม้โมเดลจะมีผลลัพธ์เชิงตัวเลขที่ดี ก็ยังอาจล้มเหลวต่อผู้ใช้ได้ |
การเปรียบเทียบควรระบุหน่วยวิเคราะห์ด้วยเช่นกัน บทความเกี่ยวกับการประมวลผลภาษาธรรมชาติอาจแยกโมเดลหรืออัลกอริธึมออกมา ในขณะที่บริการที่เปิดใช้งานจริงจะเพิ่มการดึงข้อมูล การกำหนดเส้นทาง แคช นโยบาย การระบุตัวตน ส่วนต่อผู้ใช้ และการเฝ้าติดตาม ผลิตภัณฑ์สองตัวอาจใช้คำหลักเดียวกันแต่ดำเนินการส่วนต่างของสแตกนั้นต่างกัน ควรถามว่าคอมโพเนนต์ใดทำการแปลงที่กำหนดและคอมโพเนนต์อื่นใดจำเป็นต่อผลลัพธ์ที่รายงาน
เหตุผลที่การประมวลผลภาษาธรรมชาติมีความสำคัญในระบบ AI ปัจจุบัน
การประมวลผลภาษาธรรมชาติมีความสำคัญในขณะนี้เนื่องจากระบบ AI ได้รับบริบทที่ใหญ่ขึ้น โหมดหลายรูปแบบ การคำนวณแบบเรียลไทม์ที่เพิ่มขึ้น การเข้าถึงเครื่องมือที่หลากหลาย และการเชื่อมต่อที่ลึกซึ้งกับการตัดสินใจขององค์กร ภายใต้เงื่อนไขเหล่านี้ สิ่งที่เคยเป็นรายละเอียดการวิจัยอาจกำหนดความหน่วงเวลา ความปลอดภัย ความเข้าถึง ความต้นทุนด้านสิ่งแวดล้อม คุณภาพผลิตภัณฑ์ หรือความรับผิดชอบทางกฎหมาย
ตัวชี้วัดที่สำคัญไม่ใช่ว่า การประมวลผลภาษาธรรมชาติสามารถสร้างผลลัพธ์ที่น่าประทับใจหนึ่งอย่างเดียวหรือไม่ แต่คือเทคนิคนั้นทำให้ผลลัพธ์ที่สำคัญในสภาพเงื่อนไขที่เป็นตัวแทนดีขึ้นและทำได้ดีกว่าฐานเปรียบเทียบที่ง่ายกว่าอย่างไร รายงานการกระจาย ความล้มเหลวประเภทต่าง ๆ ความหน่วงเวลาที่หางสุด การใช้ทรัพยากร และกลุ่มผู้ใช้ที่ได้รับผลกระทบ แทนการสรุปผลทั้งหมดเป็นค่าเฉลี่ยเดียว
การเลือกเทคนิคที่เหมาะสมต้องพิจารณางานและฮาร์ดแวร์ เปรียบเทียบกับฐานเปรียบเทียบง่าย ๆ วัดคุณภาพในส่วนที่เป็นตัวแทน และติดตามหน่วยความจำ ความหน่วงเวลา ค่าใช้จ่าย และการบำรุงรักษาพร้อมกับความแม่นยำของเบนช์มาร์ค การประยุกต์ใช้กับการประมวลผลภาษาธรรมชาติทำให้หลักฐานนั้นพกพาได้: ทีมอื่นสามารถตรวจสอบว่าการเพิ่มประสิทธิภาพที่อ้างว่ายังคงอยู่เมื่อเปลี่ยนโมเดล ภาษา แพลตฟอร์มฮาร์ดแวร์ ชุดข้อมูล กลุ่มผู้ใช้ หรือระดับความเสี่ยงที่ยอมรับได้หรือไม่
ประโยชน์ที่การประมวลผลภาษาธรรมชาติสามารถมอบให้ได้
เหตุผลที่แข็งแกร่งที่สุดในการใช้การประมวลผลภาษาธรรมชาติคือมันสามารถแก้ไขคอขวดที่ตั้งใจไว้โดยตรง ขึ้นอยู่กับการนำไปใช้ ประโยชน์อาจปรากฏเป็นการทำพื้นฐานให้ดียิ่งขึ้น การแสดงผลที่เชื่อถือได้มากขึ้น การทั่วไปที่ดีขึ้น ความหน่วงเวลาที่ต่ำลง การย้ายหน่วยความจำที่ลดลง ความรับผิดชอบที่ชัดเจน หรือขอบเขตที่ปลอดภัยระหว่างข้อเสนอของโมเดลกับการกระทำจริง
ประโยชน์ควรอธิบายเป็นการตัดสินใจและการวัดผล “ฉลาดกว่า” ไม่ใช่เกณฑ์การยอมรับสำหรับการประมวลผลภาษาธรรมชาติ เป้าหมายที่มีประโยชน์อาจระบุอัตราความผิดพลาดในกรณียาก การฟื้นตัวหลังจากหลักฐานขัดแย้ง ค่าใช้จ่ายที่ระดับเปอร์เซ็นไทล์ของทราฟฟิก เวลาในการตรวจสอบโดยมนุษย์ การปรับเทียบ หรือเปอร์เซ็นต์ของการกระทำที่คงอยู่ภายในขอบเขตอำนาจที่กำหนด
โหมดความล้มเหลวที่กำหนดการประมวลผลภาษาธรรมชาติ
ข้อจำกัดหลักคือภาษามีความคลุมเครือ วัฒนธรรม และอำนาจ ดังนั้นโมเดลที่มีตัวเลขแข็งแรงอาจยังทำให้ผู้ใช้ล้มเหลวได้ ความล้มเหลวนี้ไม่ใช่สิ่งที่เพิ่มเข้ามาหลังการพัฒนาเสร็จแล้ว แต่ควรกำหนดการเก็บข้อมูล สถาปัตยกรรม สิทธิ์การเข้าถึง การประเมิน ประตูการปล่อย และการเฝ้าติดตามสำหรับการประมวลผลภาษาธรรมชาติตั้งแต่เริ่มต้น
การควบคุมสำหรับการประมวลผลภาษาธรรมชาติเป็นประโยชน์เฉพาะเมื่อทำงานก่อนผลลัพธ์ที่มีค่าใช้จ่ายสูงหรือไม่สามารถย้อนกลับได้ ระบุสัญญาณล่วงหน้าที่สังเกตได้ที่สุดของความล้มเหลว ตั้งค่าขีดจำกัดหรือกฎมอบหมายเจ้าของรับผิดชอบและทดสอบการฟื้นตัว ขึ้นอยู่กับกรณีการใช้งาน การฟื้นตัวอาจหมายถึงการละเลย ระบบสำรองที่ง่ายกว่า ขอหลักฐานเพิ่มเติม ส่งต่อให้คนดูแล ย้อนกลับโมเดล หรือหยุดการกระทำทั้งหมด
แผนการประเมินผลสำหรับการประมวลผลภาษาธรรมชาติ
เริ่มการประเมินการประมวลผลภาษาธรรมชาติด้วยการเขียนการตัดสินใจที่หลักฐานต้องสนับสนุน กำหนดกลุ่มผู้ใช้ที่ทำงาน ผลลัพธ์ของผลลัพธ์ที่ผิดพลาด ข้อมูลที่มีจริงในเวลาตัดสินใจ และทางเลือกที่เชื่อถือได้ที่ง่ายที่สุด วิธีนี้ป้องกันไม่ให้เบนช์มาร์คกลายเป็นเป้าหมายเพียงเพราะทำได้ง่าย
ใช้ชุดทดสอบที่ยังไม่ถูกใช้สำหรับการเปรียบเทียบที่ควบคุม แล้วตรวจสอบการประมวลผลภาษาธรรมชาติในสภาพแวดล้อมการทำงานแบบขั้นตอน การประเมินแบบออฟไลน์ทำให้ตัวแปรเปรียบเทียบได้; โหมดเงา, canaries, การจำกัดอัตรา, หรือประตูอนุมัติเปิดเผยว่าการจราจรจริง, วงจรป้อนกลับ, และผู้ใช้เปลี่ยนพฤติกรรมอย่างไร ขั้นตอนการเปิดใช้งานควรมีเงื่อนไขการหยุดอย่างชัดเจน แทนการสมมติว่าการปรับปรุงทุกอย่างสมควรปล่อยเต็มที่
ระบุเวอร์ชันของอินพุตที่จำเป็นเพื่อทำซ้ำการประมวลผลภาษาธรรมชาติ: ข้อมูลต้น, การเตรียมข้อมูล, tokenizer หรือ encoder, น้ำหนักโมเดล, การตั้งค่า, prompt หรือ policy, ดัชนีการดึงข้อมูล, ชุดประเมิน, สมมติฐานฮาร์ดแวร์, และโค้ดให้บริการตามความเหมาะสม หากไม่มีบันทึกเชิงสายพันธุ์ ทีมไม่สามารถบอกได้ว่าผลลัพธ์ที่เปลี่ยนแปลงมาจากเทคนิค, สภาพแวดล้อม หรือการแก้ไข pipeline ที่ไม่ได้สังเกต
สุดท้ายถามว่าข้อค้นพบใดจะทำให้ข้ออ้างว่าการประมวลผลภาษาธรรมชาติเชื่อถือได้เป็นเท็จ หากไม่มีผลลัพธ์ใดที่สามารถย้อนกลับการตัดสินใจรับใช้ได้ การประเมินก็เป็นการตลาด การกำหนดเกณฑ์การยอมรับล่วงหน้าและชุดยืนยันที่เก็บไว้ทำให้การฝึกฝนกลายเป็นหลักฐาน
คำถามที่ควรถามก่อนนำการประมวลผลภาษาธรรมชาติมาใช้
- Objective: การประมวลผลภาษาธรรมชาติมุ่งแก้คอขวดใดที่วัดผลได้?
- Mechanism: ขั้นใดในห้าขั้นมีการแปลงที่เป็นเอกลักษณ์?
- Baseline: เมื่อเทียบกับการจับคู่คำสำคัญแบบง่ายที่ไม่คำนึงถึงลำดับและบริบท หรือทางเลือกที่ง่ายกว่า วิธีนี้แตกต่างอย่างไร?
- Evidence: มีการทดสอบกรณีทั่วไป กรณียาก กรณีปรปักษ์ และกรณีของกลุ่มย่อยใดบ้าง?
- Operations: เมื่อใช้ในวงกว้าง จะมีต้นทุนด้านเวลาแฝง หน่วยความจำ การประมวลผล พลังงาน การบำรุงรักษา และการทบทวนเท่าใด?
- Risk: ทีมจะตรวจจับได้อย่างไรว่าภาษาสะท้อนความกำกวม วัฒนธรรม และอำนาจ จนโมเดลที่มีผลลัพธ์เชิงตัวเลขสูงยังอาจทำให้ผู้ใช้ได้รับผลเสีย?
- Recovery: ระบบสามารถงดตอบ ใช้วิธีสำรอง ย้อนกลับ หรือส่งต่อก่อนเกิดอันตรายได้หรือไม่?
แหล่งข้อมูลหลักสำหรับศึกษาการประมวลผลภาษาธรรมชาติ
จุดเริ่มต้นที่เป็นอำนาจสำหรับส่วนของสแตก AI ที่เกี่ยวกับการประมวลผลภาษาธรรมชาติรวมถึง กลไกความสนใจคือทุกสิ่ง, LoRA research paper, Direct Preference Optimization. อ่านคู่กับเอกสารของโมเดล, ชุดข้อมูล, ฮาร์ดแวร์, และเขตอำนาจที่เกี่ยวข้อง แหล่งข้อมูลทั่วไปอาจกำหนดกลไกได้ แต่เพียงหลักฐานที่เฉพาะเจาะจงต่อการเปิดใช้เท่านั้นที่สามารถยืนยันว่าการนำไปใช้เฉพาะกรณีนั้นเหมาะสม
สิ่งที่ควรจำเกี่ยวกับการประมวลผลภาษาธรรมชาติ
การประมวลผลภาษาธรรมชาติเป็นกลไกที่กำหนดภายในระบบสังคมเทคนิคที่ใหญ่ขึ้น มูลค่าของมันมาจากการปรับปรุงผลลัพธ์เฉพาะภายใต้เงื่อนไขที่ชัดเจน ไม่ได้มาจากชื่อป้ายเท่านั้น แผนผังห้าขั้นตอนทำให้การไหลของข้อมูลเป็นที่มองเห็นได้ การเปรียบเทียบระบุสิ่งที่มันไม่ใช่ และเส้นทางการควบคุมแสดงจุดที่ผู้ปฏิบัติการที่รับผิดชอบสามารถแทรกแซงได้
กฎปฏิบัติสำหรับการประมวลผลภาษาธรรมชาติคือการกำหนดวัตถุประสงค์, เปรียบเทียบกับฐานที่เชื่อถือได้, ทดสอบความล้มเหลวที่สำคัญที่สุด, และเก็บหลักฐานที่จำเป็นเพื่อเฝ้าติดตามการเปลี่ยนแปลง เมื่อมีชิ้นส่วนเหล่านี้ครบถ้วน แนวคิดจะกลายเป็นทางเลือกด้านวิศวกรรมและการกำกับดูแลที่สามารถประเมินได้ หากไม่มีส่วนเหล่านี้ มันยังคงเป็นชื่อที่ให้ความหวังแต่ติดกับความเสี่ยงการดำเนินงานที่ไม่ทราบแน่ชัด



