
Fundamentos de IA
Como funciona a classificação de texto?

 Adicione Unite.AI às suas fontes preferidas no Google
Classificação de texto atribui um ou mais rótulos a um documento, mensagem ou trecho de texto. Exemplos incluem detecção de spam, roteamento de intenção, análise de sentimento, marcação de tópicos, moderação e priorização de tickets de suporte.
Um classificador em produção é mais que um modelo. Ele depende de uma taxonomia de rótulos precisa, anotações representativas, divisões à prova de vazamento, uma regra de decisão calibrada e monitoramento de mudanças na linguagem e na prevalência das classes.
Principais pontos
- Defina rótulos e casos ambíguos antes de escolher uma arquitetura.
- Modelos simples de bolsa de palavras ainda são valiosos; codificadores pré‑treinados adicionam contexto e aprendizado por transferência.
- A acurácia pode ocultar desempenho ruim em classes minoritárias, portanto use métricas sensíveis à classe e análise de erros.
- Calibração de probabilidade, abstenção e revisão humana transformam pontuações em decisões mais seguras.
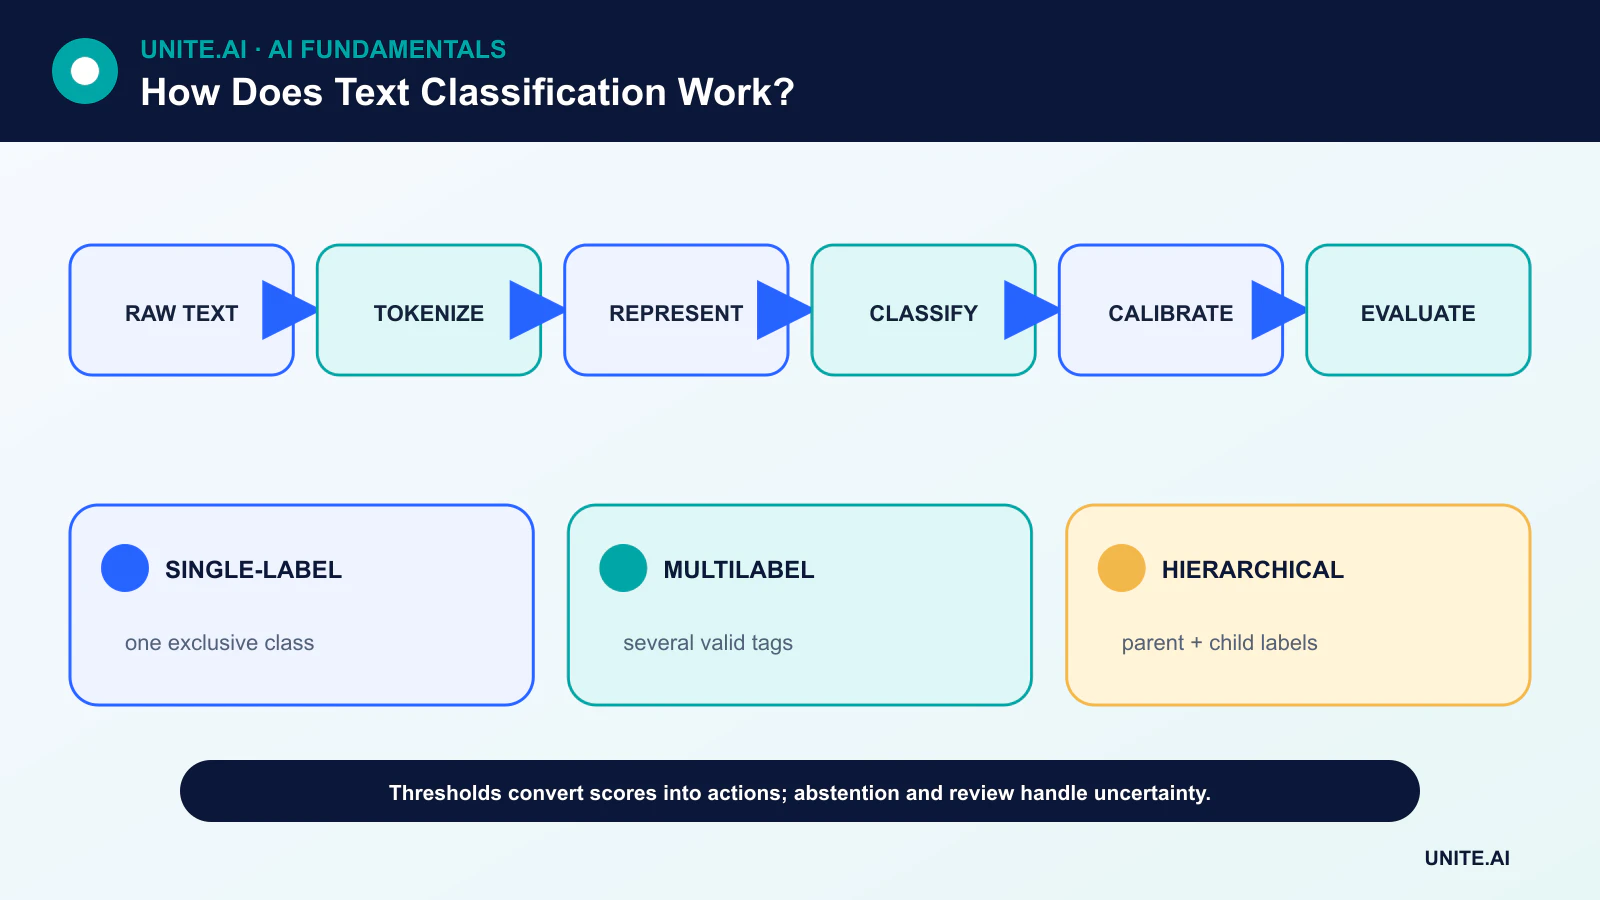
Definir a taxonomia e a política de anotação
Uma tarefa de rótulo único escolhe uma classe mutuamente exclusiva. Uma tarefa multilabel pode atribuir várias etiquetas independentes. Taxonomias hierárquicas contêm rótulos pai e filho. Esses são problemas de aprendizagem diferentes e exigem saídas e métricas distintas.
Os anotadores precisam de definições, exemplos positivos e negativos, regras para contexto ausente e um caminho de escalonamento. Estatísticas de concordância podem revelar uma tarefa pouco clara, mas discordâncias também podem representar ambiguidade genuína que o sistema deve preservar.
Representando texto
Pipelines tradicionais utilizam contagem de tokens, n‑grams e TF‑IDF com classificadores lineares ou máquinas de vetor de suporte. Eles treinam rapidamente, revelam termos influentes e fornecem uma base sólida.
Sistemas neurais mapeiam tokens para embeddings. Codificadores transformer pré‑treinados usam atenção para gerar representações contextuais e podem ser ajustados com exemplos rotulados. Classificadores com prompts ou zero‑shot podem reduzir a rotulagem inicial, mas a formulação dos rótulos, a versão do modelo e a calibração devem ser avaliadas no domínio real.
Treinamento sem vazamento
O conjunto de dados é dividido em treinamento, validação e teste final. Documentos quase duplicados, mensagens da mesma conversa ou modelos da mesma fonte devem permanecer em uma mesma divisão. Para uso dependente de tempo, uma divisão cronológica representa melhor a implantação.
O desequilíbrio de classes pode ser tratado por ponderação, reamostragem, seleção de limiar ou dados adicionais. Exemplos sintéticos não devem substituir a revisão de falhas reais de classes minoritárias e podem introduzir artefatos que o modelo aprende com facilidade.
Métricas e decisões calibradas
Uma matriz de confusão mostra quais rótulos são confundidos. Precisão mede quantos positivos previstos estão corretos; recall mede quantos verdadeiros positivos são encontrados. Médias macro ponderam as classes igualmente, enquanto médias micro ponderam exemplos individuais.
Uma pontuação bruta de softmax não é automaticamente uma probabilidade confiável. A calibração compara a confiança com a correção observada. As equipes podem definir limiares específicos por classe, abster‑se quando a confiança é baixa e encaminhar casos sensíveis a um revisor.
Implantação, uso multilíngue e deriva
O texto muda com produtos, eventos, gírias e comportamentos adversários. O monitoramento deve rastrear idioma de entrada, comprimento, padrões fora do vocabulário, taxas de classe, confiança e resultados atrasados. Re‑treinamento requer dados versionados e um conjunto de regressão com exemplos importantes.
O desempenho multilíngue deve ser testado por idioma e dialeto. Traduzir tudo para um único idioma pode alterar o sentimento ou entidades; um codificador multilíngue ainda pode apresentar desempenho desigual porque seu pré‑treinamento e rótulos não são igualmente representativos.
Representações e famílias de classificadores
A classificação de texto mapeia um documento, sentença ou sequência de tokens para um ou mais rótulos. Defina se os rótulos são mutuamente exclusivos, multilabel, hierárquicos, ordenados ou de conjunto aberto. Pipelines tradicionais tokenizam o texto, constroem recursos de bolsa de palavras ou TF‑IDF e treinam regressão logística, Naive Bayes ou um SVM linear. Sistemas neurais aprendem embeddings com convolução, recorrência ou transformers. Modelos de linguagem com prompt podem classificar sem treinamento específico da tarefa, mas restrições de saída, custo, deriva e evidência ainda precisam ser avaliados em relação a bases mais simples.
O pré‑processamento depende da representação. Converter para minúsculas ou remover pontuação pode destruir sinais de nomes, sentimento, código ou idioma; stemming pode mesclar significados distintos. Tokenizadores de transformer operam em subpalavras e têm limites de comprimento, portanto a estratégia de truncamento é importante. Documentos longos podem exigir fragmentação e agregação. Preserve o texto bruto e a versão da transformação, e divida por autor, conversa, fonte ou tempo para evitar que quase duplicatas e modelos recorrentes cruzem treinamento e teste.
Rótulos, métricas e análise de erros
Um guia de anotação deve definir escopo, exemplos, casos ambíguos e uma opção desconhecida ou de abstenção. Meça a concordância e adjudique discordâncias ao invés de ocultá‑las com voto da maioria. Para classes desequilibradas, a acurácia é insuficiente; relate precisão, recall, F1, confusão, calibração e carga de trabalho específica por limiar e classe. Tarefas multilabel precisam de métricas micro, macro e ao nível de rótulo. Avalie idiomas, dialetos, domínios, comprimento de mensagens e tempo. Uma divisão aleatória pode superestimar a qualidade quando vocabulário ou modelos mudam.
A análise de erros deve separar falha de representação, contexto insuficiente, ambiguidade de rótulo, vocabulário raro, negação, sarcasmo e indícios espúrios. Use testes contrafactuais que alterem nomes, marcadores de dialeto ou metadados irrelevantes mantendo o sentido. Inspecione erros de alta confiança e casos rejeitados. Um modelo pode aprender que um canal do cliente ou assinatura prediz um rótulo ao invés de interpretar o conteúdo. Remova vazamentos e revise os dados antes de simplesmente aumentar a capacidade do modelo.
Projeto de produção
Forneça um tokenizador e modelo fixos com validação de esquema, limites de comprimento, loteamento e fallback para idioma não suportado ou baixa confiança. Monitore a distribuição de entrada, taxas de rótulo, calibração, latência e resultados revisados. Proteja o texto pois pode conter instruções pessoais, confidenciais ou adversárias. Para moderação automatizada, elegibilidade ou roteamento, ofereça recurso e meça erros discrepantes. Versione rótulos e limiares de acordo com a política de negócios. A classificação de texto é confiável apenas dentro do seu sistema de rótulos definido e da distribuição de dados; explicações fluentes do modelo não provam que uma classificação está correta.
Exemplo prático: classificando solicitações de suporte recebidas
Uma equipe de suporte define rótulos de roteamento mutuamente exclusivos, além de sinalizadores de urgência, multilíngue e desconhecido. Os anotadores rotulam mensagens desidentificadas com orientações para questões mistas e medem a concordância. Uma linha de base logística TF‑IDF, codificador ajustado e modelo com prompt utilizam o mesmo conjunto de teste baseado em tempo. O relatório de avaliação apresenta precisão e recall por classe, falsos negativos urgentes, calibração, validade do esquema, latência e custo, com modelos quase duplicados agrupados para evitar vazamento.
O classificador implantado valida idioma e comprimento, abstém‑se diante de evidências fracas e permite que agentes corrijam rotas. Prompts e mensagens são tratados como não confiáveis; o acesso a ferramentas está ausente. O monitoramento acompanha a prevalência de rótulos, confiança, correções, tempo de resposta e tópicos emergentes. Uma mudança de política ou produto atualiza a taxonomia e os dados de re‑treinamento por meio de revisão. O sistema melhora a alocação na fila, mas nunca infere emoção ou direito do cliente além dos rótulos validados.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atrativo.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use um lançamento em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
A análise de sentimento é uma tarefa de classificação de texto?
Normalmente sim, mas o sentimento pode ser multilabel, baseado em aspectos ou contínuo, em vez de um único rótulo positivo/neutral/negativo.
Quando um classificador de texto deve abster‑se?
Quando a confiança é baixa, o texto está fora do escopo, o contexto necessário está ausente ou o custo de uma ação automática incorreta supera o custo da revisão.
Referências principais












