Fundamentos de IA
O que é Análise de Sentimento? Métodos, Usos e Limitações

 Adicione Unite.AI às suas fontes preferidas no Google
A análise de sentimento estima a linguagem avaliativa em texto, transcrições de fala ou outro conteúdo. Um sistema pode classificar a polaridade como positiva, negativa ou neutra; detectar opiniões em nível de aspecto; estimar a intensidade; ou identificar a postura em relação a uma afirmação específica.
O alvo deve ser definido cuidadosamente. Sentimento não é o mesmo que emoção, intenção, toxicidade, satisfação ou verdade. Uma frase positiva pode descrever um evento prejudicial de forma sarcástica, enquanto uma avaliação negativa de um produto ainda pode recomendar o produto como um todo.
Principais pontos
- Defina unidade, alvo, rótulos e contexto antes de coletar exemplos.
- Lexicons são linhas de base transparentes; modelos supervisionados e de transformadores podem capturar mais contexto, mas precisam de dados representativos.
- Negação, sarcasmo, vocabulário de domínio, texto multilíngue e limites de aspecto continuam difíceis.
- Avalie por classe, subgrupo, domínio e período; inclua revisão humana para usos com consequências.
Níveis e alvos
A análise ao nível de documento produz um rótulo para todo o item. A análise ao nível de frase separa as declarações, enquanto a análise baseada em aspectos vincula o sentimento a uma entidade ou atributo — por exemplo, positivo quanto à qualidade da imagem, mas negativo quanto à duração da bateria.
Postura pergunta se um falante apoia uma proposição específica, o que pode diferir do tom emocional. Essas distinções devem ser definidas no guia de anotação antes de aplicar métodos de classificação de texto.
Lexicons, modelos clássicos e transformadores
Um lexicon atribui pontuações às palavras e as combina com regras de negação ou intensidade. É interpretável e barato, mas tem dificuldade com contexto. Modelos supervisionados clássicos utilizam recursos de palavra ou n‑gramas, enquanto transformadores aprendem representações contextuais e podem ser ajustados finamente.
Prompting de poucos exemplos pode ser conveniente, mas as saídas dependem dos exemplos e da formulação. Compare cada abordagem complexa com uma linha de base e use aprendizado de poucos exemplos apenas com um conjunto de avaliação reservado e versionado.
Desafios de dados e linguagem
Os rótulos podem refletir a perspectiva do anotador em vez de um fato objetivo. A mudança de domínio é severa: ‘imprevisível’ pode ser elogio para um filme e crítica para um veículo. Alternância de código, dialeto, emojis, discurso citado e ironia complicam os sinais ao nível de token.
Equilibre as classes intencionalmente e evite que autores, produtos ou conversas relacionados vazem entre treinamento e teste. Um modelo que memoriza uma marca ou falante pode parecer preciso sem aprender sentimento.
Avaliação e uso responsável
Reporte precisão, recall, F1 e uma matriz de confusão em vez de apenas acurácia. Revise erros por aspecto, comprimento, dialeto e tempo, e calibre limites considerando o custo operacional de cada erro.
Tendências agregadas podem apoiar pesquisa ou triagem, mas inferir o estado de um indivíduo ou tomar decisões de emprego, crédito, saúde ou policiamento gera maior risco. Forneça incerteza, contexto de origem, controles de privacidade e revisão humana.
Anotação e construção de conjunto de dados
Elabore um guia de anotação com entidade alvo, unidade de análise, definições de rótulos, tratamento de mistos e neutros, regras de citação, política de sarcasmo e exemplos do domínio. Faça um piloto com vários anotadores, calcule concordância, discuta divergências e revise a tarefa antes de escalar os rótulos.
A amostragem determina o que o modelo aprende. Um fluxo de mídia social pode superrepresentar contas altamente ativas; tickets de suporte podem omitir clientes satisfeitos; avaliações por estrelas podem não corresponder ao texto da revisão. Preserve metadados de origem e tempo, respeite os termos da plataforma e a privacidade, e crie um conjunto de teste a partir da população onde as decisões serão tomadas.
Vazamento de rótulos pode ocorrer por meio de avaliações, emojis inseridos pelo sistema de coleta, assinaturas padronizadas ou nomes de produtos correlacionados ao sentimento. Desduplicar postagens quase idênticas e agrupar conversas ou autores para que sua linguagem não apareça em ambos os lados de uma divisão.
Escolhas de modelagem e calibração
Sistemas de lexicon somam pontuações de palavras e ajustam para negação, intensificadores, pontuação ou emojis. Eles fornecem uma verificação de sanidade útil e podem ser adaptados com termos de domínio. Modelos lineares com recursos TF–IDF continuam competitivos em alguns conjuntos de dados e revelam n‑grams influentes.
Codificadores contextuais representam palavras de acordo com o texto circundante e podem ser ajustados finamente para polaridade ou aspectos. Documentos longos podem necessitar de modelos hierárquicos, agregação de sentenças ou recuperação de trechos relevantes. Abordagens multilíngues podem treinar um modelo compartilhado, traduzir para uma língua pivô ou manter modelos locais; cada uma tem cobertura e trade‑offs culturais.
A calibração de probabilidade importa quando pontuações acionam ações. Gráficos de confiabilidade e erro de calibração esperado revelam se uma confiança reportada de 0,8 corresponde a cerca de 80% de acurácia. Limiares podem criar uma faixa de abstenção para revisão humana, e limiares separados podem ser justificados quando os custos de erro diferem — não para ocultar qualidade desigual.
Aplicações e interpretações equivocadas comuns
Sentimento agregado pode ajudar a priorizar temas, comparar reações de campanhas ou direcionar mensagens de serviço urgentes. Análise de aspecto costuma ser mais acionável que a polaridade geral porque identifica o que as pessoas discutem. Análise de tendências requer amostragem estável e definições de rótulos ao longo do tempo.
Não equilibre a prevalência de postagens negativas com a opinião da população. Comportamento de postagem, bots, moderação, demografia da plataforma, campanhas e consultas de coleta moldam a amostra. Um modelo de sentimento não mede a população silenciosa, e uma mudança na redação pode parecer uma mudança de atitude.
Para decisões individuais, rótulos falsos podem ser estigmatizantes e difíceis de contestar. Evite usar sentimento como proxy para engajamento de funcionários, saúde mental, confiabilidade de crédito, intenção ou engano. Quando as pessoas são afetadas, mostre o contexto de origem, permita correções e exija um tomador de decisão humano com real discrição.
Exemplo prático: análise de sentimento para feedback de clientes
Uma empresa que analisa comentários de suporte deve definir se precisa de sentimento de documento, sentimento de aspecto, emoção, urgência ou classificação de problema. “A entrega foi rápida, mas o produto quebrou” não pode ser representado fielmente por um único rótulo positivo ou negativo. Crie um guia de anotação para alvos, negação, sarcasmo, declarações mistas, discurso citado e casos desconhecidos, então meça a concordância antes de tratar os rótulos como verdade de base.
Compare um lexicon ou linha de base linear com um codificador ajustado finamente ou modelo de linguagem com prompt. Divida os dados por tempo ou cliente para evitar vazamento de quase‑duplicatas, e preserve a prevalência de classes. Reporte precisão, recall, F1, calibração e confusão por idioma, canal, produto e proxies demográficos apenas onde for legal e justificado. Revise erros de alta confiança porque são mais perigosos no roteamento automatizado do que saídas incertas que são escaladas.
Use sentimento como um sinal para agregação ou priorização, não como medida incontestável do estado de uma pessoa. Monitore vocabulário e deriva de produto, re‑treine com exemplos revisados e permita que agentes corrijam rótulos. Nunca infira traços protegidos ou discipline trabalhadores a partir de pontuações de sentimento não validadas. Para relatórios executivos, mostre tamanho da amostra, incerteza, dados ausentes e os tópicos que impulsionam a mudança, de modo que uma pontuação flutuante leve à investigação em vez de a uma conclusão simplista.
A implantação multilíngue não deve assumir que traduzir entradas preserva tom, negação, idioma ou convenção cultural. Valide cada idioma suportado e padrão de linguagem mista com revisores nativos, e forneça um resultado desconhecido quando a evidência for fraca. A adaptação de domínio também importa: palavras que soam negativas em conversa comum podem ser descrições técnicas neutras. Mantenha limiares ou modelos separados apenas quando evidências operacionais justificarem a complexidade adicional e a carga de governança.
Lista de verificação de implementação prática
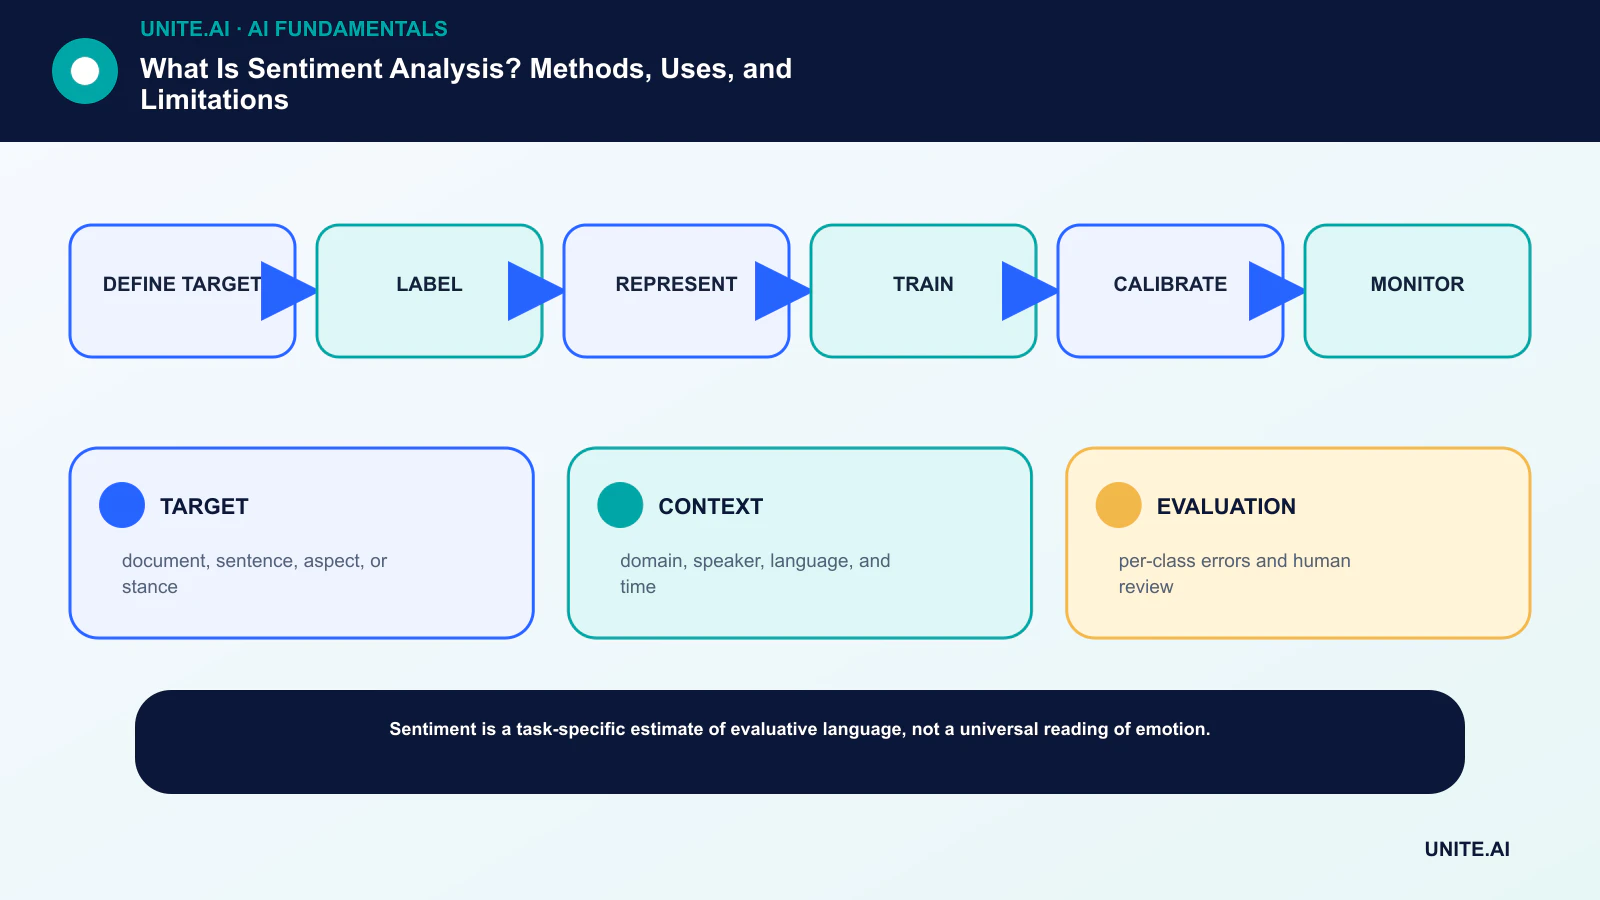
Transforme o conceito em um fluxo de trabalho delimitado e testável: defina alvo → rótulo → representação → treinamento → calibração → monitoramento. Nomeie um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e interrupção, teste falhas representativas e defina monitoramento, reversão e revisão antes de expandir o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, realize uma revisão de prontidão documentada com as pessoas que constroem, operam, asseguram e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e riscos não resolvidos. Defina quem pode aprovar o lançamento, alterar um limiar, sobrescrever uma saída ou interromper a operação. Revise a decisão após a chegada de dados reais, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- TARGET: documento, frase, aspecto ou postura.
- CONTEXT: domínio, falante, idioma e tempo.
- EVALUATION: erros por classe e revisão humana.
Perguntas frequentes
A análise de sentimento é objetiva?
Não. Ela estima rótulos definidos por uma tarefa e processo de anotação. Alguns textos são genuinamente ambíguos, mistos, dependentes de contexto ou interpretados de forma diferente pelos leitores.
A análise de sentimento pode detectar sarcasmo?
Os modelos podem aprender alguns padrões, mas o sarcasmo frequentemente depende do histórico do falante, conhecimento compartilhado e contexto fora do texto. Ele continua sendo um modo de falha comum.
Referências principais