
Fundamentos de IA
O que é Reconhecimento de Fala Conversacional (CSR)?

 Adicione Unite.AI às suas fontes preferidas no Google
O reconhecimento de fala conversacional (CSR) amplia o reconhecimento automático de fala além da transcrição isolada ao utilizar contexto de diálogo, sinais de tomada de turno, informações de falante e processamento de baixa latência. O objetivo é suportar uma interação ao vivo em que palavras, tempo, interrupções e turnos anteriores são todos relevantes.
O CSR é um rótulo emergente de produto e pesquisa, não uma classe de modelo padronizada única. Um sistema robusto combina ASR em streaming com detecção de ponto final, gerenciamento de falantes, modelagem de linguagem contextual, estado de diálogo e uma política de resposta, avaliando a experiência de ponta a ponta.
Principais pontos
- O reconhecimento em streaming emite hipóteses provisórias e as revisa à medida que mais áudio chega.
- A detecção de ponto final e a previsão de turno são independentes da precisão da transcrição.
- O histórico de conversa e palavras‑chave podem melhorar o reconhecimento, mas também propagar erros anteriores.
- Avalie latência, interrupções, falantes, sotaques, ruído, privacidade e conclusão de tarefas — não apenas a taxa de erro de palavras.
Do ASR ao diálogo ao vivo
O ASR tradicional mapeia áudio para texto. Um sistema conversacional deve decidir quando ouvir, quando um turno está completo, se a fala é dirigida ao sistema e como se recuperar quando sua transcrição ou resposta está errada.
Modelos de streaming processam quadros incrementalmente e produzem transcrições parciais. Baixa latência melhora a capacidade de resposta, mas um compromisso prematuro pode aumentar revisões ou erros. A aplicação precisa de uma política para texto estável versus provisório.
Tomada de turno, sobreposição e falantes
A duração do silêncio por si só é um sinal de ponto final fraco. A conclusão lexical, prosódia, tempo, olhar e o estado do diálogo podem ajudar a prever se uma pessoa está mantendo ou cedendo a palavra. A interrupção (barge‑in) permite que o usuário interrompa a fala sintetizada sem perder o contexto.
Vozes sobrepostas e diarização ainda são difíceis. Os sistemas devem preservar a incerteza sobre o falante, evitar atribuir uma declaração à pessoa errada e oferecer um caminho de correção — especialmente para registros usados em saúde, finanças ou trabalhos jurídicos.
Reconhecimento contextual
Turnos anteriores podem desambiguar nomes e referências; listas de palavras‑chave podem direcionar o reconhecimento para termos do domínio. Modelos de linguagem de fala podem codificar o contexto de áudio e texto em uma estrutura compartilhada de prompting ou atenção.
O contexto também pode reforçar uma transcrição anterior equivocada ou vazar informações entre sessões. Limite o histórico ao propósito atual, separe metadados confiáveis da fala do usuário e use contexto de transformer com regras explícitas de retenção e acesso.
Avaliação e implantação responsável
Reporte a taxa de erro de palavras em streaming, latência do primeiro token e da finalização, taxa de revisão, erros de ponto final, sucesso de barge‑in, atribuição de falante e conclusão de tarefas. Teste microfones reais, ruído, sotaques, mudança de código, deficiências e fala carregada de emoção.
Dados de voz podem identificar ou revelar informações sensíveis. Aplique consentimento, minimização, criptografia, limites de retenção e revisão humana. Conecte respostas geradas aos controles de segurança de chatbots, pois transcrição precisa não torna uma resposta correta ou autorizada.
Da entrada acústica ao estado conversacional
Um sistema de fala conversacional captura áudio, aplica condicionamento de sinal, detecta fala, reconhece palavras ou unidades semânticas, identifica falantes quando necessário e atualiza o estado do diálogo. Sistemas de streaming produzem hipóteses parciais antes que uma enunciação termine. Essas hipóteses podem mudar, portanto os componentes subsequentes devem distinguir resultados provisórios dos finais.
A detecção de atividade de voz e a definição de ponto final decidem quando a fala começa e quando o usuário terminou. Limiares fixos de silêncio falham com falantes lentos, ruído de fundo e pausas de reflexão. Modelos de tomada de turno podem usar palavras, prosódia, olhar e contexto de diálogo, mas precisam equilibrar resposta rápida contra interromper o falante.
A diarização responde quem falou quando; o reconhecimento de falante estima identidade; a separação de fontes isola vozes sobrepostas. São tarefas diferentes com riscos distintos. Em reuniões, saúde e atendimento ao cliente, atribuir as palavras corretas à pessoa correta pode ser tão importante quanto a taxa de erro de palavras da transcrição.
Contexto, sobreposição, emoção e recuperação de interação
O contexto conversacional resolve pronomes, elipses, correções, termos de domínio e referências a turnos anteriores. Um sistema pode combinar evidências acústicas com o histórico de diálogo e conhecimento recuperado, mas o contexto prévio também pode enviesar o reconhecimento para uma expectativa incorreta. Preserve evidências de áudio e confiança para que o contexto não sobrescreva silenciosamente a incerteza.
O diálogo natural inclui backchannels, interrupções, inícios falsos, risos, mudança de código e fala simultânea. Um agente responsivo precisa de tratamento de barge‑in: interromper ou reduzir sua saída, capturar a nova fala do usuário, decidir se a interrupção altera a intenção e recuperar sem duplicar ou perder uma ação.
Prosódia e sinais paralinguísticos podem indicar ênfase ou incerteza, mas inferir emoção, saúde ou intenção a partir da voz é propenso a erros e culturalmente dependente. Use essas estimativas com cautela, divulgue-as quando apropriado e não tome decisões importantes com base em um rótulo de emoção não validado.
Avaliação, privacidade e design de produção
A taxa de erro de palavras continua útil, mas a avaliação conversacional também deve medir atribuição de falante, precisão de entidades, sucesso semântico da tarefa, estabilidade de hipóteses parciais, latência de ponto final, sucesso de interrupção, recuperação e taxa de correção do usuário. Segmente por sotaque, idioma, dispositivo, ruído, sobreposição, estilo de fala e condições de rede.
A arquitetura de streaming requer buffers limitados, backpressure, reconexão, números de sequência e finalização explícita. Mantenha os orçamentos de latência do modelo e do diálogo separados, rastreie cada estágio e teste redes degradadas. Quando um sistema aciona ações, confirme a intenção de alto impacto e torne as tentativas de novo idempotentes para que áudio repetido ou reconexões não dupliquem transações.
A fala contém identidade, conteúdo, ambiente e informações de terceiros. Minimize a retenção, criptografe o transporte e o armazenamento, controle o acesso, defina exclusão e distinga áudio de transcrições e embeddings derivadas. Forneça indicadores visíveis de gravação e alternativas quando o consentimento estiver ausente. Um modelo local pode reduzir a transferência, mas ainda requer permissão e controles de ciclo de vida.
Exemplo prático: um agente de voz lidando com interrupção e correção
Um chamador diz: ‘Reserve terça‑feira — não, quarta‑feira à tarde’, enquanto o agente começa a responder após ‘terça‑feira’. O reconhecimento em streaming emite transcrições parciais em mudança, a detecção de ponto final identifica fala contínua e o barge‑in interrompe a saída. O estado do diálogo marca a data anterior como substituída em vez de criar duas solicitações. A confirmação de entidade foca na data e horário corrigidos, enquanto o sistema mantém confiança e evidência para a interpretação final.
A arquitetura separa captura de áudio, detecção de fala, reconhecimento em streaming, gerenciamento de falantes, política de diálogo, execução de ferramentas e síntese. Números de sequência e finalização evitam que resultados parciais tardios sobrescrevam a transcrição final. A ferramenta de reserva aceita uma solicitação estruturada, verifica autorização e disponibilidade, e usa uma chave de idempotência. Uma reserva consequente é lida de volta e confirmada antes da execução; uma reconexão não pode repeti‑la silenciosamente.
Os testes combinam precisão de palavras e de entidades com latência de ponto final, sucesso de interrupção, tratamento de correção, atribuição de falante, conclusão de tarefa e taxa de ações duplicadas. Os cenários cobrem ruído, sobreposição, sotaques, mudança de código, fala lenta, dispositivos assistivos, redes fracas e ataques sintéticos. A retenção de áudio é minimizada e divulgada, os dados de terceiros são tratados explicitamente, e os usuários podem mudar para texto ou para um humano. A inteligência conversacional é medida pela recuperação segura e pelo resultado, não apenas pela precisão da transcrição.
Lista de verificação prática de implementação
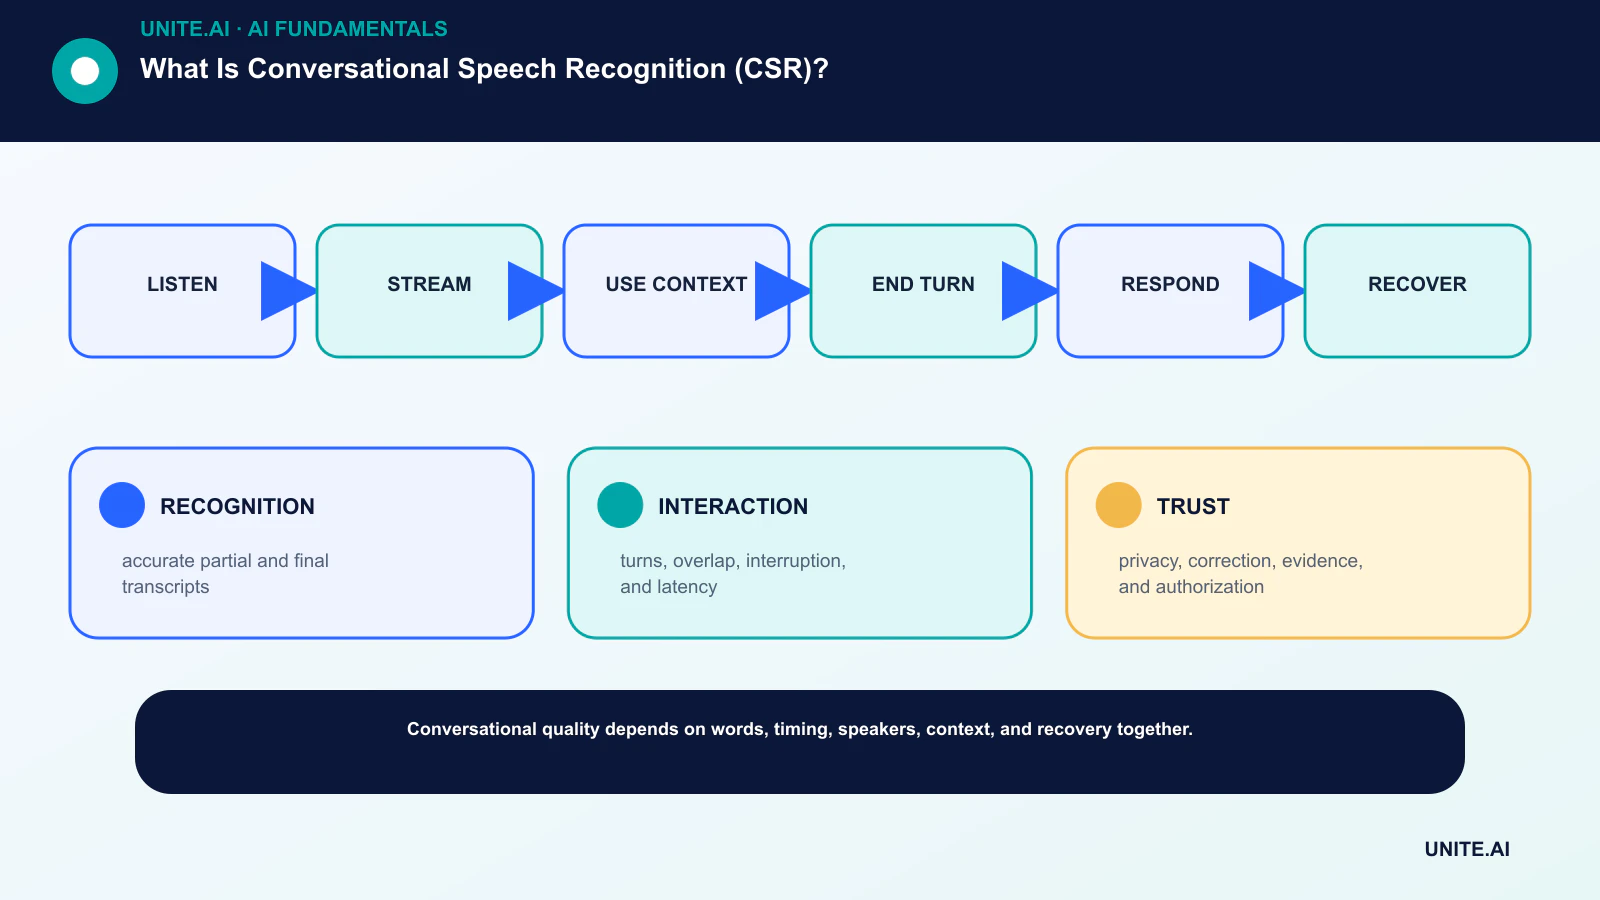
Transforme o conceito em um fluxo de trabalho delimitado e testável: ouvir → transmitir → usar contexto → encerrar turno → responder → recuperar. Defina um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e parada, teste falhas representativas e defina monitoramento, reversão e revisão antes de ampliar o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, realize uma revisão de prontidão documentada com as pessoas que constroem, operam, asseguram e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e os riscos não resolvidos. Defina quem pode aprovar a liberação, alterar um limiar, sobrescrever uma saída ou interromper a operação. Revise a decisão após a chegada de dados do mundo real, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- RECONHECIMENTO: transcrições parciais e finais precisas.
- INTERAÇÃO: turnos, sobreposição, interrupção e latência.
- CONFIANÇA: privacidade, correção, evidência e autorização.
Perguntas frequentes
O CSR é diferente de ASR?
O ASR é o componente de fala‑para‑texto. O CSR utiliza o ASR mais contexto de diálogo, temporização, gerenciamento de falante e ponto final, e políticas de interação para conversas ao vivo.
Uma taxa de erro de palavras mais baixa garante um agente de voz melhor?
Não. Um sistema pode transcrever com precisão e ainda assim interromper usuários, responder lentamente, atribuir falantes incorretamente ou executar a ação errada. Métricas de interação de ponta a ponta são necessárias.
Referências principais












