
-
 AIモデルとプラットフォーム8 hours ago
Tesla、営業コスト増加のなか四半期売上高はほぼ横ばい
Teslaは2026年10月21日、2026年第3四半期の決算を発表し、SECに提出したForm 8-Kで、総売上高が280億ドル、GAAPベースの営業利益が7億1,800万ドルだったと報告しました。今回の決算は2026年9月30日に終了した四半期を対象としており、提出書類の別紙99.1として添付された、同社の2026年第3四半期アップデートで公表されました。第3四半期の決算総売上高は280億4,600万ドルで、2025年の同四半期の280億9,500万ドルと比べて、Teslaがアップデートで説明したとおり、前年同期比でほぼ横ばいでした。自動車の売上高は205億6,000万ドル、エネルギー発電・蓄電の売上高は28億8,100万ドル、サービスその他の売上高は46億500万ドルでした。売上総利益は合計で54億9,400万ドルでした。アップデートによると、GAAPベースの売上総利益率は前年同期比で160ベーシスポイント上昇した一方、営業利益率は322ベーシスポイント、調整後EBITDAマージンは114ベーシスポイント低下しました。普通株主に帰属するGAAPベースの純利益は7億8,700万ドル、希薄化後1株当たり0.22ドルでした。非GAAPベースの純利益は16億9,700万ドル、希薄化後1株当たり0.48ドルでした。調整後EBITDAは39億ドルで、利益率は13.9%でした。Teslaによると、売上高が直近12カ月で1,000億ドルを超える四半期を2四半期連続で達成しました。アップデートの前年同期比の内訳で、Teslaは売上高がほぼ横ばいとなった要因として、エネルギー発電・蓄電の売上高の減少(一部は関税関連の顧客への返金によるもの)、車両の平均販売価格の低下、規制クレジット収入の減少、納車台数の減少を挙げました。これらは、サービスの成長、3億ドルの為替差益、主にFSDの契約数増加にけん引された自動車関連付帯販売の増加によって相殺されました。当四半期の規制クレジット収入は1億1,300万ドルで、2025年第3四半期の4億1,700万ドルを下回りました。営業利益については、Super Intelligence (SI)をはじめとする研究開発プロジェクトによる営業費用の増加、2025年CEO業績賞を含む株式報酬費用、販売費・一般管理費の増加が要因として挙げられました。これらは、サービスの売上総利益の増加、車両の地域別・製品構成の改善、リストラ費用の減少、1億ドルの為替差益によって一部相殺されました。キャッシュフローと支出営業活動による純キャッシュフローは62億6,300万ドル、設備投資は47億3,200万ドル、フリーキャッシュフローは15億3,100万ドルでした。四半期末の現金、現金同等物および短期投資は454億4,700万ドルでした。アップデートによると、前四半期比で19億ドル増加した主な要因は、フリーキャッシュフローがプラスだったことです。研究開発費は27億6,100万ドル、販売費・一般管理費は20億1,500万ドルでした。2026年9月30日時点で、総資産は1,575億1,700万ドル、株主資本合計は892億8,900万ドルでした。サービスその他の売上総利益は前四半期から8,600万ドル増加して7億3,400万ドルとなり、Teslaはこれを同部門の過去最高と説明しました。納車、Robotaxi、FSDアップデートによると、Teslaは当四半期に46万4,391台を生産し、前年同期比で4%増加しました。納車台数は48万6,532台で、2%減少しました。当四半期中に1,000万台目の車両を生産・納車し、累計納車台数は1,020万台となりました。Teslaによると、四半期末時点で乗用車の受注残は過去4年間で最大となり、カナダ、オーストラリア、日本、台湾では四半期納車台数の記録を更新し、Gigafactory Berlinでは生産台数の記録を達成しました。Teslaは2026年9月3日、オースティンでCybercabsを使ったRobotaxiの運行を開始しました。アップデートによると、四半期末時点で監視なしのRobotaxi走行距離は累計で約200万マイルに達し、累計走行距離は前四半期比で8倍に増加しました。また、オースティンでの運行時間は現在、午前6時から午前0時までとなっています。CybercabではGrokをGrok BotおよびConnectorsとともに利用でき、アップデートでは、乗客が受信トレイ、カレンダー、ファイル、チャット、タスクにハンズフリーの音声でアクセスできるようになると説明されています。有効なFSD契約数は174万件に達しました。Teslaはこの指標について、前払いと月額契約を含み、無料トライアルを除外すると定義しています。第2四半期末以降、Teslaによると、クロアチア、スロベニア、チェコ、スロバキアで新たに4件のFSD承認を取得し、EU内の9カ国でシステムを利用できるようになりました。これらの国では、最初の承認以降、10万人を超える顧客が合計1億6,000万キロメートル以上を走行しています。アップデートの開示情報には、FSDの利用にはドライバーによる継続的な監視が必要であり、車両が自動運転になるわけではないと記されています。エネルギー貯蔵設備の導入量は13.7 GWhとなり、Teslaはエネルギー貯蔵の受注率と受注残が過去最高に達したと報告しました。Superchargerネットワークは8,904カ所、充電コネクター84,465基に拡大しました。Supercharger for Businessプログラムの充電区画数は600を超え、Teslaは工場で事前組み立てしたAccordion Superchargerと、事前組み立てしたMegachargerを初めて導入しました。Semi、Optimus、エネルギー製造Teslaはネバダ州で、クラス8の大型トラック「Tesla Semi」の量産を開始した。発表によると、最上位モデルは連結総重量が最大82,000ポンドの状態で500マイル走行でき、1マイル当たりの電力消費量は1.7 kWhに抑えられる。Teslaは、同じ積載量を運ぶ同等のディーゼルトラックと比べ、Semiのエネルギー消費量は3分の1で済むと説明した。FremontではOptimusの生産が大規模生産ラインで始まり、同社はラインから出てくるユニットを初の量産品質を備えたロボットと表現し、現在の製造プロセスが商用製品に適していることを実証したと述べた。Teslaは2026年10月15日にNext Gen Roadsterを発表した。Megafactory Texasは、計画生産能力を50 GWhとして生産を開始した。またTeslaは、ネバダ州の工場でLFPセルを使用して製造したMegapackを初出荷した。同社のCortex 1およびCortex 2 SI学習用コンピュートクラスターは、それぞれ105 MW超、120 MW超の性能で稼働中である。Teslaは、年末までにSI学習用コンピュートを400 MWにする計画だと述べ、2027年にはAustinの半導体製造施設で設備の試運転を開始する見込みだとした。見通しとウェブキャスト見通しの項目でTeslaは、工場の稼働率を最大限に高めることに注力し、製品ロードマップと長期的な生産能力の拡大(さらなる垂直統合を含む)に必要な資金を確保できるよう、強固なバランスシートと十分な流動性を維持する方針だと述べた。また同社は、ハードウェア関連の利益に加え、時間の経過とともにSI、ソフトウェア、車両群を基盤とする利益が加速すると見込んでいる。SIコンピュート、太陽光発電、バッテリー材料、半導体製造にまたがる複数年のインフラ計画に関連した生産能力の構築も進行中だという。この8-Kには、Teslaの法務顧問兼コーポレート・セクレタリーであるBrandon Ehrhartが署名した。Teslaは、2026年第3四半期の決算説明会を2026年10月21日午後4時30分(CT)に開催し、ir.tesla.comでライブ配信すると発表した。再生配信は約1年間視聴できる。
-
 AIモデルとプラットフォーム9 hours ago
Meta、第3四半期の売上高が26%増 取締役会は議決権のないクラスC株式を承認
Meta Platformsは2026年10月21日、2026年9月30日に終了した第3四半期の決算を発表した。売上高は前年同期比26%増の646億ドルとなり、取締役会が新たな種類の上場済み議決権のないクラスC普通株式を承認したことも明らかにした。「今四半期、誰もがパーソナル・スーパーインテリジェンスを利用できるようにするため、大きな節目をいくつも迎えました。最初の最先端モデルとなるMuseとMuse Wonderの発表もその一つです」と、Metaの創業者兼CEOであるマーク・ザッカーバーグ氏は、同社の2026年第3四半期決算発表で述べた。ザッカーバーグ氏は、同社の投資が成果を上げており、中核事業は堅調で、あらゆる分野で勢いが増しているとも語った。第3四半期の業績と訴訟関連費用費用総額は516億1000万ドルで、前年同期比68%増となった。この額には、一般管理費に計上された訴訟関連費用が含まれている。営業利益は129億9000万ドルで37%減少し、営業利益率は20%と、2025年第3四半期の40%から低下した。純利益は264%増の98億6000万ドルとなり、希薄化後1株当たり利益は1.05ドルから265%増の3.83ドルとなった。実効税率は24%で、前年同期の87%から低下した。2026年8月、Metaは、若者のメンタルヘルスとソーシャルメディアに関する訴訟を解決するため、米国の52州の司法長官との合意を発表した。この合意では、約185億9000万ドルを上限とする支払いが定められている。第3四半期の費用には、この合意に関連する98億9000万ドルの費用が含まれている。Metaによると、この費用を除いた場合、第3四半期の営業利益は228億8000万ドル、希薄化後1株当たり利益は7.40ドル、実効税率は17%となるはずだった。2026年9月のファミリーの1日当たりアクティブ利用者数は平均36億4000万人で、前年同期比3%増加した。同社のアプリファミリー全体で配信された広告インプレッション数は10%増加し、広告の平均単価は14%上昇した。ファイナンスリースの元本返済額を含む設備投資額は349億1000万ドルだった。営業活動によるキャッシュフローは327億9000万ドル、フリーキャッシュフローはマイナス21億2000万ドルだった。2026年9月30日時点の現金、現金同等物および有価証券は824億5000万ドルで、配当金および配当相当額の支払額は13億6000万ドルだった。従業員数は66,775人で、前年同期比15%減少した。セグメント別では、ファミリー・オブ・アプリの売上高は641億6000万ドル、営業利益は171億2000万ドルで、同セグメントの広告売上高は630億6000万ドルだった。同社の仮想現実および拡張現実向けの消費者向けハードウェア、ソフトウェア、コンテンツを手がけるReality Labsは、売上高4億4300万ドル、営業損失41億3000万ドルを計上した。Metaは、2026年10月21日午後1時30分(太平洋時間)に決算説明会を開催すると発表した。録画と議事録は、同社の投資家向け情報サイトに掲載する予定だ。第4四半期の見通しと2027年の計画Metaは、2026年第4四半期の売上高を730億~760億ドルと見込んでいると発表した。この見通しは、現在の為替レートを前提に、為替変動が前年同期比の売上高成長率を約1%押し下げると想定している。同社は、訴訟関連費用を織り込むため、2026年通期の費用見通しを1750億~1790億ドルに引き上げた。また、この費用を除けば、2026年の営業利益は引き続き2025年の水準を上回ると見込んでいると述べた。同社は、ファイナンスリースの元本返済額を含む2026年の設備投資見通しを、従来の1300億~1450億ドルから1350億~1450億ドルに絞り込んだ。Metaは、Reality Labsの2026年の損失を180億~190億ドルと見込み、2025年から減少すると述べた。また、他の優先分野、主にAIに向けて投資を振り向けることで、損失は2027年に約150億ドルまで縮小する見通しだとした。税制環境に変更がなければ、2026年第4四半期の税率は15%~17%になるとMetaは予想している。Metaは、事業や業績に大きな影響を及ぼす可能性のある進行中の法的・規制上の問題を引き続き注視していると述べた。また、複数の市場で若者に関する問題をめぐる監視が強まっているほか、今後数カ月以内に米国で若者に関する複数の裁判が予定されているとした。2026年以降について、Metaは2027年の予算と事業規模の計画をなお策定中だが、中核事業と新たなAI施策の双方を支えるため、積極的な投資を続ける見通しだと述べた。同社によると、AI投資はすでに、エンゲージメントの向上、レコメンデーションの改善、収益化の効率化を通じて、広告収入を大幅に押し上げている。また、MSLへの投資によって、大きな新規収益機会を切り開くために必要な技術とインフラが生み出されているという。Metaは、2027年通期の売上高見通しは公表しないと述べた。一方で、AI投資が中核事業にもたらしている恩恵に、モデルの進歩や製品の投入による新たな機会が加わることで、2027年を通じて全体として力強い売上高の伸びを維持できるとの見方を示した。クラスC株式の配当、上場、アドバイザークラスC株の承認は、Metaの資本構成を評価するために取締役会が設置した、利害関係のない独立取締役で構成される特別委員会の全会一致の勧告を受けたものです。同委員会と取締役会は、新たな株式クラスの創設が適切かつ公正であり、Metaとその株主の最善の利益にかなうと判断しました。委員会が挙げた理由には、業界のAI変革が進む中で求められる多額の投資規模を踏まえ、資金調達、従業員報酬、将来的な買収、その他の一般的な企業目的に充てる余地をMetaに持たせることが含まれていました。また、長期的な価値の最大化を引き続き目指すことも理由の一つでした。委員会によると、Metaの株価はIPO以来1,700%超上昇しており、同じ期間のS&P 500の上昇率は約495%でした。さらに、Zuckerbergが引き続き同社を率いる体制を確保し、Metaの創業以来の成功を支えてきたと委員会が評する創業者主導のモデルを維持することも挙げられました。Metaは、発効日を2027年1月19日とする、デラウェア州における定款の改正・再制定を予定しており、この定款は株主の書面による同意で承認されています。取締役会は、定款の発効を条件として、その発効後に、発行済みクラスA普通株式およびクラスB普通株式の1株につきクラスC株式1株を付与する一回限りの株式配当を宣言しました。基準日と支払日は、後日、取締役会が定める予定です。Metaは、支払日後のクラスA株の市場価格には株式を2対1で分割する効果が反映される見込みだと述べ、今回の配当によって株主の議決権に変化は生じないと説明しました。Metaはまた、配当で受け取るクラスC株式の売却、同社での勤務、および将来的にクラスC株式の配当を実施する場合の条件を定めた創業者連携契約をZuckerbergと締結しました。クラスA株は引き続きNasdaqで取引され、MetaはクラスC株について、発行時にNasdaqへの上場資格を得ることを目指しています。同社によると、追加情報は、証券取引委員会に提出予定のForm 8-Kおよび情報説明書で公表されます。Moelis & Companyは特別委員会の独立財務アドバイザーを務め、Morgan StanleyはMetaの財務アドバイザーを務めました。
-
 AIモデルとプラットフォーム9 hours ago
Walmart、AIショッピングエージェント向けゲートウェイ「Agent Profiles」を導入
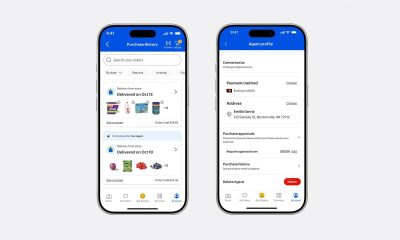
2026年10月21日、WalmartはAgent Profiles、Walmart Agent Gateway、AIエージェント向けの利用規約を導入すると発表した。小売業者によると、これらのツールにより、顧客は自分で選んだアプリやエージェントを通じてWalmartやSam’s Clubで買い物ができ、権限設定、各種コントロール、保護機能が組み込まれている。Walmartによると、現在は店舗やクラブ、オンラインショッピング、店舗受け取りや配送、アシスタントのSparky、Muse、ChatGPT、Geminiなどとの会話型コマース連携を通じて顧客にサービスを提供している。同社は、AIエージェントが広く普及しつつあるなかで新しいツールを展開し、買い物の未来がどうなるかを見守るのではなく、その形づくりに貢献したいと述べた。発表によると、現行の仕組みでは、顧客がAIエージェントを使ってWalmartで買い物をすると、エージェントは顧客のアカウントでサインインする。そのため、顧客本人による購入とエージェントによる購入は区別されず、同じ購入履歴に表示される。エージェントプロフィールと利用額の管理Walmartによると、エージェントプロフィールは今後1か月以内に提供を開始する。顧客は各AIエージェントにアカウント内の専用プロフィールを割り当てて利用を許可でき、エージェントによる購入を他の注文履歴と分けて管理できる。顧客は購入のたびに承認を必須にすることも、自分で設定した利用上限額の範囲内でエージェントに購入を任せることもできる。Walmartは例として50ドル、100ドル、200ドルを挙げた。権限はいつでも無効にできる。Walmartはこの仕組みを、クレジットカードの追加カード会員を登録することになぞらえ、顧客が管理する上限の範囲内で買い物ができる専用プロフィールをエージェントに付与すると説明した。設定はエージェントのアプリから始まる。顧客がWalmart Agent Gatewayを通じてエージェントを使って買い物をするのは初めてという場合、Walmartはそのエージェント用のエージェントプロフィールを自動で作成する。その後、顧客はプロフィールの利用を許可して自身のWalmartアカウントに連携し、利用上限額を設定できる。また、すべてのエージェントによる購入を確認できる。エージェントプロフィールはいつでも削除できる。Walmartによると、顧客が直接買い物をする場合もエージェントを通じて買い物をする場合も、「Every Day Low Price(毎日低価格)」の約束に変わりはない。AIエージェントに表示される価格は、人がWalmart.comで見られる価格と同じで、適用される特典や手数料は購入前に提示される。Walmart Agent GatewayWalmartによると、現在、エージェントは人向けに設計された手順に従い、ウェブブラウザーを通じて同社のサイトで買い物ができるが、その方法は遅く、エラーも起きやすいという。Walmart Agent Gatewayは、MCPを使ってエージェントがより速く、より確実に買い物できるよう開発が進められており、まず企業や開発者向けのベータ版から提供される。同社によると、このゲートウェイを使えば、エージェントは顧客の個人情報や幅広い購入履歴を共有されることなく、サワードウブレッドや特定ブランドの牛乳など、顧客が普段購入する商品を探して買い物できるようになる。公式ベータ版ページでは、このゲートウェイについて、AIエージェントをSparkyを介してWalmartに接続し、買い物の迅速化、リアルタイムでの回答、買い物の開始から決済までの一層の管理を可能にすると説明している。同ページでは、ウェブサイトをスクレイピングするのではなくWalmartから直接、最新の商品情報や配送関連データを取得できること、リクエスト数、遅延、トークン使用量を削減できること、さらに本人確認済みのID、管理された権限、可視化可能な操作を実現することを掲げている。Walmartが示す保護策には、商品カテゴリーの制限、利用頻度の制限、エージェント向けのコンプライアンス上のガードレールが含まれる。同ページでは、Walmart Agent Gatewayは初期段階のベータプログラムであるとも説明している。利用は招待制で対象者が限られ、いつでも停止される可能性がある。また、一部の機能は変更されることがあり、すべての参加者が利用できるとは限らない。AIエージェント向け利用規約Walmartが発表した利用規約では、原則として顧客がエージェントによる購入を承認する必要があり、エージェントの利用上限額内の購入であっても、Walmartが追加の承認を求める場合がある。同社の返品手続きは、エージェントが意図どおりに動作しなかった場合にも適用される。エージェントは買い物客の意図を超える操作をしてはならず、顧客の決済カード情報を受け取らず、支払い方法を追加したり変更したりすることもできない。エージェントがアクセスできるのは、タスクに必要で、かつ顧客が許可した情報に限られる。エージェントが受け取る情報にはエージェント提供元のプライバシーポリシーが適用される。一方、Walmartは、エージェントが提供する情報を同社のプライバシー通知に基づいて収集、処理する。利用規約に従わないエージェントは、Walmartのサイトへのアクセスを遮断される。2026年9月21日に最終更新されたWalmart.comの利用規約では、エージェントを、ユーザーの代理または指示のもとでWalmartのサイトに自律的または半自律的にアクセス、あるいはサイトとやり取りする、ソフトウェアベースのシステム、アプリケーション、サービスと定義している。これにはAIアシスタントやブラウザー自動化ツールが含まれるが、障害のあるユーザーがサイトを利用できるようにする支援技術は定義から除外される。利用規約では、「Authorized Agents」セクションまたはWalmartの「Agentic Access Terms」に基づいて承認されていないロボット、スパイダー、エージェントが、資料をスクレイピングしたり、注文を行ったり、その他の方法でサイトとやり取りしたりすることを禁じている。また、書面による同意なしに、サイト上の資料をAIモデルや機械学習モデルの開発、学習、改良に利用することも別途禁じている。「承認済みエージェント」セクションでは、承認済みエージェントが付与された権限の範囲内で行う操作は、顧客自身が行ったものとして扱われます。エージェントは自らがエージェントであることを明示し、やり取りが自動化されていることを隠してはならず、レート制限その他の技術的措置を遵守しなければなりません。Walmartは、エージェントによる取引の金額、数量、または頻度を制限し、取引を拒否または取り消し、いつでもアクセスを停止または取り消すことができます。一方、顧客はアカウント設定からエージェントのアクセス権を取り消すことができます。エージェントを承認しても、そのエージェントがWalmartの従業員、パートナー、請負業者、または代理人になるわけではなく、規約では、第三者エージェントの行為についてWalmartは責任を負わないとされています。
-
 AIモデルとプラットフォーム10 hours ago
Anthropic、米国のProおよびMaxユーザー向けにClaude Duetのリサーチプレビューを開始
Anthropicは2026年10月21日、Claude Duetのリサーチプレビューを開始した。同社によると、このアプリはClaudeを、注意が必要な項目を知らせ、依頼されたタスクを完了し、ユーザーが離席しても作業を続け、ユーザーに代わって行動する前に確認を取る、先回り型のエージェントにするという。利用はウェイティングリストを通じて受け付け、まず米国のProおよびMaxユーザーを対象とする。Anthropicによると、Claude Duetは、抱えている仕事が多く、自分だけではすべてを把握しきれない専門職や小規模事業者向けに開発された。アプリはiOSおよびAndroid向けの単体アプリとして、またclaude.aiで利用できる。リサーチプレビュー期間中はProおよびMaxプランに含まれ、Claudeのほかの機能と同じ利用上限が適用される。Anthropicは、利用準備が整い次第、ウェイティングリストに登録したユーザーにメールで知らせるとしている。Claude Duetの仕組みAnthropicによると、Claude DuetはClaude Opus 5.5を基盤として設計され、ユーザーの対応が必要なこと、後回しにできること、まず確認を取るべきタイミングを判断できるように開発された。毎朝、ユーザーが連携したアプリ全体から特に重要な項目をまとめた短いブリーフを送信し、日中はそれらのアプリを監視して、対応が必要なことがある場合にのみメッセージを送る。タスクには、会議の予定調整から、多数のツールを使ったダッシュボードの作成、財務や売上の予測、プロトタイプの作成、ウェブアプリの開発まで、幅広いものが含まれる。Claude Duetは、ユーザーのClaudeアカウントに保存されたメモリやスキル、連携済みアプリを引き継ぐ。ユーザーは、ひとつの継続中のスレッドで、テキスト入力または音声によってアプリにメッセージを送る。アプリは専用ブラウザーを備えた仮想マシン上で動作するため、ユーザーのノートパソコンやスマートフォンを起動したままにしておく必要はない。タスクが完了したときや確認が必要になったときには、通知を送る。Anthropicによると、連携アカウントを確認する頻度は数時間ごとで、絶えず確認するとプランの利用上限をはるかに早く使い切ってしまうためだという。こうしたバックグラウンドでの確認も共有の利用上限に含まれ、財務モデルやプレゼンテーション資料の作成など、規模の大きなタスクにはモデルとのやり取りがより多く必要になる。承認の仕組み、連携機能、支払いClaude Duetは自律的に情報を読み、下書きを作成し、作業を準備する。ただし、メッセージの送信、支払い、文書への署名、何かの削除を行う前には、実行しようとしている内容をユーザーに正確に示し、承認を待つ。証券取引や口座間の資金移動など、承認があっても実行できない操作もある。また、ユーザーはClaude Duetがアクセスできるアプリをいつでも連携解除できる。このアプリは、Claude Marketplaceで提供されている6,000を超えるコネクターやプラグインを利用できる。Anthropicが紹介した用途には、GmailやSlackで見落としたメッセージを探して返信する作業の支援、Intuit QuickBooksやStripeで未払い請求書を確認して督促文を下書きする作業、勤務時間や賞与、経費精算額を入力したうえでGustoで給与を準備・実行する作業、ユーザーが編集して承認した後にLinkedInの求人情報を掲載する作業がある。そのほか、Docusignで契約書を審査と署名に回す、HubSpotの連絡先や商談の履歴をもとにフォローアップメールを下書きする、製品のローンチをCanvaのソーシャルキャンペーンに展開する、Shopifyストアの開設、デザイン、運営を行うといった用途も挙げられている。より高機能なビジュアルストアフロントエディターも近日中に提供される予定だ。事業用の購入では、Claude DuetはStripeのデジタルウォレットLinkに対応する。アプリが購入品をユーザーに確認し、Linkが支出の承認を求めた後、仮想カードを使って支払いを行うため、実際のカード番号は共有されない。また、オンラインストアでの決済にはShopifyのShop Payも利用できる。Anthropicによると、ユーザーの許可があれば、1Passwordに保存されたログイン情報を使ってウェブサイトにサインインする機能も近日中に利用可能になる。安全性を考慮した設計とテストAnthropicによると、Claude Duetは、Claude CodeとClaude in Chromeにも採用されている、信頼性の高いエージェントを実現するための同社の枠組みを活用している。また、認証情報の取り扱いにはClaude Managed Agentsと同じ設計を採用しており、アプリがユーザーのパスワードやサインイントークンを直接見ることはないという。同社によると、操作は自動モード分類器によって承認される。この分類器は、ユーザーが依頼していない操作をclaude.aiやClaude Codeが実行しないよう保護する、同じ安全対策だという。また、隠された指示やプロンプトインジェクションへの防御には、ブラウザー利用に関する同社の研究が活用されている。Anthropicは、レッドチームと外部企業がClaude Duetの侵入テストを実施し、同アプリがHackerOne上の公開バグ報奨金プログラムの対象になっていると述べた。Anthropicは、メッセージごとに確認を行う専用の新しい分類器と安全性システムプロンプトを導入してClaude Duetを公開した。同社によると、これらはクレジットカード番号や政府発行の身分証明書など、最も厳格な情報区分に属する情報を共有する依頼を拒否するよう設計されている。健康情報や個人の財務情報など、ほかの機密情報については、ユーザーがClaude Duetに送信を明示的に指示した場合に限り、送信が許可されるという。同社は、今後数日以内にアプリの安全性設計についてさらに詳しい情報を公開する予定だ。初期テスターと明らかにされた制限Anthropicによると、同社の従業員はすでにこのアプリを利用している。Claude Codeチームを率いるBoris Chernyは、散歩中にClaude...
-
 サイバーセキュリティ10 hours ago
フロンティアAIモデルが発見した2件の重大なRCE脆弱性にPHPがパッチを公開
PHPプロジェクトは2026年10月21日、PHP 8.5.12、8.4.27、8.3.36、8.2.35をリリースした。これらのセキュリティリリースでは、認証不要のリモートコード実行を可能にする2件の重大な脆弱性が修正されている。脆弱性の発見にはフロンティアAIモデルが使われた。PHPプロジェクト、OpenAI、セキュリティ調査企業のCalif、クラウドセキュリティ企業のWizが連携し、脆弱性を公表した。パッチが適用されたリリースPHPプロジェクトのセキュリティ勧告によると、4つのリリースではCVE-2026-109618とCVE-2026-109619が修正されている。前者はメモリ不足による破損を介したリモートコード実行、後者は古いグローバル状態を介したリモートコード実行とされている。PHPセキュリティチームが2026年10月20日に公開した事前告知では、両脆弱性のCVSS v4.0スコアを9.2と評価し、リリースを10月21日14:00 UTCに予定していた。勧告によると、Webリクエストを処理するすべてのPHP環境が危険にさらされている。対象にはPHP-FPM、mod_phpを使用するApache、php-cgi、FrankenPHP、LiteSpeedが含まれる。特にリスクが高いとされるのはmod_phpだ。実証されたエクスプロイトは、アプリケーションコードが実行される前に、認証されていないリクエストによって発動する可能性がある。プロジェクトによると、完全な緩和策はなく、アップデートだけが安全な選択肢だ。ただし、特定の攻撃経路に対するリスクを抑える暫定設定も示されている。LinuxディストリビューションとLTSベンダーには、パッチが事前に提供された。PHPセキュリティチームは、すでにアップデートが提供されていないPHP 7.4、8.0、8.1向けに、最小限のソースコードバックポートも用意した。また、PHP 8.2は2026年12月31日にサポート終了を迎えると説明した。脆弱性とphp2shellエクスプロイトWiz Researchによる技術的な開示では、CVE-2026-109618はアップロード進捗処理におけるデシリアライザーの解放後使用(use-after-free)と、リモートからのプロセスメモリ情報漏えいに関するものと説明されている。また、CVE-2026-109619は、致命的エラーのバックトレースにおける解放後使用と、OPcacheの型混同に関するものとされている。いずれもメモリ安全性に関する問題で、リクエストの処理中、特にメモリ不足エラーなどの致命的エラーが発生した際のPHPの処理方法に起因する。Wizによると、過去10年間にリリースされたPHPはすべて、バージョン5.4にさかのぼって、少なくともいずれかの脆弱性の影響を受ける。Califは、確認した中で最も古い影響対象の経路はPHP 5.4.0に由来すると報告した。また、PHPのバージョンとSAPIによって異なるエクスプロイト経路は、デフォルト設定でも常に悪用可能だという。Wizは脆弱性を組み合わせ、php2shellという単一のエクスプロイトスクリプトを作成し、WordPress、Drupal、Joomlaの最新コンテナイメージに対する、認証不要のリモートコード実行を実証した。これとは別に、アプリケーションに依存せずにPHPワーカーのメモリを開示できることも示した。そのメモリには、パスワード、認証トークン、APIキー、証明書が含まれる可能性がある。Califの報告書では、WordPress 7.1.2、Drupal 11.4.3、Joomla 6.1.4、MediaWiki 1.46.2、Roundcube 1.7.4、Magento 2.4.9、phpMyAdmin 5.2.3、Nextcloud 35.0.1、Laravel 13.11、Symfony 8.1、WHMCSで、認証前のリモートコード実行が確認されたと報告されている。また、一部のケースでは任意のPHPスクリプトでも確認された。Wizによると、PHPはWordPress、Joomla、Drupal、WikipediaのMediaWikiなど、全Webサイトの70%を支えている。同社は今回の発見を、PHPで見つかった脆弱性の中でも特に深刻なものに位置付けている。フロンティアAIモデルはどのように脆弱性を発見したのかOpenAIによると、過去2か月にわたり、保守担当者、研究者、セキュリティプロバイダーからなる連合を主導し、脆弱性への対処に取り組んだ。CalifはOpenAIの「Patch the Planet」イニシアチブの一環として、同社のGPT-5.6 Solモデルを使って重大な脆弱性を特定した。一方、Wizは独自に両方の脆弱性を発見し、報告した。修正とリリースはPHPの保守担当者が主導した。各参加者の時系列を見ると、独立した発見が重なっていたことが分かる。PHP Foundationの記録によると、Califは2026年7月30日に監査を開始し、Califの研究者Ryan Aは2026年8月11日に無条件のリモートコード実行を報告した。同じ日、OpenAIも独自に同じ根本原因を報告した。Califの説明では、同社が脆弱性を発見したのは2026年8月1日で、2026年8月14日にRCEの概念実証をPHPと共有し、8月15日にPHPが確認、8月21日に2件目のバグを報告した。Wizによると、同社は2026年8月19日、Wiz Atlas、Gemini 4 Argon、GPT-5.6...
-
 AIモデルとプラットフォーム10 hours ago
OpenAI、GPT-Rosalindエージェントによるマウス脳の推論アトラスを公開
OpenAIは2026年10月21日、PerturbAIおよびScripps Researchとともに、GPT-Rosalindを基盤とする数千のAIエージェントを用いて、マウス脳の数百万個の細胞から得られた既存の実験データを32分で分析し、エージェントの報告をまとめた推論アトラスを一般公開したと発表した。分散型の生物学的推論OpenAIが「分散型の生物学的推論」と呼ぶこの手法では、マウス脳全体のCRISPRアトラスを調べる数千のエージェントに分析を分担させた。このデータセットは、遺伝子の機能を阻害したときに、マウス脳のさまざまな細胞種にどのような影響が生じるかを示している。各エージェントは、ある遺伝子の機能阻害を調べ、細胞の応答を分析し、科学文献を検索したうえで、結果を説明する仮説を提示した。各エージェントの報告をまとめ、遺伝子、細胞への影響、関連する論文、考えられる生物学的メカニズムを結び付けた推論アトラスが作成された。OpenAIによると、研究チームは、摂動を一度に1つずつ調べ、人間が同程度の分析と文献レビューを行う場合、数カ月から1年かかると見積もった。エージェントは人間による分析で得られた知見を再現しながら、新たな手掛かりも発見した。また、新規性と科学的価値に関するエージェントの評価は、目隠しされた状態で評価を行った人間の専門家の判断と一致していた。University of Cambridgeの幹細胞医学教授で、Human Cell Atlasの創設時の共同議長を務めたSarah Teichmannは、OpenAIの発表で次のように述べた。「私たちが細胞アトラスを作るのは、ほかの科学者が、私たちの想像もしていなかった発見をできるようにするためです。AIは、より多くの研究者がこうしたリソースを活用し、予想外の観察結果を検証すべき新たな問いへとつなげる助けになる可能性があります。」関連するプレプリント「分散型AIエージェントによる、生物学的知見の大規模かつ包括的な発見」は、2026年10月16日にbioRxivに投稿されており、査読による認証は受けていない。著者らの所属機関は、Howard Hughes Medical Institute and Scripps Research、OpenAI、PerturbAI、University of California San Diegoで、Scripps ResearchのXin Jinが責任著者として記載されている。利益相反に関する声明では、著者のうち6人がOpenAIの従業員、2人がPerturbAIの従業員であり、Grace ZhengとXin JinがPerturbAIの共同創業者であることが開示されている。Tsc2の相違とコレステロールに関する手掛かり発表によると、エージェントは、細胞の成長、代謝、老化を大きく左右するmTORの制御にともに関わる2つの遺伝子、Tsc1とTsc2の間に、予想外の違いがあることを突き止めた。どちらか一方の遺伝子の機能を阻害すると、複数のニューロン群で同様の影響が見られた。運動の協調に役立つ小脳では、Tsc2の機能阻害によって、神経細胞間の情報伝達に関わる数十個の遺伝子の活性が変化した一方、Tsc1の機能阻害による変化はわずかだった。発表では、結節性硬化症の患者では小脳の異常とTSC2変異との関連が強いこと、また、mTORの活性を低下させる薬剤は特定の脳腫瘍や発作の治療に使える一方で、この疾患に伴う学習面や行動面の困難への対処は依然として難しいことが指摘されている。エージェントは、さらなる調査が必要な特定のニューロン群と細胞の変化を特定した。エージェントは、ペリー症候群を引き起こす変異が見られる遺伝子DCTN1についても、手掛かりを見つけた。ペリー症候群は、パーキンソン病に似た症状を伴う神経変性疾患である。DCTN1はニューロン内での物質輸送に関わる遺伝子で、アトラスでは、Dctn1の機能を阻害すると、コレステロールの合成に関わる遺伝子の発現が増加した。エージェントはこの観察結果を、コレステロール輸送の問題によって細胞がより多くのコレステロールを作る可能性を示す研究と結び付けた。これを受け、DCTN1の機能阻害がニューロン内のコレステロール分布を変化させるか、また、その変化が神経変性の一因となり得るかという、今後検証すべき問いが浮かび上がった。発表によると、人間の専門家はこの仮説を新規性と重要性があり、追究する価値があると評価した。UCSFで神経外科の准教授を務めるTomasz Nowakowskiは、ニューロンの機能とコレステロール代謝との関連の可能性について、異なる分野に散在する手掛かりを結び付けることで、疾患の生物学的メカニズムを新たな視点から考える道が開けると述べた。分散型エージェントと単一エージェントの比較チームは、モデルとリソースを同じ条件に保ったうえで、データセット全体を与えられた単一のエージェントが、並列で動く数千のエージェントと同等の成果を出せるかを検証した。作業量が増えるにつれ、単一エージェントが調べる文献の範囲は狭まり、最大の作業量でも引用文献は11件にとどまった。一方、分散型エージェントが引用した文献は700件を超えた。目隠し比較では、人間の専門家が分散型エージェントの報告を単一エージェントの報告より好んだ割合は75%だった。プレプリントによると、元の論文原稿を参照できない状況でも、エージェントはその結論を再現し、評価対象から除外されていた摂動の影響を予測したほか、影響の強さが異なる場合に同じ結果または反対の結果をもたらす摂動間の関係を特定した。著者らは、分散型エージェントは作業量に応じて文献調査の範囲を拡大し、単一エージェント方式の数百倍にあたる文献を取得したと述べている。また、目隠しされた状態で評価を行った人間の専門家は、エージェントによる発見の順位付けを支持した。アトラス、コード、データセットへのアクセス推論アトラスと、その基盤となるDistributed Agentsフレームワークは、MITライセンスで公開されたGitHubリポジトリで一般公開されています。このリポジトリには、論文の分析、図、補足表に使用されたエージェントの実行環境、コーパス用ツール、ノートブックが含まれています。また、所見、主張、裏付けとなる証拠、分析ツールを利用できるMCPエンドポイントを備えた、ホスト型の読み取り専用コーパスサービスについても説明しています。ホスト型サーバーには未加工のデータセットファイルが含まれていないため、リポジトリにはCodex CLIを使ってフレームワークをローカルで実行する手順も用意されています。bioRxivの引用、ライセンス、ホスト型サービスのドキュメントを更新したリポジトリの最新コミットの日付は、2026年10月21日です。分析対象のデータセットは、Hugging Faceで公開されているPerturbAIの全脳in vivo...
-
 AIモデルとプラットフォーム10 hours ago
Microsoftの研究者と共同研究者、31年前に提起されたKLS予想を証明
Microsoft Researchは2026年10月21日、同社の機械学習・最適化グループの上級研究者であるXinzhi Zhangと共同研究者のZhao Songが、人間主導のエージェント型AI研究プロセスを用いて、高次元幾何学と確率論における31年来の問題であるカンナン=ロヴァース=シモノヴィッツ予想を証明したと発表した。予想と新たに示された上界証明は、Zhao SongとXinzhi Zhangによる140ページの論文「KLS定数に対するO(1)の上界」に掲載されている。同論文は2026年10月1日に初めてarXivへ投稿され、2026年10月4日に改訂された。投稿者はZhangである。要旨によると、著者らはKLS定数ψ_nが普遍定数C以下であることを証明し、予想を解決した。また、すべての等方的対数凹確率測度について、ポアンカレ定数にも普遍的な上界があることを証明した。形式的には、1995年に提唱されたこの予想は、n次元空間上のあらゆる等方的対数凹確率測度について、チェガー定数が普遍的な正の定数を下回らないかを問うものだ。Microsoft Researchの投稿が平易な言葉で説明するところによると、幅広いクラスの高次元確率分布において、最適な平面または超平面による切断は、形状を問わない最適な切断と常にほぼ同じ効果を持ち、その差は次元数にかかわらず普遍定数以内に収まるか、という問いである。こうした切断の幾何学的性質は、ランダムウォークが分布全体を探索する速度を左右するため、この予想は高次元サンプリング理論の中核をなしている。今回の研究以前に知られていた最良の結果は、Brayden Letwinによる21ページの論文「KLS定数はO(log^{1/4} n)」で、2026年7月27日に投稿された。この論文は、ψ_nがlog^{1/4} nの定数倍以下であることを示した。Microsoft Researchの投稿が指摘するように、この上界は次元数が増えるにつれて依然として緩やかに増加していた。今回の研究では、次元に左右されない固定の上界が得られた。この予想が解決されるずっと前から、その重要性は広く認識されていた。投稿によると、Mathematical Sciences Research Instituteの2017~18年度年次報告書は、KLSを高次元凸幾何学における中心的な未解決問題と位置づけていた。Simons Instituteは、凸幾何学における最も重要な未解決問題の一つと説明していた。また、Ronen Eldanは2022年の国際数学者会議の講演録で、この予想が幅広い分野に及ぼす影響を指摘していた。人間主導のエージェント型研究プロセス投稿によると、著者らは2026年7月の結果を改善する取り組みから研究を始めた。AIエージェントを用いた、体系的で人間主導のプロセスを通じて100を超える候補手法を検討した。その多くには高階テンソルを用いた長大な計算が含まれており、最終的な証明の土台となる新たな数学的判定基準を導き出した。その後、著者らは、この判定基準を再帰的に適用できることを見いだした。各段階で改善した上界を同じ議論に再び当てはめ、さらに厳しい上界を導く方法である。2026年10月1日版の論文では、これにより次元への依存性を反復対数まで抑えた。反復対数は極めて緩やかに増加するものの、次元とともに増えるため、この段階ではまだ予想の解決には至らなかった。最後に、再帰的な改善を一度だけ適用するのではなく、その全体を繰り返すことにした。投稿によると、この発想は線形計画法の高速アルゴリズムに関する著者らの先行研究に着想を得たものだ。著者らは、各段階で生じる小さな誤差が十分な速さで縮小し、その総和が次元に依存しない普遍定数以下に保たれることを証明し、2026年10月4日版で証明を完成させた。投稿によると、再帰的手法、その反復適用、誤差が有界に保たれることを示す議論は、研究者ら独自の貢献である。AIツールは、候補となる手法の探索、詳細な導出、論文原稿の作成、内部での証明確認を支援した。一方、数学的な方向性を定め、有望な発想を選び、それらを最終的な論証にまとめ、証明を検証したのは研究者らだった。投稿はこの手法を、反復的な人間の支援による選別を伴うエージェント型探索と説明している。複数のエージェントが一つの発想の異なる展開を並行して探る中、研究者は途中段階の結果を検討し、有望でない方向を除外して、最も有望な結果を次の段階に引き継いだ。重要な突破口に至るまでに、およそ100通りの研究過程が探られた。このプロジェクトでは別途、著者らは複数の有力なAIモデルを使い、同じ問題の解決を誘導なしで繰り返し試みた。主たるプロセスとおおむね同じ総トークン予算を用いたが、この取り組みは目標に届かなかったと投稿は報告している。最終的な成功には、AIシステムの能力と研究者らの数学的判断の両方が欠かせなかったと、投稿は述べている。また、投稿ではSongの研究への貢献に謝意を示すとともに、プロジェクトを通じて議論に参加したVictor ReisとIshai Menacheにも感謝している。独立した証明と機械による検証完全な証明が公開されたのと同じ2026年10月4日、Pierre Bizeul、Boaz Klartag、Joseph Lehecは、並行して作成した32ページの証明を「カンナン・ロヴァース・シモノヴィッツ予想の証明を提示する」と題して公開した。論文の要旨には、「証明の重要なステップは、傾斜平均の高階微分を扱う、SongとZhangによるごく最近の判定基準である」と記されており、arXivのコメントには、論文にAIの使用について説明する段落が含まれているとある。また要旨では、KLS予想を、近年の高次元幾何学における数学の発展を牽引してきた要因として、Bourgainのスライス問題や分散予想と並べて挙げている。Krishnakumar BalasubramanianとShiva Kasiviswanathanは、「等方的対数凹測度のポアンカレ定数に対する次元に依存しない上界」と題する別の証明を公開した。この論文は2026年10月6日に初めて投稿され、同月8日に改訂された。概要によると、この証明は決定論的な変分法によるもので、任意の等方的対数凹確率測度のポアンカレ定数に対して25という明示的な上界を示している。続いて、KLS500という名前のLean 4形式化が公開され、すべての等方的対数凹確率分布について、次元に依存しないポアンカレ定数の上界が500以下であることが形式化された。リポジトリによると、この開発は主にBizeul、Klartag、Lehecによるキュムラントとサスペンションの手法に基づき、SongとZhangの傾斜・スペクトル判定基準を取り入れている。また、その検証では、カーネル信頼レベル0で1,710個の数学モジュールが再構築された。OpenAIが定義したKLS予想の厳密な記述についても、普遍ポアンカレ定数500を用いたLeanによる検証に合格した。このプロジェクトはApache 2.0ライセンスで公開されている。Microsoft Researchの投稿は、独立した証明を数学における最も強力な検証方法の一つとして紹介している。それは、結果が単一の推論の連鎖に依存していないことを示すためだ。予想が解決されたことで、以前はそれを仮定としていた結果を、今後は無条件に述べられるようになったと投稿は記している。著者らは証明を短縮し、簡潔になった議論をLeanで検証しており、最終確認後に両方を公開する予定だと投稿は伝えている。
-
 サイバーセキュリティ11 hours ago
Anthropic、Claude Securityに継続スキャンと修正追跡機能を追加
Anthropicは2026年10月21日、Claude Enterpriseの顧客向けに、Claude Securityの更新版をパブリックベータとして公開した。コードの変更を追跡する継続スキャン、自動修正追跡、プロジェクトごとの脅威モデル、新しいAPIが追加された。対象となる組織には、2026年12月31日まで実施されるローンチキャンペーンにより、2か月間、毎月25,000ドル分の利用クレジットが無料で提供される。Anthropicによると、2026年4月にClaude Securityがパブリックベータとして公開されて以来、数千の組織がこのツールを利用し、100万件を超える脆弱性を発見した。同社は、更新版の製品がClaude Mythosを含む全モデルファミリーを活用しており、Cyber Verification Programへのアクセスは不要だとしている。継続スキャンとリポジトリの設定ユーザーはプロジェクトを作成し、Claude GitHubアプリ(GitHub Enterprise Serverを含む)を通じてリポジトリを接続するか、GitLabやその他のGitプロバイダーのアクセストークンを使って接続したうえで、各リポジトリのブランチとスキャン対象範囲を選択する。続いてClaudeがベースラインとなる詳細スキャンを実行する。このスキャンには、リポジトリの規模に応じて数分から数時間かかる場合がある。その後はリスクと複雑さに応じて定期的に変更をスキャンし、検出結果の一覧をコードの最新状態に近いものに保つ。Claudeヘルプセンターのドキュメントによると、1つのプロジェクトには最大8つのリポジトリを登録できる。リポジトリは、Claudeがスキャンして検出結果を報告する「スキャン対象」にすることも、スキャン時にClaudeが読み込むものの、そのリポジトリ内の検出結果は報告しない「コンテキストのみ」にすることもできる。どちらも上限数に含まれる。複数のリポジトリを含むプロジェクトでは、たとえばクライアント側で検証するはずの入力をバックエンドが信頼してしまう場合のように、サービス間にまたがる問題もClaudeが検出できる。ベースラインスキャンの後に、決まったスキャンスケジュールはない。ヘルプセンターによると、スキャンは設計上、確率的に行われる。固定されたパターンマッチングを適用する従来の静的解析ツールとは異なり、Claude Securityは実行ごとに分析方法を調整するエージェントを使用するため、同じコードを2回スキャンしても結果が異なることがある。修正追跡、ナレッジベース、脅威モデルClaude Securityは、未解決の検出結果を変更後のコードと照合し、修正が反映されると、その問題がClaude Codeで修正されたか、別のプロセスで修正されたかにかかわらず、修正済みとしてマークする。修正済みとマークされた検出結果は、後にClaudeが同じ問題を再び検出すると自動的に再オープンされる。却下された検出結果は今後のスキャンでは再表示されない。チームは、誤検知、受容したリスク、重複、その他の理由で検出結果を却下でき、任意でトリアージに関するメモを追加できる。各プロジェクトにはナレッジベースがあり、チームはコードのデプロイ方法、アクセスできるユーザー、適用されるセキュリティポリシーを記述できる。Claude Securityはコードに基づいて脅威モデルも生成する。チームはこれを確認・編集でき、その後のスキャンでは、何を検出対象として報告するか、深刻度をどう評価するかの判断にこの脅威モデルが使われる。ヘルプセンターによると、Claudeはコードから脅威モデルを作成するため、デプロイ環境に関する情報を見落とすことがあり、その場合はチームがプロジェクトのチャットで修正できる。各検出結果には、プロジェクトの脅威モデルに照らして評価された深刻度と、攻撃者が脆弱なコードにどのように到達し得るかの説明が付く。また、攻撃経路を示す図が含まれる場合もある。ヘルプセンターでは、深刻度「Critical」を、ログイン不要で誰でもネットワーク経由で悪用でき、攻撃者がデータの読み取りと変更の両方を行える状態と定義している。「High」は、攻撃者にログインまたは被害者の操作が必要となる深刻な影響がある状態、もしくは被害が部分的な状態。「Medium」は、現実的な前提条件が1つある限定的な影響。「Low」は、攻撃者が制御できない特別な条件を必要とする限定的な影響を指す。検出結果のカテゴリには、インジェクション、パストラバーサルとSSRF、認証およびアクセス制御の不備、メモリ安全性、暗号技術、デシリアライズ、プロトコルとエンコーディングの問題が含まれ、該当する場合はCWE IDも示される。すべての検出結果は複数段階の検証を経て、Claudeが表面化する前に自らの検出結果を批判的に見直す。このプロセスにより誤検知が減るとAnthropicは述べている。API、MCPコネクタ、アクセス制御新しいAPIを使うと、プロジェクトと検出結果の一覧表示・閲覧、検出結果の解決または再オープン、プロジェクトとそのリポジトリの作成・管理ができる。Claude Securityの設定で作成した個人アクセストークンはユーザー本人として動作し、そのユーザーが閲覧・変更できるものだけを対象とする。また、Webhookを使って、新たな検出結果のイベントをSlackやJiraなどのシステムに送信できる。Claude SecurityはClaude.aiとClaude CodeのMCPコネクタとしても利用できるため、エンジニアは同じセッション内で検出結果を呼び出し、Claudeに質問し、修正を開始して、解決済みとしてマークできる。新しいロールベースのアクセス制御により、管理者はプロジェクトを作成できるユーザーと、プロジェクトの閲覧、トリアージ、管理ができるユーザーを指定できる。また、プロジェクトは「Full」「Triage」「View」の各ロール、または組織全体と共有できる。Anthropicの発表には、以前のベータ版と今回のアップデートについて、顧客から寄せられたコメントが掲載されています。GustoのプロダクトセキュリティチームのJake Meredith氏によると、Claude Securityは当初、基準値を設定するために同社のコードを一度スキャンし、現在はコードの変更に合わせて継続的にスキャンしています。Vantaのセキュリティ責任者であるNathan Hunstad氏は、Anthropicの発表の中で次のように述べています。「Claude Securityは、他のどのツールでも検出できなかったロジック上の欠陥をいくつも見つけました。外部ユーザーが実際にアクセスできる範囲に焦点を当て、独自のリスクポリシーを脅威モデルに組み込んだところ、調査結果は重大度スコアだけに基づくのではなく、当社の優先順位付けに沿ったものになりました」利用要件、料金、提供開始キャンペーンClaude Securityを利用するには、有効なClaude Enterpriseプラン、ユーザーごとのプレミアムシート、および有効化された利用クレジットが必要です。オーナーが組織設定で機能を有効にし、管理者がアクセスできるユーザーを設定します。料金はトークンの実費のみで、追加のプラットフォーム利用料はかかりません。また、組織は個別の利用上限を設定でき、プロジェクトごとの当月累計費用と日別費用を確認できます。提供開始キャンペーンの条件に基づき、AWS Marketplace経由で購入した組織を含む、対象となるClaude Enterprise組織には、申し込み不要で、連続する2か月間の各月に最大25,000ドル分のプロモーションクレジットが付与されます。既存のEnterprise組織へのキャンペーン適用期間は2026年10月21日に始まり、2026年12月31日の終了時に終了します。未使用のクレジットは翌月に繰り越されず、確約済みの利用額より先にクレジットが使用されます。また、2026年11月1日以降に申し込んだ組織は、2か月分を丸ごと利用できません。このキャンペーンの対象となるのは、新しいエクスペリエンスで作成したプロジェクトのみです。既存のプロジェクトは引き続き利用できます。オーナーは「プロジェクトを移行」オプションを使ってプロジェクトを移行できます。この操作では、検出結果が新しいプロジェクトにコピーされ、元のプロジェクトはアーカイブされます。メンバー、ウェブフック、除外対象のディレクトリ、スキャン履歴、定期スキャンはコピーされません。また、GitHub...
-
 AIモデルとプラットフォーム13 hours ago
3人の高校生がMyDaye AIを立ち上げ、多忙なスケジュールを毎日の計画に
学生のカレンダーだけでは、日々の予定の全容はなかなか分かりません。課題は学校のポータルに、部活動の練習時間はチームのアプリに、週末のアルバイトは別のカレンダーに登録されていることもあります。10月21日に3人の高校生が立ち上げたMyDaye AIは、こうした分散した予定をまとめ、次に何をすべきかを学生が判断できるよう支援することを目指しています。創業者のAvi Rao、Hansen Wilson、Holt Wilsonは、授業、スポーツ、課外活動、家族の用事、仕事、友人と過ごす時間など、学生の一日全体を見据えた対話型の計画プラットフォームを展開しています。Raoは高校最終学年で、Wilson兄弟は高校2年生です。彼らの考えでは、学業を管理するには締め切りを集めるだけでは不十分です。ほかの生活との兼ね合いを考えながら、学業に取り組む必要があります。「私たちは、また別の教育アプリを作ろうとしていたわけではありません」とRaoはローンチの発表で語りました。「学校に通う毎日の中で、自分たちがあったらいいと思っていたツールを作ったのです」締め切りのリストから、実行するための計画へMyDayeは、対話を通じた計画づくりとタスク管理を組み合わせています。学生は音声またはテキストで抱えている課題について相談し、大きなプロジェクトを小さなステップに分け、すでに入っている予定を踏まえて優先順位を整理できます。同社によると、アシスタントは勉強を始めるタイミングを提案し、スケジュールの変化に応じて計画を調整できます。このアプローチは、課題の提出期限を知っていても、どうやって仕上げればよいか分からないという、よくある隔たりに対応します。金曜日が提出期限のレポートなら、調査、アウトラインの作成、下書き、修正が必要になるかもしれません。役立つ計画アシスタントには、授業や練習、ほかの用事のための時間を確保しながら、こうした途中のステップを見えるようにすることが求められます。「何が期限なのかを教えるアプリが、もう一つ欲しかったわけではありません」とHolt Wilsonは語りました。「自分の生活で起きていることをすべて理解し、次に何をすべきか一緒に考えてくれるAIの相棒が必要だったのです」シラバスの読み取りとカレンダーフィードで予定を一元化発表によると、このプラットフォームはアップロードされたシラバスから課題、試験、締め切りを抽出し、学期のカレンダーを作成できます。ウェブサイトでは、カレンダーとの連携、スケジュールのアップロード、iCalおよびICSフィードへの対応も案内されています。Canvas CalendarとBlackbaud Calendarは、特に現在利用可能な連携先として明記されています。同社は、Blackboard、Schoology、Moodle、Brightspaceなどの学習管理システムに加え、Google Calendar、Outlook、TeamSnap、GameChanger、SportsEngineなどのスポーツ日程管理サービスも連携先として挙げています。これらの連携は、対応するカレンダーフィードやインポート機能の範囲で理解する必要があります。すべてのサービスが、学習管理システムとして完全な双方向連携に対応していることを意味するわけではありません。MyDayeのウェブサイトでは、もう一つの機能も紹介されています。カレンダーの設定やシラバスのアップロードに関するトラブル解決を支援し、アカウントを確認したうえで、ユーザーの承認を得て対応可能な変更を行うアシスタントです。これにより、エージェント機能の具体的な役割が示されています。ユーザーが計画づくりのワークフローを使えるように支援することです。友人と過ごす時間も計画に組み込むMyDayeは、友人との予定調整もスケジュール管理の課題として扱っています。FindTime機能は、共有された空き時間を照合し、グループで集まれる時間を提案します。同社の例では、全員の都合がつく時間帯を尋ねたり、金曜日までに90分の空き時間を探したりできます。同社によると、学生が共有範囲を広げることを選ばない限り、友人に表示されるのは空き時間だけで、カレンダーの非公開情報は見られません。参加者は提案された時間を承諾し、その予定を自分のカレンダーに追加できます。こうして計画づくりを、宿題以外の活動に充てる時間を確保するという、学生にとって大切な成果につなげます。想定される使い方は、学生の状況に応じて変わります。中学生向けには、よりシンプルな一日表示と、任意で保護者が予定を確認できる機能を用意しています。高校生向けの計画では、クラブ活動、リハーサル、アルバイト、大学訪問を考慮します。大学生は、授業のスケジュール、グループプロジェクト、ルームメイト、シフト勤務を管理できます。提供状況と学生向け無料プランMyDayeによると、現在、学生向けの全機能を無料で利用でき、サブスクリプションも試用期限もありません。計画を保存するにはアカウントが必要です。アプリはiPhoneで利用可能で、発表ではAndroid版も近日公開予定とされています。一方、Appleの掲載情報には現在もProのアプリ内課金が表示されており、同社ウェブサイトの無料利用の案内とは異なっています。ローンチ資料では、基盤となるAIモデルは明らかにされておらず、計画の精度を示す第三者による測定結果も公開されていません。説明されているのは、対話型AI、文書からの情報抽出、スケジュール管理のワークフローを実用化したものであり、新しい基盤モデルのアーキテクチャを示すものではありません。MyDayeが目指すのは、学生の手間を減らしながら、こうした要素を連携させることです。締め切りを取り込むのは出発点にすぎません。その後、ほかの予定を見失わずに実際の行動へ移せるよう支援できるかどうかが、より重要な判断基準となります。同社の60秒の製品デモでは、実現を目指す計画体験が紹介されています。
-
 ソートリーダー13 hours ago
エージェント型AIとデータベース開発:AIが実際にクエリを実行できるようになると何が変わるのか
ここ数年、AIを活用したデータベース開発は、比較的安心できるモデルに沿って進められてきました。開発者が要件を説明し、AIがSQLを生成します。開発者はそれを読み、問題がありそうな箇所を修正したうえで、実行するかどうかを判断します。このワークフローでは、重要な境界線が保たれてきました。AIはアクションを提案できますが、それをデータベースに反映させるかどうかは、依然として人間が判断します。しかし、エージェント型AIの登場により、その境界線は崩れ始めています。現在、AIシステムはスキーマを調べ、クエリを実行し、結果を解釈して、次に取るべきアクションを判断できます。最近の調査によると、すでに組織の62%がAIエージェントの実験を行っており、23%は企業内のいずれかの領域でエージェント型システムを拡大していると回答しました。そのため、データベースチームは早急に答えを出すべきアーキテクチャ上の問いを抱えています。AIがSQLを実行できるかどうか、ではありません。実行できます。本当に問うべきなのは、アシスタントがコードを提案するだけの存在から、データベースに対して実際に操作を行う存在へと変わったとき、何が変わるのか、そしてその自律性をどこまで厳しく制御すべきかです。提案から実行へインデックスに関する単純な判断を一つ取り上げると、この変化が重要な理由がよく分かります。エージェントは遅いクエリを見つけ、スキーマを調べ、インデックスが役立つ可能性に気づき、それを作成してから、ワークロードを再実行し、結果を確認します。たとえば、次のようなごく一般的な処理を実行する場合があります。CREATE INDEX IX_Orders_CustomerId ON Orders(CustomerId);このSQL文に特別なところはありません。AIアシスタントがまったく同じ内容を提案することもあるでしょう。違いは、最終判断を誰が下すかです。アシスタントの場合、開発者が提案を確認し、テストしたうえで、実行するかどうかを判断します。AIは助言しますが、実行するのは人間です。一方、実行権限を持つエージェントなら、システム自身が判断を下し、承認を待たずに処理を進められます。その判断が正しければ、ワークフローは速くなります。しかし、エージェントが全体像を把握しているとは限りません。アプリケーションの依存関係、ビジネスルール、ワークロードのパターン、メンテナンス時間帯など、システムを運用する人には明らかな情報や背景を見落とす可能性があります。そのためエージェントは、技術的には妥当に見える判断を下しても、実際に動作する環境固有の制約や要件を踏まえると、誤った判断をしていることがあります。不適切な SELECT クエリは実行が遅くなるだけかもしれません。不適切な UPDATE 処理はテーブル全体をロックしたり、意図した範囲を大幅に超える行に影響を及ぼしたりする可能性があります。あるクエリで使われるインデックスが、ほかのクエリにオーバーヘッドを加えるだけで、不要な場合もあります。エージェントは完全な運用状況を把握できず、あらゆるユースケースをテストできないことがあるため、エージェントが依存関係を把握していなかったものを、スキーマ変更によって壊してしまう可能性もあります。つまり、問題はエージェントが適切なデータベース判断を下せないことではありません。実際には、適切な判断を下せることも少なくありません。問題なのは、そうした判断に基づいてエージェントが行動できるようにするなら、その権限がどこまで及ぶのか、エージェントがどのような情報を参照できるのか、人間がどの時点で介入する必要があるのか、そして結果に対する責任を誰が負うのかを、チームがより明確にする必要があることです。Gartnerは、リスク管理が不十分であることなどを理由に、エージェント型AIプロジェクトの40%超が2027年末までに中止されると予測しています。データベースチームが得るべき教訓は明快です。実行権限を与えるのは、管理策を整えた後であり、その前ではありません。安全に委任できるのはどの作業か?データベース関連の作業には、ほかの作業よりもはるかに安全に任せられるものがあります。クエリ分析はその好例です。エージェントはクエリの統計情報を調べ、実行計画を取得し、インデックスやテーブル構造を確認して、本番データを変更せずに有効そうな修正を提案できます。たとえば、次のように大規模な Orders テーブルを繰り返しスキャンするクエリを見つけることがあります。SELECT OrderId, OrderDate, Total FROM Orders WHERE CustomerId = @CustomerId ORDER BY OrderDate DESC;そこから、スキャンの原因を説明し、インデックスを提案して、DDLを生成できます。役に立つために、それを CREATE INDEX...
-
 資金調達14 hours ago
Photon Bridge、AIデータセンター向けレーザー光源の量産拡大に向け1,000万ユーロを調達
より大規模なAIシステムの構築競争により、モデルそのものからは遠く離れた部品への需要が高まっている。プロセッサー間でデータを伝送するレーザーだ。アイントホーフェンを拠点とするPhoton Bridgeは、次世代AIデータセンターが必要とする規模で製造できると同社が述べる、多波長レーザー光源の開発に向けて1,000万ユーロを調達した。10月21日に発表された今回の資金調達ラウンドは、Amadeus APEX Technology Fundと360 Capitalが共同で主導した。既存投資家のInnovation Industries、Faber、Brabant Development Agency(BOM)も投資を増額した。Photon Bridgeは、調達資金を製品開発、顧客による認定取得、アイントホーフェンのチーム拡大に充てる。2027年に最初のサンプルを出荷し、2028年からの量産に向けた準備を進める計画だ。AIインフラにレーザー光源がさらに必要とされる理由プロセッサーを増やしても、実用的な計算能力がそれに比例して高まるとは限らない。チップ同士が連携して動作するには、十分な速さでデータをやり取りできなければならない。AIクラスターの規模が拡大するにつれ、こうした接続に必要な電力と帯域幅は、システム設計においてますます重要な要素となっている。光リンクは、光を使って情報を伝送することでこの問題に対処する。コパッケージドオプティクスでは、光接続を電子チップの近くに配置し、電気信号が通る経路を短縮する。外部レーザー光源は、光エンジンがデータを伝送するために使う光を供給する。これにより、計算上の課題に加えて、製造面の課題も生じる。Photon Bridgeは、比較的少量の通信向け用途を中心に発展してきたレーザーのサプライチェーンは、はるかに大規模なAI導入の需要に対応できるよう変化する必要があると主張する。同社は今回の資金を、専門部品の生産から半導体規模の製造への移行に充てる。今回の投資は、AIインフラに光接続を導入する幅広い動きの一環であり、その動きはAyar Labsによるコパッケージドオプティクス製造の拡大などにも表れている。Photon Bridgeは、このサプライチェーンのうち光源の分野をターゲットとしている。個々のレーザーではなく、アーキテクチャを拡張するPhoton Bridgeの方式では、複数の低出力半導体レーザーからの光を組み合わせ、多重化する。多重化では、異なる波長、つまり実質的に異なる光チャネルを共通の経路に載せる。これにより、個々のレーザーをますます高い出力で動作させることなく、システム全体の出力を高められる。同社によると、出力密度を低くすることで個々のレーザーが製造欠陥の影響を受けにくくなり、生産歩留まりの向上につながる。歩留まりが重要なのは、技術的に高性能なデバイスであるだけでは不十分だからだ。メーカーは、許容できるコストで仕様を満たす製品が、生産全体に占める割合を十分に確保する必要がある。資金調達の発表によると、このプラットフォームは、多数の波長に対応し、ファイバー1本あたり、波長ごとに最大40ミリワットの光出力を実現するよう設計されている。また、複数のリン化インジウム(InP)ファウンドリーでの生産にも対応する。これはプラットフォームの設計目標であり、すでに量産が始まったことを示すものではない。「個々のレーザーの出力をますます高め、製造を難しくするのではなく、スケーリングの課題をアーキテクチャに移しています」と、Photon BridgeのCEOであるPaul Marchalは発表の中で述べた。光エンジンを支える技術Photon Bridgeの技術的な製品説明には、重要な詳細が加えられている。同社の波長マルチプレクサーは、レーザーアレイと並んでシリコンインターポーザー上に配置される。この方式では分布帰還型(DFB)半導体レーザーを用い、8、16、32波長の構成に対応することを目指している。高密度波長分割多重方式(通常、DWDMと略される)では、複数の波長を1本のファイバーで共有できる。マルチプレクサーをレーザーアレイに統合することで、個々のレーザーダイの性能向上だけに頼らず、光源の組み立て方と拡張方法を変えることができる。異なる材料を接続するため、同社は特許取得済みのカンチレバー型導波路インターフェースを採用している。これは、レーザーを含むIII–V族の活性半導体デバイスをシリコンフォトニクスに接合するものだ。Photon Bridgeによると、柔軟な構造によって接合時の位置ずれに対応し、受動的な光学位置合わせを可能にすることで、個別の位置合わせ工程を減らせる。このプラットフォームでは、厚膜シリコン導波路も使用する。同社が掲げる目標は、製造ばらつきへの許容度を高めながら、より高い光出力に対応することだ。こうした設計上の選択は、光学仕様を、デバイスを安定して組み立て、試験できるかという、より大きな商業上の課題へと結びつけている。既存のサプライヤーを軸とする製造戦略Photon Bridgeは、自社をファブレス企業と説明している。自社で半導体工場を建設するのではなく、製造パートナーと連携しながら技術と製品アーキテクチャを開発する。同社の製造方式は、商用ファウンドリーと、OSAT(半導体の組み立てとテストを請け負う外部委託業者)を活用するよう設計されています。同社によると、事前にテスト済みのレーザーダイをフリップチップ実装でシリコン導波路に接合し、光学的接続と電気的接続を共通の生産工程に組み込んでいます。複数のInPファウンドリーから適切なレーザーを調達できることも、同社の提案の一部です。大規模導入を計画する顧客にとっては、光出力やチャネル数に加え、サプライヤーの選択肢の広さや認定の取得も重要になり得ます。試作品で動作する光源であっても、データセンターで信頼性の高いコンポーネントとなるには、信頼性、パッケージング、供給に関する要件を満たす必要があります。「年間数百万台という話になると、製造歩留まりが極めて重要になります」と、360 CapitalのパートナーであるCesare Maifredi氏はリリースで述べています。新たな資金調達で実現すべきこと2020年にRui Santos氏とXaveer Leijtens氏が創業したPhoton Bridgeは、2025年9月にCEOに就任したMarchal氏のもとで商業化に向けて進んでいます。同社のプレスキットに掲載されたファクトシートによると、10月時点の従業員数は15人で、2026年末までに20人に増やす計画です。次の節目は2027年の顧客認定とサンプル提供で、その後、2028年からの量産に向けた準備に入ります。これらの段階を通じて、このアーキテクチャが目指す歩留まりとサプライチェーン上の優位性を、顧客が大規模に導入できる製品へと結び付けられるかが試されます。今回の資金調達により、Photon BridgeはAIインフラの拡大における特定の領域に取り組むための資金を得ました。光接続がコンピューティングに近づくなか、光源そのものを単に高出力化するのではなく、製造、認定取得、供給を容易にすることが事業機会となります。
-
 インタビュー14 hours ago
Andrej Jonovic、XBP Global CEO — インタビューシリーズ
Andrej Jonovicは、ミッションクリティカルな企業業務プロセスに注力する多国籍のテクノロジー・サービス企業、XBP GlobalのCEOです。XBP Globalは、医療、公共部門、金融サービスなどの規制対象分野でエージェント型AIを活用しています。これらの分野では、精度、セキュリティ、データ主権、監査可能性が不可欠です。このインタビューでは、Jonovicが適応型プロセスオーケストレーション、オープンウェイトモデル、インテリジェント文書処理、人による判定、そしてAIを技術的な能力から測定可能な業務成果へと結び付けるために必要なことについて語ります。キャリアの出発点は取引法務で、その後、合併・買収、企業変革に携わり、最終的にはXBP Globalを率いる立場になりました。こうした経歴は、ミッションクリティカルな業務プロセスに人工知能を導入する際のガバナンス、商業上のリスク、組織への影響を評価するうえで、どのような影響を与えていますか?私はまず、業務モデルの観点からAIを見る傾向があります。取引や変革に携わっていると、プレゼンテーションの段階を越えて実行に移したときに、その仕組みが本当に機能するのかを問うようになります。これはAIにおいて非常に重要です。モデル単体では極めて高い性能を発揮しても、業務上の成果が悪くなることがあるからです。医療、公共部門、銀行業務では、処理精度、規制遵守、監査可能性は絶対に譲れません。データがどこに保存されているのか、システムに何が許可されているのか、意思決定がどのように管理されているのか、そして業務プロセスを大規模に実行した場合のコスト構造がどうなるのかを理解する必要があります。ガバナンスは、そのアーキテクチャに組み込まれていなければなりません。モデルがどこで稼働しているのか、どの情報が企業の境界を越えるのか、監査証跡に何が記録されるのか、そして業務プロセスがより高度な管理を要する判断に至ったときに何が起きるのかを把握したいと思います。おそらく、私の経歴が最も大きく影響しているのはこの点です。管理されたデモ環境でテクノロジーに何ができるかには、あまり関心がありません。ミッションクリティカルなプロセスに組み込み、信頼して使えるかどうかを知りたいのです。XBP Globalは、エージェント型AIを、従来のルールベースの自動化やロボティック・プロセス・オートメーションを発展させたものと位置付けています。ワークフローがあらかじめ定められた指示に従う方式から、推論や意思決定を行い、複数のタスクを連携させるAIエージェントを活用する方式に移行すると、技術面では何が変わるのでしょうか?アーキテクチャは、はるかに適応性の高いものになります。従来のワークフロー自動化は決定論的です。ルールがあり、次の段階で何が起きるかが分かっているため、プロセスが複雑になるほどロジックを追加して組み込んでいきます。予測可能な業務では、これは非常にうまく機能します。ルールの数が膨大になったり、システムを再構築できる速度よりも速くプロセスが変化したりすると、難しくなります。私たちが現在取り組んでいるのは、適応型プロセスオーケストレーションです。精度とコンプライアンスのために必要な箇所では決定論的なルールエンジンを維持しつつ、推論が価値を生むワークフローの部分にインテリジェントモデルを導入できます。エージェントはタスクを連携させ、情報にアクセスし、次のアクションを選択できます。プロセスで起こりうるあらゆる経路を、誰かがすべてハードコードする必要はありません。もう一つの変化は、基盤となるモデルを、より簡単に置き換えられるようになることです。エンタープライズ向けのオープンウェイトモデルは、急速に性能が向上しています。パイプラインを適切に設計すれば、エコシステムの発展に応じて、運用プロセス全体を再構築することなく、より高性能なモデルを統合できます。そのため、今後ますます重要になる技術的資産は、ワークフローそのものだと考えています。つまり、オーケストレーション、ドメイン知識、モデルを取り巻く制御機能とデータです。多くの企業がAIを試験導入していますが、パイロット段階から本番環境への移行に苦労しています。エージェント型ワークフローを大規模に導入するうえで、企業が直面する最も一般的なアーキテクチャ上または組織上の障壁は何でしょうか? クライアントは実験段階を脱しつつあります。デモを見て、非常に意欲的なROIの約束も聞いてきました。いずれ誰かが、このテクノロジーを実際のプロセスに組み込み、機能させなければなりません。そこでアーキテクチャが難しくなります。本番環境のワークフローは、企業がすでに利用している環境と連携しなければなりません。機密情報はプライベートクラウドまたはオンプレミスに保管する必要があるかもしれません。既存システムにも引き続きアクセスできなければなりません。規制要件を満たす必要もあります。さらに、エンタープライズ規模で運用した場合にも経済性が成り立たなければなりません。私たちは最近、世界規模で運航する航空会社の航空機群における整備ライフサイクルに関する業務を受注しました。すべての整備項目をベクトル化し、クライアントのプライベートクラウド内にある専用のベクトルデータベースに保存します。エージェント型のインフラがその情報へのアクセスを管理し、航空機のリース契約が終了したときや売却されたときに、記録を再現できるよう支援します。これは、モデルが航空機の記録について質問に答えられると証明することとは、まったく異なる問題です。データ管理と、繰り返し確実に機能しなければならないプロセスを含む、業務環境全体を扱うことになります。組織面での課題は、たいてい責任の所在にあります。本番運用とは何を意味するのかを定義できるほど、プロセスを深く理解している人が必要です。そうした運用上の規律がなければ、パイロットは長い間、印象的なままでも実用には至らないことがあります。XBP Globalは、自動化と人間による確認を組み合わせ、特に重大な影響を伴う判断において、その体制を重視しています。AIシステムが自律的に実行できる判断と、人間がプロセスに関与し続けるべき判断を、どのように見極めていますか? 人間の役割は、判断や裁定を担うことを中心に設計しています。重大な影響を伴うワークフローでは通常、高い確度でパイプラインを通せる作業が大量にあります。一方で、情報が不完全なケース、状況が特殊なケース、あるいは誤った判断をした場合の影響が大きすぎるケースもあります。パイプラインがそのようなケースに達すると、案件はその分野の専門家に引き継がれます。専門家が解決し、その判断をシステムにフィードバックすることで、モデルは継続的に改善されます。このフィードバックループは重要だと思います。人間による監督は、時間の経過とともにワークフローを改善できるとき、より大きな価値を発揮します。専門家は、モデルがまだ必要としているケースに、分野固有の知識をもたらします。自律化の基準は、環境にも大きく左右されます。医療分野の審査、公共部門の記録、規制対象の金融業務には、影響の小さい社内業務とは異なる要件があります。許容できる確信度は、システムが判断を実行したときに、その判断が実際にどのような結果をもたらすかを踏まえて定める必要があります。規制産業や公共部門で事業を展開する貴社のクライアントにとって、データ主権、セキュリティ、監査可能性は欠かせません。こうしたシステムの有用性を支える機能を損なわずに、保護された環境内で大規模言語モデルを運用するには、どうすればよいのでしょうか? オープンウェイトモデルの登場によって、この問いへの答えは大きく変わりつつあります。長い間、最高のモデル性能を得るには、情報を他社の環境に送る必要があると考えられていました。データを企業の境界内にとどめなければならない場合、これは明らかな問題になります。現在では、エンタープライズ水準のオープンウェイトモデルを、データをクライアントの環境内に保ったまま、実運用のエージェント型パイプラインに統合できます。要件に応じて、プライベートクラウドやオンプレミスのインフラを利用できます。データ主権に関して組織が必要とする管理体制を維持しながら、モデルを取り巻くエコシステム全体の進歩による恩恵も得られます。アーキテクチャは変更に対応できなければなりません。現在のモデルが、特定のタスクにおいて今後も最良であり続けるとは限りません。当社の学習プロトコルは、既存のパイプラインに新しいモデルをすばやく統合できるよう設計されています。規制対象のクライアントにとって、この柔軟性は非常に価値があります。データの境界を維持しながら、ワークフローを継続的に改善できるからです。また、EU AI Actなどの要件への対応を始めるうえでも重要です。コンプライアンスを、技術の導入後に付け加えるものとして扱わずに済みます。企業情報の多くは、今も文書、画像、レガシーシステム、紙の記録に閉じ込められています。インテリジェント文書処理はどのように進化しており、断片化したデータをAIエージェントが確実に利用できる情報へ変換するうえで、どのような役割を果たしていますか?インテリジェント文書処理は、エージェント型ワークフローを支えるインフラの一部になりつつあると思います。従来、文書処理の多くはテンプレートに基づいていました。文書の形式と必要な項目があらかじめ分かっており、システムがその項目を抽出していました。しかし、企業情報がそれほど整っていることはめったにありません。医療分野だけを見ても、EOB(給付内容説明書)、複雑なやり取りを含む文書、請求情報、さまざまな形式で届く記録などを扱うことがあります。新しいアプローチは、文脈をより深く理解します。非構造化情報を取り込み、何が関連するのかを把握したうえで、後続のシステムが実際に利用できる構造化データに変換できます。これは重要です。エージェントは、基盤となる情報が不完全だったり、誤って解釈されていたりすれば、業務を確実に連携・実行できないからです。規模が大きくなると、問題の性質も変わります。当社は、膨大な量の画像、請求、決済取引、その他の文書を処理する環境を運用しています。その規模では、抽出品質のわずかな差が、運用上の非常に大きな問題につながります。そのため、IDPはインテリジェントなワークフローの最前線に位置するようになっています。断片化した情報を利用可能なデータに変換し、プロセスの次の段階が信頼できる情報に基づいて処理できるようにするとともに、その後のさらなる自動化の基盤を築きます。XBP Globalは、レガシーなルールベースのプロセスをエージェント型AIパイプラインに移行し、初回処理での解決率を高めることについて説明してきました。AIシステムが信頼できる成果を出すには、組織のプロセス、例外、組織に蓄積された知識について、どのようなことを理解している必要がありますか?組織に蓄積された知識の多くは、整理されたプロセス文書にまとめられていません。それは旧来のシステムやルール群、そしてそのプロセスを何年も運用してきた人々の判断の中に存在しています。彼らは、どの情報が重要か、特定の状況でどのルールが適用されるか、誤った判断が下された場合に後続の工程で何が起こるかを理解しています。その業務を移行する際には、こうした運用上の知識を維持しなければなりません。私たちの領域では、多くの場合、すべてのルールをすぐになくすべきだと考えるのではなく、決定論的なロジックとAIを組み合わせることを意味します。規制対象のワークフローには、要件が明確であるため、ルールエンジンが非常に有効な部分があります。一方で、変化への対応には、インテリジェントなモデルのほうがはるかに優れている部分もあります。それぞれをどこに適用すべきかは、業務分野の専門知識によって判断できます。だからこそ、初回対応での解決をモデルのスコアだけで評価することはできません。ワークフローは、プロセスの次の段階に進んでも問題のない結果を生み出す必要があります。後続のどこかで再びエスカレーションが発生するなら、問題を解決したのではなく、移したにすぎません。システムは、取引の開始から完了まで、何をもって成功とするのかを把握できるだけの十分なプロセス理解を備えていなければなりません。XBP Globalは、顧客業務だけでなく、自社がAIファーストの運営モデルへ移行する取り組みにも自動化を活用しています。社内を実証の場として活用する中で、どのようなことを学びましたか。また、生産性向上と人材育成、チェンジマネジメントのバランスをどのように取っていますか?自社の業務にもかなり積極的に適用してきました。結果が自社の収益に直結するため、非常に早く学べると思うからです。AIファーストの自動化施策によって、年間換算で6,500万~7,500万ドルの業務効率化が見込まれており、そのうち約3,500万ドルの効果が2026年中に生じると予想しています。従業員1人当たりの売上高は第2四半期に約8万9,000ドルとなり、前四半期の約8万2,000ドルから増加しました。年末までには10万ドル近くに達すると見込んでいます。こうした指標は、運営モデルの生産性が実際に向上しているかどうかを示してくれるため、有用です。人員への影響は現実に生じています。より生産性の高い運営モデルへの移行に伴い、2026年末までに世界全体の従業員数を約20%削減すると見込んでいます。チェンジマネジメントでは、生産性の変化によって人員要件も変わることを認識しなければなりません。同時に、こうしたワークフローに携わり続ける人々には、より高い能力が求められます。業務を構成し、出力を評価し、より高い価値を生む意思決定に責任を持てる、業務分野の専門家、アーキテクト、オペレーターが必要です。この変革を自社内で進めたことで、議論はずっと実務的になりました。どの自動化が持続的な効率化をもたらし、どの活動が単に誰かがAIをより頻繁に使っているだけなのかは、すぐに分かります。企業のAIプロジェクトは、測定可能な事業成果よりもデモを通じてアピールされることがよくあります。インテリジェントなワークフローを評価する際、経営者はどの指標を使うべきでしょうか。また、精度、例外率、処理時間、運用コスト、リスク低減をどのように考慮すべきでしょうか?ワークフローは、2つのレベルで測定すべきだと考えています。運用レベルでは、精度、初回対応での解決率、処理時間、例外の件数、業務処理コストを把握したいと思います。規制対象の環境では、取引の監査可能性に加え、大量処理時にも統制が一貫して機能するかどうかも重視します。次に、こうした改善が事業の収益性に結び付いているかを確認したいと思います。XBPでは、第2四半期の調整後売上総利益率が24.9%に達し、過去最高を記録しました。同じく従業員1人当たりの売上高も約8万9,000ドルに増加しました。追加の自動化機会を特定したことで、年間換算の業務効率化目標も6,500万~7,500万ドルに引き上げました。これらの指標が示すのは、ベンチマークのスコアとは異なるものです。テクノロジーが業務のコスト構造を変えているかどうかが分かります。モデルの精度が非常に高くても、運用コストがかかりすぎたり、手作業によるやり直しが多すぎたりすれば、そのワークフローの導入は失敗となり得ます。経営者は、結果が最終段階に至るまで追跡する必要があると思います。テクノロジーは、実際に測定できる何らかの業務上の効果をもたらさなければなりません。今後、エージェント型AIは既存の企業システムに追加されるレイヤーにとどまると思いますか。それとも、人、ソフトウェア、データ、業務プロセスが連携するための主要なオーケストレーションレイヤーになるでしょうか?ワークフローのより多くの部分が、エージェント型になっていくと思います。企業には今後も、特定の機能を担うシステム、データリポジトリ、アプリケーションが存在します。変わるのは、それらの間で業務がどのように進むかです。エージェント型のパイプラインは、情報を取得し、ツールを連携させ、アクションを実行し、取引に別種の介入が必要かどうかを判断できます。航空会社の例には、すでにその姿が表れています。整備記録は顧客の環境内にあるプライベートなベクトルデータベースに保存され、エージェント型レイヤーが整備ライフサイクル全体を通じて、その情報へのアクセスと活用を管理します。この種のオーケストレーションは、今後さらに一般的になると考えています。基盤となるモデルは今後も変化し続けるでしょう。オープンウェイトモデルは急速に進歩しており、現在利用しているモデルの次の世代も登場するはずです。そのため、企業がモデルを取り巻く永続性のある仕組みを必要とするなかで、オーケストレーション層の重要性はますます高まっています。プロセス、ドメイン知識、セキュリティ要件、企業向けの制御を軸にパイプラインを構築すれば、より優れたモデルが登場するたびに、その利点を引き続き活用できます。長期的な価値の多くは、そこにあると考えています。素晴らしいインタビューをありがとうございました。さらに詳しく知りたい方は、XBP Globalをご覧ください。
-
 ロボティクスとフィジカルAI14 hours ago
CoreWeave、ロボット工学と自動運転車の開発向けにPhysical AIテンプレートを提供
ロボット工学チームが新しいポリシーをテストするには、その前にシミュレーター、データ、ストレージ、コンピューティングを連携させる必要がある。CoreWeaveは、こうした準備作業を支援するため、ロボット工学、自動運転車、シミュレーション向けのテスト済みワークロードテンプレートを集めた「Physical AI Launchables」を10月21日に発表した。このテンプレートは、NVIDIA Isaac Sim、CARLA、MuJoCo、NVIDIA AlpaSim、NVIDIA Cosmos 3という5つのツール向けに環境をパッケージ化したものだ。エンジニアはインフラを一から組み立てる代わりに、コマンドを実行するだけでワークロードを設定して起動できる。今回の発表には、コーディングエージェントが同じワークフローを操作するためのスキルも含まれている。開発者にとって重要なのは、何を繰り返し実行できるようになるかだ。Launchablesは、実験のたびにチームがシーン、データセット、モデル、結果を左右する設定を変更しながら、動作する環境を維持できるようにすることを目指している。実験の準備作業を基盤側に移すPhysical AIの実験は、モデルを実行するだけでは完結しない。運転評価にはシミュレーターとシナリオが必要であり、ロボット学習のジョブには環境、ポリシー、結果を収集する手段が必要となる。さらに、これらの構成要素には、適切なストレージ、コンピューティングリソース、実行制限も必要だ。CoreWeaveによると、同社のエンジニアは各テンプレートの基盤となる構成を構築し、テストしている。チームはそれらの構成を自分たちの作業に合わせて調整でき、継続的なプログラムには予約済みのリソースを、個々の実験には必要に応じて追加するリソースを利用できる。サポート対象の各ツールには、ワークロードを指定せずに環境だけを提供する空のテンプレートも用意されている。「Physical AI Launchablesは、チームがすでに使っているツール向けに、テスト済みの出発点を提供します。そのため、チームは自分たちにしかできない作業に、より多くの時間を割けるようになります」と、CoreWeaveのPhysical AI担当上級副社長、Richard Ahlfeld氏は発表の中で述べた。ここには有用な線引きがある。CoreWeaveが提供するのはパッケージングと実行のレイヤーであり、シミュレーションやモデリングのソフトウェアはNVIDIAなどの開発企業が提供する。何をテストし、その結果に意味があるかどうかを判断するのは、引き続き各チームだ。初期テンプレートで実行できることCoreWeaveの技術的な発表記事では、カタログの内容がより具体的に紹介されている。例として、ロボット操作、運転シミュレーション、合成データ、強化学習が挙げられている。 NVIDIA Isaac Sim:ロボットアームによるピック・アンド・プレース、ラベル付きの倉庫シーン、車両ダイナミクスの実験。 CARLA:検査用の動画を生成する運転シナリオの一括実行。 MuJoCo:強化学習の並列実験と、キッチンでの操作タスク。 NVIDIA AlpaSim:クローズドループ方式の運転評価。 NVIDIA Cosmos 3:収集が難しい、あるいはコストのかかる可能性がある動画シナリオの生成。 これらは固定されたデモ一式ではなく、出発点となる構成だ。エンジニアは、テスト済みの環境を維持したまま、ワークロードのパラメーターを変更したり、アプリケーションコードを編集したりできる。今回の発表には、データの拡張、ラベル付け、キュレーション、検索に使えるNVIDIA Cosmos Data...
-
 パートナーシップ14 hours ago
Mary Technology、Harveyと提携し、精査済みの案件事実を法務AIに提供
Mary Technologyは、訴訟チームが蓄積してきた事実調査の成果を、弁護士が調査や文書作成に利用するプラットフォームに取り込むことを目的に、Harveyとの連携を発表しました。この連携機能により、HarveyはMaryが管理する案件記録にアクセスできます。記録には、過去の調査結果やその根拠となる証拠、それらの調査結果に対するチームのレビューが含まれます。この提携は、法務AIが直面する実務上の課題に対応するものです。説得力のある回答を作成することは、仕事の一部にすぎません。弁護士は、その回答を裏付ける文書はどれか、ほかの証拠と矛盾しないか、未解決の点は何かも確認する必要があります。Maryは、弁護士が次の質問をする前に事実関係の基盤を整理し、その後の業務で使うツールから利用できるようにすることを目指しています。Harveyに引き継がれる事実記録発表によると、Maryは最初の質問が行われる前に、アップロードされた案件文書を読み取り、内容を整理します。案件の進展に応じてチームの調査結果とレビュー内容を保持するため、誰かが新たなAI支援タスクを始めるたびに、調査をやり直す必要はありません。両社は、ある申し立てを支持する証拠と反証する証拠の評価、証人の供述と同時期に作成された文書との比較、財務記録における支払いや資金移動の調査などを用途として挙げています。Maryは、矛盾点や不足部分、裏付けとなる証拠を、作成された成果物と並べて確認できるようにします。また、作業の根拠となった文書と、対象から除外された文書についても説明します。「訴訟におけるAIの価値は、AIが参照する事実記録の質に左右されます」と、Mary Technologyの共同創業者であるDaniel Lord-Doyle氏は述べています。「Maryが取り組んでいるのは、案件の証拠を、弁護士とそのAIツールが活用できる事実関係の基盤へと変えることです。」この区別が重要なのは、事件記録に同じ出来事についての複数の見解が含まれることがあるためです。AIアシスタントを文書リポジトリにつないだだけでは、意見の相違は解消されません。この連携は、抽出されたすべての発言を確定した事実として提示するのではなく、留保や未解決の疑問も含め、チームが進めてきた調査を引き継ぐことを目的としています。この連携機能を支える技術MaryのMCP製品ページでは、対応するAIツールが、Maryで管理されている事実記録をもとに作業するための接続方法が説明されています。この記録では、人、日付、出来事、争点、証拠が整理され、文書の網羅状況やレビューの進捗も確認できます。同社のより広範な方針は、案件を通じてすでに確立された文脈を失うことなく、弁護士が好みのAIインターフェースを使えるようにすることです。Harveyは、より広範な法務業務環境を提供します。そのプラットフォームは、契約書の分析、デューデリジェンス、コンプライアンス、訴訟などの分野を網羅しています。この提携により、Maryの専門的な事実調査をその幅広い作業環境で利用できるようになり、文書作成、調査、事件の展開に役立てられます。「MaryをHarveyに導入することで、弁護士は文書の作成、調査、訴訟の組み立てを行う場所で、案件の事実関係についてチームがすでに積み上げてきた知見を活用できます」と、Harveyのプロダクト事業開発責任者であるNate Schlein氏は述べています。弁護士によるレビューも引き続きワークフローに含まれる発表によると、このレビュー工程では、弁護士が事実を確認し、同僚が行った確認内容を把握し、監査履歴を調べることができます。案件の進展に応じて、調査結果、相反する見解、留保事項、レビューの履歴はMaryに保持されます。新たな文書が既存の作業に影響する場合、Maryは対応する成果物の更新を提案します。Maryがその更新を処理する前に、ユーザーが変更を承認します。更新された成果物は、次にHarveyが連携機能を利用する際に使えるようになります。これにより、この連携は初回の分析後も継続的な役割を果たします。証拠が変われば、事実関係の基盤も更新できます。Maryはまた、MCPページで、法律事務所がアクセス管理権限を保持し、顧客の案件情報をAIモデルの学習に使用しないと説明しています。これらの管理措置は、訴訟に関わる機密情報を扱ううえで重要です。ただし、法律事務所は、連携機能が自らの権限設定やレビューの慣行にどのように適合するかを引き続き評価する必要があります。中心となるのは追跡可能性発表では、この連携によって事実誤認がどの程度減るかを示す独立したベンチマークは提示されていません。追跡可能な記録が役立つのは、回答を検証しやすくなるためです。ただし、それだけですべての推論が正しいと保証されるわけでも、相反する証拠の法的な意味合いが確定するわけでもありません。この提携が実務上どれほど有用かは、弁護士が提示された回答からその根拠となる文書へ効率よくたどり、何が除外されたかを理解し、事件の進展に伴う修正を維持できるかどうかにかかっています。MaryとHarveyは、こうした各段階をより緊密につなぎ、事実記録の質と継続性をAIワークフローの中核に据えています。
-
 Andersonの視点14 hours ago
AIへの執着が、その存続に不可欠な研究分野を衰えさせるおそれ
私は10年間、人工知能だけを専門に執筆してきました。2022年当時、AIだけを専門に扱うジャーナリストは世界でもほんの一握りでしたが、今では数千人、あるいはそれ以上に増え、資金力のある報道機関では人工知能専門のスタッフを複数人雇うところもあります。今や人類は、一世紀に一度あるかないかの文化的・技術的現象に、関心も努力も不安も希望も集中させています。実用的な大規模言語モデルや効果的な拡散モデルによる画像・動画生成が登場するまでは、それは「珍奇なもの」の領域にとどまっていました。ディープフェイクは政治的な争点として利用されていたものの、世界経済は脅かされていないように見えていました。「日常化」したAIの嵐もちろん、今では状況は一変しました。あらゆるものが脅かされ、あらゆるものが変革を迫られています。そして、おそらく2026年は、翌年についての予測に根拠を示すことが最も難しい年でした*。新たなクローズドソースモデルやオープンウェイトモデルは毎週、時には週に数回も公開されています。公開頻度は今やあまりに高く、熱心な愛好家や趣味で取り組む人々のコミュニティでさえレビューされないモデルもあります。そうした人々は、この状況に対して懐疑的になりつつあり、絶え間なく続くリリースの中で注目を集めるための基準も、ますます高くなっています。研究やリリースの動向を熱心に、そして仕事として追ってきた者として言えば、AIの研究開発の各分野における進歩は、大きな間隔を置いて大きな影響をもたらすことはあっても、革命的あるいは進化を画する節目、たとえばTransformerのようなものより、むしろ小刻みな積み重ねとして現れる傾向があります。これは以前から変わりません。最近の衝撃的な話題の多くは、AIの最新機能よりも、AIが経済に与える影響をめぐるものです。さらに、以前にも指摘したように、2022年以降のAI研究の大ブームでは、研究の量が増えても、そこで示されるアイデアの質が常に伴っているとは限りません。多くは、既存の研究やより新しい研究を「フランケンシュタイン風」に作り直したり、組み合わせたり、再構成したりしたものです。既存研究をつぎはぎしたアーキテクチャーによって、先行研究を見かけ上大幅に上回る成果を生み出そうとしますが、精査すると、脆弱な手法やあまりに法外なVRAMコストに足を引っ張られています。話題から取り残された分野何千人ものジャーナリストがAI報道に移ったことで、それまで彼らが扱っていたテーマは、必然的に直接取り上げられる機会が減ったはずです。ある意味、それは大きな問題ではありませんでした。AIの話題や導入が文化やインフラに広く浸透し、たとえばエネルギー担当記者も、今では他のどのテーマよりもAI関連の問題を多く扱うようになったからです。経済、雇用、政治、政策などを担当する記者も同様です。これらのテーマはすべて、今ではAIという視点を通して捉えられるように思えました。それは、縮小し続ける分野(とはいえ、最近は少し持ち直しています)において、「AI専門」の報道が大幅に増えた理由の一端を説明するのかもしれません。その結果、「AIへの執着」によって、ほかのテーマが十分に報道されなくなっているのではないか、と考えずにはいられません。いずれ「最重要テーマ」であるAIそのものに影響を及ぼすかもしれない、さまざまな物語や動向、分野を持つテーマが、です。とはいえ、どうしようもありません。使えるリソースには限りがあり、今のところAIは今世紀最大の話題なのです。AI分野への大移動この問題について私の心を大いに揺さぶった新たな論文によると、AIそのものにも同じことが起きている可能性があります。縮小と再投入によって将来のモデルの質が低下するリスクに加え、異なる分野をまたいでアイデアが生まれ、互いに影響し合う、より広範な科学のエコシステムがAI研究に過度に集中しつつあります。その結果、一見無関係なアイデア同士の思いがけない結びつきが分野全体を変えるような「偶然の発見」が、ますます稀になるかもしれません。要するに、「人工知能の飛躍的進歩は、その枯渇を早める」と題されたこの新たな研究は、AIへの執着が新しい進展の生まれる土壌を奪いつつあり、AIに直接影響する進展もその例外ではないと示唆しています。また、著者たちの言葉を大まかに言い換えれば、関心が集まるようになったこの新たな領域には、望ましい結末につながりそうにない、ある種の「近親交配的な傾向」があります。論文には次のように記されています†。「支配的なパラダイムは、その競合相手だけでなく、後継となるパラダイムが再構成されるための多様性まで取り除いてしまう。「2017年以降の関心の狭まり、分野を移った著者の半数を超える人々がAIに移ったこと、新しいアイデアの活力の低下、そして相次ぐサイクルを経るごとに、活動中のアイデア群が急激に衰退していること。これらを合わせると、自ら生み出した支配的なパラダイムの成功によって、創造力が損なわれつつあるシステムの姿が浮かび上がる。」これまでの研究では、AIが研究を画一化させつつある可能性が指摘されてきたが、新たな研究の著者らは、AIの影響力が拡大することで、AI自身が進歩を続けるために必要な新しい発想が不足しかねないとも考えている。著者らはAI研究を生物科学になぞらえており、生物科学ではクライオ電子顕微鏡やAlphaFoldといった画期的な成果が、同様のイノベーションと衰退のサイクルを引き起こしてきた。自説を裏付ける実証的な証拠を得るため、著者らは1990年から2025年に発表されたOpenAlex収録のコンピューターサイエンス論文718万本を分析し、研究テーマと引用の変化、370万人の研究者の分野間の移動、さらにAIの影響力拡大が科学の多様性に及ぼした影響を調べるための査読7万3,089件を追跡した。データから明らかになった最も興味深い知見の一つは、近年、研究者がそれまで取り組んでいた分野を離れ、AIへ移っていることに関するものだ。「移っていくのはキャリアの中盤にある、ある程度の実績を築いた研究者たちだ。彼らは、自らの地位を築いた研究を離れ、分野の引力に引き寄せられていく。その代償として、方向転換による不利益を被ることになっても」調査によると、コンピューターサイエンスの分野間で確認された91万8,862件の移動のうち、半数以上がAIへの移行だった。一方、特にシステム分野や理論研究などの領域では、研究者が着実に減少していた。分野を移る可能性が最も高かったのは、経験を積み、確固たるキャリアを築いた研究者だった。その一方で、コンピューターサイエンス論文全体に占めるAI論文の割合は、2017年の40%から2025年には55%超へと増加した。3つの兆候この論文は、2017年以降のコンピューターサイエンスを特徴づけるようになったと著者らが論じる、3つの「収束する兆候」を特定している。1つ目は、トランスフォーマー・アーキテクチャが登場した2017年以降に、研究上の関心が急速に狭まったことだ。著者らは718万本のコンピューターサイエンス論文から、それぞれの論文で最も目立つキーワードを10個抽出し、研究がどれほど同じテーマに集中しているかを追跡した。数十年にわたり、インターネットやスマートフォン、ディープラーニングが台頭した時期にも、この集中度は比較的安定していた。しかし2017年から2025年にかけて、研究上の関心に関するジニ係数††(上の画像を参照)は0.26から0.33へ上昇し、27%増加した。引用もさらに集中し、ジニ係数は0.60から最高0.69まで上昇した。Tsinghua University、University of Chicago、Santa Fe Instituteに所属する研究者らは、次のように述べている。「トランスフォーマーは、それ以前の技術とは異なる規模でこの分野に変革をもたらした。この傾向は分析上の産物ではない。[keyword count]の違いを考慮しても確認できる」さらに、次のように続けている。「コンピューターサイエンスの出版物に占めるAIの割合は、2017年から2025年にかけて40%から55%超へと上昇する一方、システム研究は長きにわたる黄金期から後退し、理論研究はさらに縮小している」したがって、この知見は、コンピューターサイエンスが拡大する一方で、研究者たちはますます同じアイデアを追い求め、より限られた範囲の研究を引用するようになっていたことを示唆している。2つ目の「兆候」は、専門分野を離れてAIに取り組む研究者の増加に関するものだ。著者らは370万人の研究者を追跡し、コンピューターサイエンスの分野間で約91万9,000件の移動を確認した。そのうち53.81%はAIへの移行だった。AIは毎年研究者を獲得する一方、システム分野と理論分野では着実に研究者が減っていた。分野を移ったのは、新人やベテランではなく、キャリアを積んだ中堅の研究者である傾向があった。AI分野へ移る可能性は、学術キャリア年数が31.8年の研究者で最も高く、論文業績では上位82パーセンタイルに位置する研究者でも最も高かった。論文が指摘する3つの傾向のうち3つ目は、査読への負担が増していることだ。査読とは、科学論文の質と信頼性を、出版前に他の研究者が評価するプロセスである。2017年から2025年にかけて、45の学会やその他の発表先に投稿された26,731本の論文に対する73,089件の査読を調べた結果、論文を評価する自分の能力に対する査読者の自信は、5段階評価で3.9から2.9に低下していた。著者らは、この低下はAIの急速な拡大を反映している可能性があると示唆している。その結果、論文に適した専門知識を持つ査読者を見つけることが難しくなっている。「査読者の層には、AIの引力に引き寄せられた新人が大量に流入している。査読者には、自身の専門分野から外れたAI手法を盛り込んだ論文がますます多く割り当てられている。投稿論文を真に専門性のある査読者に割り当てることは、構造的に困難になっている。」「この状況では、論文が採択されるかどうかは、ますますコイン投げのようなものになっている。」ゴールドラッシュの後に論文はまた、AIにおける最大のブレークスルーが、最終的には自らの消耗を早める可能性も示唆している。大きな進歩のたびに新しいアイデアが一気に増えるものの、研究がブレークスルーそのものにますます集中するにつれ、こうした初期のイノベーションの高まりは、やがて勢いを失って単調な反復へと落ち着いていくためだ†。「現代AIにおける連続したサイクルは、以前より早く飽和し、より急激に消耗する。そのサイクルは短縮している。「AlexNet、Transformer、大規模言語モデルという3つの主要な技術進歩にわたる、コンピューターサイエンスの36年間の発展を通じて、私たちは同じスパイラルを繰り返し観察している[pattern]。「特筆すべきは、このパターンがコンピューターサイエンスに限られないことだ。生物学でも、計算を伴わない進歩(例:クライオ電子顕微鏡)と計算を伴う進歩(例:AlphaFold)のいずれに続いても、同じ消耗のサイクルが見られる。」 この「消耗」は、オートエンコーダーや敵対的生成ネットワーク(GAN)、そしてオートエンコーダーを用いたディープフェイクのような手法でも確かに見られた。これらはいずれも、その可能性が明らかに尽きた後も何年にもわたり、研究者たちに容赦なく酷使され、新たな枠組みや手法がついに登場して、それらにかかる負担を軽減するまで続いた。いずれにせよ、こうしたサイクルを追跡するため、著者らは科学論文の要旨から特徴的な名詞や句を探し、それらが研究アイデアの変化を示す指標となるよう、出現、消失、そして時折の再登場を追跡した。2012年のAlexNetと2017年のTransformerは、それぞれ新たなアイデアの波を引き起こし、やがてその波は収束した。ブレークスルーのたびにAIはさらに優位に立つ一方、他のコンピューターサイエンス分野は後れを取り、最終的には2012年以前よりも新しいアイデアを生み出すペースが落ちた。この傾向は、使われなくなるアイデアにも当てはまる。新たな画期的な成果が、登場から何年もたって旧来のアプローチを一掃することもある。とはいえ、画期的な成果そのものも同じサイクルにとらわれている。それぞれが研究の注目を集めて急増させるものの、やがてその勢いは衰え、分野は再び活気づける新たな発見を待つことになる(Gaussian Splattingで起きたように、31年の間隔を経て)。著者らによると、AIの成功によって研究者やアイデアが少数の有力なアプローチに集中する一方、それらに取って代わるものを生み出す助けとなりうる周辺分野は、勢いを失い続けている。また、これが将来の画期的な成果を完全に妨げるとまでは予測していないものの、AIが次の飛躍を支えるかもしれない多様性を徐々に失わせている可能性を指摘している。現に使われているアイデアの数も追跡したところ、AI開発の波が次々と訪れるにつれて、その数は予測を下回る幅が拡大した。Transformerの登場後の不足幅は、AlexNetの後よりも大きかった。要するに著者らは、AIに関わる課題の範囲がますます狭まるなか、そこに研究努力と人材が集中することで、かつては自然にAI分野へアイデアをもたらしていた周辺分野、さらには多様な他分野までが衰退するおそれがあると結論づけている。2025年のノーベル経済学賞の授与に関するJohn Hasslerのコメントに言及し、著者らは次のように結論づけている。「ノーベル委員会は、停滞を避けるには創造的破壊の仕組みを維持しなければならないと警告した。私たちの研究は、その仕組みの一つである知的多様性を明らかにし、現在の制度がそれを損なっていることを示している。「審査制度、投稿料や規則、報酬体系、採用、昇進、退職に関する慣行12など、注目の配分を左右する制度はすべて、次のパラダイムが生まれる余地を持てるかどうかを形づくる。「制度を適切に設計するには、現在優勢なパラダイムに一層力を注ぐ衝動を抑え、探究ではなく集中に負担を課し、評価の権限を多作な人々から新規性のあるものへと移す必要がある。「創造的破壊が成長を支えられるのは、再結合できる何かを残す限りにおいてのみだ。特異点に後継者はいない。」



