
एआई की मूल बातें
जनरेटिव बनाम डिस्क्रिमिनेटिव मशीन लर्निंग मॉडल

 Unite.AI को Google पर अपने पसंदीदा स्रोतों में जोड़ें
जनरेटिव और डिस्क्रिमिनेटिव यह वर्णन करते हैं कि मॉडल डेटा और लक्ष्य के बारे में क्या सीखता है। पारंपरिक सुपरवाइज़्ड वर्गीकरण में, एक जनरेटिव मॉडल संयुक्त वितरण जैसे P(x, y) या वर्ग-शर्तीय P(x|y) सीखता है, जबकि एक डिस्क्रिमिनेटिव मॉडल P(y|x) या सीधे निर्णय सीमा को सीखता है।
यह अंतर उपयोगी है, लेकिन आधुनिक सिस्टम अक्सर उद्देश्यों को मिलाते हैं। एक मॉडल जनरेटिव प्रतिनिधित्व सीख सकता है और बाद में डिस्क्रिमिनेटिव भविष्यवाणी के लिए फाइन‑ट्यून किया जा सकता है, या जनरेशन और वर्गीकरण के बीच एक ही बैकबोन साझा कर सकता है।
मुख्य बिंदु
- जनरेटिव वर्गीकर्ता मॉडल इनपुट और लेबल के उत्पन्न होने की प्रक्रिया को मॉडल करते हैं; डिस्क्रिमिनेटिव वर्गीकर्ता मॉडल इनपुट के आधार पर लेबल या निर्णय सीमा को मॉडल करते हैं।
- जनरेटिव धारणाएँ सीमित लेबल्ड डेटा में मदद कर सकती हैं लेकिन कभी‑कभी गलत भी हो सकती हैं।
- डिस्क्रिमिनेटिव विधियाँ अक्सर क्षमता को भविष्यवाणी कार्य पर केंद्रित करती हैं और बेहतर असिम्प्टोटिक वर्गीकरण त्रुटि प्राप्त कर सकती हैं।
- GAN, VAE और भाषा मॉडल जनरेटिव सिस्टम हैं, लेकिन “जनरेटिव” का अर्थ यह नहीं है कि प्रत्येक घटक एक जनरेटिव वर्गीकर्ता है।
संभाव्यता विभाजन
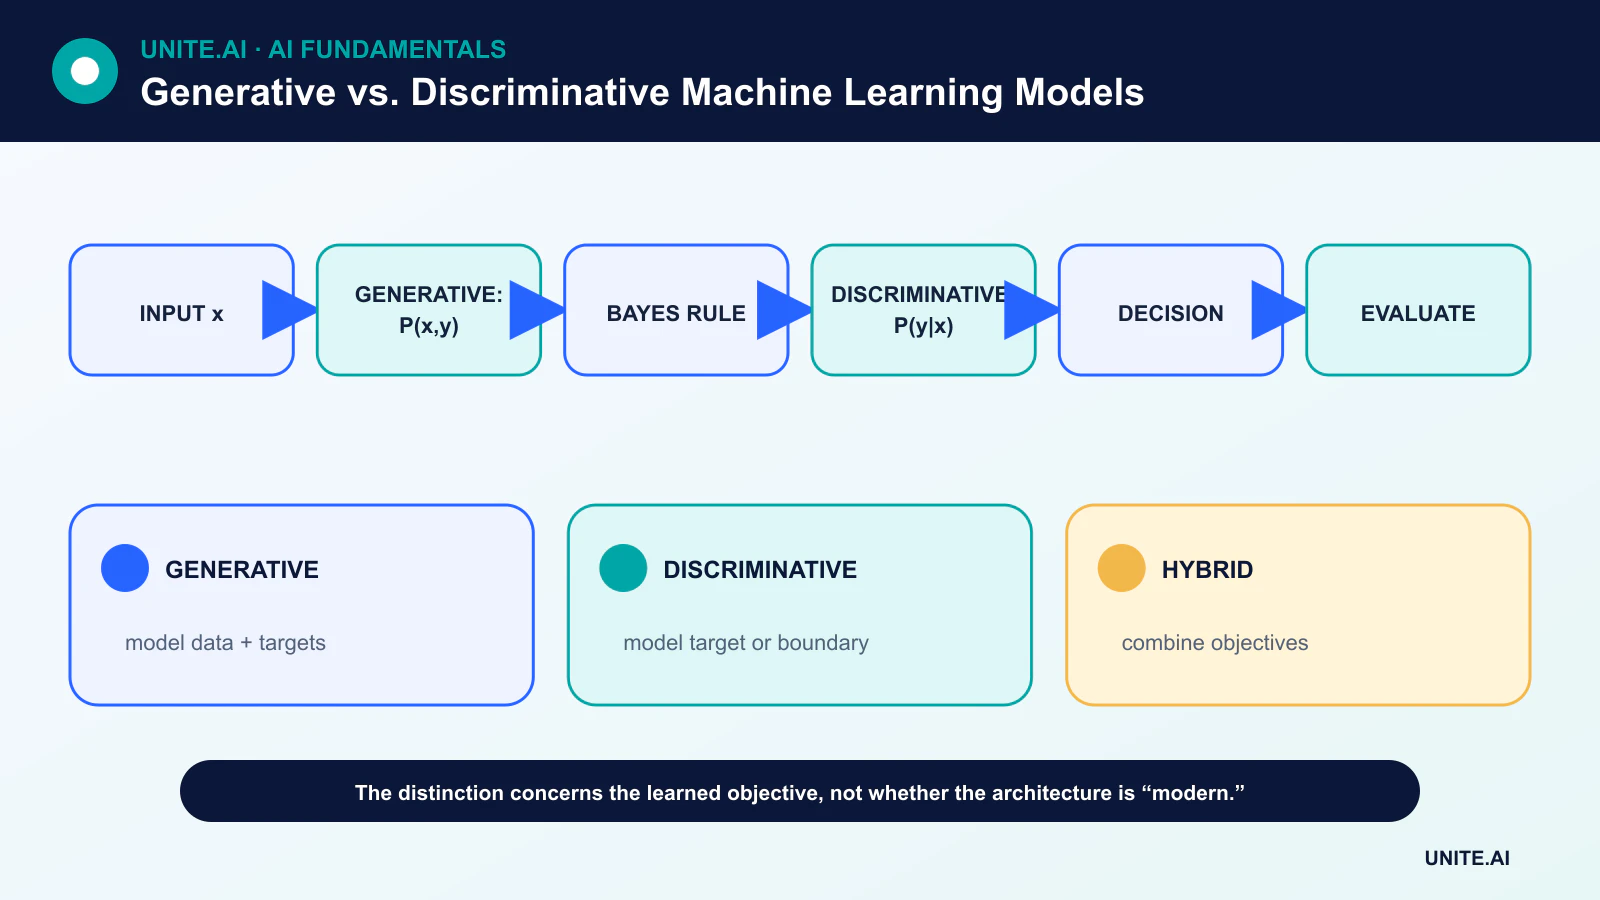
एक जनरेटिव वर्गीकर्ता P(x|y) और P(y) का अनुमान लगा सकता है, फिर बेयेस सिद्धांत का उपयोग करके P(y|x) प्राप्त करता है। नाइव बेयेस इसका क्लासिक उदाहरण है। एक डिस्क्रिमिनेटिव वर्गीकर्ता जैसे लॉजिस्टिक रिग्रेशन P(y|x) को सीधे अनुमानित करता है; एक SVM विभाजन सीमा सीखता है।
P(x,y) को मॉडल करना x से y की भविष्यवाणी करने से व्यापक कार्य है। यह अतिरिक्त संरचना सैंपलिंग या लापता डेटा तर्क में सहायक हो सकती है, लेकिन इसके लिए इनपुट वितरण के बारे में धारणाएँ आवश्यक होती हैं।
डेटा दक्षता और असिम्प्टोटिक व्यवहार
Ng और Jordan द्वारा नाइव बेयेस और लॉजिस्टिक रिग्रेशन की तुलना ने एक उपयोगी ट्रेड‑ऑफ़ दर्शाया: उनके धारणाओं के तहत, जनरेटिव मॉडल कम उदाहरणों से अपनी सीमित प्रदर्शन के निकट पहुँच सकता है, जबकि डिस्क्रिमिनेटिव मॉडल कम असिम्प्टोटिक त्रुटि प्राप्त कर सकता है।
यह सार्वभौमिक रैंकिंग नहीं है। परिणाम इस बात पर निर्भर करते हैं कि मॉडल परिवार डेटा के अनुकूल है या नहीं, आयाम, रेग्युलराइज़ेशन, ऑप्टिमाइज़ेशन और लेबल की गुणवत्ता क्या है। प्रतिनिधिक वैलिडेशन डिज़ाइन पर अनुभवजन्य तुलना आवश्यक बनी रहती है।
प्रतिनिधि मॉडल परिवार
जनरेटिव मॉडलों में वर्ग‑शर्तीय वितरण, हिडन मार्कोव मॉडल, मिश्रित मॉडल, वैरिएशनल ऑटोएन्कोडर, ऑटोरिग्रेसिव भाषा मॉडल, डिफ्यूज़न मॉडल और GAN शामिल हैं।
डिस्क्रिमिनेटिव मॉडलों में लॉजिस्टिक रिग्रेशन, निर्णय वृक्ष, कंडीशनल रैंडम फील्ड, सपोर्ट वेक्टर मशीन और न्यूरल वर्गीकर्ता शामिल हैं। वही न्यूरल बैकबोन अपने प्रशिक्षण उद्देश्य और आउटपुट के आधार पर किसी भी श्रेणी में भाग ले सकता है।
हाइब्रिड और स्व-पर्यवेक्षित सिस्टम
एक प्री‑ट्रेंड भाषा या विज़न मॉडल अनलेबल्ड डेटा से जनरेटिव या स्व‑पर्यवेक्षित उद्देश्य के साथ सीख सकता है, फिर लक्ष्य कार्य के लिए डिस्क्रिमिनेटिव हेड प्राप्त करता है। अर्द्ध‑पर्यवेक्षित विधियाँ लेबल्ड वर्गीकरण और अनलेबल्ड डेटा उद्देश्य को साथ‑साथ अनुकूलित कर सकती हैं।
हाइब्रिडीकरण आर्किटेक्चर लेबल को पूर्ण प्रशिक्षण पाइपलाइन की तुलना में कम सूचनात्मक बनाता है। दस्तावेज़ीकरण में उद्देश्य, डेटा, आउटपुट और इच्छित निष्कर्ष को स्पष्ट करना चाहिए—केवल मॉडल को जनरेटिव कहना पर्याप्त नहीं है।
पद्धतियों के बीच चयन
निर्णय कार्य पर आधारित होना चाहिए। यदि लक्ष्य प्रचुर लेबल के साथ एक कैलिब्रेटेड सीमा बनाना है, तो डिस्क्रिमिनेटिव मॉडल एक स्वाभाविक बेसलाइन है। यदि सैंपलिंग, घनत्व अनुमान, लापता डेटा संरचना या अनलेबल्ड डेटा मुख्य हैं, तो जनरेटिव घटक मददगार हो सकता है।
उपयुक्त रूप से मजबूती, सैंपल दक्षता, गणना, संभाव्यता या कैलिब्रेशन की तुलना करें। एक अच्छा उत्पन्न सैंपल एक अच्छे वर्गीकर्ता का प्रमाण नहीं है, और उच्च‑सटीकता वाला वर्गीकर्ता इनपुट वितरण के वास्तविक मॉडल का संकेत नहीं देता।
संभाव्यता दिशाएँ और मॉडलिंग उद्देश्यों
एक डिस्क्रिमिनेटिव मॉडल एक सीमा या शर्तीय वितरण P(y|x) सीखता है: विशेषताओं x को देखते हुए लेबल y की भविष्यवाणी करता है। लॉजिस्टिक रिग्रेशन, सपोर्ट वेक्टर मशीन, कंडीशनल रैंडम फील्ड और कई वर्गीकर्ता डिस्क्रिमिनेटिव होते हैं। एक जनरेटिव मॉडल संयुक्त वितरण P(x,y), वर्ग‑शर्तीय वितरण P(x|y) या अनशर्त डेटा वितरण सीखता है, जिससे सैंपलिंग या संभाव्यता‑संबंधी कार्य संभव होते हैं। नाइव बेयेस और लीनियर डिस्क्रिमिनेंट एनालिसिस जनरेटिव वर्गीकर्ता हैं; GAN, वैरिएशनल ऑटोएन्कोडर, डिफ्यूज़न मॉडल और ऑटोरिग्रेसिव मॉडल विभिन्न उद्देश्यों के माध्यम से डेटा उत्पन्न करते हैं।
यह अंतर इस बात से संबंधित है कि कौन सा वितरण या निर्णय नियम मॉडल किया गया है, न कि न्यूरल नेटवर्क का उपयोग हुआ या नहीं। एक जनरेटिव भाषा मॉडल को वर्गीकृत करने के लिए प्रॉम्प्ट किया जा सकता है, जबकि एक डिस्क्रिमिनेटिव री‑रैंकर जनरेशन को मार्गदर्शन दे सकता है। जनरेटिव धारणाएँ डेटा दक्षता बढ़ा सकती हैं या लापता वेरिएबल्स को संभाल सकती हैं, लेकिन मॉडल की मिसस्पेसिफिकेशन जोखिम उत्पन्न करती हैं। डिस्क्रिमिनेटिव विधियाँ अक्सर प्रचुर लेबल्ड डेटा के साथ उत्कृष्ट प्रदर्शन करती हैं क्योंकि वे सीधे भविष्यवाणी सीमा पर केंद्रित होती हैं। समान विशेषताओं, डेटा, ट्यूनिंग और गणना के तहत परिवारों की तुलना करें, न कि एक श्रेणी को सार्वभौमिक रूप से श्रेष्ठ मानें।
उपयोग‑केस के अनुसार प्रशिक्षण और मूल्यांकन
वर्गीकरण मूल्यांकन में प्रिसिशन, रिकॉल, कैलिब्रेशन, मजबूती और त्रुटि लागत शामिल हैं। जनरेटिव मूल्यांकन को फिडेलिटी, विविधता, कवरेज, संभाव्यता या कार्य उपयोगिता, मेमोरीज़ेशन और सुरक्षा को संबोधित करना चाहिए। एक मॉडल आकर्षक सैंपल बना सकता है जबकि कुछ मोड छोड़ देता है, या खराब दृश्य आउटपुट के साथ अच्छी संभाव्यता प्राप्त कर सकता है। सिंथेटिक‑डेटा उपयोगिता को स्वतंत्र वास्तविक डेटा पर डाउनस्ट्रीम मॉडलों को प्रशिक्षित और मूल्यांकन करके परीक्षण किया जाना चाहिए, जिसमें दुर्लभ समूह भी शामिल हों। परीक्षण डेटा को जनरेशन प्रॉम्प्ट और चयन से बाहर रखें।
अर्द्ध‑पर्यवेक्षित सीखने में, एक जनरेटिव मॉडल अनलेबल्ड संरचना का उपयोग कर सकता है; विसंगति पहचान में, संभाव्यता तब विफल हो सकती है जब आउट‑ऑफ़‑डिस्ट्रिब्यूशन डेटा को अप्रासंगिक कारणों से उच्च घनत्व मिलता है। रिट्रिवल‑ऑगमेंटेड जनरेशन में, एक जनरेटिव उत्तर मॉडल और डिस्क्रिमिनेटिव रिट्रिवर या री‑रैंकर एक हाइब्रिड बनाते हैं। चरणों का अलग‑अलग निदान करें ताकि प्रवाहपूर्ण आउटपुट रिट्रिवल विफलता को छुपाए न। ऐसा विभाजन चुनें जो साक्ष्य और नियंत्रण को स्पष्ट रूप से दिखाए।
परिनियोजन और शासन
जनरेटिव सिस्टम कंटेंट उत्पत्ति, बौद्धिक‑संपदा, प्रतिरूपण, प्रॉम्प्ट इंजेक्शन और आउटपुट‑मॉडरेशन जोखिम जोड़ते हैं; डिस्क्रिमिनेटिव सिस्टम थ्रेशहोल्ड, अस्वीकृति और असमान‑त्रुटि जोखिम जोड़ते हैं। दोनों को डेटा अधिकार, सुरक्षित आर्टिफैक्ट, संस्करणन, प्रतिनिधिक परीक्षण, मॉनिटरिंग और परिणाम के अनुपात में मानव अधिकार की आवश्यकता होती है। दस्तावेज़ीकरण में सटीक उद्देश्य और आउटपुट सेमान्टिक्स को ट्रैक करें। जनरेटिव बनाम डिस्क्रिमिनेटिव एक उपयोगी सांख्यिकीय अंतर है, लेकिन वास्तविक सिस्टम अक्सर इन्हें मिलाते हैं, और विश्वसनीयता पूरे डेटा और निर्णय पाइपलाइन पर निर्भर करती है।
व्यावहारिक उदाहरण: समर्थन उत्तरों का वर्गीकरण और जनरेशन
एक समर्थन प्लेटफ़ॉर्म डिस्क्रिमिनेटिव वर्गीकर्ता का उपयोग करके समस्या प्रकार और तात्कालिकता पहचानता है और एक जनरेटिव मॉडल का उपयोग करके अनुमोदित नीतियों से उत्तर का मसौदा तैयार करता है। वर्गीकर्ता का मूल्यांकन वर्ग‑विशिष्ट रिकॉल और कैलिब्रेशन से किया जाता है; रिट्रिवर का मूल्यांकन साक्ष्य रिकॉल से; जनरेटर का मूल्यांकन ग्राउंडेडनेस, शुद्धता और अस्वीकार से किया जाता है। प्रत्येक चरण का परिणाम अज्ञात रहता है, और जनरेटिव मॉडल प्रेरक पाठ के माध्यम से वर्गीकरण या ग्राहक अधिकार को बदल नहीं सकता।
एजेंट भविष्यवाणी किए गए मार्ग, स्रोत और मसौदा देखते हैं और भेजने से पहले अनुमोदित या सुधारते हैं। रिट्रिवल से पहले अनुमति फ़िल्टर लागू होते हैं, और ग्राहक पाठ में प्रॉम्प्ट इंजेक्शन टूल को अधिकृत नहीं कर सकता। मॉनिटरिंग रूटिंग त्रुटियों, रिट्रिवल अंतराल, असमर्थित बयानों और एजेंट संपादनों को अलग करती है। नीति परिवर्तन स्रोतों को तुरंत अपडेट करता है और रिग्रेशन टेस्ट ट्रिगर करता है; ट्यूनिंग स्थिर व्यवहार के लिए आरक्षित है। हाइब्रिड डिज़ाइन डिस्क्रिमिनेटिव और जनरेटिव ताकतों को मिलाते हुए साक्ष्य और मानव अधिकार को संरक्षित करता है।
कार्यान्वयन प्रमाण और परिचालन तत्परता
एक प्रोडक्शन निर्णय सफल डेमो से अधिक की आवश्यकता रखता है। इरादे वाले उपयोगकर्ता, संचालन वातावरण, इनपुट, आउटपुट, निर्भरताएँ, मालिक और प्रत्येक महत्वपूर्ण विफलता के परिणाम को परिभाषित करें। ट्यूनिंग से पहले पुनरुत्पादक बेसलाइन और संस्करणित मूल्यांकन सेट स्थापित करें। सामान्य मामलों, सीमा शर्तों, विकृत या लापता इनपुट, वितरण बदलाव, निर्भरता आउटेज, दुरुपयोग, और उन समूहों या वातावरणों का परीक्षण करें जो सबसे अधिक उपेक्षित हो सकते हैं। कार्य गुणवत्ता को कैलिब्रेशन या अनिश्चितता, लेटेंसी, थ्रूपुट, संसाधन लागत, पहुँच, गोपनीयता और सुरक्षा के साथ मापें। प्रत्येक परिवर्तन और थ्रेशहोल्ड को रिकॉर्ड करें ताकि एक स्वतंत्र समीक्षक परिणाम को पुन: उत्पन्न कर सके और आकर्षक प्रोटोटाइप से प्रमाण को अलग कर सके।
लॉन्च से पहले, रिलीज़, अपवाद, परिवर्तन, रोलबैक और रिटायरमेंट के लिए अधिकार निर्धारित करें। चरणबद्ध रोलआउट उपयोग करें, एक सुरक्षित फॉलबैक संरक्षित रखें, और जानबूझकर इंजेक्टेड विफलताओं के साथ मॉनिटरिंग सत्यापित करें। ऑपरेशनल टेलीमेट्री को इनपुट गुणवत्ता, आउटपुट व्यवहार, मॉडल या नियम संस्करण, निर्भरता स्वास्थ्य, मानव ओवरराइड और पुष्टि किए गए परिणाम दिखाने चाहिए, बिना अनावश्यक संवेदनशील डेटा एकत्र किए। अलर्ट थ्रेशहोल्ड और प्रतिक्रिया मालिक को परिभाषित करें, फिर डिप्लॉयमेंट के बाद वास्तविक‑विश्व प्रमाण की समीक्षा करें, न कि ऑफ़लाइन प्रदर्शन को स्थायी मानें। जब भी डेटा स्रोत, उपयोगकर्ता, मॉडल, विक्रेता, नीतियाँ, हार्डवेयर या उद्देश्य बदलें, पुनः‑मूल्यांकन करें। एक रखरखाव किया गया सिस्टम दस्तावेज़ित रिकवरी, घटना सीखना, हटाना और रखरखाव प्रक्रियाओं, तथा एक स्पष्ट बिंदु की आवश्यकता रखता है जहाँ इसे निष्क्रिय या प्रतिस्थापित किया जाना चाहिए।
अक्सर पूछे जाने वाले प्रश्न
क्या GAN का डिस्क्रिमिनेटर एक डिस्क्रिमिनेटिव मॉडल है?
यह प्रशिक्षण के दौरान विभेदन करता है, लेकिन संपूर्ण GAN एक जनरेटिव फ्रेमवर्क है जिसका आउटपुट जेनरेटर द्वारा उत्पन्न होता है।
क्या डिस्क्रिमिनेटिव लर्निंग हमेशा सुपरवाइज़्ड होती है?
नहीं। यह शब्द मॉडल किए गए संबंध या सीमा को दर्शाता है, जबकि सुपरवाइज़न प्रशिक्षण संकेत को दर्शाता है। आधुनिक उद्देश्यों से श्रेणियों में धुंधलापन आ सकता है।
मुख्य संदर्भ












