Fundamentos de la IA
¿Qué es un Data Fabric?

 Añade Unite.AI a tus fuentes preferidas en Google
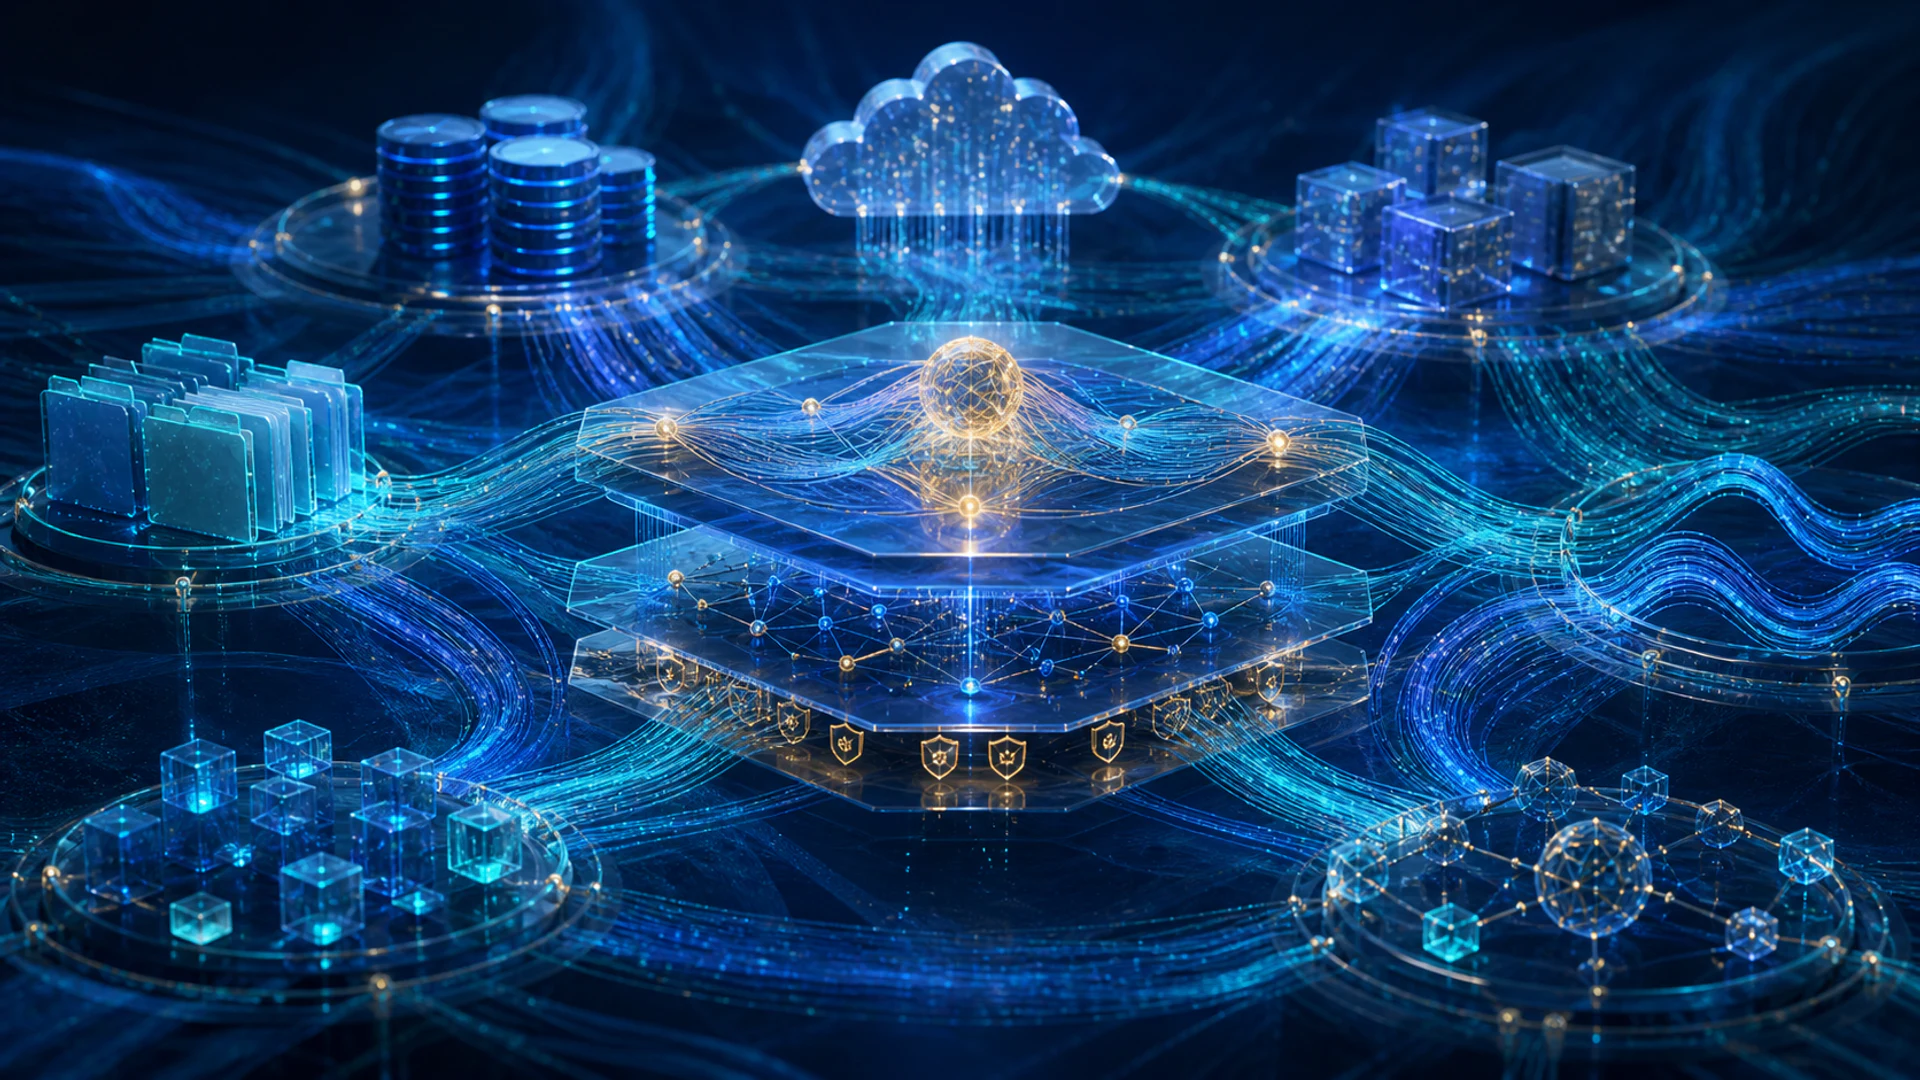
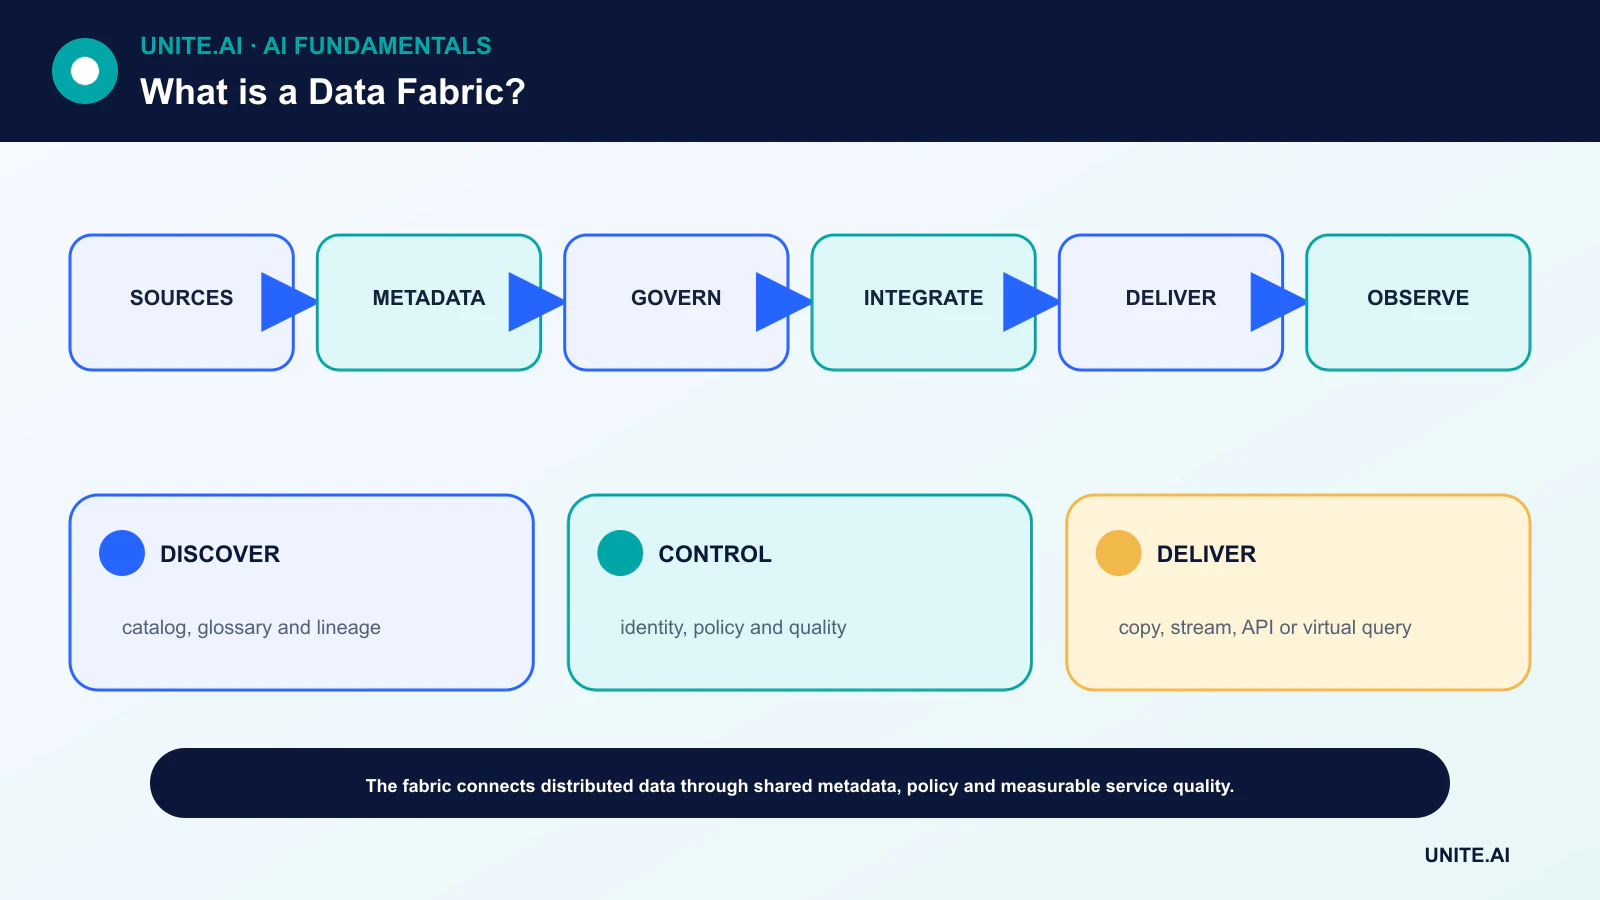
Un data fabric es un patrón arquitectónico para descubrir, conectar, gobernar y entregar datos a través de sistemas distribuidos. Proporciona una capa compartida de metadatos y control para que personas y aplicaciones puedan encontrar datos confiables sin obligar a que cada conjunto de datos se almacene en un único repositorio físico.
Un data fabric no es un producto único y no elimina las diferencias entre sistemas de origen. Su valor depende de metadatos precisos, una propiedad clara, políticas aplicables, integración fiable y evidencia de que los consumidores reciben datos adecuados a su propósito.
Conclusiones clave
- Un plano de control rico en metadatos conecta catálogos, linaje, calidad, políticas y acceso.
- Los datos pueden permanecer distribuidos y ser copiados, transmitidos, transformados o virtualizados según la carga de trabajo.
- El data fabric está orientado a la tecnología; el data mesh enfatiza la propiedad por dominio y los datos como producto.
- La automatización ayuda a escalar la gobernanza, pero los propietarios responsables siguen definiendo el significado, la calidad y el uso permitido.
El plano de control y el plano de datos
El plano de datos contiene bases de datos, archivos, flujos, API y los pipelines que los mueven o consultan. El plano de control registra metadatos técnicos y de negocio: esquemas, propietarios, clasificaciones, medidas de calidad, linaje, políticas y uso.
Un catálogo o grafo de conocimiento puede conectar estos hechos para que un consumidor descubra un conjunto de datos y comprenda su contexto. El tejido entonces utiliza los metadatos para guiar el acceso, la transformación, la observabilidad y la aplicación de políticas en plataformas heterogéneas.
Integración sin un almacén obligatorio
Algunas cargas de trabajo copian datos mediante ETL; otras utilizan captura de cambios, flujos de eventos, API o virtualización de consultas. El patrón correcto depende de la frescura, el rendimiento, la consistencia, la soberanía, el costo y las limitaciones del sistema de origen.
El acceso virtual puede reducir la duplicación, pero puede exponer a los consumidores a latencia y disponibilidad del origen. La materialización física mejora el rendimiento y la reproducibilidad, pero genera responsabilidades de sincronización y ciclo de vida.
Gobernanza, semántica y calidad
Un glosario empresarial brinda un significado compartido a términos como cliente, pedido o cuenta activa. El linaje muestra dónde se originó un campo y cómo cambió. La clasificación y la política determinan quién puede acceder a registros sensibles y con qué propósito.
Las reglas de calidad deben asociarse a casos de uso específicos. La completitud suficiente para un tablero puede ser insegura para decisiones automatizadas. Un tejido debe exponer la frescura, el historial de validación y las limitaciones conocidas, en lugar de simplemente etiquetar un activo como certificado.
Data fabric, mesh y lakehouse
El data mesh es un enfoque sociotécnico que asigna a los equipos de dominio la responsabilidad de productos de datos interoperables. Un data fabric enfatiza los servicios técnicos compartidos y la automatización de metadatos. Las organizaciones pueden combinarlos: la propiedad por dominio puede operar a través de un tejido común.
Un lakehouse combina la flexibilidad del lago de datos con la gestión y características de consulta al estilo de un almacén. Puede ser una plataforma participante, pero no constituye todo el tejido transversal del sistema. De manera similar, un almacén o catálogo por sí solo no brinda todas las funciones de integración y política.
Implementación y evaluación
Comience con un caso de uso transversal valioso e inventarice las fuentes mínimas, propietarios, políticas y expectativas de nivel de servicio. Establezca identidad, estándares de metadatos, contratos, pruebas y observabilidad antes de añadir recomendaciones automatizadas.
Mida el tiempo de descubrimiento, el tiempo de aprobación de acceso, las tasas de incidentes, la frescura de los datos, la reutilización y la confianza del consumidor. Vincule el tejido a la gobernanza de datos estructurados y no estructurados y a la ciberseguridad; la conectividad sin control puede aumentar la exposición.
Arquitectura de data-fabric y plano de metadatos
Un data fabric es un enfoque arquitectónico para conectar datos distribuidos mediante metadatos compartidos, gobernanza, integración y servicios de acceso. No es una única base de datos o producto. Las fuentes pueden permanecer en almacenes, lagos, sistemas operacionales, flujos y plataformas SaaS, mientras los catálogos describen conjuntos de datos, el linaje rastrea transformaciones, las políticas controlan el acceso y las definiciones semánticas hacen que los conceptos sean reutilizables. La virtualización, replicación, API y pipelines son métodos de entrega complementarios elegidos según la latencia, escala, capacidad de origen y necesidades de consistencia.
Los metadatos activos capturan esquemas, propiedad, uso, calidad, clasificaciones, linaje, patrones de consultas y eventos operacionales y pueden impulsar la automatización. Un grafo de conocimiento puede conectar conceptos de negocio con campos físicos y políticas. La automatización puede recomendar uniones, detectar desviaciones, propagar clasificaciones o dirigir incidentes, pero los metadatos inferidos requieren confianza y gestión. Un catálogo que no está conectado a la entrega y a los controles se convierte en deuda documental; la integración automatizada sin propiedad semántica genera inconsistencias más rápidamente.
Integración, gobernanza y productos de datos
El ETL por lotes, la captura de cambios, los flujos, la federación y el ETL inverso tienen diferentes semánticas de frescura y fallos. Defina fuentes autoritativas, identificadores, contratos, tiempo de eventos, datos tardíos, eliminación y reconciliación. Las consultas virtuales evitan copias pero dependen del rendimiento y disponibilidad del origen; la materialización mejora la velocidad pero crea obligaciones de frescura y retención. Las políticas sensibles deben aplicarse o reevaluarse para datos derivados, cachés, incrustaciones y exportaciones.
Trate los conjuntos de datos de alto valor como productos con propietarios, usuarios, documentación, expectativas de servicio, pruebas y soporte. La propiedad federada permite a los dominios gestionar el significado mientras los estándares compartidos preservan la interoperabilidad. Los equipos centrales proporcionan capacidades de plataforma y gobernanza, no la propiedad de cada campo. Mida el tiempo de descubrimiento, la reutilización, la calidad de los datos, el tiempo de respuesta de acceso, la resolución de incidentes, la adopción de métricas confiables y el costo. El número de entradas de catálogo o conectores no es evidencia de que las personas puedan encontrar y usar datos fiables.
Estrategia de implementación
Comience con un recorrido interdominio cuyas demoras y riesgos sean conocidos. Inventarice fuentes y contratos, establezca identidad y clasificación, conecte linaje y calidad, y luego automatice los controles repetidos. Evite un intento de varios años de modelar toda la empresa antes de entregar valor. Pruebe interrupciones de origen, cambios de esquema, acceso revocado, eventos tardíos y recuperación ante desastres. Un data fabric tiene éxito cuando los datos distribuidos se vuelven más fáciles de gobernar y usar sin eliminar las realidades operativas y la responsabilidad de los sistemas donde se originan.
Ejemplo práctico: un data fabric de cliente
Una empresa conecta datos de comercio, soporte, marketing y producto, manteniendo los sistemas operacionales como autoritativos. Un catálogo compartido vincula definiciones de cliente, cuenta, pedido, consentimiento e interacción a campos físicos. La captura de cambios alimenta productos gobernados, mientras la virtualización sirve consultas actuales de bajo volumen y las tablas materializadas respaldan análisis. Identidad, linaje, calidad y política se implementan antes de que una capa de personalización IA pueda usar los datos.
Una revocación de consentimiento se propaga a través de tablas de almacén, índices de búsqueda, incrustaciones y sistemas de activación, con evidencia de finalización. Los contratos de esquema y pruebas de reconciliación detectan cambios en el origen. Los propietarios publican expectativas de frescura y calidad, y los metadatos de uso ayudan a retirar copias no utilizadas. El piloto mide el tiempo de respuesta de acceso, la reutilización de métricas confiables, la resolución de incidentes y el cumplimiento de privacidad. El tejido se considera exitoso porque un recorrido interdominio se vuelve fiable y gobernable, no porque un proveedor haya conectado el mayor número de fuentes.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, interrupciones de dependencias, usos indebidos y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retroceso y retiro. Utilice un despliegue por etapas, conserve una alternativa segura y verifique la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Un data fabric traslada todos los datos a un solo lugar?
No. Puede coordinar datos que permanecen distribuidos y elegir movimiento físico o virtualización según la carga de trabajo.
¿Un data fabric es lo mismo que un data mesh?
No. El tejido describe principalmente una arquitectura habilitadora y automatización; el mesh describe principalmente la propiedad descentralizada por dominio y las responsabilidades de los datos como producto. Pueden coexistir.
Referencias principales