Fundamentos de la IA
¿Qué es el análisis de sentimiento? Métodos, usos y limitaciones

 Añade Unite.AI a tus fuentes preferidas en Google
El análisis de sentimiento estima el lenguaje evaluativo en texto, transcripciones de voz u otro contenido. Un sistema puede clasificar la polaridad como positiva, negativa o neutral; detectar opiniones a nivel de aspecto; estimar la intensidad; o identificar la postura respecto a una afirmación concreta.
El objetivo debe definirse cuidadosamente. El sentimiento no es lo mismo que emoción, intención, toxicidad, satisfacción o verdad. Una frase positiva puede describir sarcásticamente un evento dañino, mientras que una reseña de producto negativa aún puede recomendar el producto en general.
Conclusiones clave
- Definir unidad, objetivo, etiquetas y contexto antes de recopilar ejemplos.
- Los léxicos son líneas base transparentes; los modelos supervisados y de transformadores pueden capturar más contexto pero requieren datos representativos.
- La negación, el sarcasmo, el vocabulario del dominio, el texto multilingüe y los límites de los aspectos siguen siendo difíciles.
- Evaluar por clase, subgrupo, dominio y período de tiempo; incluir revisión humana para usos con consecuencias.
Niveles y objetivos
El análisis a nivel de documento produce una etiqueta para todo el elemento. El análisis a nivel de oración separa las declaraciones, mientras que el análisis basado en aspectos vincula el sentimiento a una entidad o atributo —por ejemplo, positivo respecto a la calidad de la imagen pero negativo respecto a la duración de la batería.
La postura pregunta si un hablante apoya una proposición específica, lo que puede diferir del tono emocional. Estas distinciones deben quedar fijadas en la guía de anotación antes de aplicar los métodos de clasificación de texto.
Léxicos, modelos clásicos y transformadores
Un léxico asigna puntuaciones a palabras y las combina con reglas para la negación o la intensidad. Es interpretable y barato, pero tiene dificultades con el contexto. Los modelos supervisados clásicos usan características de palabras o n‑gramas, mientras que los transformadores aprenden representaciones contextuales y pueden ajustarse finamente.
El prompting de pocos ejemplos puede ser conveniente, pero las salidas dependen de los ejemplos y la redacción. Compare cada enfoque complejo con una línea base y utilice aprendizaje de pocos ejemplos solo con un conjunto de evaluación reservado y versionado.
Desafíos de datos y lenguaje
Las etiquetas pueden reflejar la perspectiva del anotador más que un hecho objetivo. El cambio de dominio es severo: ‘impredecible’ puede ser elogio para una película y crítica para un vehículo. El cambio de código, dialecto, emojis, discurso citado e ironía complican las señales a nivel de token.
Equilibre las clases intencionalmente y evite que autores, productos o conversaciones relacionados se filtren entre entrenamiento y prueba. Un modelo que memoriza una marca o un hablante puede parecer preciso sin aprender el sentimiento.
Evaluación y uso responsable
Informe precisión, recall, F1 y una matriz de confusión en lugar de solo la exactitud. Revise los errores por aspecto, longitud, dialecto y tiempo, y calibre los umbrales según el costo operativo de cada error.
Las tendencias agregadas pueden apoyar la investigación o la triaje, pero inferir el estado de una persona o tomar decisiones de empleo, crédito, salud o vigilancia genera mayor riesgo. Proporcione incertidumbre, contexto de la fuente, controles de privacidad y revisión humana.
Anotación y construcción de conjuntos de datos
Redacte una guía de anotación con entidad objetivo, unidad de análisis, definiciones de etiquetas, manejo de mixtas y neutrales, reglas de citación, política de sarcasmo y ejemplos del dominio. Pilotee con varios anotadores, calcule el acuerdo, discuta discrepancias y revise la tarea antes de escalar las etiquetas.
El muestreo determina lo que el modelo aprende. Un flujo de redes sociales puede sobre‑representar cuentas muy activas; los tickets de soporte pueden omitir a clientes satisfechos; las calificaciones por estrellas pueden no coincidir con el texto de la reseña. Preserve los metadatos de origen y tiempo, respete los términos de la plataforma y la privacidad, y cree un conjunto de prueba a partir de la población donde se tomarán decisiones.
La filtración de etiquetas puede ocurrir a través de calificaciones, emojis insertados por el sistema de recolección, firmas plantillas o nombres de productos correlacionados con el sentimiento. Desduplicar publicaciones casi idénticas y agrupar conversaciones o autores para que su lenguaje no aparezca en ambos lados de una división.
Opciones de modelado y calibración
Los sistemas de léxico suman puntuaciones de palabras y ajustan por negación, intensificadores, puntuación o emojis. Proporcionan una verificación de sentido útil y pueden adaptarse con términos del dominio. Los modelos lineales con características TF–IDF siguen siendo competitivos en algunos conjuntos de datos y revelan n‑grams influyentes.
Los codificadores contextuales representan palabras según el texto circundante y pueden ajustarse finamente para polaridad o aspectos. Los documentos largos pueden necesitar modelos jerárquicos, agregación de oraciones o recuperación de fragmentos relevantes. Los enfoques multilingües pueden entrenar un modelo compartido, traducir a un idioma pivote o mantener modelos locales; cada uno tiene coberturas y compensaciones culturales.
La calibración de probabilidad es importante cuando las puntuaciones desencadenan acciones. Los gráficos de fiabilidad y el error de calibración esperado revelan si una confianza reportada de 0,8 corresponde a aproximadamente un 80 % de acierto. Los umbrales pueden crear una banda de abstención para revisión humana, y umbrales separados pueden justificarse cuando los costos de error difieren —no para ocultar una calidad desigual.
Aplicaciones e interpretaciones erróneas comunes
El sentimiento agregado puede ayudar a priorizar temas, comparar reacciones de campañas o dirigir mensajes de servicio urgentes. El análisis de aspectos suele ser más accionable que la polaridad general porque identifica de qué hablan las personas. El análisis de tendencias necesita muestreo estable y definiciones de etiquetas a lo largo del tiempo.
No equipare la prevalencia de publicaciones negativas con la opinión de la población. El comportamiento de publicación, bots, moderación, demografía de la plataforma, campañas y consultas de recolección moldean la muestra. Un modelo de sentimiento no mide a la población silenciosa, y un cambio en la redacción puede parecer un cambio de actitud.
Para decisiones individuales, las etiquetas falsas pueden estigmatizar y ser difíciles de impugnar. Evite usar el sentimiento como proxy de compromiso de empleados, salud mental, solvencia crediticia, intención o engaño. Cuando las personas se ven afectadas, muestre el contexto de la fuente, permita correcciones y exija un tomador de decisiones humano con verdadera discreción.
Ejemplo práctico: análisis de sentimiento para retroalimentación de clientes
Una empresa que analice comentarios de soporte debe definir si necesita sentimiento a nivel de documento, sentimiento de aspecto, emoción, urgencia o clasificación de problemas. «La entrega fue rápida pero el producto se rompió» no puede representarse fielmente con una sola etiqueta positiva o negativa. Cree una guía de anotación para objetivos, negación, sarcasmo, declaraciones mixtas, discurso citado y casos desconocidos, luego mida el acuerdo antes de tratar las etiquetas como verdad de referencia.
Compare un léxico o línea base lineal con un codificador afinado o un modelo de lenguaje con prompting. Divida los datos por tiempo o cliente para evitar filtración de duplicados cercanos, y preserve la prevalencia de clases. Informe precisión, recall, F1, calibración y confusión por idioma, canal, producto y proxies demográficos solo donde sea legal y justificado. Revise errores de alta confianza porque son más peligrosos en el enrutamiento automatizado que las salidas inciertas que se escalan.
Use el sentimiento como una señal para agregación o priorización, no como una medida incuestionable del estado de una persona. Supervise el vocabulario y la deriva de productos, reentrene con ejemplos revisados y permita a los agentes corregir etiquetas. Nunca infiera rasgos protegidos ni discipline a trabajadores a partir de puntuaciones de sentimiento no validadas. Para informes ejecutivos, muestre el tamaño de la muestra, la incertidumbre, los datos faltantes y los temas que impulsan el cambio, de modo que una puntuación fluctuante conduzca a investigación y no a una conclusión simplista.
El despliegue multilingüe no debe asumir que traducir las entradas preserva el tono, la negación, la expresión idiomática o la convención cultural. Valide cada idioma admitido y los patrones multilingües con revisores nativos, y proporcione un resultado desconocido cuando la evidencia sea débil. La adaptación al dominio también importa: palabras que suenan negativas en la conversación ordinaria pueden ser descripciones técnicas neutrales. Mantenga umbrales o modelos separados solo cuando la evidencia operativa justifique la complejidad adicional y la carga de gobernanza.
Lista de verificación para la implementación práctica
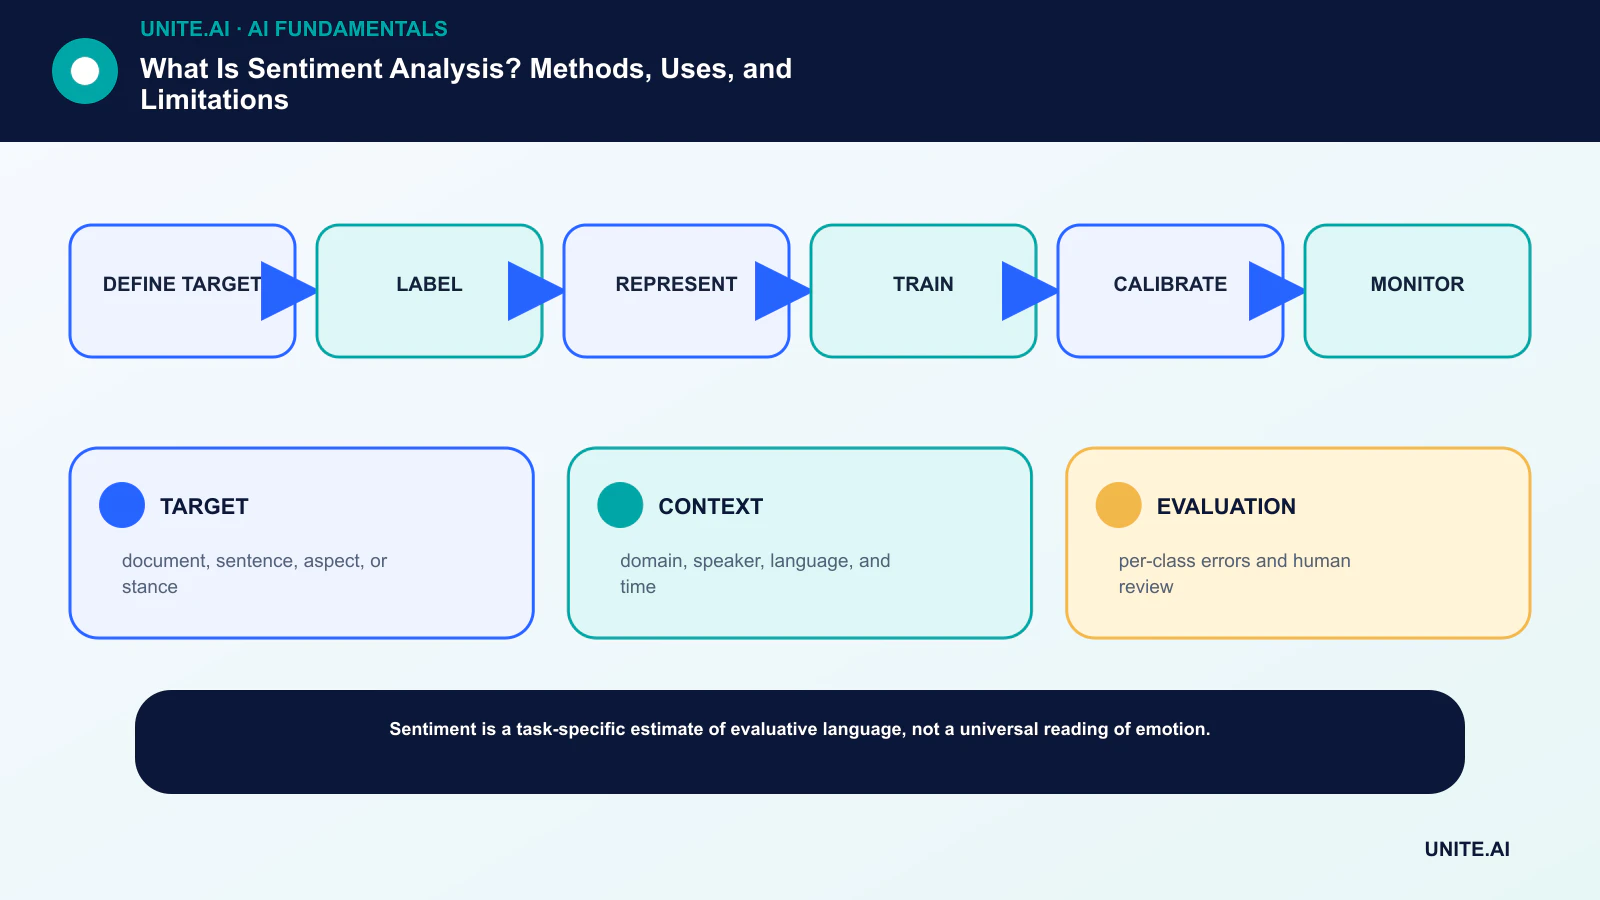
Transforme el concepto en un flujo de trabajo delimitado y verificable: defina objetivo → etiqueta → representación → entrenamiento → calibración → monitorización. Asigne un responsable, documente los datos y dependencias, establezca una línea base sencilla, fije criterios de aceptación y de parada, pruebe fallos representativos y defina monitorización, reversión y revisión antes de ampliar el alcance. Registre versiones y supuestos para que otro equipo pueda reproducir el resultado y entender qué cambió.
Antes del lanzamiento, realice una revisión de preparación documentada con las personas que construyen, operan, aseguran y se ven afectadas por el sistema. Pruebe casos normales, condiciones límite, fallos de dependencias y usos indebidos; preserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar el lanzamiento, cambiar un umbral, anular una salida o detener la operación. Revise la decisión después de que lleguen datos del mundo real, porque un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- OBJETIVO: documento, oración, aspecto o postura.
- CONTEXTO: dominio, hablante, idioma y tiempo.
- EVALUACIÓN: errores por clase y revisión humana.
Preguntas frecuentes
¿Es objetivo el análisis de sentimiento?
No. Estima etiquetas definidas por una tarea y proceso de anotación. Algunos textos son genuinamente ambiguos, mixtos, dependientes del contexto o interpretados de manera diferente por los lectores.
¿Puede el análisis de sentimiento detectar sarcasmo?
Los modelos pueden aprender algunos patrones, pero el sarcasmo a menudo depende del historial del hablante, conocimientos compartidos y contexto fuera del texto. Sigue siendo un modo de falla común.
Referencias principales