
Det bedste
10 Bedste Maskinlæringsalgoritmer

 Føj Unite.AI til dine foretrukne kilder på Google
NøglepunkterTransformatorer revolutionerede NLP ved at muliggøre parallel behandling og vedvarende…
Vis mere
- Transformatorer revolutionerede NLP ved at muliggøre parallel behandling og vedvarende hukommelse i modsætning til RNN'er.
- GAN'er tvinger generatorer til at udforske forskellige løsninger ved at tilbageholde diskriminatorens fejlfeedback.
- K-Nærmeste Naboer fra 1951 overgår stadig moderne algoritmer i forudsigelse af medarbejderomsætning.
Selv om vi er midt i en periode med ekstraordinær innovation inden for GPU-accelereret maskinlærning, indeholder de nyeste forskningsartikler ofte (og prominent) algoritmer, der er årtier, i visse tilfælde 70 år gamle.
Nogle kunne mene, at mange af disse ældre metoder hører under kategorien ‘statistisk analyse’ snarere end maskinlærning, og foretrækker at datere begyndelsen af sektoren tilbage til 1957, med opfindelsen af Perceptron.
Da disse ældre algoritmer støtter og er indviklet i de nyeste trends og overskrifter inden for maskinlærning, kan det betragtes som en tvivlsom holdning. Så lad os kaste et blik på nogle af de ‘klassiske’ byggesten, der ligger til grund for de nyeste innovationer, samt nogle nyere indgange, der søger at komme ind i AI-hallen.
1: Transformatorer
I 2017 ledte Google Research et forskningssamarbejde, der resulterede i artiklen Attention Is All You Need. Arbejdet omfattede en ny arkitektur, der fremhævede opmærksomhedsmekanismer fra hjælpekomponenter i encoder/decoder-modeller og rekurrente netværksmodeller til en central transformativ teknologi i sig selv.
Tilgangen blev kaldt Transformator, og er siden blevet en revolutionerende metode inden for Natural Language Processing (NLP), der driver, blandt andet, den autoregressive sprogmodel og AI-ikonet GPT-3.

Transformatorer løste elegant problemet med sekvenstransduktion, også kaldet ‘transformation’, der beskæftiger sig med behandlingen af indgangssekvenser til udgangssekvenser. En transformator modtager og behandler også data på en kontinuert måde, snarere end i sekventielle batch, hvilket giver en ‘varig hukommelse’, som RNN-arkitekturer ikke er designet til at opnå. En mere detaljeret gennemgang af transformatorer findes i vores referenceartikel.
I modsætning til de Rekurrente Neurale Netværk (RNN), der var begyndt at dominere ML-forskning i CUDA-æraen, kunne Transformator-arkitekturen også let paralleliseres, hvilket åbnede vejen for at produktivt tackle en langt større mængde data end RNN.
Populær brug
Transformatorer fik fat i offentlighedens forestilling i 2020 med udgivelsen af OpenAIs GPT-3, der havde en daværende rekord på 175 milliarder parametre. Denne tilsyneladende imponerende præstation blev senere overgået af senere projekter, såsom udgivelsen af Microsofts Megatron-Turing NLG 530B i 2021, der (som navnet antyder) har over 530 milliarder parametre.

En tidslinje over hyperskala Transformer NLP-projekter. Kilde: Microsoft
Transformator-arkitekturen er også gået over fra NLP til computer vision, og driver en ny generation af billedsyntheseframeworks som OpenAIs CLIP og DALL-E, der bruger tekst>billed-domæne-kortlægning til at fuldende ufuldendte billeder og syntetisere nye billeder fra trænede domæner, blandt en voksende mængde relaterede anvendelser.
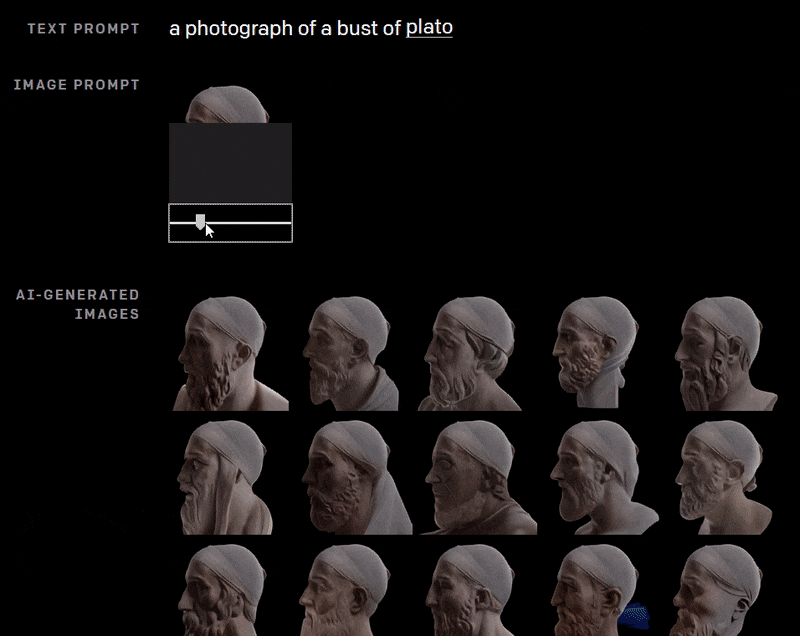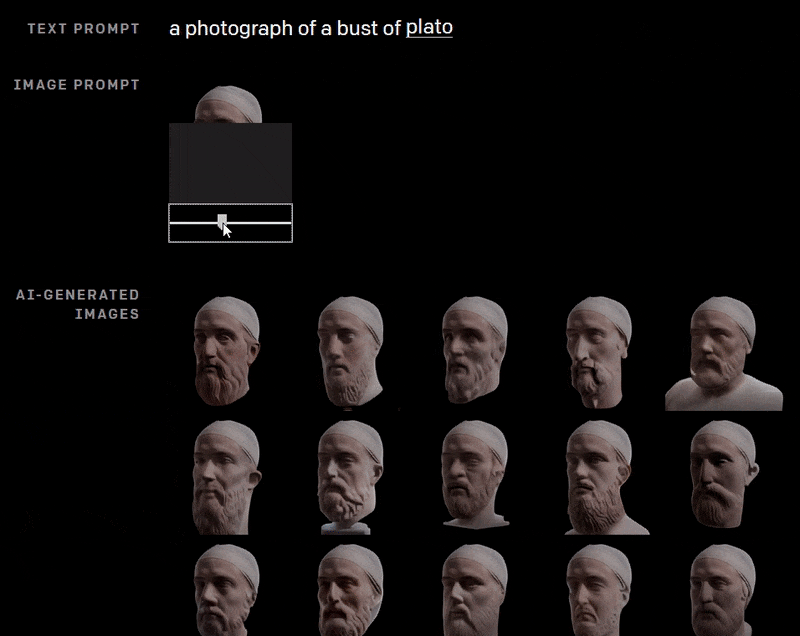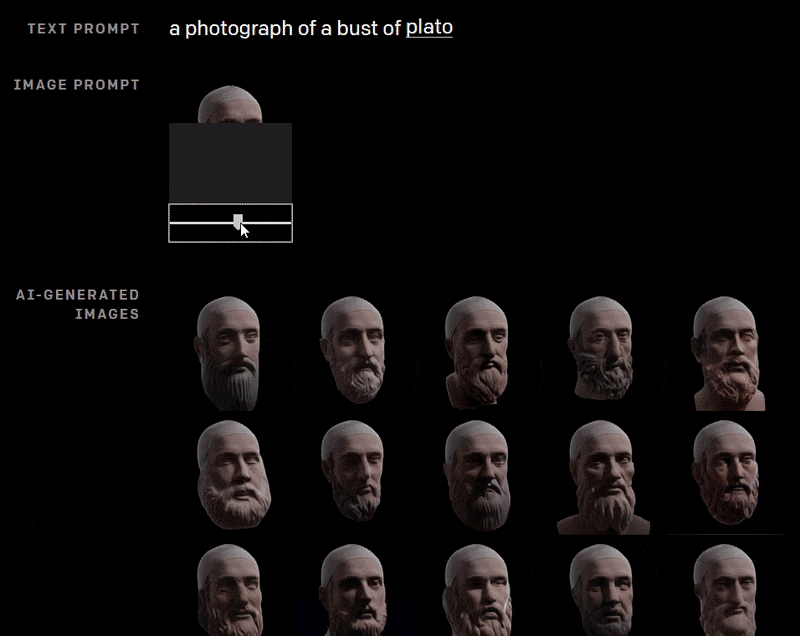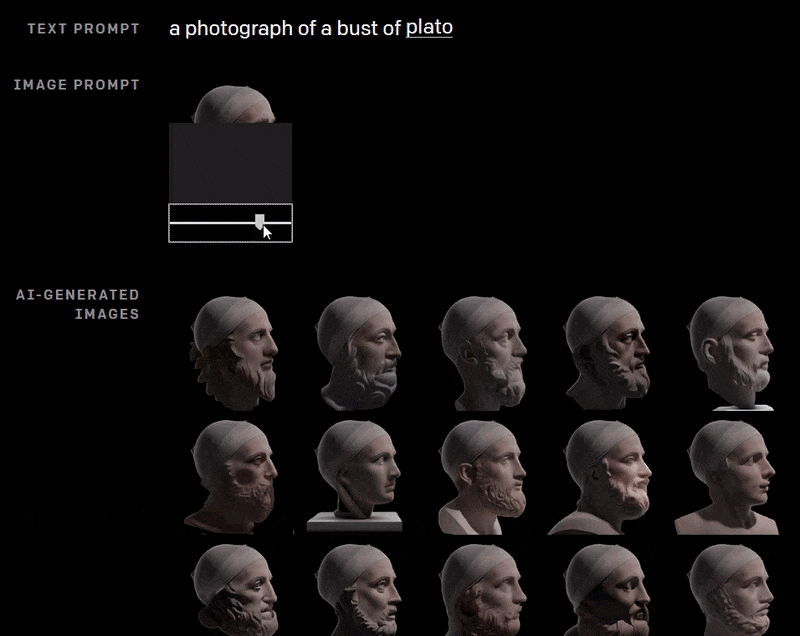
DALL-E forsøger at fuldende et delvist billede af en buste af Platon. Kilde: https://openai.com/blog/dall-e/
2: Generative Adversarial Networks (GANs)
Selv om transformatorer har fået ekstraordinær mediedækning gennem udgivelsen og antagelsen af GPT-3, er Generative Adversarial Network (GAN) blevet en genkendelig mærkevare i sin egen ret, og kan muligvis slutte sig til deepfake som et verbum.
Først foreslået i 2014 og primært brugt til billedsynthese, består en Generative Adversarial Network arkitektur af en Generator og en Discriminator. Generatoren gennemløber tusinder af billeder i en dataset, og forsøger iterativt at genskabe dem. For hvert forsøg vurderer diskriminatoren generatorens arbejde og sender generatoren tilbage for at forbedre resultatet, uden at fortælle, hvordan den tidligere rekonstruktion var forkert.

Kilde: https://developers.google.com/machine-learning/gan/gan_structure
Dette tvinger Generatoren til at udforske en mangfoldighed af veje, snarere end at følge de potentielle blindgyder, der ville være opstået, hvis Discriminatoren havde fortalt det, hvor det gik galt (se #8 nedenfor). Når træningen er færdig, har Generatoren en detaljeret og omfattende kortlægning af relationer mellem punkter i datasettet.
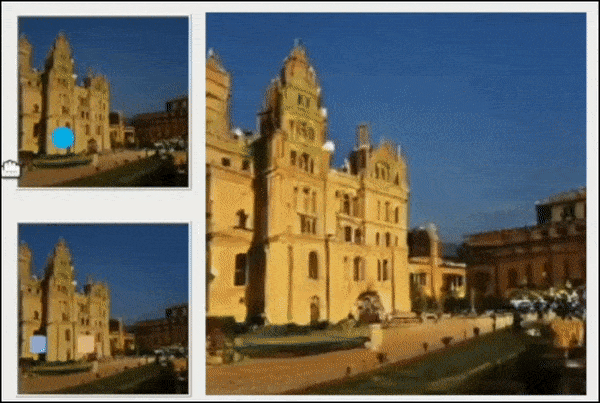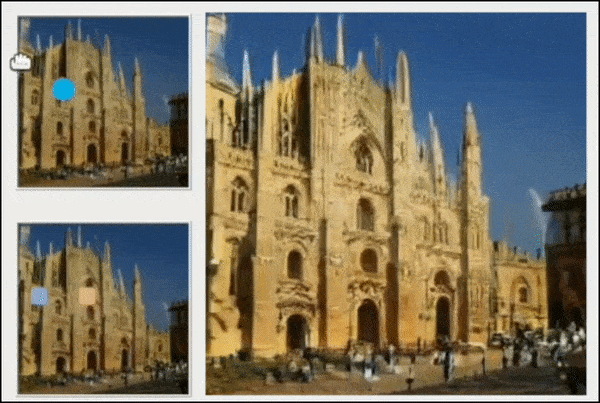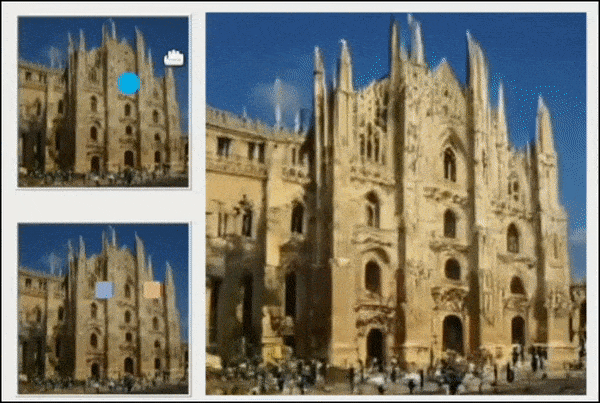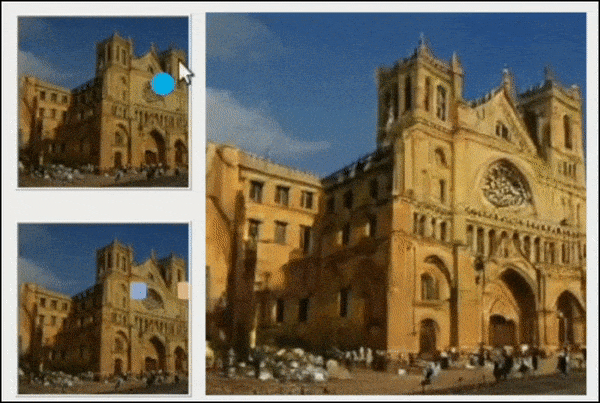
Fra artiklen Improving GAN Equilibrium by Raising Spatial Awareness: en ny ramme cykler gennem den undertiden mystiske latente rum af en GAN, og giver responsiv instrumentering til en billedsynthesearkitektur. Kilde: https://genforce.github.io/eqgan/
Ved analogi er dette forskellen på at lære en enkelt kedelig pendlerrute til det centrale London, eller møjsommeligt at tilegne sig The Knowledge.
Resultatet er en samling af egenskaber på højt niveau i det latente rum af den trænede model. Den semantiske indikator for en egenskab på højt niveau kunne være ‘person’, mens en nedgang gennem specifikation i forhold til egenskaben kan afsløre andre lærende karakteristika, såsom ‘mand’ og ‘kvinde’. På lavere niveauer kan underegenskaberne bryde ned til, ‘blond’, ‘kaukasisk’, osv.
Entanglement er et bemærkelsesværdigt problem i det latente rum af GAN’er og encoder/decoder-rammer: er smilen på en GAN-genereret kvindes ansigt en sammenfiltret egenskab af hendes ‘identitet’ i det latente rum, eller er det en parallel gren?

GAN-genererede ansigter fra thispersondoesnotexist. Kilde: https://this-person-does-not-exist.com/en
De sidste par år har ført til en voksende mængde nye forskningsinitiativer i denne henseende, måske baner vejen for egenskabsniveau, Photoshop-stil-redigering af det latente rum af en GAN, men for øjeblikket er mange transformationer effektivt ‘alt eller intet’-pakker. Bemærkelsesværdigt er NVIDIAs EditGAN-udgivelse i slutningen af 2021 opnår en høj niveau af fortolkning i det latente rum ved at bruge semantiske segmenteringsmasker.
Populær brug
Ud over deres (i virkeligheden ret begrænsede) involvering i populære deepfake-videoer, har billed-/video-centreret GAN’er bredt sig over de sidste fire år, og har betaget forskere og offentligheden. At holde trit med den svimlende hastighed og hyppighed af nye udgivelser er en udfordring, selv om GitHub-repositoriet Awesome GAN Applications søger at give en omfattende liste.
Generative Adversarial Networks kan i teorien udlede funktioner fra enhver veldefineret domæne, herunder tekst.
3: SVM
Oprindeligt i 1963, er Support Vector Machine (SVM) en kernealgoritme, der ofte dukker op i ny forskning. Under SVM kortlægger vektorer den relative disposition af datapunkter i en dataset, mens support-vektorer afgrænser grænserne mellem forskellige grupper, egenskaber eller træk.

Support-vektorer definerer grænserne mellem grupper. Kilde: https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
Den afledte grænse kaldes et hyperplan.
Ved lav egenskabsniveau er SVM to-dimensionel (billede ovenfor), men hvor der er en højere antal genkendte grupper eller typer, bliver det tre-dimensionel.

En dybere række af punkter og grupper kræver en tre-dimensionel SVM. Kilde: https://cml.rhul.ac.uk/svm.html
Populær brug
Siden Support Vector Machines kan effektivt og agnostisk tackle høj-dimensionel data af mange slags, dukker de op bredt over en række maskinlæringssektorer, herunder deepfake-detektion, billedklassifikation, hadefuld tale-klassifikation, DNA-analyse og populationsstruktur-forudsigelse, blandt mange andre.
4: K-Means Clustering
Clustering i almindelighed er en uovervåget læring-tilgang, der søger at kategorisere datapunkter gennem tæthedsestimation, og skaber en kortlægning af fordelingen af de data, der undersøges.

K-Means-clustering afslører segmenter, grupper og fællesskaber i data. Kilde: https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
K-Means Clustering er blevet den mest populære implementering af denne tilgang, og fører datapunkter ind i karakteristiske ‘K-Grupper’, der kan indikere demografiske sektorer, online-fællesskaber eller enhver anden mulig hemmelig aggregation, der venter på at blive opdaget i rå statistisk data.

Cluster danner sig i K-Means-analyse. Kilde: https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
K-værdien selv er den bestemmende faktor i nyttigheden af processen, og i at etablere en optimal værdi for en cluster. Initialt tildeles K-værdien tilfældigt, og dens egenskaber og vektorkarakteristika sammenlignes med dens naboer. De naboer, der mest ligner datapunktet med den tilfældigt tildelte værdi, bliver tildelt dens cluster iterativt, indtil data har afgivet alle de grupperinger, processen tillader.
Grafen for den kvadrerede fejl, eller ‘omkostning’ af forskellige værdier mellem cluster, afslører en albue-punkt for data:

Albue-punktet i en cluster-graf. Kilde: https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
Albue-punktet er lignende i koncept til, at tab falder ud til svindende retur ved slutningen af en træningssession for en dataset. Det repræsenterer punktet, hvor ingen yderligere forskelle mellem grupper vil blive tydelige, og indikerer øjeblikket at gå videre til efterfølgende faser i datapipelinen, eller også at rapportere resultater.
Populær brug
K-Means Clustering, af åbenlyse årsager, er en primær teknologi i kundeanalyse, da den tilbyder en klar og forklarlig metode til at oversætte store mængder af kommercielle optegnelser til demografiske indsigt og ‘leads’.
Uden for denne anvendelse bruges K-Means Clustering også til jordrutsning-forudsigelse, medicinsk billedsegmentering, billedsynthese med GAN’er, dokumentklassifikation, og byplanlægning, blandt mange andre potentielle og faktiske anvendelser.
5: Random Forest
Random Forest er en ensemble-læring-metode, der gennemsnitter resultatet fra en række beslutningstræer for at etablere en samlet forudsigelse for udfaldet.

Kilde: https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
Hvis du har forsket det, selv blot ved at se Tilbage til fremtiden-trilogien, er en beslutningstræ selv ret let at forestille sig: en række veje ligger foran dig, og hver vej forgrener sig til en ny udfald, der igen indeholder yderligere mulige veje.
I forstærkningslæring kan du måske trække dig tilbage fra en vej og starte igen fra en tidligere position, mens beslutningstræer er forpligtet til deres rejser.
Således er Random Forest-algoritmen grundlæggende en spredningsvæddemål for beslutninger. Algoritmen kaldes ’tilfældig’, fordi den foretager ad hoc-valg og observationer for at forstå den median-sum af resultaterne fra beslutningstræ-arrayet.
Da den tager hensyn til en mangfoldighed af faktorer, kan en Random Forest-tilgang være sværere at konvertere til meningsfulde grafer end en beslutningstræ, men er sandsynligvis mere produktiv.
Beslutningstræer er underlagt overfitting, hvor resultaterne opnås er dataspecifikke og ikke sandsynligvis generaliserer. Random Forests tilfældige udvælgelse af datapunkter bekæmper denne tendens, og borer sig igennem til meningsfulde og nyttige repræsentative tendenser i data.

Beslutningstræ-regression. Kilde: https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
Populær brug
Som med mange af algoritmerne på denne liste, fungerer Random Forest typisk som en ‘tidlig’ sorter og filter af data, og dukker derfor konsekvent op i nye forskningsartikler. Nogle eksempler på Random Forest-brug inkluderer Magnetisk Resonans-billedsynthese, Bitcoin-prisforudsigelse, census-segmentering, tekstklassifikation og kreditkort-svindel-detektion.
Da Random Forest er en lav-niveau-algoritme i maskinlæringsarkitekturer, kan den også bidrage til ydelsen af andre lav-niveau-metoder, samt visualiseringsalgoritmer, herunder induktiv clustering, egenskabstransformationer, klassifikation af tekstdokumenter ved hjælp af sparsomme egenskaber, og visning af rørledninger.
6: Naive Bayes
Koblet med tæthedsestimation (se 4 ovenfor), er en naive Bayes-klassifikator en kraftfuld, men relativt letvægts-algoritme, der kan estimere sandsynligheder baseret på de beregnede egenskaber ved data.

Egenskabsrelationer i en naive Bayes-klassifikator. Kilde: https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
Begrebet ‘naiv’ refererer til antagelsen i Bayes’ teorem, at egenskaber er uafhængige, kendt som betinget uafhængighed. Hvis du antager denne holdning, er gående og tale som en and ikke nok til at fastslå, at vi har med en and at gøre, og ingen ‘åbenlyse’ antagelser adopteres forhastet.
Dette niveau af akademisk og undersøgende rigor er overkill, hvor ‘sund fornuft’ er tilgængelig, men er en værdifuld standard, når man navigerer i de mange tvetydigheder og potentielt uafhængige korrelationer, der kan eksistere i en maskinlæringsdataset.
I et oprindeligt bayesiansk netværk er egenskaber underlagt scoringsfunktioner, herunder minimal beskrivelseslængde og Bayesian scoringsfunktion, der kan påføre begrænsninger på data i form af de estimerede forbindelser fundet mellem datapunkterne og retningen, disse forbindelser flyder i.
En naive Bayes-klassifikator opererer anderledes ved at antage, at egenskaberne ved et givet objekt er uafhængige, og bruger derefter Bayes’ teorem til at beregne sandsynligheden for et givet objekt baseret på dets egenskaber.
Populær brug
Naive Bayes-filtre er godt repræsenteret i sygdomsforudsigelse og dokumentkategorisering, spam-filtrering, sentiment-klassifikation, anbefalingsystemer, og svindel-detektion, blandt andre anvendelser.
7: K- Nærmeste Naboer (KNN)
Først foreslået af US Air Force School of Aviation Medicine i 1951, og måtte tilpasse sig til den daværende stand af midt-20. århundredes computerværktøj, er K-Nearest Neighbors (KNN) en slank algoritme, der stadig dukker op bredt over akademiske artikler og private sektors maskinlæringsforskningsinitiativer.
KNN er blevet kaldt ‘den dovne lærer’, da den udtømmende gennemløber en dataset for at evaluere relationerne mellem datapunkter, snarere end at kræve træningen af en fuldt udviklet maskinlæringsmodel.

En KNN-gruppering. Kilde: https://scikit-learn.org/stable/modules/neighbors.html
Selv om KNN er arkitektonisk slank, placerer dens systematiske tilgang en bemærkelsesværdig krav på læse-/skriveoperationer, og dens brug i meget store datasets kan være problematisk uden hjælpeteknologier som Principal Component Analysis (PCA), der kan transformere komplekse og høj-volumen-datasets til repræsentative grupperinger, som KNN kan gennemløbe med mindre anstrengelse.
En seneste studie evaluerede effektiviteten og økonomien af en række algoritmer, der blev bedt om at forudsige, om en medarbejder ville forlade et selskab, og fandt, at den 70-årige KNN forblev overlegen i forhold til nøjagtighed og prædiktionseffektivitet i forhold til mere moderne konkurrenter.
Populær brug
Trods sin populære enkelhed af koncept og udførelse, er KNN ikke fastlåst i 1950’erne – det er blevet tilpasset til en mere DNN-fokuseret tilgang i et forslag fra Pennsylvania State University i 2018, og forbliver en central tidlig-stadiet-proces (eller post-processing analytisk værktøj) i mange mere komplekse maskinlærings-rammer.
I forskellige konfigurationer er KNN blevet brugt til online-signatur-verificering, billedklassifikation, tekstminering, afgrøde-forudsigelse, og ansigtsgenkendelse, blandt andre anvendelser og inkorporeringer.

Et KNN-baseret ansigtsgenkendelsessystem i træning. Kilde: https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8: Markov Decision Process (MDP)
En matematisk ramme introduceret af den amerikanske matematiker Richard Bellman i 1957, er Markov Decision Process (MDP) en af de mest grundlæggende byggesten i forstærkningslæring-arkitekturer. En konceptuel algoritme i sin egen ret, er den blevet tilpasset til en stor mængde andre algoritmer, og dukker ofte op i den nuværende mængde af AI/ML-forskning.
MDP udforsker et datamiljø ved at bruge sin vurdering af sin nuværende tilstand (dvs. ‘hvor’ det er i data) til at bestemme, hvilken node af data det skal udforske næste.

Kilde: https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
En grundlæggende Markov Decision Process prioriterer nær-term-fordel over mere ønskværdige langsigtede mål. Af denne grund er det ofte indlejret i konteksten af en mere omfattende politik-arkitektur i forstærkningslæring, og er ofte underlagt begrænsende faktorer som diskonteret belønning og andre modificerende miljøvariable, der vil forhindre det i at skynde sig til et øjeblikkeligt mål uden at tage hensyn til det overordnede ønskede udfald.
Populær brug
MDP’s lav-niveau-koncept er bredt udbredt i både forskning og aktive installationer af maskinlærning. Det er blevet foreslået til IoT-sikkerhedsforsvarssystemer, fiskehøst, og markedforudsigelse.
Ud over dets åbenlyse anvendelighed til skak og andre strengt sekventielle spil, er MDP en naturlig kandidat til procedural træning af robot-systemer, som vi kan se i videoen nedenfor.
9: Term Frequency-Inverse Document Frequency
Term Frequency (TF) dividerer antallet af gange et ord optræder i et dokument med det samlede antal ord i det dokument. Således har ordet sæl, der optræder en gang i en artikel på 1000 ord, en term-frekvens på 0,001. Af sig selv er TF stort set værdiløs som en indikator for term-vigtighed, på grund af det faktum, at meningsløse artikler (såsom a, and, the, og it) dominerer.
For at opnå en meningsfuld værdi for en term, beregner Inverse Document Frequency (IDF) TF’en for et ord på tværs af multiple dokumenter i en dataset, og tildeler lav rating til meget hyppige stop-ord, såsom artikler. De resulterende egenskabsvektorer er normaliseret til hele værdier, med hvert ord tildelt en passende vægt.

TF-IDF vægtning af relevansen af termer baseret på frekvens på tværs af en række dokumenter, med sjældnere forekomst som en indikator for vægt. Kilde: https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
Selv om denne tilgang forhindrer, at semantisk vigtige ord forsvinder som afvigere, kan invertering af frekvens-vægten ikke automatisk betyde, at en lav-frekvens-term ikke er en afviger, fordi nogle ting er sjældne og værdiløse. Derfor vil en lav-frekvens-term behøve at bevise sin værdi i den bredere arkitektoniske kontekst ved at figurere (selv ved lav frekvens per dokument) i en række dokumenter i datasettet.
Trods sin alder, er TF-IDF en kraftfuld og populær metode til indledende filtreringstrin i Natural Language Processing-rammer.
Populær brug
Fordi TF-IDF har spillet en vis rolle i udviklingen af Googles stort set okkulte PageRank-algoritme over de sidste 20 år, er det blevet meget bredt antaget som en manipulerende SEO-taktik, på trods af John Muellers afvisning i 2019 af dets betydning for søgeresultater.
På grund af hemmeligholdelsen omkring PageRank, er der ingen klart bevis for, at TF-IDF ikke er en effektiv taktik for at stige i Googles rangliste. Kontroversiel diskussion blandt IT-fagfolk for nylig antyder en populær forståelse, korrekt eller ej, at term-misbrug måske stadig kan resultere i forbedret SEO-placering (selv om yderligere beskyldninger om monopol-misbrug og eksessiv reklame udvisker grænserne for denne teori).
10: Stokastisk Gradient Descent
Stokastisk Gradient Descent (SGD) er en stadig mere populær metode til at optimere træningen af maskinlæringsmodeller.
Gradient Descent i sig selv er en metode til at optimere og kvantificere den forbedring, som en model gør under træning.
I denne forstand indikerer ‘gradient’ en skråning nedad (snarere end en farve-baseret gradation, se billedet nedenfor), hvor det højeste punkt på ‘bjerget’, til venstre, repræsenterer begyndelsen af træningsprocessen. På dette stadium har modellen endnu ikke set hele datasettet, og har ikke lært nok om relationer mellem data til at producere effektive transformationer.

En gradient-descent på en FaceSwap-træningssession. Vi kan se, at træningen har plateauet i en periode i anden halvdel, men er til sidst kommet tilbage på sporet ned ad gradienten mod en acceptabel konvergens.
Det laveste punkt, til højre, repræsenterer konvergens (punktet, hvor modellen er så effektiv, som den nogensinde vil blive under de pålagte begrænsninger og indstillinger).
Gradienten fungerer som en optegnelse og forudsigelse for forskellen mellem fejl-raten (hvor nøjagtigt modellen har kortlagt data-relationer) og vægtene (indstillingerne, der påvirker, hvordan modellen vil lære).
Denne optegnelse over fremgangen kan bruges til at informere en plan for læringsraten, en automatisk proces, der fortæller arkitekturen at blive mere granulær og præcis, efterhånden som de tidlige vage detaljer forvandler sig til klare relationer og kortlægninger. I virkeligheden giver gradient-tab en kortlagt vej til, hvor træningen skal gå herefter, og hvordan den skal fortsætte.
Innovationen i Stokastisk Gradient Descent er, at den opdaterer modellens parametre for hvert træningseksempel per iteration, hvilket generelt accelererer rejsen til konvergens. På grund af opkomsten af hyperskala-datasets i de seneste år, er SGD vokset i popularitet for nylig som en mulig metode til at tackle de efterfølgende logistiske problemer.
På den anden side har SGD negative implikationer for skalering af egenskaber, og kan kræve flere iterationer for at opnå det samme resultat, og kræver yderligere planlægning og yderligere parametre i forhold til almindelig Gradient Descent.
Populær brug
På grund af dets konfigurerbarhed, og på trods af dets mangler, er SGD blevet den mest populære optimeringsalgoritme til at tilpasse neurale netværk. En konfiguration af SGD, der bliver mere dominerende i nye AI/ML-forskningsartikler, er valget af Adaptive Moment Estimation (ADAM, introduceret i 2015) som optimeringsalgoritme.
ADAM tilpasser læringsraten for hvert parameter dynamisk (‘adaptiv læringsrate’), samt inkorporerer resultater fra tidligere opdateringer i den efterfølgende konfiguration (‘momentum’). Yderligere kan det konfigureres til at bruge senere innovationer, såsom Nesterov Momentum.
Men nogle mener, at brugen af momentum kan også accelerere ADAM (og lignende algoritmer) til en underoptimal konklusion. Som med det meste af fronten af maskinlæringsforskningssektoren, er SGD et arbejde i fremgang.
Først publiceret 10. februar 2022. Ændret 10. februar 20.05 EET – formatering.


