
Grundlæggende AI
Hvordan fungerer tekstklassificering?

 Føj Unite.AI til dine foretrukne kilder på Google
Tekstklassificering tildeler én eller flere etiketter til et dokument, en besked eller et tekstudsnit. Eksempler inkluderer spam‑detektion, intention‑routing, sentimentanalyse, emnemærkning, moderation og prioritering af support‑billetter.
En produktionsklassifikator er mere end en model. Den afhænger af en præcis etiket‑taksonomi, repræsentative annoteringer, lækage‑sikre opdelinger, en kalibreret beslutningsregel og overvågning af skiftende sprog og klassens udbredelse.
Vigtige pointer
- Definér etiketter og tvetydige tilfælde, før du vælger en arkitektur.
- Simple bag‑of‑words‑baselines forbliver værdifulde; fortrænet encodere tilføjer kontekst og overførselslæring.
- Nøjagtighed kan skjule dårlig præstation for minoritetsklasser, så brug klassespecifikke målinger og fejlanalyse.
- Sandsynlighedskalibrering, afståelse og menneskelig gennemgang omsætter scorer til sikrere beslutninger.
Definér taksonomien og annoteringspolitikken
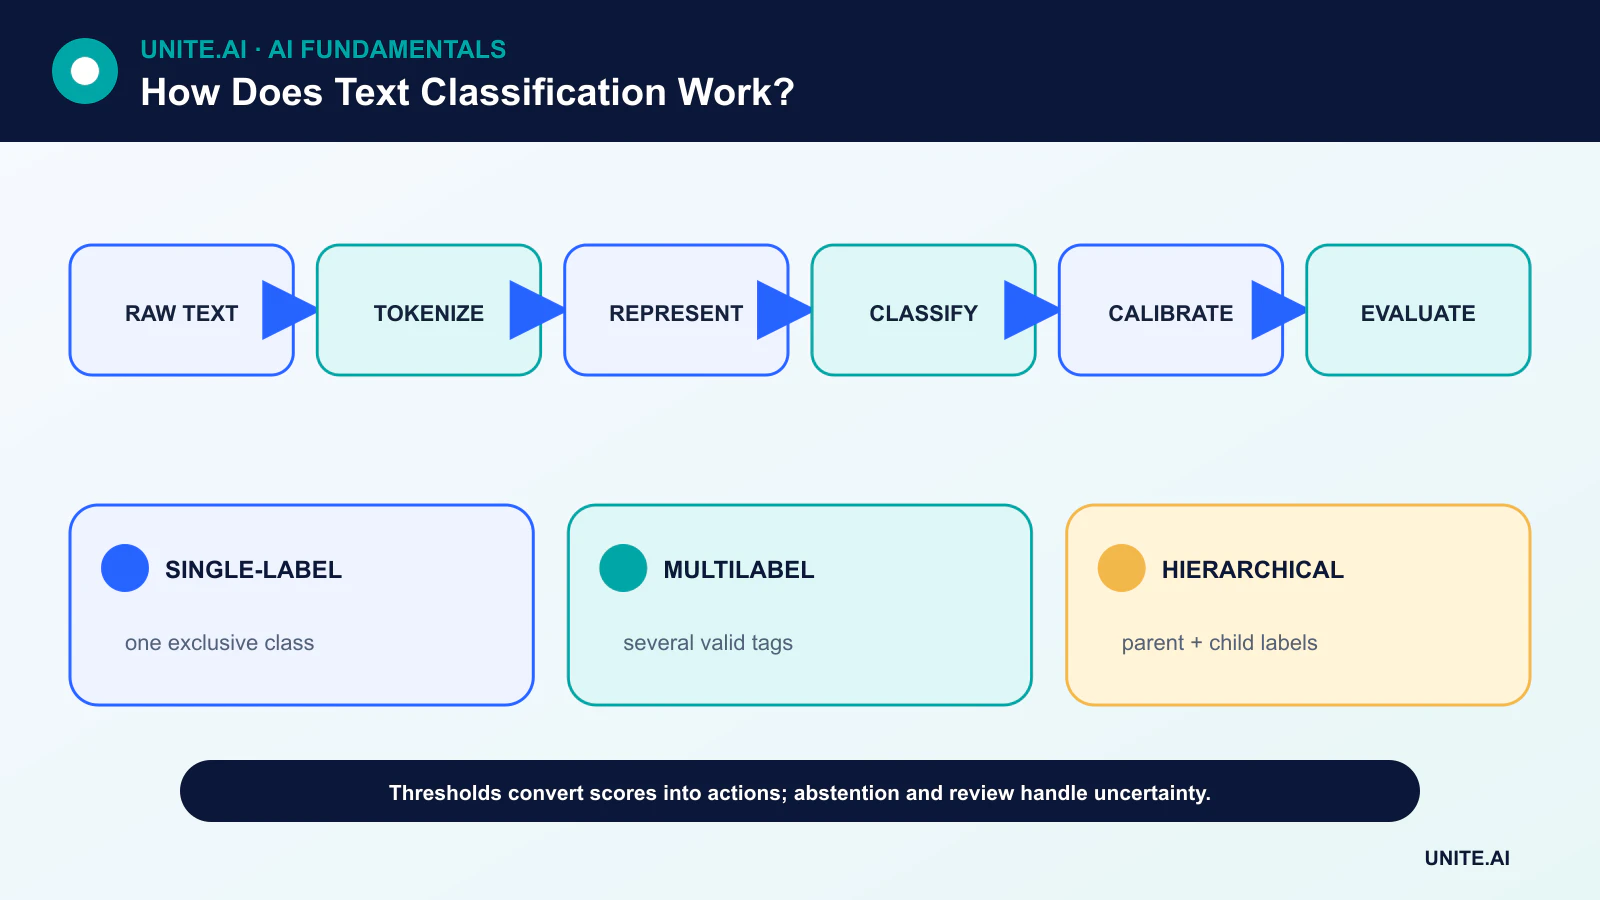
En enkelt‑etiket‑opgave vælger én gensidigt udelukkende klasse. En fleretiket‑opgave kan tildele flere uafhængige mærker. Hierarkiske taksonomier indeholder forældre‑ og børneetiketter. Disse er forskellige læringsproblemer og kræver forskellige output og målinger.
Annotatorer har brug for definitioner, positive og negative eksempler, regler for manglende kontekst og en eskaleringsvej. Enighedsstatistik kan afsløre en uklar opgave, men uenighed kan også repræsentere ægte tvetydighed, som systemet bør bevare.
Repræsentation af tekst
Traditionelle pipelines bruger token‑tællinger, n‑grammer og TF‑IDF med lineære klassifikatorer eller supportvektormaskiner. De træner hurtigt, afslører indflydelsesrige termer og giver et stærkt grundlag.
Neurale systemer kortlægger tokens til indlejringer. Fortrænede transformer‑encodere bruger attention til at producere kontekstuelle repræsentationer og kan finjusteres med mærkede eksempler. Promptede eller zero‑shot‑klassifikatorer kan reducere den indledende mærkning, men deres etiketformulering, modelversion og kalibrering skal evalueres på det faktiske domæne.
Træning uden lækage
Datasættet opdeles i trænings‑, validerings‑ og endelige testdata. Nærdobbelt dokumenter, beskeder fra samme samtale eller skabeloner fra samme kilde bør forblive i samme opdeling. For tidsafhængig brug repræsenterer en kronologisk opdeling implementeringen bedre.
Klasseubalancen kan håndteres gennem vægtning, genprøveudtagning, valg af tærskel eller ekstra data. Syntetiske eksempler bør ikke erstatte gennemgang af reelle fejl i minoritetsklasser og kan introducere artefakter, som modellen lærer for let.
Målinger og kalibrerede beslutninger
En forvirringsmatrix viser, hvilke etiketter der forveksles. Præcision måler, hvor mange forudsagte positive der er korrekte; recall måler, hvor mange sande positive der findes. Makro‑gennemsnit vægter klasser ligeligt, mens mikro‑gennemsnit vægter individuelle eksempler.
En rå softmax‑score er ikke automatisk en pålidelig sandsynlighed. Kalibrering sammenligner tillid med observeret korrekthed. Teams kan sætte klassespecifikke tærskler, afstå når tilliden er lav, og dirigere følsomme tilfælde til en reviewer.
Implementering, flersproget brug og drift
Tekst ændrer sig med produkter, begivenheder, slang og modstandshandlinger. Overvågning bør spore input‑sprog, længde, out‑of‑vocabulary‑mønstre, klassesatser, tillid og forsinkede resultater. Gen‑træning kræver versionerede data og en regressionspakke af vigtige eksempler.
Flersproglig ydeevne skal testes pr. sprog og dialekt. Oversættelse af alt til ét sprog kan ændre sentiment eller entiteter; en flersproget encoder kan stadig præstere ujævnt, fordi dens fortræning og etiketter ikke er lige repræsentative.
Repræsentationer og klassifikator‑familier
Tekstklassificering kortlægger et dokument, en sætning eller en token‑sekvens til én eller flere etiketter. Definér om etiketter er gensidigt udelukkende, fleretiket, hierarkiske, ordnede eller åbne. Traditionelle pipelines tokeniserer tekst, bygger bag‑of‑words‑ eller TF‑IDF‑funktioner og træner logistisk regression, naive Bayes eller en lineær SVM. Neurale systemer lærer indlejringer med convolution, recurrence eller transformers. Promptede sprogmodeller kan klassificere uden opgavespecifik træning, men output‑begrænsninger, omkostninger, drift og beviser skal stadig evalueres mod enklere grundlag.
Forbehandling afhænger af repræsentationen. Nedskrivning eller fjernelse af tegnsætning kan ødelægge signaler for navne, sentiment, kode eller sprog; stemming kan sammenlægge forskellige betydninger. Transformer‑tokenizere opererer på subord og har længdebegrænsninger, så afkortningsstrategi er vigtig. Lange dokumenter kan kræve opdeling i bidder og aggregation. Bevar den rå tekst og transformationsversion, og opdel efter forfatter, samtale, kilde eller tid for at forhindre nærdobletter og tilbagevendende skabeloner i at krydse træning og test.
Etiketter, målinger og fejlanalyse
En annoteringsguide bør definere omfang, eksempler, tvetydige tilfælde og en ukendt‑ eller afståelses‑mulighed. Mål enighed og afgjør uenighed i stedet for at skjule den med flertalsafstemning. For ubalancerede klasser er nøjagtighed utilstrækkelig; rapportér præcision, recall, F1, forvirring, kalibrering og tærskel‑specifik arbejdsbyrde pr. klasse. Flertags‑opgaver kræver mikro‑, makro‑ og etiket‑niveau målinger. Evaluer sprog, dialekter, domæner, beskedlængde og tid. En tilfældig opdeling kan overvurdere kvalitet, når ordforråd eller skabeloner drifter.
Fejlanalyse bør adskille repræsentationsfejl, utilstrækkelig kontekst, etiket‑tvetydighed, sjældent ordforråd, negation, sarkasme og falske signaler. Brug kontrafaktiske tests, der ændrer navne, dialekt‑markører eller irrelevant metadata, mens meningen bevares. Undersøg fejl med høj tillid og afviste tilfælde. En model kan lære, at en kundekanal eller signatur forudsiger en etiket i stedet for at fortolke indholdet. Fjern lækage og revidér data, før du blot øger modellens kapacitet.
Produktionsdesign
Betjen en fast tokeniser og model med skema‑validering, længdebegrænsninger, batch‑behandling og en fallback for ikke‑understøttet sprog eller lav tillid. Overvåg input‑distribution, etiket‑satser, kalibrering, latenstid og gennemgåede resultater. Beskyt teksten, da den kan indeholde personlige, fortrolige eller modstandshandlinger. For automatiseret moderation, berettigelse eller routing, tilbyd appel og mål forskelligartede fejl. Versionér etiketter og tærskler i overensstemmelse med forretningspolitik. Tekstklassificering er pålidelig kun inden for sit definerede etiket‑system og datafordeling; flydende modelforklaringer beviser ikke, at en klassifikation er korrekt.
Eksempel: klassificering af indkommende support‑anmodninger
Et supportteam definerer gensidigt udelukkende routing‑etiketter samt flag for hastende, flersprogede og ukendte sager. Annotatorer mærker de‑identificerede beskeder med vejledning for blandede problemstillinger og måler enighed. En TF‑IDF‑logistisk baseline, finjusteret encoder og promptet model bruger det samme tidsbaserede test‑sæt. Evalueringen rapporterer klassens præcision og recall, hastende falske negativer, kalibrering, skema‑validitet, latenstid og omkostninger, med nærdobbelt skabeloner grupperet for at undgå lækage.
Den implementerede klassifikator validerer sprog og længde, afstår ved svage beviser og lader agenter rette ruter. Prompt og beskeder behandles som upålidelige; værktøjstilgang er fraværende. Overvågning sporer etiket‑forekomst, tillid, korrektion, svartid og fremkommende emner. En politik‑ eller produktændring opdaterer taksonomien og gen‑træningsdata gennem gennemgang. Systemet forbedrer kø‑placering, men det udleder aldrig kundens følelser eller berettigelse ud over de validerede etiketter.
Implementeringsbeviser og driftsparathed
En produktionsbeslutning kræver mere end en vellykket demonstration. Definér de tiltænkte brugere, driftsmiljø, input, output, afhængigheder, ejer og konsekvensen af hver vigtig fejl. Etablér et reproducerbart grundlag og et versioneret evalueringssæt før finjustering. Test almindelige tilfælde, grænsebetingelser, fejlformet eller manglende input, distributionsskift, afhængighedsnedbrud, misbrug og de grupper eller miljøer, der sandsynligvis er underforsynet. Mål opgavens kvalitet sammen med kalibrering eller usikkerhed, latenstid, gennemløb, ressourceomkostninger, tilgængelighed, privatliv og sikkerhed. Registrér hver transformation og tærskel, så en uafhængig reviewer kan reproducere resultatet og skelne beviser fra en attraktiv prototype.
Før lancering skal autoritet for udgivelse, undtagelser, ændringer, rollback og pensionering tildeles. Brug en trinvis udrulning, bevar en sikker fallback, og verificér overvågning med bevidst indsprøjtede fejl. Operationel telemetri bør afsløre input‑kvalitet, output‑adfærd, model‑ eller regel‑version, afhængigheds‑sundhed, menneskelige overstyringer og bekræftede resultater uden at indsamle unødvendige følsomme data. Definér alarm‑tærskler og en ansvarlig for respons, og gennemgå real‑world‑beviser efter implementering i stedet for at antage, at offline‑præstationen vil bestå. Revurder, når datakilder, brugere, modeller, leverandører, politikker, hardware eller mål ændres. Et vedligeholdt system kræver også dokumenteret gendannelse, hændelses‑læring, sletnings‑ og opbevaringsprocedurer samt et klart tidspunkt, hvor det skal deaktiveres eller udskiftes.
Ofte stillede spørgsmål
Er sentimentanalyse en tekstklassificeringsopgave?
Normalt ja, men sentiment kan være fleretiket, aspekt‑baseret eller kontinuert i stedet for en enkelt positiv/neutral/negativ etiket.
Hvornår skal en tekstklassifikator afstå?
Når tilliden er lav, teksten er uden for omfang, nødvendig kontekst mangler, eller omkostningen ved en forkert automatisk handling overstiger omkostningen ved gennemgang.
Primære referencer












