
Anderson 视角
Stable Diffusion 前方的三个挑战

 将 Unite.AI 添加到您在 Google 上的首选来源
此次 发布 发生于几周前,推出了 stability.ai 的 Stable Diffusion 这一 潜在扩散 图像合成模型可能是最重要的技术公开之一, 自 1999 年 DeCSS 以来;它无疑是 AI 生成图像领域最大的事件,自 2017 年 deepfakes 代码 被复制到 GitHub,并分叉发展为后来的 DeepFaceLab 和 FaceSwap,以及实时流式深度伪造软件 DeepFaceLive以来。
转眼间, 用户的挫败感 ——源于 内容限制 在 DALL-E 2 图像合成 API 中的存在——便被一扫而空,因为人们发现只需修改 一行代码,就能禁用 Stable Diffusion 的 NSFW 过滤器。专注于色情内容的 Stable Diffusion Reddit 社区几乎立刻出现,也同样迅速被关闭;与此同时,开发者和用户在 Discord 上分成官方社区和 NSFW 社区,Twitter 开始充满 Stable Diffusion 的奇幻想象作品。
目前,采用该系统的开发者似乎每天都会带来令人惊叹的创新,人们正快速编写插件和第三方附加工具,用于 Krita, Photoshop, Cinema4D, Blender以及许多其他应用平台。
与此同时, 提示词创作 ——如今已成为职业的“AI 耳语”艺术,可能是自“Filofax 整理员”以来寿命最短的职业选择——已经开始 商业化,而 Stable Diffusion 的早期变现正在 Patreon 层面展开。更复杂的服务肯定会陆续出现,面向那些不愿处理 基于 Conda 的 源代码安装,或不愿受网页版严格 NSFW 过滤器限制的人。
开发进度和用户自由探索的节奏快得令人眩晕,很难看清远方。归根结底,我们尚不确切知道面对的是什么,也不知道全部限制或可能性是什么。
尽管如此,下面看看快速形成并不断壮大的 Stable Diffusion 社区可能需要面对、并有望克服的三个最有趣也最艰巨的障碍。
1:优化基于图块的处理流程
面对有限的硬件资源和训练图像分辨率的硬性限制,开发者很可能会找到变通办法,提高 Stable Diffusion 输出的质量和分辨率。这些项目中有许多将利用系统本身的限制,例如仅为 512×512 像素的原生分辨率。
正如计算机视觉和图像合成项目通常所做的那样,Stable Diffusion 使用正方形图像训练;在这里,图像被重采样为 512×512,以便统一源图像,并使它们符合训练模型所用 GPU 的限制。
因此,Stable Diffusion 若有所谓“思考”,就是以 512×512 为单位,而且肯定以正方形为框架。许多正在探索系统极限的用户表示,这一相当受限的宽高比能产生最可靠、瑕疵最少的结果(参见下文肢体问题)。
虽然不同实现可通过 RealESRGAN 进行放大(也可以借助 GFPGAN 修复生成不佳的人脸),但一些用户正在开发将图像分成 512×512 像素区块,再拼接成更大合成作品的方法。

这张 1024×576 的渲染图——通常无法由 Stable Diffusion 一次生成的分辨率——是把 Python 文件 attention.py 从 DoggettX 分支复制到另一个分支后生成的;前者是采用基于图块放大方法的 Stable Diffusion 版本。 来源:https://old.reddit.com/r/StableDiffusion/comments/x6yeam/1024x576_with_6gb_nice/
虽然部分项目使用原创代码或其他库,GOBIG 的 txt2imghd 移植版 预计很快就会为主分支提供这项功能。GOBIG 是耗费大量 VRAM 的 ProgRockDiffusion 的一种模式。txt2imghd 是专门移植 GOBIG 的版本,而其他社区开发者正在尝试 GOBIG 的不同实现。

原始 512×512 像素渲染中的抽象图像恰好适合这一示例(左和左二);随后用 ESGRAN 放大,该工具如今几乎已成为各个 Stable Diffusion 发行版的内置功能;再通过 GOBIG 实现给予“特别关注”,产生的细节至少在相应图块范围内看起来放大得更好。来源:https://old.reddit.com/r/StableDiffusion/comments/x72460/stable_diffusion_gobig_txt2imghd_easy_mode_colab/
上述抽象示例有许多细节的“小王国”,适合这种只关注自身的放大方式。但若想得到不重复、连贯的放大结果,而非 看起来 像许多碎片拼起来的图像,可能就需要更有挑战性的代码解决方案。尤其在人脸方面,我们对畸变和突兀伪影格外敏感。因此,人脸最终可能需要专门的解决方案。
Stable Diffusion 目前没有在渲染时聚焦人脸的机制,无法像人类那样优先考虑面部信息。虽然一些 Discord 开发者正考虑实现这种“增强注意力”,但目前在初次渲染之后手动改善人脸要容易得多,未来也许能自动完成。
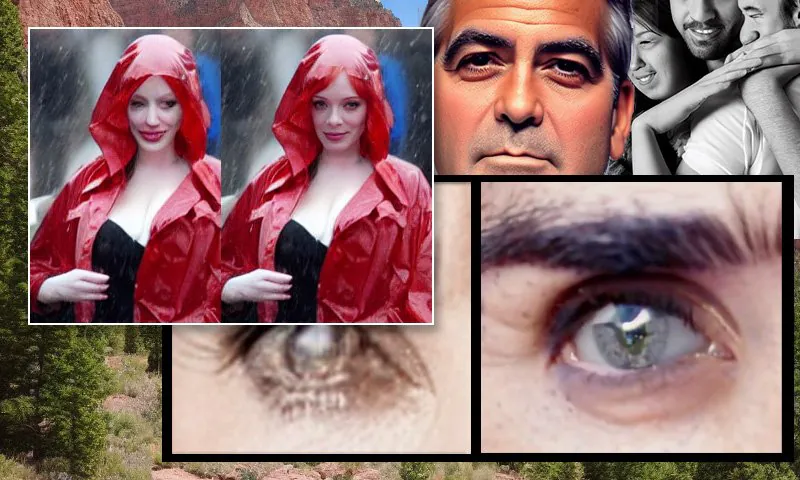
人脸具有内部完整的语义逻辑,而建筑物下方角落的一块图像并不具备这种逻辑。因此,目前可以非常有效地对 Stable Diffusion 输出中粗略的人脸“放大”并重新渲染。

左:Stable Diffusion 最初使用提示词 ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’ 的结果。右:把初次渲染中模糊、粗略的人脸通过 Img2Img 再次交给 Stable Diffusion,让它投入全部注意力后改善的人脸(参见下面的动图)。
如果没有专门的 Textual Inversion 解决方案(见下文),这种方法只适用于已在训练 Stable Diffusion 的 LAION 数据子集中得到充分体现的名人。因此,它适用于 Tom Cruise、Brad Pitt、Jennifer Lawrence 等少数在源数据中拥有大量图像的真正媒体名人。
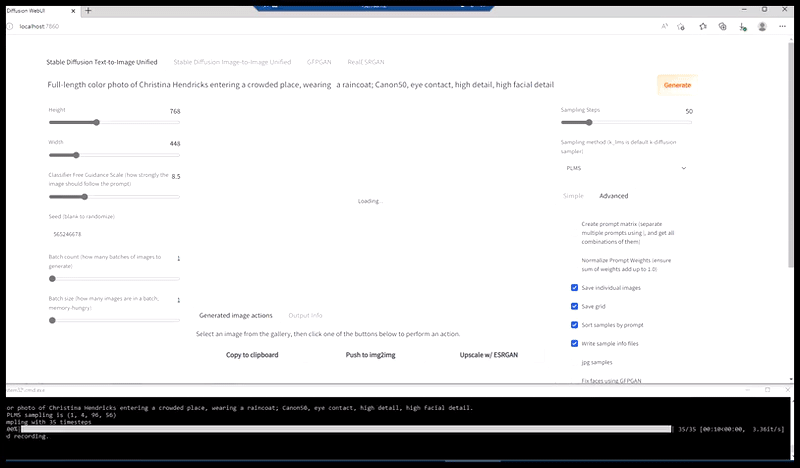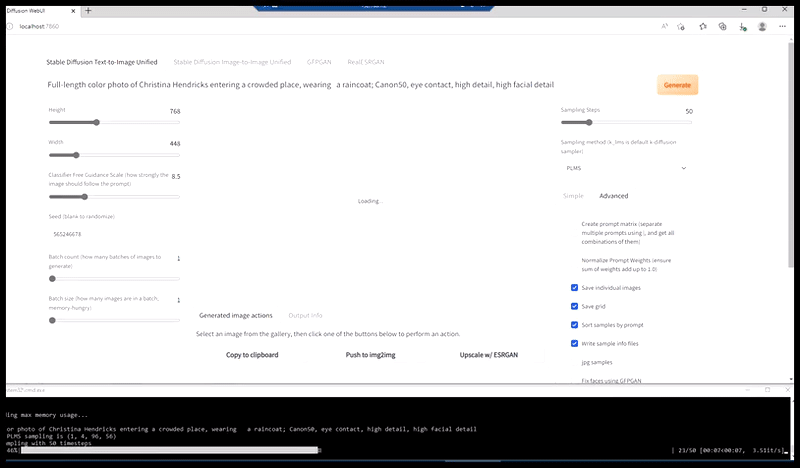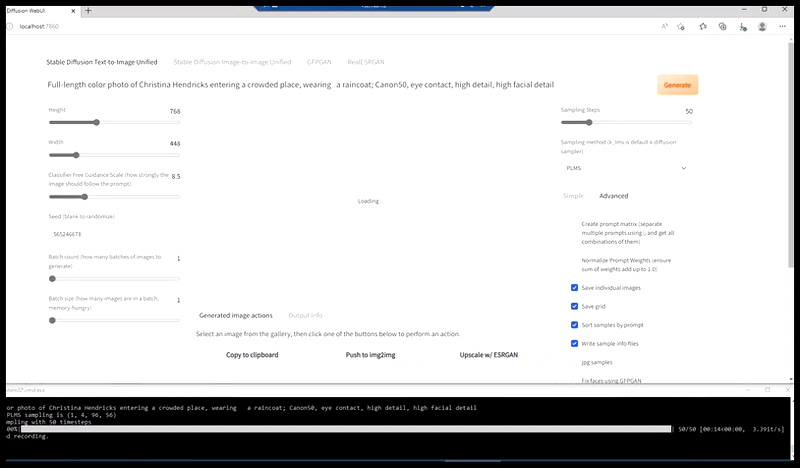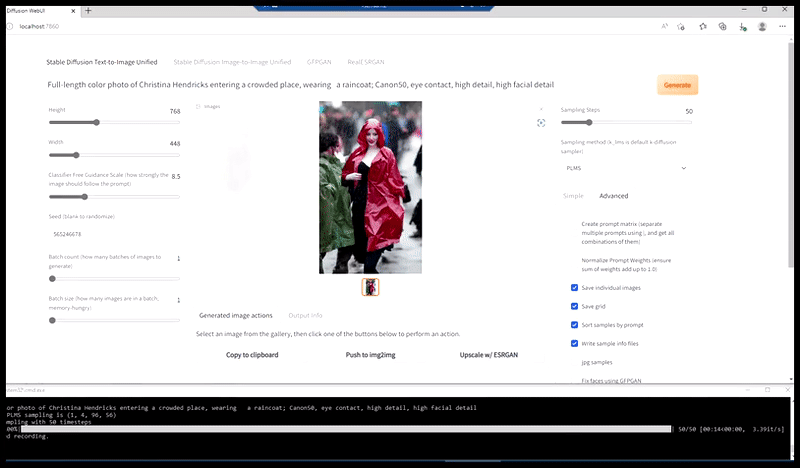
使用提示词 ‘Full-length color photo of Christina Hendricks entering a crowded place, wearing a raincoat; Canon50, eye contact, high detail, high facial detail’ 生成一张可信的新闻照片。
对于职业生涯漫长而持久的名人,Stable Diffusion 通常会生成其近期、也就是年龄较大的形象。要生成较年轻的样貌,需要在提示词中添加 ‘young’ 或 ‘in the year [YEAR]’ 这样的限定。

演员 Jennifer Connelly 拥有近 40 年突出、经常被拍摄且持续的职业生涯,是 LAION 中少数能让 Stable Diffusion 呈现多个年龄阶段的名人之一。来源:本地预装 Stable Diffusion,v1.4 检查点;与年龄相关的提示词。
这主要源于 2000 年代中期以来数字新闻摄影的普及,取代了昂贵的乳剂摄影,以及后来宽带速度提升带来的图像数量增长。
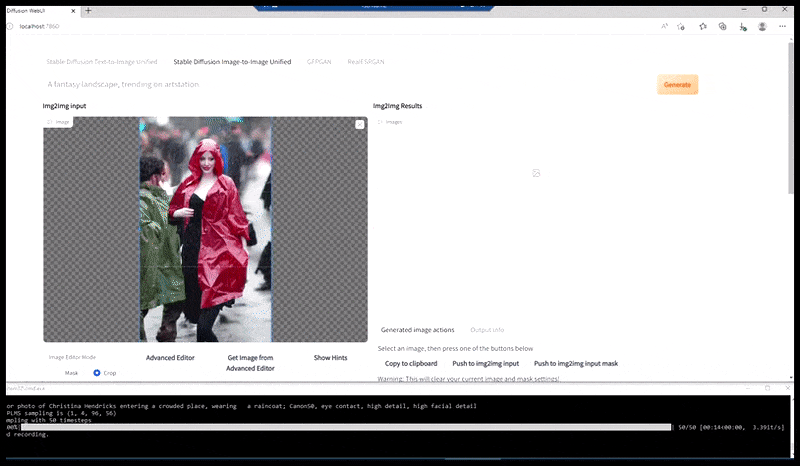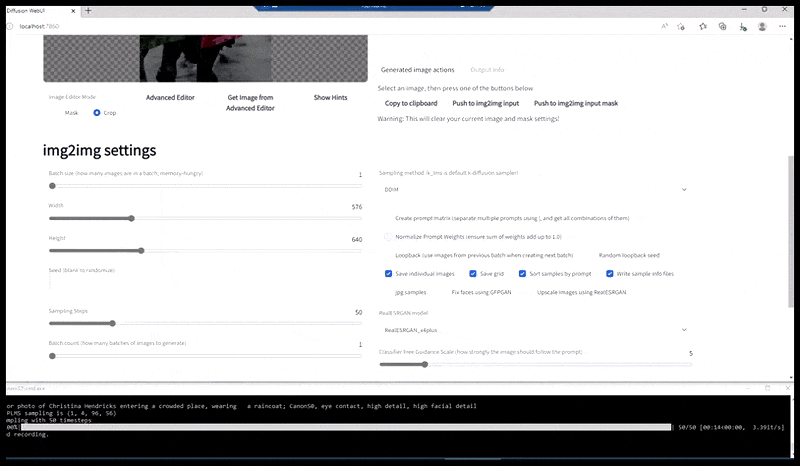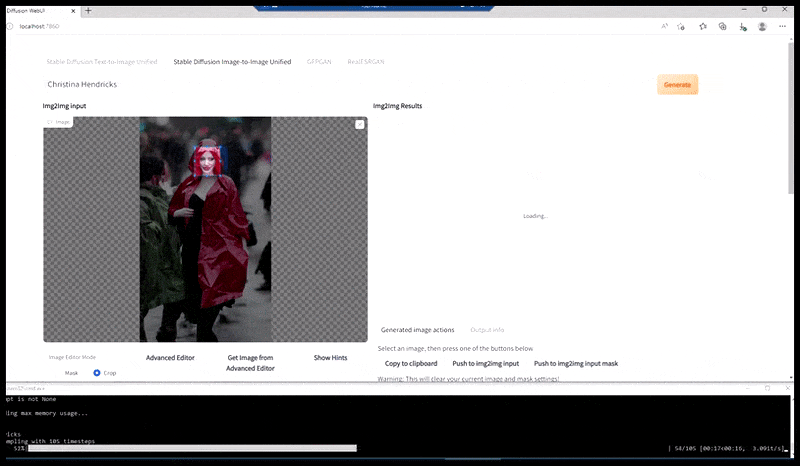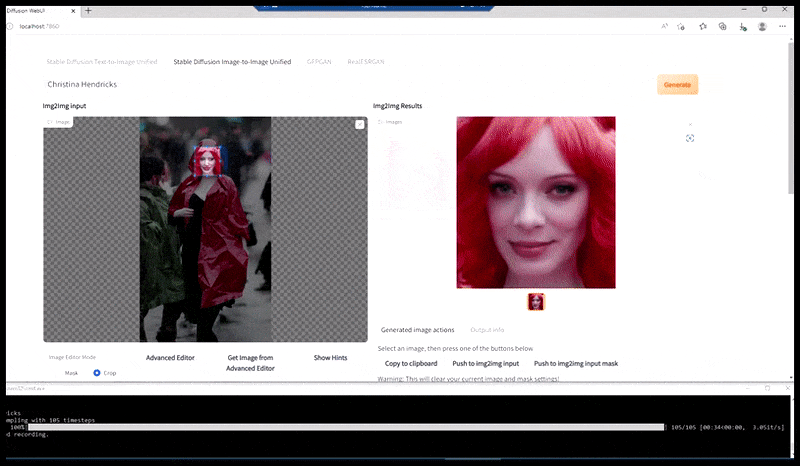
将渲染图像传入 Stable Diffusion 的 Img2Img,选择一个“聚焦区域”,再仅为该区域生成最大尺寸的新渲染图,使 Stable Diffusion 能把所有可用资源集中于重建人脸。
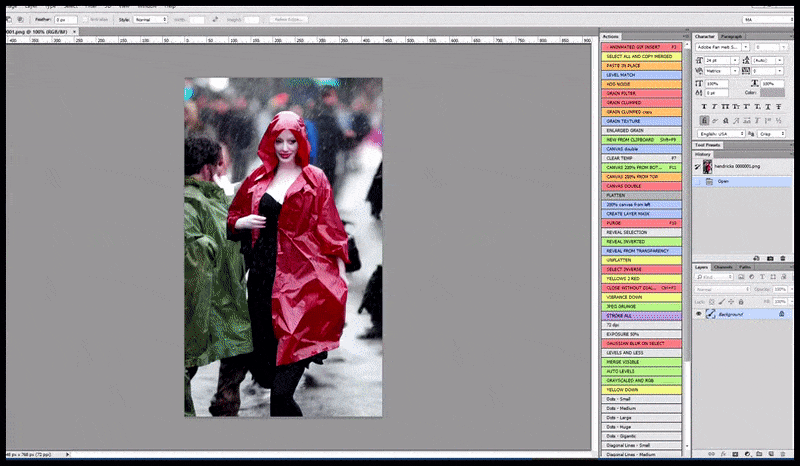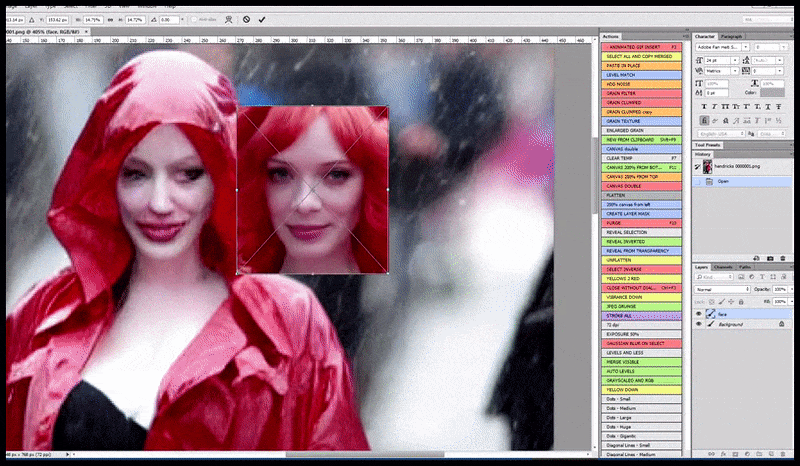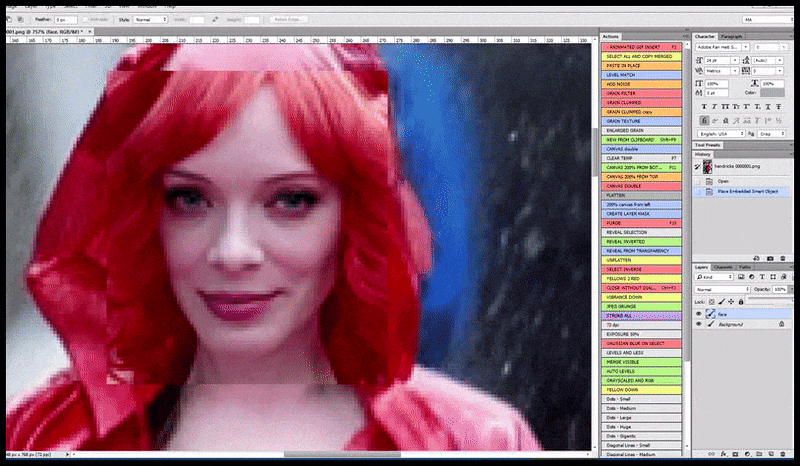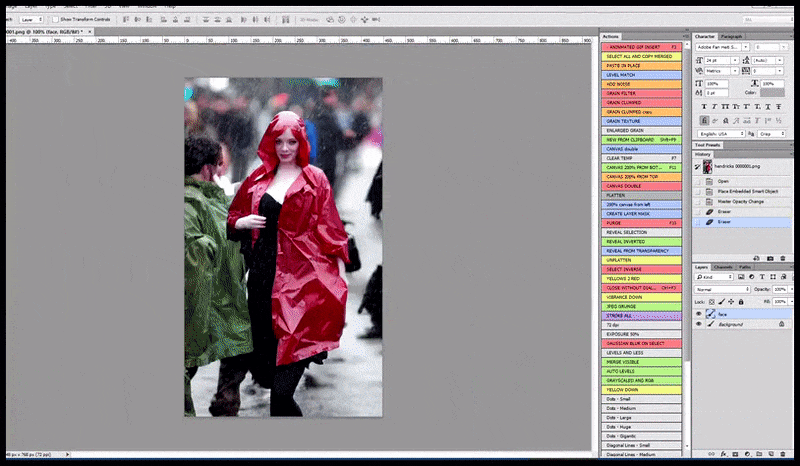
把获得“高度关注”的人脸合成回原图。除了人脸,这一过程只适用于可能具有已知、连贯且完整外观的实体,例如原图中包含手表或汽车等明确物体的区域。放大墙的一部分会导致重新拼接的墙十分奇怪,因为生成各图块时并没有这块“拼图”所在的更大背景。
数据库中的某些名人仿佛已经“冻结”在特定年代,可能因为他们早逝,如 Marilyn Monroe,也可能因为仅在短期内享有主流名气,从而在有限时期产生大量图像。向 Stable Diffusion 提问或许能提供一种当今和老牌明星的“当前”人气指数。一些老牌和当今名人的源图像不足以生成非常相似的肖像,而某些去世已久或早已淡出的明星持续受欢迎,使系统仍能生成较可信的形象。

Stable Diffusion 的输出很快便揭示哪些名人的脸在训练数据中充分出现。写作时已处于青少年后期的 Millie Bobby Brown 虽然极受欢迎,但 LAION 从网上抓取源数据时,她更年轻且知名度较低,因此目前要生成高度相似的形象仍有困难。
有数据支持时,Stable Diffusion 基于图块的放大方案可以超越仅仅关注整张脸:将面部特征拆开,在重新组装前逐一把本地 GPU 全部资源用于各个显著特征,可能得到更精确、细致的人脸。这同样仍是手动过程。

这不限于人脸,但仅限于在整体对象的更大背景中位置至少同样可预测的部分,而且这些部分应符合人们有理由预期在超大规模数据集中存在的高层嵌入表示。
真正的限制是数据集中的参考数据量,因为经过深度迭代的细节最终会完全成为“幻觉”,也就是虚构,真实性降低。
这种细粒度放大对 Jennifer Connelly 有效,是因为她在多个年龄阶段都充分出现在 LAION-aesthetics ——它是 LAION 5B 中 Stable Diffusion 使用的主要子集——以及整个 LAION 中。许多其他情况下,数据不足会降低准确性,需要微调,也就是额外训练(见下文“定制”),或 Textual Inversion(见下文)。
图块是使 Stable Diffusion 生成高分辨率输出的强大而相对廉价的方法。但如果没有更广泛、更高层次的注意力机制,这种算法式图块放大在多种内容上可能达不到预期标准。
2:解决人体四肢问题
在描绘人体末端部位的复杂性时,Stable Diffusion 并不如其名称所暗示的那样稳定。手可能随机增多,手指可能融合,第三条腿可能不请自来,原有肢体可能消失得无影无踪。公平地说,类似模型也有这个问题,DALL-E 2 更是如此。

2022 年 8 月底 DALL-E 2 和 Stable Diffusion(1.4)的未经编辑结果,两者都有肢体问题。提示词为 ‘A woman embracing a man’。
期待即将到来的 1.5 检查点——经过更密集训练、参数更完善的模型版本——能解决肢体混乱的 Stable Diffusion 爱好者很可能会失望。新模型将在 大约两周后发布,目前已在 stability.ai 商业门户 DreamStudio上率先提供;该服务默认使用 1.5,用户可将新结果与本地或其他 1.4 系统的渲染图比较:

来源:本地 1.4 预装包及 https://beta.dreamstudio.ai/

来源:本地 1.4 预装包及 https://beta.dreamstudio.ai/

来源:本地 1.4 预装包及 https://beta.dreamstudio.ai/
与常见情况一样,数据质量很可能是主要原因。
为 Stable Diffusion 和 DALL-E 2 等图像合成系统提供数据的开放数据库,能为个体以及人与人之间的行动提供许多标签。这些标签与相关图像或图像片段相辅相成地被纳入训练。

Stable Diffusion 用户可查询 LAION-aesthetics,探索模型训练过的概念。它是为系统提供数据的较大 LAION 5B 数据集的子集。图像按“美学评分”排序,而非按标签的字母顺序。 来源:https://rom1504.github.io/clip-retrieval/
用来描绘人体手臂的单独标签和类别,一个 良好的层级结构 大致如下: body>arm>hand>fingers>[sub digits + thumb]> [digit segments]>Fingernails.

手部各部分的细粒度语义分割。即使这种异常详细的拆分,也把每个“手指”作为单一实体,没有考虑普通手指的三个指节和拇指的两个指节。 来源:https://athitsos.utasites.cloud/publications/rezaei_petra2021.pdf
实际上,整个数据集的源图像不大可能都得到这样一致的标注。无监督标注算法很可能停留在 更高 层级,比如“手”,把内部像素——技术上含有“手指”信息——当作未标注的像素团。从中任意提取的特征可能在后续渲染中成为突兀之处。

应有的样子(右上,如果不是上勾拳的话)与常见的样子(右下),这源于标注资源有限,或架构对已有标签的利用方式受到限制。
因此,如果潜在扩散模型已渲染出手臂,它几乎肯定会尝试在手臂末端渲染一只手,因为 arm>hand 是最低限度的层级结构,在架构所掌握的“人体解剖学”知识中处于相当高的层次。
再往下,“手指”可能就是最小的分组,尽管描绘人手还需考虑手指和拇指的另外 14 个子部分。
如果这一理论成立,就没有真正的补救办法,因为整个领域都缺少人工标注的预算,也缺少能在低错误率下自动标注的有效算法。实际上,模型当前可能依赖人体解剖结构的一致性,来掩盖其训练数据的不足。
它之所以 不能 依靠这一点,一个可能原因最近在 Stable Diffusion Discord 中被 提出 :模型可能会混淆真实人手应有的正确手指数量,因为为它提供数据的 LAION 数据库包含手指较少的卡通人物(这本身是 节省绘制工作量的捷径)。

可能导致 Stable Diffusion 及类似模型“手指缺失”问题的两个嫌疑对象。下方是 LAION-aesthetics 数据集中为 Stable Diffusion 提供训练数据的卡通手示例。 来源:https://www.youtube.com/watch?v=0QZFQ3gbd6I
如果这是真的,唯一明显的解决方案就是重新训练模型,排除不现实的人形内容,并将真正缺失肢体的情况,如截肢者,恰当标注为例外。仅从数据整理角度看,这已是相当大的挑战,尤其对于资源匮乏的社区项目。
第二种方法是应用过滤器,阻止这类内容,如“三指/五指手”,在渲染时出现,类似于 OpenAI 已经在一定程度上 过滤 GPT-3 和 DALL-E 2的做法,使得不必重新训练源模型也能管理输出。

对 Stable Diffusion 而言,手指乃至肢体之间的语义区别可能变得骇人地模糊,让人联想到 David Cronenberg 等导演在 1980 年代恐怖片中的“身体恐怖”流派。 来源:https://old.reddit.com/r/StableDiffusion/comments/x6htf6/a_study_of_stable_diffusions_strange_relationship/
不过,这仍然需要可能并不存在于所有相关图像上的标签,因此还是同样的组织与预算难题。
可以说还剩两条路:给问题投入更多数据,以及使用第三方解释系统,在这些身体错误被呈现给最终用户时加以干预。至少后一种做法能让 OpenAI 为“身体恐怖”渲染提供退款办法,如果公司愿意这么做的话。
3:定制
Stable Diffusion 未来最令人兴奋的可能性之一,是用户或组织开发修订后的系统。这些修改能把预训练 LAION 范围之外的内容纳入系统,理想情况下不必承担重新训练整个模型的失控费用,也不必冒险把大量新图像训练到现有成熟且强大的模型中。
打个比方:两个能力较弱的学生加入一个有三十名学生的高级班,要么会融入并跟上,要么会作为少数例外而失败。无论哪种情况,班级平均表现大概不会变化。但如果加入十五名能力较弱的学生,整个班的成绩分布很可能会变差。
同样,持续且昂贵的模型训练建立起来的关系网络既相互协同又相当脆弱,过多新数据可能损害它,某些情况下甚至实际上摧毁它,全面降低模型输出质量。
这样做主要适用于你想完全接管模型对关系和事物的概念理解,并专门用它生成与新增材料相似的内容时。
因此,把 500,000 帧 Simpsons 训练进现有 Stable Diffusion 检查点,最终很可能得到比原始版本更好的 Simpsons 模拟器,前提是足够广泛的语义关系仍能在这一过程中保留下来,比如 Homer Simpson eating a hotdog;它可能需要新增材料中没有、但原检查点中已有的热狗相关数据。同时还要假设你不想突然从 Simpsons 内容转向创作 fabulous landscape by Greg Rutkowski ,因为经过追加训练的模型已被大幅转移注意力,做这类事不会再像以前那样好。
一个值得注意的例子是 waifu-diffusion,它已经成功 追加训练了 56,000 张动漫图像 到一个已完成训练的 Stable Diffusion 检查点中。不过,这对爱好者而言并不容易,因为模型至少需要 30GB VRAM,远远超出 NVIDIA 即将推出的 40XX 系列消费级产品预计能提供的容量。

通过 waifu-diffusion 把定制内容训练进 Stable Diffusion:模型经过两周追加训练,才能达到这一插画水平。左侧六张图显示训练过程中,模型依据新训练数据生成主题一致输出的进步。 来源:https://gigazine.net/gsc_news/en/20220121-how-waifu-labs-create/
人们可能会为这些 Stable Diffusion 检查点分支投入巨大精力,却被技术债务阻碍。官方 Discord 的开发者已经表示,未来检查点并不一定向后兼容,甚至以前版本可用的提示词逻辑也可能不再有效,因为他们主要追求的是最好的模型,而不是支持旧应用和流程。
因此,将检查点分支做成商业产品的公司或个人实际上没有回头路:此时他们的模型成为一个“硬分叉”,不能再吸收 stability.ai 后续版本的上游改进,这是一项很大的承诺。
目前,定制 Stable Diffusion 的更大希望在于 Textual Inversion,用户在其中用少量与 CLIP对齐的图像训练。

Textual Inversion 是特拉维夫大学与 NVIDIA 的合作成果,它能训练独立的新实体,同时不破坏源模型的能力。 来源:https://textual-inversion.github.io/
Textual Inversion 最明显的主要限制是推荐图像数量极少,可能仅五张。这实际上产生了一种有限实体,可能更适合风格迁移,而不是插入逼真的摄影式物体。
尽管如此,Stable Diffusion 的多个 Discord 社区正使用多得多的训练图像开展实验,其效果如何仍有待观察。同样,这项技术需要大量 VRAM、时间和耐心。
由于这些限制,可能还需等待一段时间,才能看到 Stable Diffusion 爱好者更精细的 Textual Inversion 实验,并了解这一方法是否能在保留官方检查点惊人功能的同时,比 Photoshop 剪切粘贴更好地“把你放进照片”。
首次发表于 2022 年 9 月 6 日。



