
Anderson 视角
RigNeRF:一种使用神经辐射场的新型Deepfakes方法

 将 Unite.AI 添加到您在 Google 上的首选来源

要点RigNeRF是首个利用三维形变模型控制的神经辐射场实现可行深度伪造的方法。
查看更多
- RigNeRF是首个利用三维形变模型控制的神经辐射场实现可行深度伪造的方法。
- 该系统仅需70秒智能手机视频即可训练,不同于繁琐的自编码器数据集。
- RigNeRF支持包括身体和背景在内的完整场景合成,而不仅仅是换脸。
最近的研究在Adobe (ADBE ) 开发了一种基于神经辐射场(NeRF)的可行且有效的Deepfakes方法,这可能是自2017年Deepfakes出现以来五年来首次真正的创新。
该方法名为RigNeRF,使用三维可变形人脸模型(3DMM)作为中间层,连接输入(即要强加于NeRF渲染的身份)和神经空间。这种方式近年来已被广泛用于生成对抗网络(GAN)人脸合成方法,然而,这些方法尚未产生功能性和有用的面替换框架用于视频。
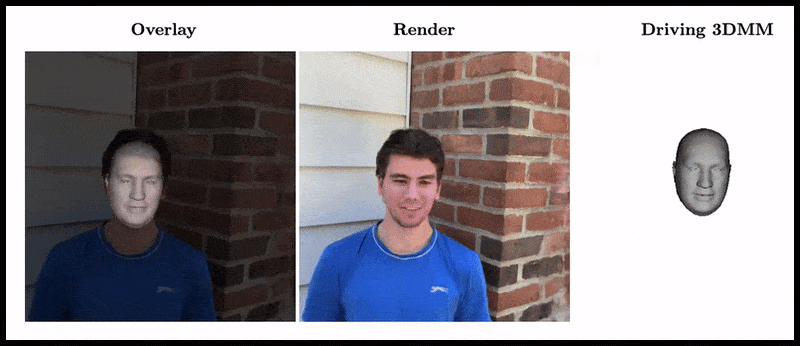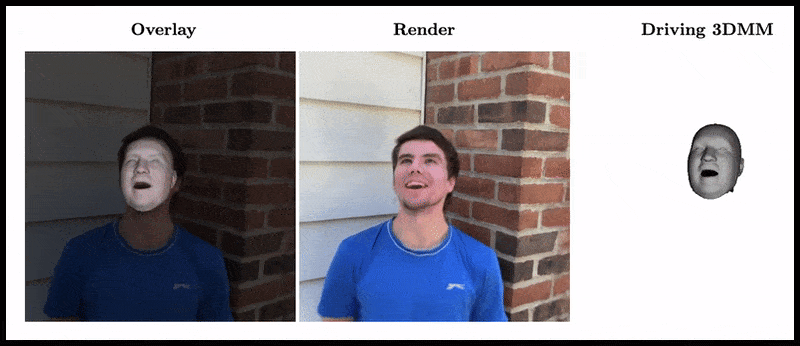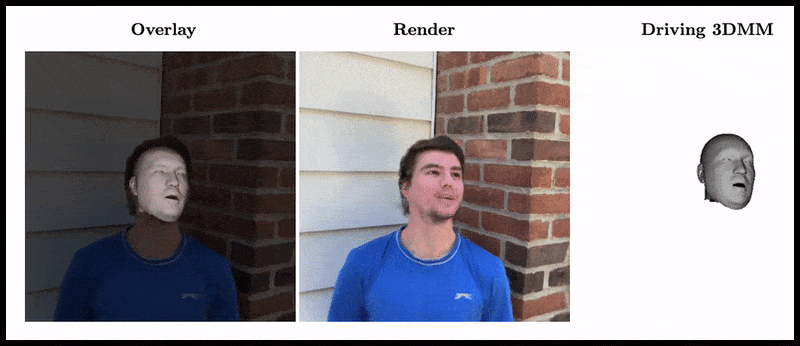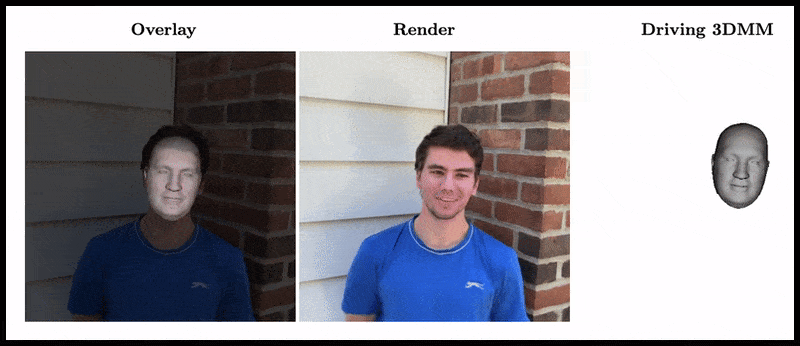
与传统deepfake视频不同,这里的所有动态内容都不是实拍内容,而是用短视频训练出的可探索神经空间。右侧的3DMM在所需操控(微笑、向左看、向上看等)与神经辐射场可视化通常难以控制的参数之间充当接口。此片段及其他示例的高清版本见项目页面或文末嵌入视频。 来源: https://shahrukhathar.github.io/2022/06/06/RigNeRF.html
3DMM基本上是CGI面模型,其参数可以适应更抽象的图像合成系统,如NeRF和GAN,这些系统本身难以控制。
上图中间图像(蓝衬衫男子)和下图左侧图像(蓝衬衫男子)并非“真实”视频,而是完全合成的场景,仅存在于体积神经渲染中,包括身体和背景。
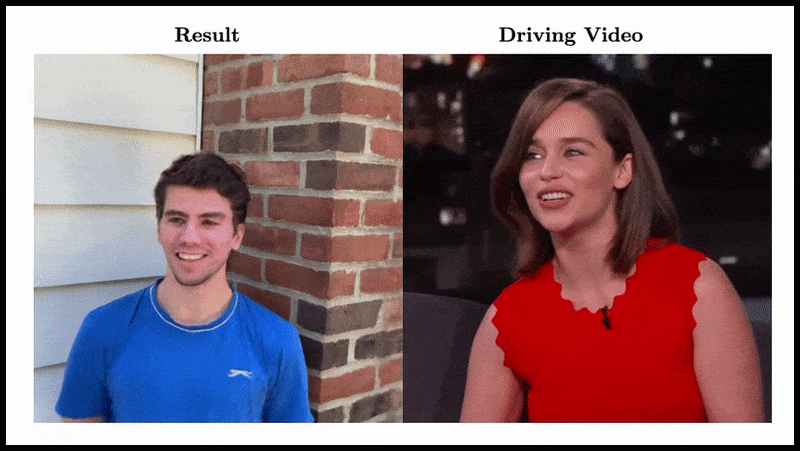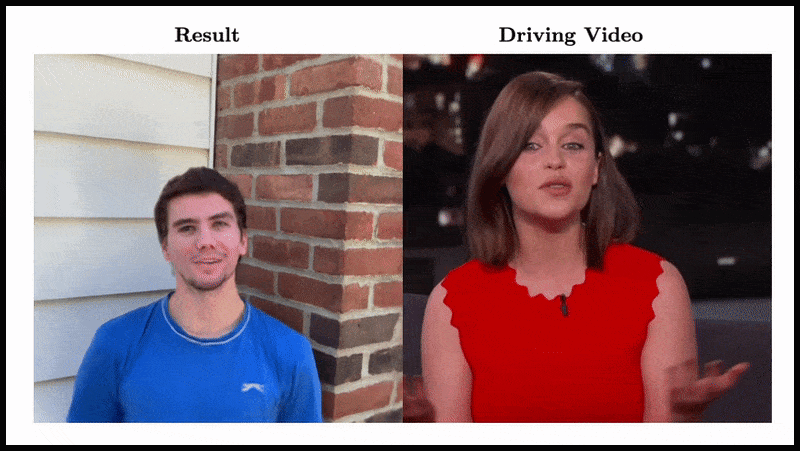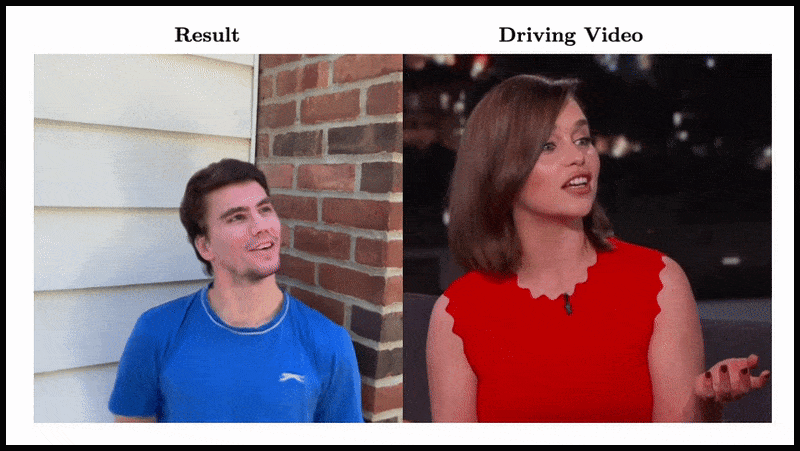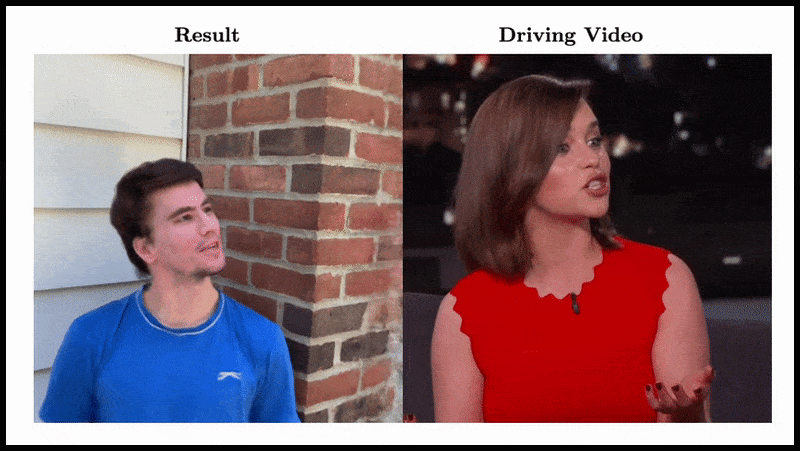
在上图中,右侧的真人视频(红衣女子)用于“操纵”左侧的捕获身份(蓝衬衫男子)通过RigNeRF,据作者称,这是首个能够分离姿势与表情、同时合成新视角的NeRF系统。
左侧的男性图像是从70秒的智能手机视频中“捕获”的,输入数据(包括整个场景信息)随后在4个V100 GPU上训练以获得场景。
由于3DMM风格的参数化骨架也可用作全身参数化CGI代理模型(而不仅仅是面部骨架),RigNeRF可能开启了全身Deepfakes的可能性,即真实的人体运动、质地和表情传递到基于参数的CGI层,然后将动作和表情转化为渲染的NeRF环境和视频。
那么,RigNeRF是否符合当前对Deepfakes的理解?还是只是另一个半瘫痪的、不如DeepFaceLab和其他2017年时代的自动编码器Deepfakes系统的方法?
新论文的研究人员对此点非常明确:
‘作为一种能够重现面部的方法,RigNeRF容易被不法分子滥用来生成Deepfakes。’
新论文题为RigNeRF:完全可控的神经三维肖像,作者为Stonybrook大学的ShahRukh Atha及Adobe Research的另外四位作者;前者在RigNeRF开发期间是Adobe实习生。
超越自动编码器的Deepfakes
过去几年成为头条新闻的大多数热门deepfake由自动编码器系统生成,源于2017年在随即被封禁的r/deepfakes子论坛发布的代码。封禁之前,代码已被复制到GitHub,随后被派生开发超过一千次,其中包括流行但有争议的DeepFaceLab发行版及FaceSwap项目。
除了GAN和NeRF外,自动编码器框架也尝试使用3DMM作为面部合成框架的“指导”。一个例子是2021年7月的HifiFace项目。然而,到目前为止,似乎没有可用的或流行的计划从这种方法中发展出来。
RigNeRF的数据是通过捕获短暂的智能手机视频获得的。对于该项目,研究人员使用iPhone XR或iPhone 12进行所有实验。对于捕获的前半部分,对象被要求在头部保持静止的同时,执行一系列面部表情和语音,同时相机在其周围移动。
记录的后半段则固定相机,让被摄者转动头部并做出多种表情。最终40至70秒的视频(约1200至2100帧)构成训练模型所用的全部数据集。
减少数据采集
相比之下,自动编码器系统(如DeepFaceLab)需要数千张多样化照片,这些照片通常来自YouTube视频和其他社交媒体渠道,以及电影(在名人Deepfakes的情况下)。这些照片需要经过仔细的收集和策划。
训练好的自动编码器模型通常旨在在各种情况下使用。然而,最细致的“名人”Deepfakes制作者可能会为单个视频从头开始训练整个模型,尽管训练可能需要一周或更长时间。
尽管论文作者发出警告,用于AI色情内容及热门YouTube/TikTok换角deepfake的拼凑式、多来源数据集,似乎不太可能在RigNeRF这类场景特定方法中产生可接受且一致的结果。新工作所述的采集限制因此可能在一定程度上额外防范恶意制作者轻易盗用身份。
将NeRF适应Deepfake视频
NeRF是一种基于摄影测量的方法,通过从不同视角拍摄的少量源图像,构建一个可探索的3D神经空间。这种方法在今年早些时候因NVIDIA (NVDA ) 推出的Instant NeRF系统而受到关注,该系统可以将NeRF的训练时间缩短到几分钟甚至几秒钟。
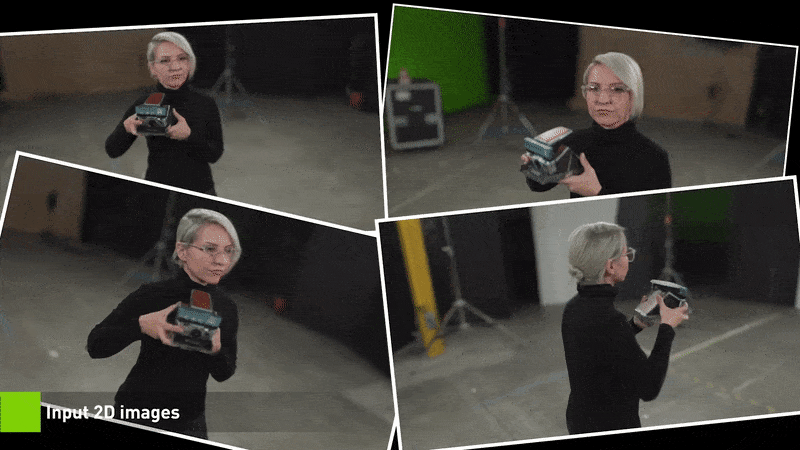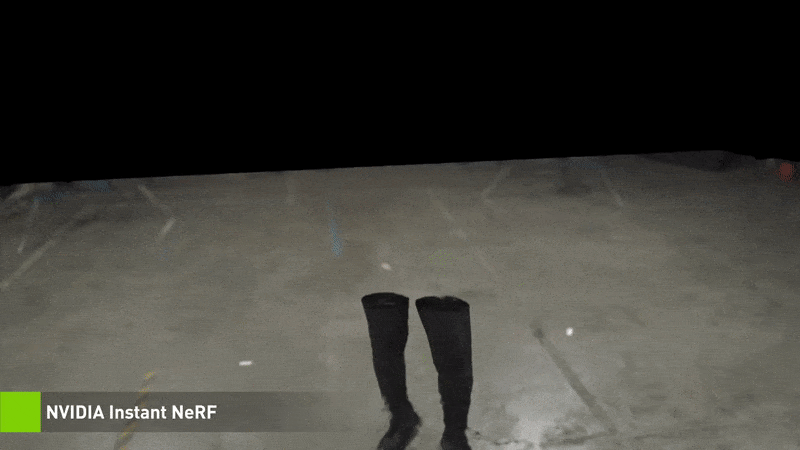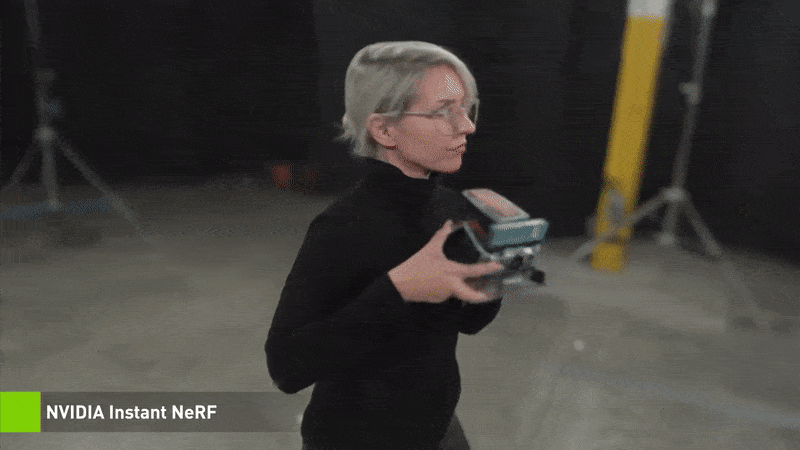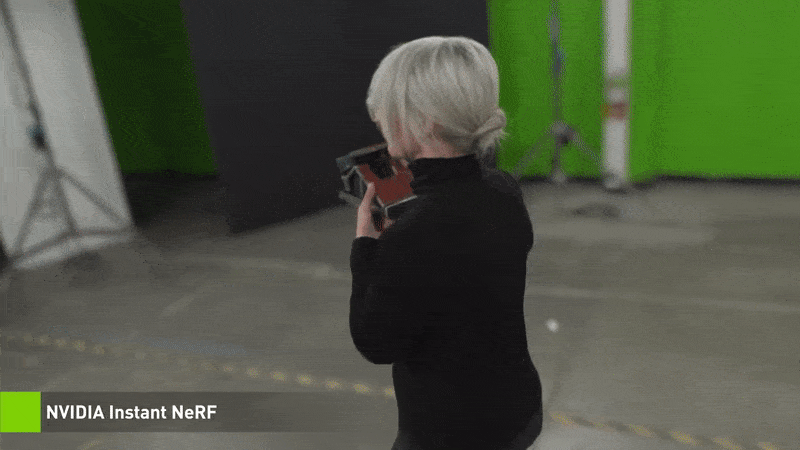
Instant NeRF。 来源:https://www.youtube.com/watch?v=DJ2hcC1orc4
生成的NeRF场景基本上是一个静态环境,可以被探索,但很难编辑。研究人员指出,两个先前的NeRF系统——HyperNeRF + E/P和NerFACE——尝试过面部视频合成,并将RigNeRF与这两个框架进行了比较。
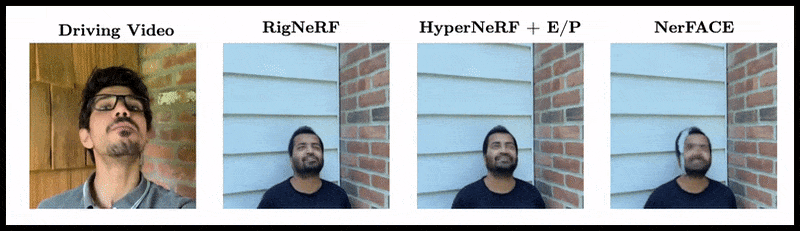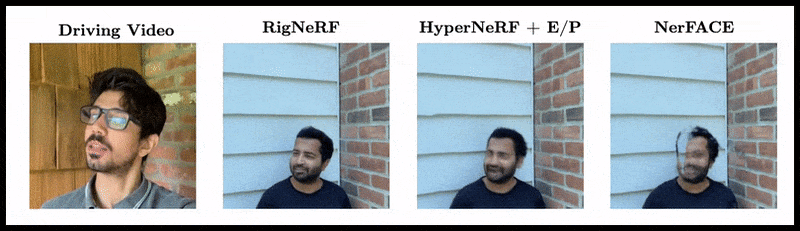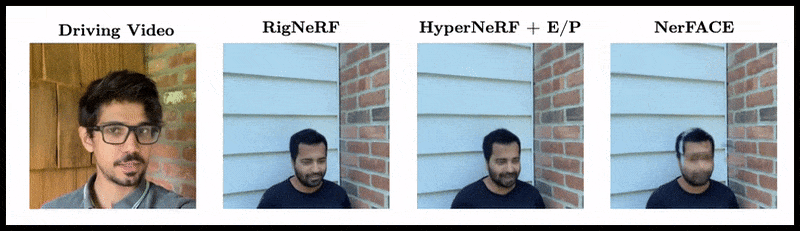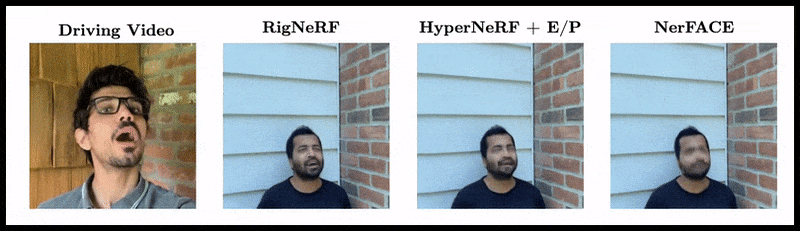
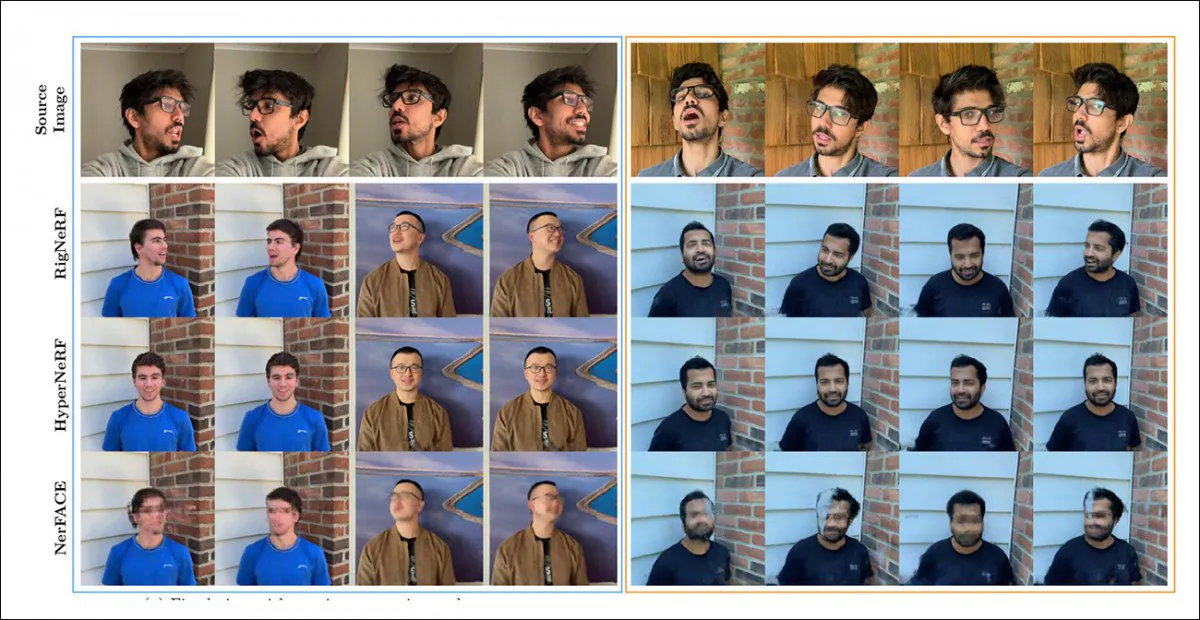
RigNeRF、HyperNeRF与NerFACE的定性比较。更高清的版本见所链接的源视频及PDF。 静态图片来源:https://arxiv.org/pdf/2012.03065.pdf
然而,这些结果偏向RigNeRF,原因有两个:首先,作者指出“没有现有的方法可以进行苹果到苹果的比较”;其次,这需要限制RigNeRF的功能,以部分匹配前两个系统的功能限制。
由于这些结果并非对旧方法的渐进改进,而是NeRF可编辑性及实用性的一次突破,本文暂且放下这轮比较,转而考察RigNeRF与前代方法的差异。
综合优势
NerFACE能够在NeRF环境中控制姿势和表情,其主要限制是,它假设源视频将使用静态相机捕获,这意味着它无法产生超出其捕获限制的新视图。这种方法产生了一个可以创建“移动肖像”的系统,但不适合Deepfakes风格的视频。
HyperNeRF另一方面,可以生成新颖和超现实的视图,但它没有任何机制可以改变头部姿势或面部表情,这也不会产生任何竞争对手来挑战自动编码器Deepfakes。
RigNeRF可以通过创建一个“规范空间”来结合这两个独立的功能,这个空间作为一个默认基线,偏差和变形可以通过3DMM模块的输入来执行。

创建一个“规范空间”(无姿势,无表情),3DMM产生的变形(即姿势和表情)可以在此空间中执行。
由于3DMM系统可能无法与捕获的对象完全匹配,需要在过程中进行补偿。RigNeRF通过从源视频中派生的多层感知器(MLP)计算变形场先验来实现这一点。

计算变形所需的相机参数通过COLMAP获得,而每个帧的表情和形状参数通过DECA获得。
位置进一步通过标志点拟合和COLMAP的相机参数优化,然而,由于计算资源限制,视频输出在训练过程中被降采样到256×256分辨率(这是一个硬件约束的缩小过程,也困扰着自动编码器Deepfakes场景)。
之后,变形网络在四个V100上训练——这是一个不太可能在普通爱好者手中拥有的强大硬件(然而,在机器学习训练中,通常可以用时间换取资源,只需接受模型训练将需要数天甚至数周的时间)。
总之,研究人员指出:
‘与其他方法相比,RigNeRF由于使用了3DMM引导的变形模块,能够以高保真度模拟头部姿势、面部表情和完整的3D肖像场景,从而产生更好的重建结果和清晰的细节。’
请查看下面的嵌入视频以获取更多详细信息和结果录像。
最初发布于2022年6月15日。


