
AI 模型与平台
Inside OpenAI的o3和o4-mini:通过多模态推理和集成工具集解锁新可能性

 将 Unite.AI 添加到您在 Google 上的首选来源
2025年4月16日,OpenAI 发布了其高级推理模型的升级版本。这些新模型,分别命名为o3和o4-mini,相比其前身o1和o3-mini具有改进。最新的模型提供了增强的性能、新功能和更大的可访问性。本文探讨了o3和o4-mini的主要优点,概述了它们的主要功能,并讨论了它们可能如何影响AI应用的未来。但在我们深入探讨o3和o4-mini的独特之处之前,了解OpenAI的模型如何随时间演变至关重要。让我们从OpenAI开发越来越强大的语言和推理系统的简要概述开始。
OpenAI的大型语言模型演进
OpenAI的大型语言模型开发始于 GPT-2 和 GPT-3,它们使得ChatGPT因其能够产生流畅和上下文准确的文本而被广泛采用。这些模型被广泛应用于诸如总结、翻译和问答等任务。然而,当用户将它们应用于更复杂的场景时,它们的缺点变得明显。这些模型经常难以处理需要深层推理、逻辑一致性和多步骤问题解决的任务。为了解决这些挑战,OpenAI引入了 GPT-4,并将其重点转向提高其模型的推理能力。这种转变导致了 o1 和 o3-mini 的开发。两个模型都使用了一种称为链式思维提示的方法,使它们能够通过一步一步的推理生成更逻辑和更准确的响应。虽然o1是为高级问题解决需求而设计的,但o3-mini则旨在以更高效和更具成本效益的方式提供类似的功能。基于这一基础,OpenAI现在推出了o3和o4-mini,它们进一步增强了其LLM的推理能力。这些模型被设计为能够产生更准确和更周全的答案,尤其是在编程、数学和科学分析等技术领域——这些领域需要逻辑精度。
o3和o4-mini的关键进展
增强的推理能力
o3和o4-mini的一个关键改进是它们对于复杂任务的增强推理能力。与之前的模型相比,o3和o4-mini模型需要更多时间来处理每个提示。这种额外的处理使它们能够更彻底地推理并产生更准确的答案,从而提高了基准测试的结果。例如,o3在 LiveBench.ai 上比o1提高了9%,LiveBench.ai是一个评估多个复杂任务(如逻辑、数学和代码)性能的基准。在SWE-bench上,测试软件工程任务的推理能力,o3获得了69.1%的分数,甚至超过了竞争对手模型,如 Gemini 2.5 Pro,后者获得了63.8%的分数。同时,o4-mini在同一基准上获得了68.1%的分数,在更低的成本下提供了几乎相同的推理深度。
多模态集成:以图像思考
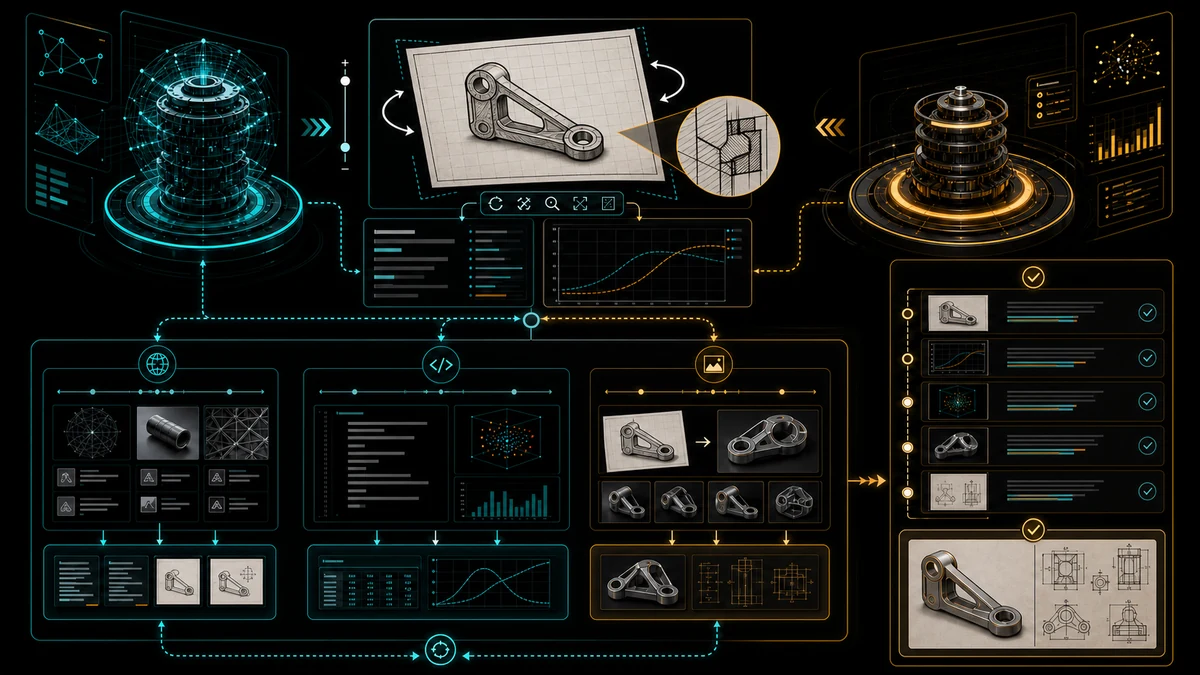
o3和o4-mini最具创新性的功能之一是它们能够“以图像思考”。这意味着它们不仅可以处理文本信息,还可以直接将视觉数据集成到其推理过程中。它们可以理解和分析图像,即使图像质量较低——例如手写笔记、草图或图表。例如,用户可以上传一个复杂系统的图表,模型可以分析它,识别潜在问题,甚至提出改进建议。这种功能弥合了文本和视觉数据之间的差距,实现了与AI的更直观和全面交互。两个模型都可以执行诸如放大细节或旋转图像以更好地理解它们的操作。这种多模态推理是相对于前辈模型(如主要基于文本的o1)的重大进步。它为教育、研究等领域开启了新的可能性,在这些领域,视觉辅助工具至关重要。
高级工具使用
o3和o4-mini是OpenAI首批同时使用ChatGPT中所有可用工具的模型。这些工具包括:
- 网页浏览:允许模型为时间敏感的查询获取最新信息。
- Python代码执行:使它们能够执行复杂的计算或数据分析。
- 图像处理和生成:增强了它们与视觉数据合作的能力。
通过使用这些工具,o3和o4-mini可以更有效地解决复杂的多步骤问题。例如,如果用户提出一个需要当前数据的问题,模型可以进行网络搜索以检索最新信息。同样,对于涉及数据分析的任务,它可以执行Python代码来处理数据。这种集成是朝着更自主的AI代理迈出的一步,这些代理可以在最少的人工干预下处理更广泛的任务。 Codex CLI 的引入,这是一种轻量级、开源的编码代理,与o3和o4-mini合作,进一步增强了它们对开发者的实用性。
影响和新可能性
o3和o4-mini的发布对各个行业产生了广泛的影响:
- 教育:这些模型可以通过提供详细的解释和视觉辅助工具帮助学生和教师,使学习更加互动和有效。例如,学生可以上传一个数学问题的草图,模型可以提供一步一步的解决方案。
- 研究:它们可以通过分析复杂的数据集、生成假设和解释视觉数据(如图表和图表)来加速发现,这对于物理或生物学等领域至关重要。
- 行业:它们可以通过处理文本和视觉查询来优化流程、改善决策和增强客户互动,例如分析产品设计或解决技术问题。
- 创造力和媒体:作者可以使用这些模型将章节大纲转换为简单的故事板。音乐家可以将视觉效果与旋律匹配。电影编辑可以获得节奏建议。建筑师可以将手绘楼层计划转换为包含结构和可持续性说明的详细3D蓝图。
- 无障碍和包容性:对于盲用户,模型可以详细描述图像。对于聋用户,模型可以将图表转换为视觉序列或带字幕的文本。它们对文本和视觉的翻译有助于弥合语言和文化差距。
- 朝着自主代理:由于模型可以在一个工作流中浏览网络、运行代码和处理图像,因此它们构成了自主代理的基础。开发人员可以描述一个功能;模型可以编写、测试和部署代码。知识工作者可以将数据收集、分析、可视化和报告编写委托给一个AI助手。
限制和下一步
尽管取得了这些进展,o3和o4-mini仍然具有2023年8月的知识截止日期,这限制了它们对最新事件或技术的响应能力,除非通过网络浏览进行补充。未来版本可能会通过改进实时数据摄取来解决这一差距。
我们还可以期待在自主AI代理方面取得进一步的进展——这些系统可以在最少的监督下持续计划、推理、行动和学习。OpenAI将工具、推理模型和实时数据访问集成在一起,表明我们正在朝着这样的系统迈进。
结论
OpenAI的新模型o3和o4-mini提供了推理、多模态理解和工具集成的改进。它们在广泛的任务中更准确、更通用、更有用——从分析复杂数据和生成代码到解释图像。这些进展有可能显著提高各个行业的生产力和创新能力。





