AI 基础
什么是 Albumentations?计算机视觉的图像增强

 将 Unite.AI 添加到您在 Google 上的首选来源
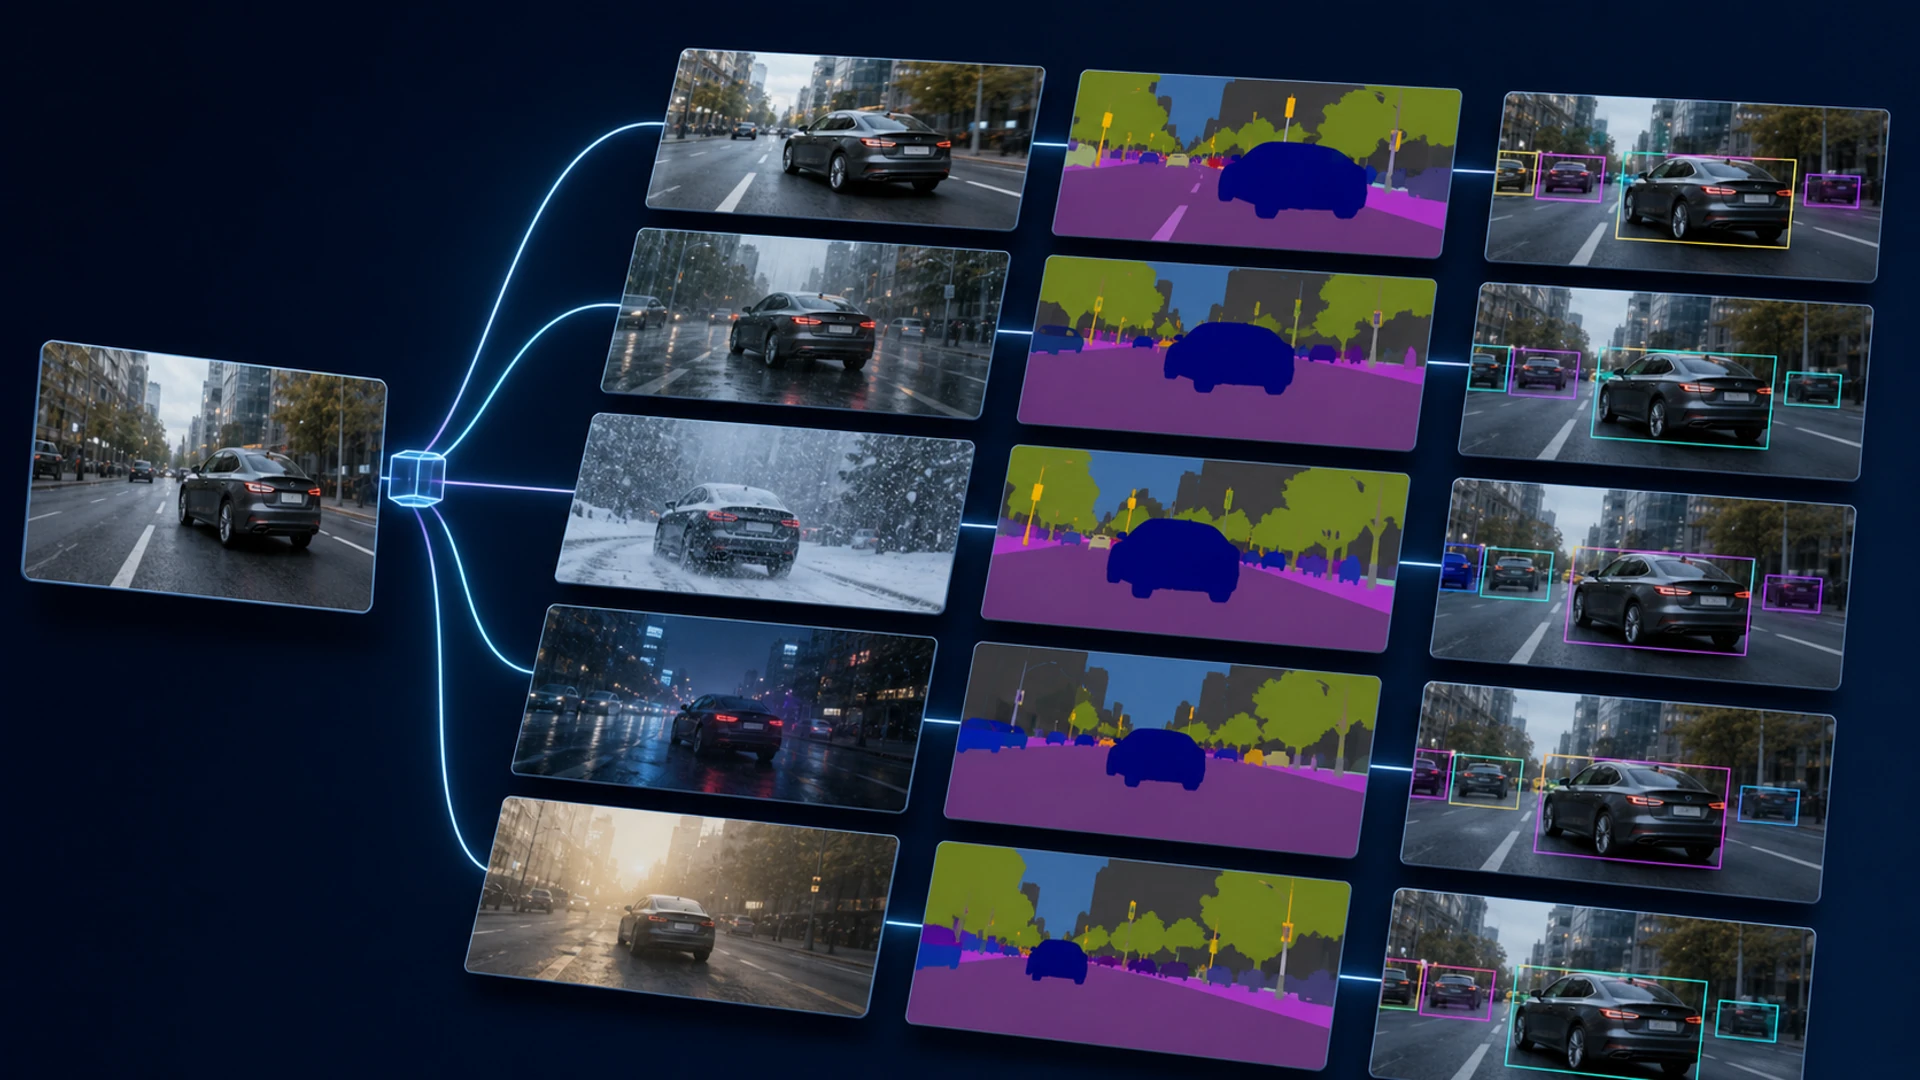
Albumentations 是一个开源的 Python 图像增强库。它在对图像进行随机几何和光度变换的同时,保持相关目标(例如分割掩码、边界框和关键点)与图像对齐。
增强是一种关于不变性的假设:它告诉模型所选的变化不应改变任务标签。快速的库可以简化实验,但只有领域知识和验证才能判断某个变换是否合理。
关键要点
- 将概率性变换组合成可重复的训练流水线。
- 对图像和空间目标同时进行变换;明确验证边框和关键点的约定。
- 对训练数据进行随机增强,而不是对未修改的验证或测试分布进行增强。
- 衡量每个类别和子群的影响,因为更强的增强可能对某些情况有益,而对另一些有害。
Albumentations 流水线的工作原理
流水线接收图像及其命名目标,根据各自概率抽样变换,并返回包含更新后输出的字典。几何变换可以裁剪、旋转、翻转或扭曲;光度变换可以改变颜色、对比度、模糊或噪声。
该库可与训练框架集成,同时专注于增强。对于计算机视觉而言,这种分离使得能够在不依赖模型框架的情况下,对数据策略进行基准测试。
保持标签的几何正确性
对图像进行裁剪时,必须同步裁剪其掩码并更新或删除受影响的边框和关键点。配置坐标格式、标签字段、最小可见度、裁剪和过滤规则,然后在训练前可视化批次。
不同目标的插值方式不同:图像可能使用双线性插值,而类别掩码通常需要最近邻插值,以避免产生错误的类别值。错误的目标处理可能会悄然破坏数据集。
从部署环境中选择变换
水平翻转在野生动物照片中可能是合理的,但在文本、道路标志、医学左右对称性或非对称设备中则不适用。颜色变化可以提升光照鲁棒性,但当颜色承载意义时,可能会抹去诊断特征。
从合理的噪声变异开始,一次添加一个变换族,并检查困难样本。将选择与过拟合假设关联,而不是假设更多的合成多样性总是更好。
可重复性与评估
记录库版本、流水线配置、概率、随机种子策略、预处理顺序和归一化。随机性应在训练样本中变化,同时实验在运行层面保持可重复性。
保持验证和测试图像具有代表性且未进行增强,仅进行确定性的预处理。比较准确率、校准、每类错误和鲁棒性。混淆矩阵可以揭示增强是转移错误还是降低错误。
组合、概率与目标
Compose 会按顺序应用一系列变换,每个变换都有概率。OneOf 或 SomeOf 结构在备选方案中抽样,嵌套的概率决定实际分布。因此,有效的增强策略是一个随机程序;应记录它并检查抽样频率,而不是单独查看每个概率。
额外的目标使得多张图像或掩码共享几何信息,这在立体对、前后对比图像或多重标注时很有用。边界框支持需要声明格式,如 Pascal VOC、COCO、YOLO 或 Albumentations 坐标。关键点格式可能包括角度或尺度,变换必须保留这些语义。
裁剪可能会移除所有目标。需要决定是重新抽样、保留背景示例还是过滤,因为每种选择都会改变类别分布。检测和分割流水线应记录被丢弃的框、可见比例和空样本,以揭示潜在的标签损伤。
按任务设计策略
分类在类别仍可见时通常能容忍裁剪、颜色变化、模糊和遮挡。检测需要对象和边框一起变换。分割要求掩码几何精确。姿态估计必须保留关键点,并且在翻转后可能需要左右标签互换。
医学影像可能禁止翻转、激进的颜色变化或会改变定量强度的插值。遥感需要考虑方向、季节、传感器波段和地理尺度。文档分析必须保持可读性和版面。领域决定不变性,库仅执行这些规则。
MixUp、CutMix、Mosaic 或复制粘贴等混合方法会生成复合标签,可能在数据加载器或框架中实现,而非 Albumentations。应测试它们与基础变换、归一化和批处理的交互。即使最终准确率提升,强策略也可能减慢收敛或改变校准。
性能、调试与实验设计
除非使用其他路径,增强默认在 CPU 上运行。测量数据加载器吞吐量、工作进程数、解码成本、内存拷贝和 GPU 空闲时间。更快的变换只有在不改变语义时才有价值。当存储和可重复性允许时,可缓存不可变的解码或预处理阶段。
可视化原始和变换样本的网格,并在上面叠加所有目标。添加自动化测试,检查坐标往返、掩码数值、形状、数据类型以及确定性重放。将在正确范围内设置种子;所有工作进程使用相同的增强可能无意中降低多样性。
针对固定基线进行消融实验:无增强、合理的基础变换,然后是更强的策略。重复种子并报告方差。分别评估干净数据、相关扰动和子群体。仅在策略的收益在留出测试中仍然有效且变换后的图像对领域专家仍具可信度时,才保留该策略。
设计与验证 Albumentations 流水线
从部署后可能出现的变化入手:相机角度、裁剪、尺度、光照、压缩、模糊、天气、遮挡和传感器噪声。选择能够保持标签并匹配这些机制的变换。水平翻转对动物可能有效,但对文本、交通方向或非对称解剖则无效。强烈的颜色变化即使图像仍看起来自然,也可能破坏诊断相关信息。
在正确配置时,Albumentations 组合变换并对图像、掩码、边界框和关键点一致地应用空间变化。明确声明坐标格式、最小可见度、插值方式和掩码处理。可视化数百个带有标注的增强样本,测试空值和边界情况,并保存随机参数以便调试。在增强前按主体或场景划分数据,防止相关图像在训练和测试之间泄漏。
在未修改的测试集和真实的压力集上比较无增强、简单增强和所提策略。跟踪每类的准确率、定位、校准和失败案例,而不仅仅是训练损失。过度增强可能导致对真实分布欠拟合,而弱增强可能促使模型学习捷径。将流水线与模型、种子评估运行一起版本化,除非明确评估测试时增强,否则在验证或推理期间避免使用随机训练变换。
对于检测和分割,需要验证坐标裁剪、最小框面积、关键点可见性以及对类别掩码使用的插值方式。类别 ID 通常需要最近邻插值,而双线性插值可能产生无效标签。同时对数据加载器进行性能分析:激进的变换可能使 CPU 增强成为训练瓶颈。仅缓存那些确定性且在各 epoch 与工作进程间保持预期随机性的变换。
实用实现检查清单
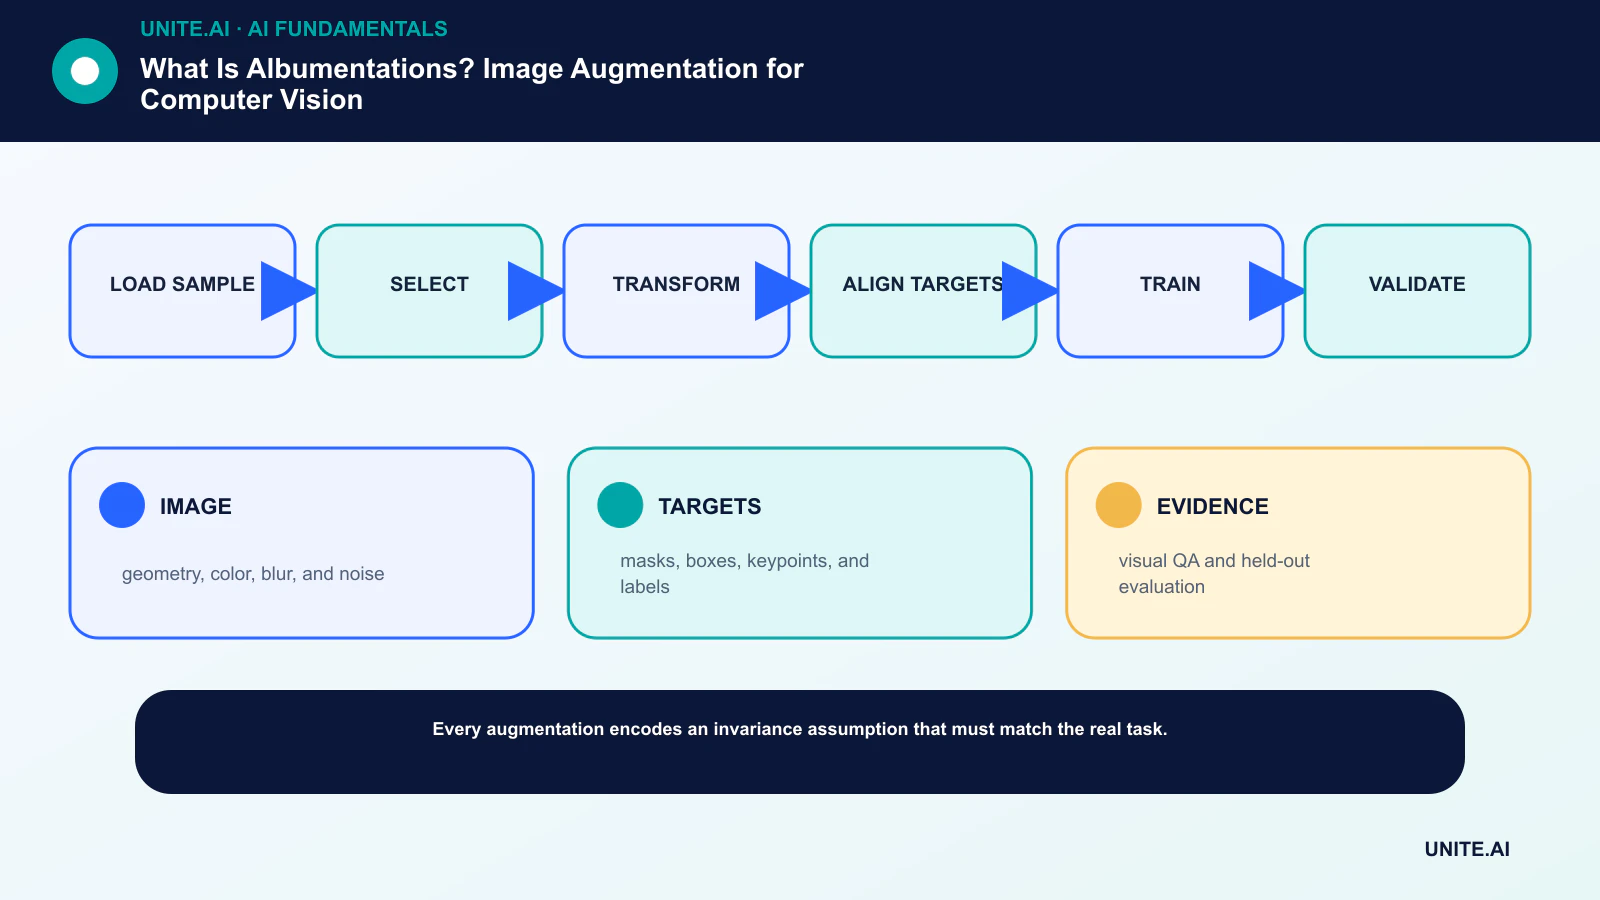
将概念转化为有界、可测试的工作流:加载样本 → 选择 → 变换 → 对齐目标 → 训练 → 验证。指定负责人员,记录数据及其依赖,建立简单基线,设定接受和停止标准,测试代表性故障,并在扩展范围前定义监控、回滚和审查。记录版本和假设,以便其他团队能够复现结果并了解变更内容。
在上线前,进行有文档记录的就绪评审,邀请构建、运维、安全以及受系统影响的人员。测试正常情况、边界条件、依赖失效和误用;保留证据和未解决的风险。明确谁可以批准发布、修改阈值、覆盖输出或停止运行。实际数据到来后重新评估决定,因为技术上成功的试点并不保证在更大规模下的可靠性能。
- IMAGE: 图像:几何、颜色、模糊和噪声。
- TARGETS: 目标:掩码、边框、关键点和标签。
- EVIDENCE: 证据:可视化质量检查和留出评估。
常见问题
图像增强会创建新的真实标签吗?
不会。它在标签仍然有效的假设下生成变换后的训练样本。若变换不符合实际或标签错误,则会引入噪声。
验证图像应当进行增强吗?
应使用模型所需的确定性缩放和归一化,但保持评估分布不变。测试时增强是另一种推理方法,需要明确报告。
主要参考文献